运维管理21 分钟阅读
国产数据库横向评测:TiDB vs OceanBase vs openGauss 部署实战与性能对比
信创浪潮下,国产数据库选型成了 DBA 绑不开的话题。TiDB、OceanBase、openGauss 是目前最主流的三大国产数据库。本文从架构设计、部署体验、兼容性、性能表现四个维度做横向评测,并给出不同场景下的选型建议。
2026年5月6日阅读—点赞—收藏—
mysqlpostgresql
在知识库中专注阅读,并随时返回相关工具与课程
信创浪潮下,国产数据库选型成了 DBA 绑不开的话题。TiDB、OceanBase、openGauss 是目前最主流的三大国产数据库。本文从架构设计、部署体验、兼容性、性能表现四个维度做横向评测,并给出不同场景下的选型建议。
最近两年,"信创" 这个词在 IT 圈的热度只增不减。简单说,信创就是 信息技术应用创新,核心目标是实现关键技术的自主可控。数据库作为基础软件的 "三驾马车" 之一(操作系统、数据库、中间件),自然成了信创替代的重中之重。
如果你是一线 DBA,或者正在做技术选型,你一定绑不开这三个名字:
我从去年开始陆续在测试环境把这三款数据库都跑了一遍,今天这篇文章就把我的实际体验分享出来。不吹不黑,用数据和部署日志说话。
2025 年之后,党政、金融、电信、能源等关键行业的核心系统,已经在加速推进国产数据库替代。很多招标文件里明确写着"优先采用国产数据库"。这不是趋势,是现实。
五年前你可能还会说 "国产数据库不靠谱",但今天情况完全不同了:
说白了,现在不是 "能不能用" 的问题,而是 "选哪个" 的问题。
Oracle 的授权费用大家都懂,一台物理机一年几十万的 License 费用,很多企业已经扛不住了。MySQL 虽然开源,但在分布式扩展、企业级高可用方面确实有短板。国产数据库恰好填补了这个空间。
TiDB 的架构设计非常清晰,核心由三个组件构成:
 TiDB Server、TiKV 与 PD 的架构关系
关键设计点:
TiDB 兼容 MySQL 5.7/8.0 协议,大部分 MySQL 客户端和 ORM 框架可以直接连。但要注意几个坑:
txn-total-size-limit = 100MB,大批量 INSERT 需要分批处理。CREATE PROCEDURE 的支持是实验性的,存储过程重度用户需要留意。实际迁移中,大概 80-90% 的 MySQL 应用可以平滑迁移到 TiDB,剩下的需要做一些改造。
TiDB 的部署体验是三者中最丝滑的,核心工具是 TiUP。
第一步:安装 TiUP
1curl --proto '=https' --tlsv1.2 -sSf https://tiup-mirrors.pingcap.com/install.sh | sh2source ~/.bashrc第二步:准备拓扑文件
1# topology.yaml23> **本章目标**:掌握本章核心知识点4> **前置要求**:完成前序章节学习5> **预计时长**:60 分钟67global:8 user: "tidb"9 ssh_port: 2210 deploy_dir: "/tidb-deploy"11 data_dir: "/tidb-data"1213server_configs:14 tidb:15 log.slow-threshold: 30016 tikv:17 readpool.storage.use-unified-pool: true18 readpool.coprocessor.use-unified-pool: true19 pd:20 replication.location-labels: ["host"]2122tidb_servers:23 - host: 10.0.1.124 - host: 10.0.1.22526tikv_servers:27 - host: 10.0.1.128 - host: 10.0.1.229 - host: 10.0.1.33031pd_servers:32 - host: 10.0.1.133 - host: 10.0.1.234 - host: 10.0.1.33536monitoring_servers:37 - host: 10.0.1.13839grafana_servers:40 - host: 10.0.1.1第三步:一键部署
1tiup cluster deploy tidb-test v7.6.0 ./topology.yaml --user root -p2tiup cluster start tidb-test部署完成后,TiUP 会自动帮你配好 Prometheus + Grafana 监控,开箱即用。这一点真的要给好评。
第四步:验证连接
1mysql -h 10.0.1.1 -P 4000 -u root没错,直接用 MySQL 客户端连,端口默认是 4000。
TiFlash 是 TiDB 的杀手锏之一。你可以对某张表开启 TiFlash 副本:
1ALTER TABLE orders SET TIFLASH REPLICA 1;之后,TiDB 的优化器会自动判断:如果是简单的点查或小范围扫描,走 TiKV(行存);如果是大范围聚合分析,走 TiFlash(列存)。整个过程对应用完全透明。
实际测试中,同一张 5000 万行的订单表:
SELECT COUNT(*) ... GROUP BY 需要 12 秒这就是列存的威力。
优势:
劣势:
OceanBase 采用 Shared-Nothing 架构,核心概念包括:
 OceanBase 三 Zone 与 OBProxy 架构
关键设计点:
OceanBase 最大的特色之一是同时兼容 MySQL 和 Oracle 两套语法模式:
1-- 创建 MySQL 模式租户2CREATE TENANT mysql_tenant 3 RESOURCE_POOL_LIST = ('pool_mysql')4 SET ob_compatibility_mode = 'mysql';56-- 创建 Oracle 模式租户7CREATE TENANT oracle_tenant 8 RESOURCE_POOL_LIST = ('pool_oracle') 9 SET ob_compatibility_mode = 'oracle';Oracle 兼容模式支持:
对于 Oracle 迁移来说,这个功能简直是救命稻草。实际测试中,大约 70-80% 的 Oracle PL/SQL 代码可以在 OceanBase Oracle 模式下直接运行。
OceanBase 的部署工具是 OBD (OceanBase Deployer)。
第一步:安装 OBD
1# CentOS/RHEL2sudo yum install -y yum-utils3sudo yum-config-manager --add-repo https://mirrors.aliyun.com/oceanbase/OceanBase.repo4sudo yum install -y ob-deploy56# 或者用 rpm 包7rpm -ivh ob-deploy-*.rpm第二步:单机快速部署(测试环境)
1# 单机 all-in-one 部署,适合学习和测试2obd demo这个命令会在本地拉起一个最小化的 OceanBase 实例,包含 1 个 OBServer + 1 个 OBProxy。
第三步:集群部署(生产环境)
1# mini-distributed.yaml2oceanbase-ce:3 servers:4 - name: server15 ip: 10.0.1.16 - name: server27 ip: 10.0.1.28 - name: server39 ip: 10.0.1.310 global:11 devname: eth012 memory_limit: 16G13 datafile_size: 100G14 log_disk_size: 100G15 cpu_count: 1616 mysql_port: 288117 rpc_port: 288218 home_path: /home/admin/oceanbase19 zone: zone120 server1:21 zone: zone122 server2:23 zone: zone224 server3:25 zone: zone32627obproxy-ce:28 servers:29 - 10.0.1.130 global:31 listen_port: 288332 prometheus_listen_port: 288433 home_path: /home/admin/obproxy34 obproxy_sys_password: ******35 observer_sys_password: ******1obd cluster deploy ob-test -c mini-distributed.yaml2obd cluster start ob-test注意事项:
root@sys 租户:mysql -h 10.0.1.1 -P 2881 -u root@sysOceanBase 的高可用设计非常硬核:
蚂蚁每年双十一用的就是 OceanBase,金融级可靠性不是吹的。
优势:
劣势:
openGauss 是华为基于 PostgreSQL 9.2 内核深度改造的数据库,但经过多年发展,已经和上游 PostgreSQL 有了相当大的差异。
核心增强:
 openGauss 主节点通过 WAL 流复制到两个备节点
openGauss 兼容 PostgreSQL 的大部分 SQL 语法和客户端协议,但有几点需要注意:
1-- openGauss 支持的 PG 语法示例2CREATE TABLE users (3 id SERIAL PRIMARY KEY,4 name VARCHAR(100),5 data JSONB,6 tags TEXT[],7 created_at TIMESTAMPTZ DEFAULT NOW()8);910-- JSONB 查询11SELECT * FROM users WHERE data->>'role' = 'admin';1213-- 数组查询14SELECT * FROM users WHERE 'dba' = ANY(tags);openGauss 的单机部署非常简单,特别适合快速评估。
方式一:Docker 快速体验
1docker run --name opengauss \2 --privileged=true \3 -d \4 -e GS_PASSWORD=MyP@ssw0rd \5 -p 5432:5432 \6 enmotech/opengauss:latest78# 连接9docker exec -it opengauss gsql -d postgres -U gaussdb -W MyP@ssw0rd方式二:企业版离线安装
1# 1. 创建用户2groupadd dbgrp3useradd -g dbgrp -m omm45# 2. 解压安装包6tar -xf openGauss-5.0.0-CentOS-64bit-all.tar.gz7tar -xf openGauss-5.0.0-CentOS-64bit-om.tar.gz89# 3. 准备 XML 配置文件10cat > cluster_config.xml << 'XMLEOF'11<?xml version="1.0" encoding="UTF-8"?>12<ROOT>13 <CLUSTER>14 <PARAM name="clusterName" value="opengauss_cluster"/>15 <PARAM name="nodeNames" value="node1"/>16 <PARAM name="backIp1s" value="10.0.1.1"/>17 <PARAM name="gaussdbAppPath" value="/opt/openGauss/app"/>18 <PARAM name="gaussdbLogPath" value="/var/log/openGauss"/>19 <PARAM name="gaussdbToolPath" value="/opt/openGauss/tool"/>20 <PARAM name="corePath" value="/opt/openGauss/core"/>21 </CLUSTER>22 <DEVICELIST>23 <DEVICE sn="node1">24 <PARAM name="name" value="node1"/>25 <PARAM name="backIp1" value="10.0.1.1"/>26 <PARAM name="sshIp1" value="10.0.1.1"/>27 <PARAM name="dataNum" value="1"/>28 <PARAM name="dataPortBase" value="5432"/>29 <PARAM name="dataNode1" value="/opt/openGauss/data/dn"/>30 </DEVICE>31 </DEVICELIST>32</ROOT>33XMLEOF3435# 4. 预安装36cd /opt/software/openGauss37./script/gs_preinstall -U omm -G dbgrp -X /opt/software/cluster_config.xml3839# 5. 安装40su - omm41gs_install -X /opt/software/cluster_config.xml4243# 6. 启动44gs_om -t start4546# 7. 验证47gsql -d postgres -p 5432 -ropenGauss 最有意思的特性之一是 AI 驱动的数据库调优。X-Tuner 是一个基于强化学习的参数调优工具:
1# 安装 X-Tuner2pip install openGauss-xtuner34# 运行调优5gs_xtuner tune \6 -f tuner_config.json \7 --db-name postgres \8 --db-user omm \9 --host 127.0.0.1 \10 --host-user omm \11 --port 5432X-Tuner 会自动采集数据库的负载特征,然后通过强化学习算法(基于 DDPG)找到最优的参数组合。实测下来,对于 shared_buffers、work_mem、effective_cache_size 等参数的调优效果还是有的,某些场景能带来 10-20% 的性能提升。
不过说实话,这个功能目前还比较初级,不能完全替代有经验的 DBA。当个辅助工具用还行。
优势:
劣势:
1简单 ◄────────────────────────────► 复杂23openGauss(单机) TiDB(TiUP) OceanBase(OBD) openGauss(集群)4 ★ ★★ ★★★ ★★★★声明:以下数据来自实验环境测试,仅供参考。不同硬件、不同配置、不同数据量下结果会有较大差异。生产环境请以实际 POC 测试结果为准。
1CPU: Intel Xeon Gold 6248R × 2 (48C)2内存: 256GB DDR4 ECC3磁盘: NVMe SSD 3.2TB × 24网络: 25Gbps5OS: CentOS 7.9 / openEuler 22.03每款数据库分配 3 台同规格服务器。
测试场景:oltp_read_write,10 张表,每表 1000 万行。
分析:
OceanBase 的 TPC-C 成绩虽然惊人,但请注意它用了 1554 个节点。单节点性能和分布式堆机器的性能是两回事,不能简单类比。
针对 HTAP 场景,我在 TiDB 上做了一组对比测试:
1-- OLTP: 持续进行点查和小事务2-- OLAP: 同时跑复杂分析查询34SELECT 5 l_returnflag,6 l_linestatus,7 SUM(l_quantity) as sum_qty,8 SUM(l_extendedprice) as sum_base_price,9 AVG(l_quantity) as avg_qty,10 COUNT(*) as count_order11FROM lineitem12WHERE l_shipdate <= DATE '2025-12-01' - INTERVAL '90' DAY13GROUP BY l_returnflag, l_linestatus14ORDER BY l_returnflag, l_linestatus;TiFlash 在 HTAP 场景下的优势非常明显:OLAP 查询速度提升 14 倍,同时对 OLTP 的影响从 35% 降到了 5%。这就是存算分离 + 列式引擎的价值。
选数据库没有 "最好" 的,只有 "最合适" 的。以下是我的建议:
适合你如果:
典型案例: 电商订单系统、实时数据分析平台、游戏用户数据、SaaS 多租户
你的业务有 MySQL 分库分表? → Yes → TiDB
你需要实时 OLAP? → Yes → TiDB + TiFlash
数据量 < 500GB 且不需要扩展? → No → 考虑其他方案
适合你如果:
典型案例: 银行核心系统、证券交易、保险理赔、支付清算
你的核心系统跑在 Oracle 上? → Yes → OceanBase Oracle 模式 需要金融级 RPO=0? → Yes → OceanBase 不确定用 MySQL 还是 Oracle 模式? → MySQL 模式起步
适合你如果:
典型案例: 政务 OA 系统、电力调度系统、高校管理系统、中小规模业务
你的团队熟悉 PostgreSQL? → Yes → openGauss 政务信创项目要求华为生态? → Yes → openGauss 需要分布式能力? → Yes → openGauss + ShardingSphere
迁移到 OceanBase(推荐):
 通过 OMS 将 Oracle 迁移到 OceanBase Oracle 模式
OceanBase 提供了 OMS 迁移工具,支持:
迁移到 openGauss:
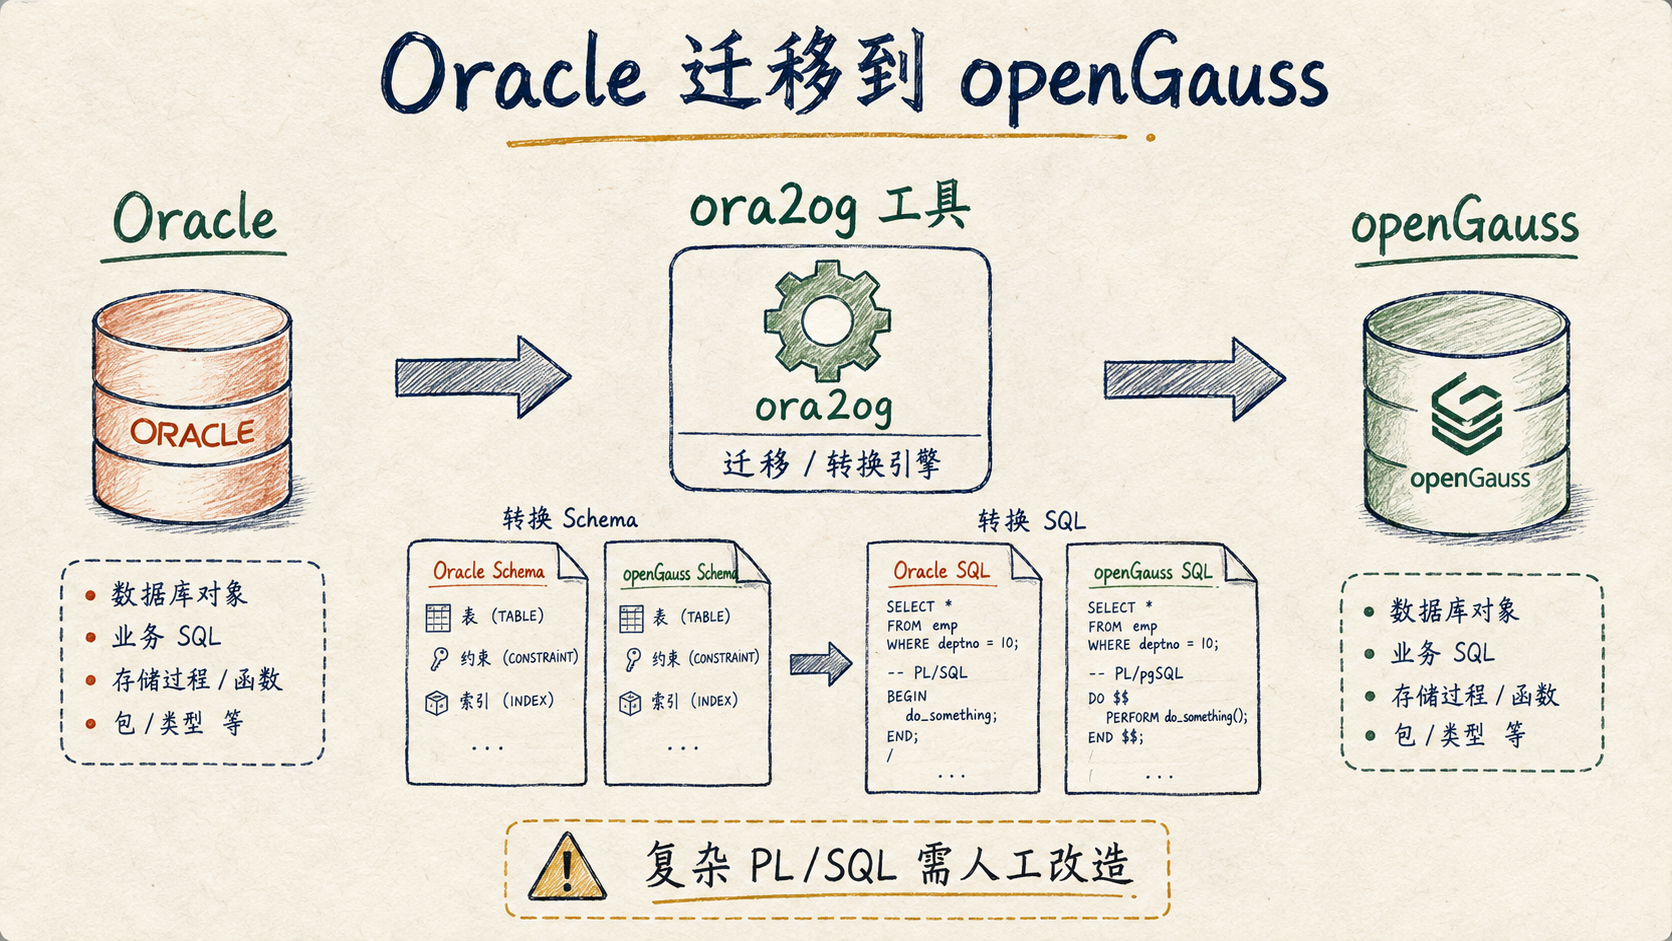 通过 ora2og 将 Oracle 迁移到 openGauss
openGauss 社区提供了 ora2og 迁移工具,但成熟度不如 OMS。复杂的 PL/SQL 代码需要手动改造。
迁移到 TiDB(推荐):
 通过 TiDB Data Migration 将 MySQL 迁移到 TiDB
TiDB DM 支持:
1# DM 迁移任务示例2tiup dmctl --master-addr=10.0.1.1:8261 \3 start-task task.yaml迁移到 OceanBase:
 通过 OMS 将 MySQL 迁移到 OceanBase MySQL 模式
1# 查看集群状态2tiup cluster display tidb-test34# 扩容 TiKV 节点5tiup cluster scale-out tidb-test scale-out.yaml67# 缩容节点8tiup cluster scale-in tidb-test --node 10.0.1.4:20160910# 升级版本11tiup cluster upgrade tidb-test v7.6.01213# 查看慢查询14SELECT * FROM information_schema.slow_query 15WHERE time > '2026-05-06 00:00:00' 16ORDER BY query_time DESC LIMIT 10;1# 查看集群状态2obclient -h 10.0.1.1 -P 2881 -u root@sys -e "SELECT * FROM oceanbase.DBA_OB_SERVERS;"34# 查看租户5SELECT * FROM oceanbase.DBA_OB_TENANTS;67# 查看 Zone 状态8SELECT * FROM oceanbase.DBA_OB_ZONES;910# 合并管理(Major Compaction)11ALTER SYSTEM MAJOR FREEZE;12SELECT * FROM oceanbase.CDB_OB_MAJOR_COMPACTION;1314# 租户级慢查询15SELECT * FROM oceanbase.GV$OB_SQL_AUDIT 16WHERE elapsed_time > 1000000 17ORDER BY elapsed_time DESC LIMIT 10;1# 查看实例状态2gs_om -t status --detail34# 查看连接信息5gsql -d postgres -p 5432 -c "SELECT * FROM pg_stat_activity;"67# 性能视图8SELECT * FROM dbe_perf.statement ORDER BY total_time DESC LIMIT 10;910# 备份11gs_basebackup -D /backup/full -p 54321213# 健康检查14gs_check -i CheckAll -L三款数据库我都在测试环境深度使用过,说点主观感受:
最后一句话:不要为了国产化而国产化,要为了解决实际问题而选型。信创是大趋势没错,但选什么数据库还是要回到业务本身。先搞清楚自己的数据量、并发量、一致性要求、团队技术栈,再来选数据库,才是正确的姿势。
如果你在做数据库选型,欢迎在评论区交流。我后续也会写单独的深度文章,分别介绍 TiDB、OceanBase、openGauss 的生产环境调优经验。
本章介绍了以下核心内容: