运维管理19 分钟阅读
数据库中间件三剑客:ShardingSphere vs ProxySQL vs Vitess 选型指南
当单库扛不住的时候,数据库中间件就该上场了。ShardingSphere 主打分库分表,ProxySQL 专注读写分离和连接池,Vitess 擅长水平扩展。本文横向对比这三款中间件的架构、功能、适用场景,帮你选出最适合的方案。
2026年5月6日阅读—点赞—收藏—
mysqlpostgresql
在知识库中专注阅读,并随时返回相关工具与课程
当单库扛不住的时候,数据库中间件就该上场了。ShardingSphere 主打分库分表,ProxySQL 专注读写分离和连接池,Vitess 擅长水平扩展。本文横向对比这三款中间件的架构、功能、适用场景,帮你选出最适合的方案。
先问自己几个问题:
如果你中了一条以上,那就该认真考虑数据库中间件了。
简单来说,数据库中间件就是横在应用和数据库之间的一层代理,它帮你处理分片路由、读写分离、连接复用、负载均衡这些脏活累活,让应用层可以像访问单库一样访问分布式数据库集群。
今天我们要聊的三款中间件,各有各的绝活:
接下来我们逐个拆解。
ShardingSphere 是 Apache 基金会的顶级项目,提供两种接入模式:
ShardingSphere-JDBC(嵌入式):
 ShardingSphere-JDBC 嵌入应用并路由到两个 MySQL 数据源
这种模式直接以 JAR 包形式嵌入 Java 应用,没有额外的网络开销,性能最好。但缺点是只能给 Java 用。
ShardingSphere-Proxy(独立代理):
 多语言应用通过 ShardingSphere-Proxy 访问两个 MySQL 数据源
Proxy 模式对外伪装成一个 MySQL 或 PostgreSQL 实例,任何语言的应用都可以直接连接,非常灵活。
下面我们用 Docker Compose 搭建一个 ShardingSphere-Proxy + 2 个 MySQL 实例的环境:
1# docker-compose.yml23> **本章目标**:掌握本章核心知识点4> **前置要求**:完成前序章节学习5> **预计时长**:60 分钟67version: '3.8'89services:10 mysql-ds0:11 image: mysql:8.012 container_name: mysql-ds013 environment:14 MYSQL_ROOT_PASSWORD: root12315 MYSQL_DATABASE: ds_016 ports:17 - "3307:3306"18 command: --default-authentication-plugin=mysql_native_password1920 mysql-ds1:21 image: mysql:8.022 container_name: mysql-ds123 environment:24 MYSQL_ROOT_PASSWORD: root12325 MYSQL_DATABASE: ds_126 ports:27 - "3308:3306"28 command: --default-authentication-plugin=mysql_native_password2930 shardingsphere-proxy:31 image: apache/shardingsphere-proxy:5.5.032 container_name: ss-proxy33 ports:34 - "3309:3307"35 volumes:36 - ./conf:/opt/shardingsphere-proxy/conf37 depends_on:38 - mysql-ds039 - mysql-ds1创建 conf/config-sharding.yaml:
1# conf/config-sharding.yaml2databaseName: sharding_db34dataSources:5 ds_0:6 url: jdbc:mysql://mysql-ds0:3306/ds_0?useSSL=false&allowPublicKeyRetrieval=true7 username: root8 password: root1239 connectionTimeoutMilliseconds: 3000010 idleTimeoutMilliseconds: 6000011 maxLifetimeMilliseconds: 180000012 maxPoolSize: 5013 minPoolSize: 114 ds_1:15 url: jdbc:mysql://mysql-ds1:3306/ds_1?useSSL=false&allowPublicKeyRetrieval=true16 username: root17 password: root12318 connectionTimeoutMilliseconds: 3000019 idleTimeoutMilliseconds: 6000020 maxLifetimeMilliseconds: 180000021 maxPoolSize: 5022 minPoolSize: 12324rules:25 - !SHARDING26 tables:27 t_order:28 actualDataNodes: ds_${0..1}.t_order_${0..3}29 tableStrategy:30 standard:31 shardingColumn: order_id32 shardingAlgorithmName: t_order_inline33 keyGenerateStrategy:34 column: order_id35 keyGeneratorName: snowflake36 t_user:37 actualDataNodes: ds_${0..1}.t_user_${0..1}38 databaseStrategy:39 standard:40 shardingColumn: user_id41 shardingAlgorithmName: database_inline42 tableStrategy:43 standard:44 shardingColumn: user_id45 shardingAlgorithmName: t_user_inline4647 shardingAlgorithms:48 database_inline:49 type: INLINE50 props:51 algorithm-expression: ds_${user_id % 2}52 t_order_inline:53 type: INLINE54 props:55 algorithm-expression: t_order_${order_id % 4}56 t_user_inline:57 type: INLINE58 props:59 algorithm-expression: t_user_${user_id % 2}6061 keyGenerators:62 snowflake:63 type: SNOWFLAKE配置解读:
t_user 表按 user_id % 2 分到 ds_0 和 ds_1 两个库user_id % 2 分成 t_user_0 和 t_user_1 两张表t_order 表按 order_id % 4 分成 4 张子表启动后连接代理试试:
1# 启动2docker-compose up -d34# 等待服务就绪后连接5mysql -h 127.0.0.1 -P 3309 -u root -p67# 连上后就像操作普通 MySQL 一样8mysql> USE sharding_db;9mysql> CREATE TABLE t_user (10 user_id BIGINT PRIMARY KEY,11 username VARCHAR(50),12 email VARCHAR(100)13);14mysql> INSERT INTO t_user (user_id, username, email) VALUES (1, 'alice', 'alice@example.com');15mysql> INSERT INTO t_user (user_id, username, email) VALUES (2, 'bob', 'bob@example.com');16-- user_id=1 会被路由到 ds_1.t_user_117-- user_id=2 会被路由到 ds_0.t_user_0优点:
缺点:
ProxySQL 是一个用 C++ 写的高性能 MySQL 代理,它非常轻量——一个二进制文件就能跑起来。
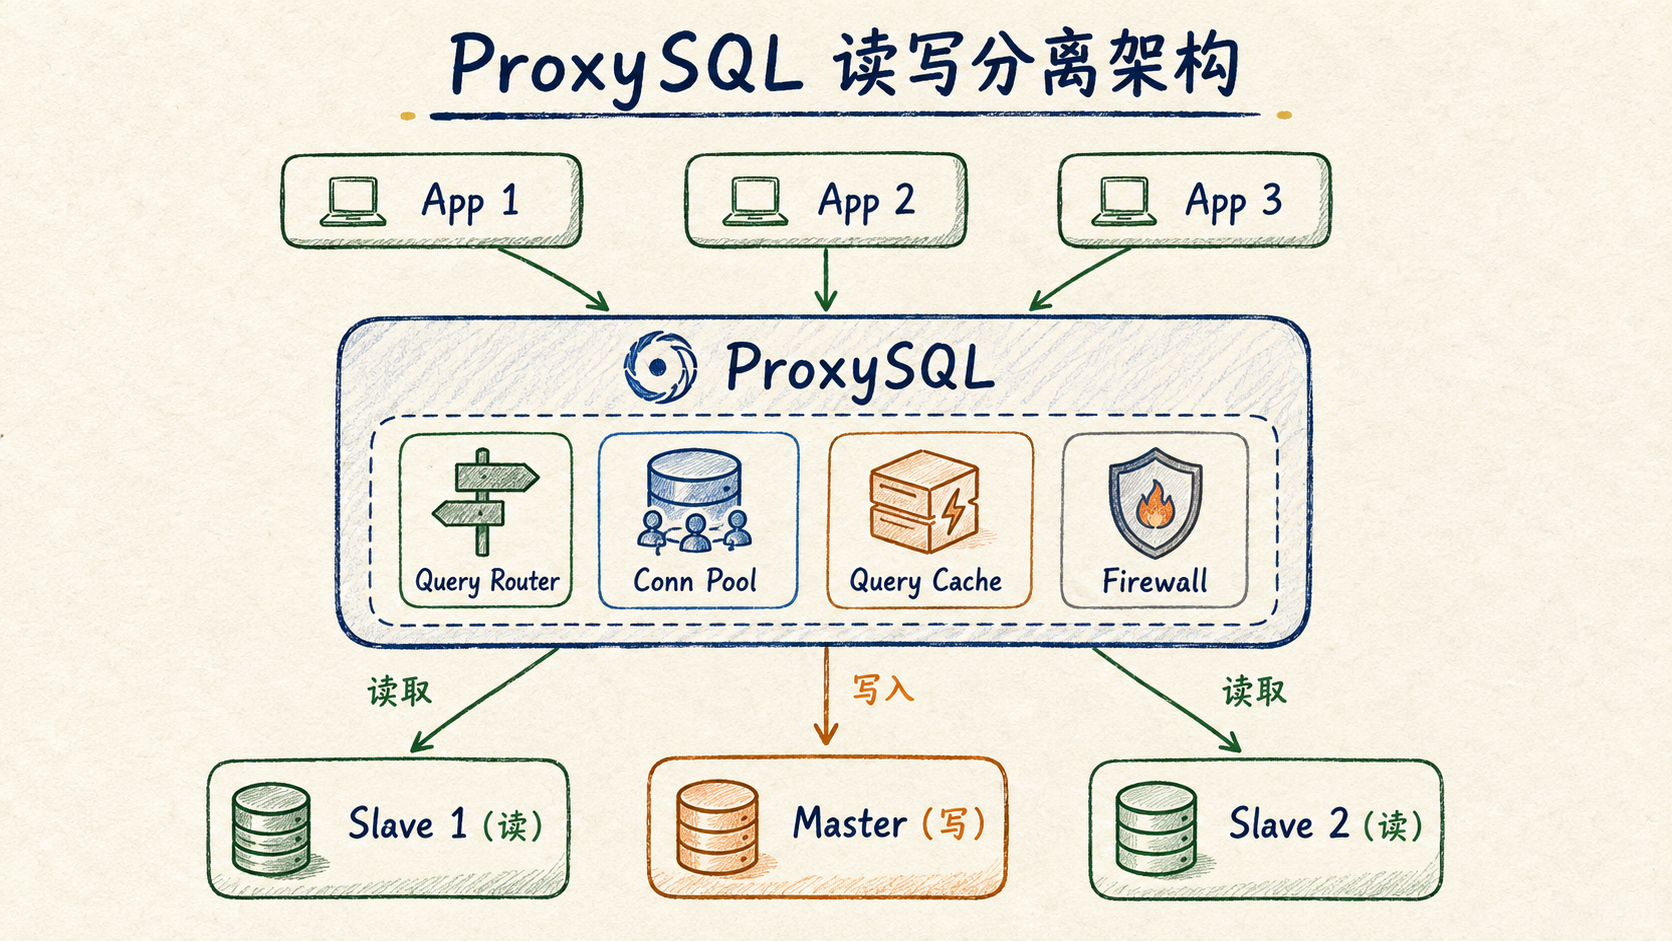 ProxySQL 通过查询路由、连接池、缓存和防火墙实现读写分离
ProxySQL 内部维护了连接池、查询路由引擎、查询缓存和查询防火墙,所有这些功能可以通过它独特的管理接口动态配置,不需要重启。
1# 启动 ProxySQL2docker run -d \3 --name proxysql \4 -p 6033:6033 \5 -p 6032:6032 \6 -v ./proxysql.cnf:/etc/proxysql.cnf \7 proxysql/proxysql:2.6.389# 6033 = MySQL 协议端口(应用连这个)10# 6032 = 管理端口(运维连这个)或者用 Docker Compose 搭建完整的主从 + ProxySQL 环境:
1# docker-compose-proxysql.yml2version: '3.8'34services:5 mysql-master:6 image: mysql:8.07 container_name: mysql-master8 environment:9 MYSQL_ROOT_PASSWORD: root12310 ports:11 - "3310:3306"12 command: >13 --server-id=114 --log-bin=mysql-bin15 --binlog-format=ROW16 --gtid-mode=ON17 --enforce-gtid-consistency=ON1819 mysql-slave:20 image: mysql:8.021 container_name: mysql-slave22 environment:23 MYSQL_ROOT_PASSWORD: root12324 ports:25 - "3311:3306"26 command: >27 --server-id=228 --log-bin=mysql-bin29 --binlog-format=ROW30 --gtid-mode=ON31 --enforce-gtid-consistency=ON32 --read-only=ON33 depends_on:34 - mysql-master3536 proxysql:37 image: proxysql/proxysql:2.6.338 container_name: proxysql39 ports:40 - "6033:6033"41 - "6032:6032"42 volumes:43 - ./proxysql.cnf:/etc/proxysql.cnf44 depends_on:45 - mysql-master46 - mysql-slaveProxySQL 最有意思的地方是它的管理接口——你通过 MySQL 客户端连上管理端口,直接用 SQL 来配置:
1# 连接管理接口2mysql -h 127.0.0.1 -P 6032 -u admin -padmin1-- 第一步:添加后端 MySQL 服务器2-- hostgroup_id=10 是写组,hostgroup_id=20 是读组3INSERT INTO mysql_servers (hostgroup_id, hostname, port, max_connections)4VALUES5 (10, 'mysql-master', 3306, 100),6 (20, 'mysql-slave', 3306, 100);78-- 第二步:配置读写分离规则9INSERT INTO mysql_replication_hostgroups10 (writer_hostgroup, reader_hostgroup, check_type)11VALUES12 (10, 20, 'read_only');1314-- 第三步:添加用户15INSERT INTO mysql_users (username, password, default_hostgroup)16VALUES ('app_user', 'app_password', 10);1718-- 第四步:加载配置并持久化19LOAD MYSQL SERVERS TO RUNTIME;20SAVE MYSQL SERVERS TO DISK;21LOAD MYSQL USERS TO RUNTIME;22SAVE MYSQL USERS TO DISK;ProxySQL 的查询规则非常强大,你可以用正则表达式把特定查询路由到指定的 hostgroup:
1-- 所有 SELECT 语句路由到读组(hostgroup 20)2INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, apply)3VALUES (1, 1, '^SELECT.*', 20, 1);45-- 但是 SELECT ... FOR UPDATE 路由到写组(hostgroup 10)6INSERT INTO mysql_query_rules (rule_id, active, match_pattern, destination_hostgroup, apply)7VALUES (2, 1, '^SELECT.*FOR UPDATE$', 10, 1);89-- 拦截不带 WHERE 的 DELETE(查询防火墙)10INSERT INTO mysql_query_rules (rule_id, active, match_pattern, error_msg, apply)11VALUES (3, 1, '^DELETE\s+FROM\s+\w+\s*$', 'Dangerous! DELETE without WHERE is blocked.', 1);1213-- 缓存某些热点查询 10 秒14INSERT INTO mysql_query_rules (rule_id, active, match_pattern, cache_ttl, destination_hostgroup, apply)15VALUES (4, 1, '^SELECT.*FROM\s+hot_config', 10000, 20, 1);1617-- 加载生效18LOAD MYSQL QUERY RULES TO RUNTIME;19SAVE MYSQL QUERY RULES TO DISK;ProxySQL 内置了丰富的统计表,可以直接查询:
1-- 连上管理端口后23-- 查看连接池状态4SELECT hostgroup, srv_host, status, ConnUsed, ConnFree, ConnOK, ConnERR5FROM stats_mysql_connection_pool;67-- 查看查询统计(哪些查询最慢?)8SELECT hostgroup, digest_text, count_star, sum_time_us,9 ROUND(sum_time_us/count_star) AS avg_time_us10FROM stats_mysql_query_digest11ORDER BY sum_time_us DESC12LIMIT 10;1314-- 查看查询规则命中情况15SELECT rule_id, hits, match_pattern16FROM stats_mysql_query_rules17ORDER BY hits DESC;这些统计数据对于性能调优非常有价值。你还可以接入 Prometheus + Grafana 实现可视化监控。
优点:
缺点:
Vitess 是 YouTube 为了解决 MySQL 扩展性问题而开发的,现在是 CNCF 毕业项目。它的架构比前两个复杂得多:
 Vitess 的 VTGate、VTTablet、MySQL 分片与拓扑服务
三个核心组件:
Vitess 天然适合 Kubernetes,官方提供 Operator:
1# 安装 Vitess Operator2kubectl apply -f https://github.com/planetscale/vitess-operator/releases/latest/download/operator.yaml定义一个最简单的 Vitess 集群:
1# vitess-cluster.yaml2apiVersion: planetscale.com/v23kind: VitessCluster4metadata:5 name: my-vitess6spec:7 images:8 vtgate: vitess/lite:v19.0.09 vttablet: vitess/lite:v19.0.010 vtbackup: vitess/lite:v19.0.011 mysqld:12 mysql80Compatible: vitess/lite:v19.0.013 vtctld: vitess/lite:v19.0.01415 cells:16 - name: zone117 gateway:18 replicas: 219 resources:20 requests:21 cpu: 500m22 memory: 512Mi2324 keyspaces:25 - name: commerce26 turndownPolicy: Immediate27 partitionings:28 - equal:29 parts: 230 shardTemplate:31 databaseInitScriptSecret:32 name: commerce-schema33 key: init_db.sql34 tabletPools:35 - cell: zone136 type: replica37 replicas: 238 mysqld:39 resources:40 requests:41 cpu: 500m42 memory: 1Gi43 dataVolumeClaimTemplate:44 accessModes: ["ReadWriteOnce"]45 resources:46 requests:47 storage: 10Gi4849 etcd:50 createEtcdClusters:51 zone1:52 replicas: 353 resources:54 requests:55 cpu: 200m56 memory: 256Mi1kubectl apply -f vitess-cluster.yaml对于本地测试,Vitess 也提供了 Docker Compose 方式:
1git clone https://github.com/vitessio/vitess.git2cd vitess/examples/compose3docker-compose up -dVitess 使用 VSchema 来定义分片策略:
1{2 "sharded": true,3 "vindexes": {4 "hash": {5 "type": "hash"6 }7 },8 "tables": {9 "users": {10 "column_vindexes": [11 {12 "column": "user_id",13 "name": "hash"14 }15 ]16 },17 "orders": {18 "column_vindexes": [19 {20 "column": "user_id",21 "name": "hash"22 }23 ]24 }25 }26}这里 users 和 orders 都按 user_id 的 hash 来分片,好处是同一个用户的订单和用户信息在同一个分片上,JOIN 查询不需要跨分片。
Vitess 的用户名单非常亮眼:
优点:
缺点:
来一张表格直观对比:
推荐:ShardingSphere
如果你的技术栈是 Java,而且主要需求是分库分表,ShardingSphere 是首选。用 JDBC 模式零额外开销,用 Proxy 模式也能服务非 Java 应用。
典型场景:电商订单表按用户 ID 分片,每个库放一部分用户的数据。
选择 ShardingSphere-JDBC 如果: ✓ 纯 Java 应用 ✓ 对性能极致追求 ✓ 不想多维护一个代理服务
选择 ShardingSphere-Proxy 如果: ✓ 多语言应用需要访问 ✓ 想统一管理分片策略 ✓ DBA 需要独立管理中间件
推荐:ProxySQL
如果你的 MySQL 已经搭好了主从,只需要做读写分离和连接池管理,ProxySQL 是最简单高效的方案。部署简单、配置灵活、资源占用少。
典型场景:Web 应用的数据库连接数暴涨,需要连接复用;读多写少的场景需要自动路由。
选择 ProxySQL 如果: ✓ 已有 MySQL 主从架构 ✓ 不需要分库分表 ✓ 想要最轻量的方案 ✓ 需要查询级别的精细控制 ✓ 运维团队偏好命令行管理
推荐:Vitess
如果你的业务跑在 Kubernetes 上,数据量增长快,需要弹性的水平扩展能力,Vitess 是最佳选择。特别是当你的数据量和并发量达到一定规模后,Vitess 的优势会更加明显。
典型场景:SaaS 平台按租户分片,数据量从 TB 级增长到 PB 级。
选择 Vitess 如果: ✓ 跑在 Kubernetes 上 ✓ 数据量大,需要水平扩展 ✓ 需要在线 Resharding ✓ 团队有足够的技术实力 ✓ 业务规模值得这个投入
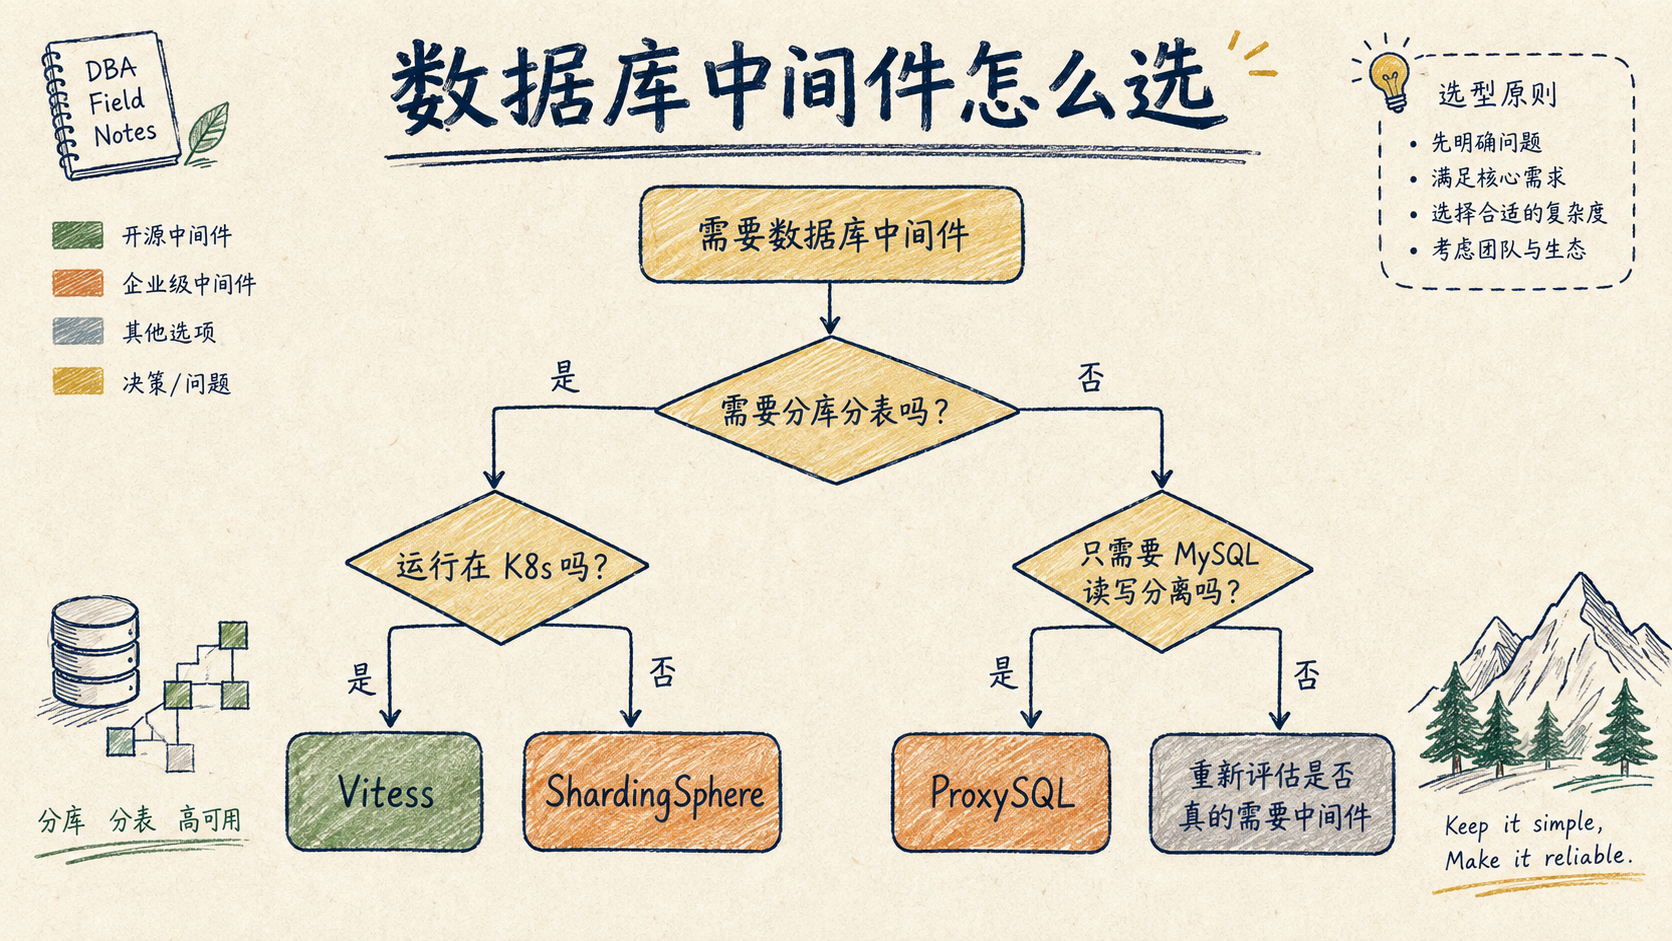 根据分库分表、K8s 与读写分离需求选择数据库中间件
答案是:可以的。
一个常见的组合是 ProxySQL + ShardingSphere:
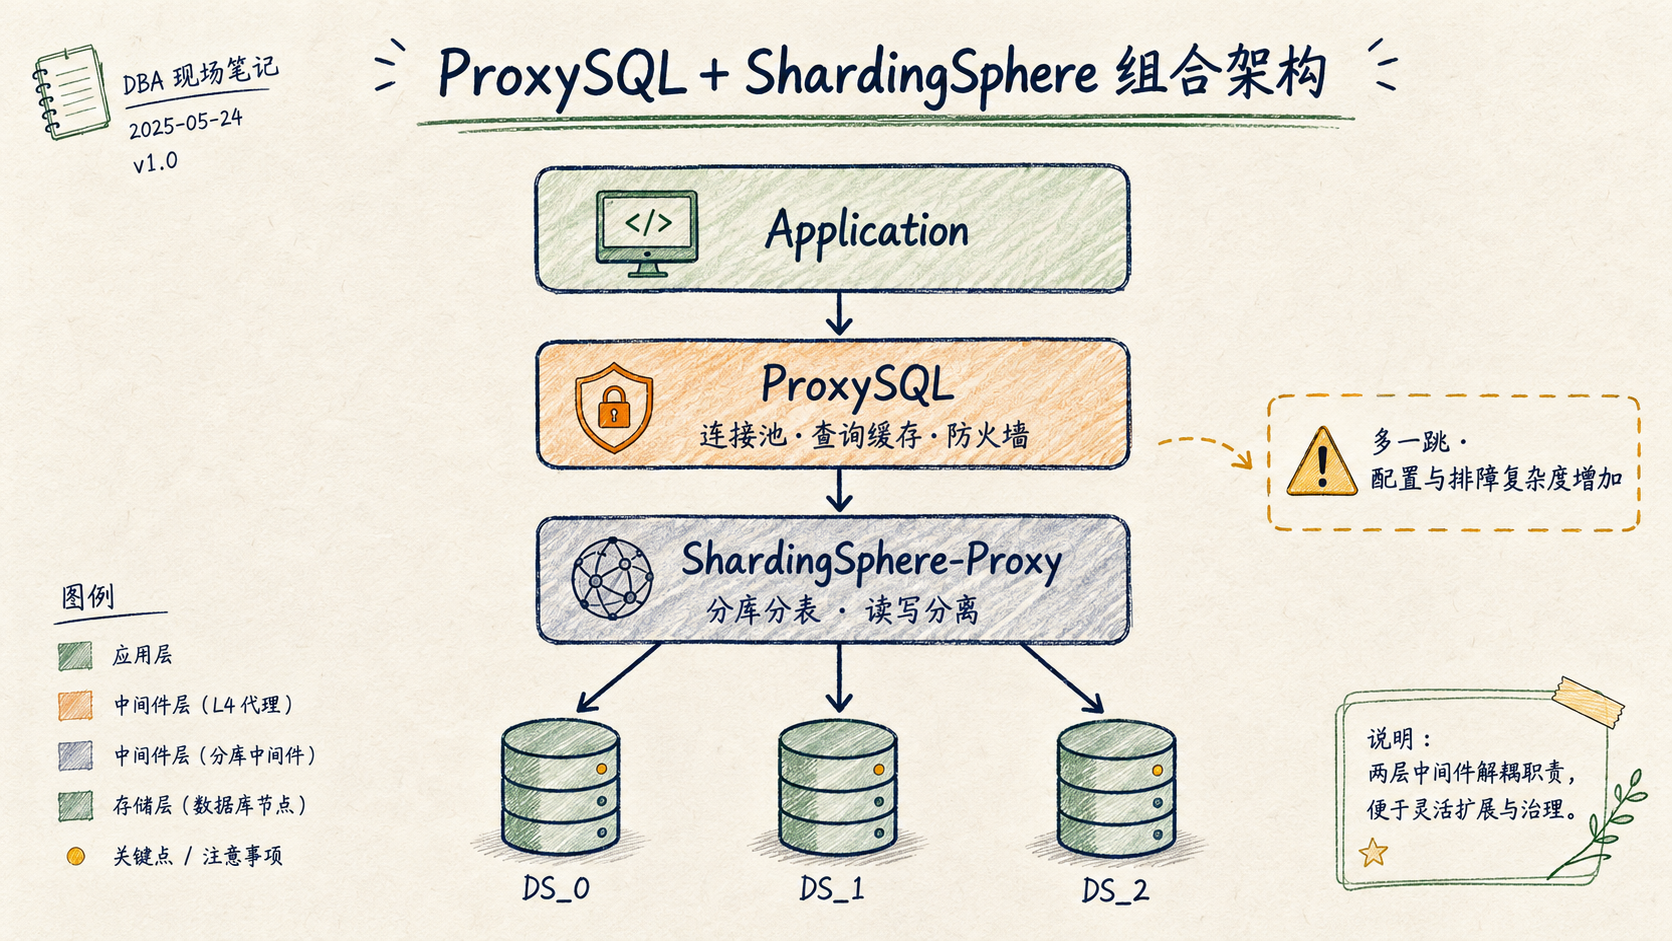 ProxySQL 与 ShardingSphere-Proxy 组合后的分层架构
这个组合的优势:
但要注意,组合使用也带来了额外的复杂度:
所以除非你确实同时需要两者的独有功能,否则不建议叠加使用。大多数场景下,选一个就够了。
另一个值得提的组合是 ProxySQL + Vitess,不过 Vitess 自带的 VTGate 已经覆盖了 ProxySQL 的大部分功能(连接池、查询路由),所以重叠度比较高,一般不推荐。
最后用一句话概括每个工具的定位:
没有最好的中间件,只有最适合的。先搞清楚你的核心需求(分片?读写分离?连接管理?弹性扩展?),再结合团队技术栈和运维能力做决策。
如果你还是拿不定主意,我的建议是:
希望这篇文章能帮你在中间件选型上少走弯路。有问题欢迎留言讨论!
本章介绍了以下核心内容: