高可用 & 容灾19 分钟阅读
达梦 DM8 数据守护实时主备运维 100 条命令
DM8 数据守护通过实时归档把主库 Redo 送到备库,备库再重演日志。守护进程负责监控和处理状态,监视器汇总主备信息并参与切换确认。备库落后时,看一个 LSN 差值还不够:守护进程是否在线、归档是否有效、日志是否已送达,以及备库重演是否跟得上,要分开查。
2026年9月16日阅读—点赞—收藏—
dba100damengscenario
100 条命令系列文章专栏
DM8 数据守护通过实时归档把主库 Redo 送到备库,备库再重演日志。守护进程负责监控和处理状态,监视器汇总主备信息并参与切换确认。备库落后时,看一个 LSN 差值还不够:守护进程是否在线、归档是否有效、日志是否已送达,以及备库重演是否跟得上,要分开查。
DM8 数据守护通过实时归档把主库 Redo 送到备库,备库再重演日志。守护进程负责监控和处理状态,监视器汇总主备信息并参与切换确认。备库落后时,看一个 LSN 差值还不够:守护进程是否在线、归档是否有效、日志是否已送达,以及备库重演是否跟得上,要分开查。
这篇从监视器的组状态入手,再到两端数据库和归档链路,整理日常巡检与切换前检查常用命令。主备状态发生变化时可以按这个顺序查,建议先收藏,现场查数不用临时翻几份手册。
示例采用 Linux、DM8 与数据守护 V4.0 的一组单节点实时主备。监视器命令在 dmmonitor 提示符输入;SQL 用 DIsql 在注明的主库或备库执行。组名、实例名和文件路径按现场替换。接管与切换命令留在诊断之后。
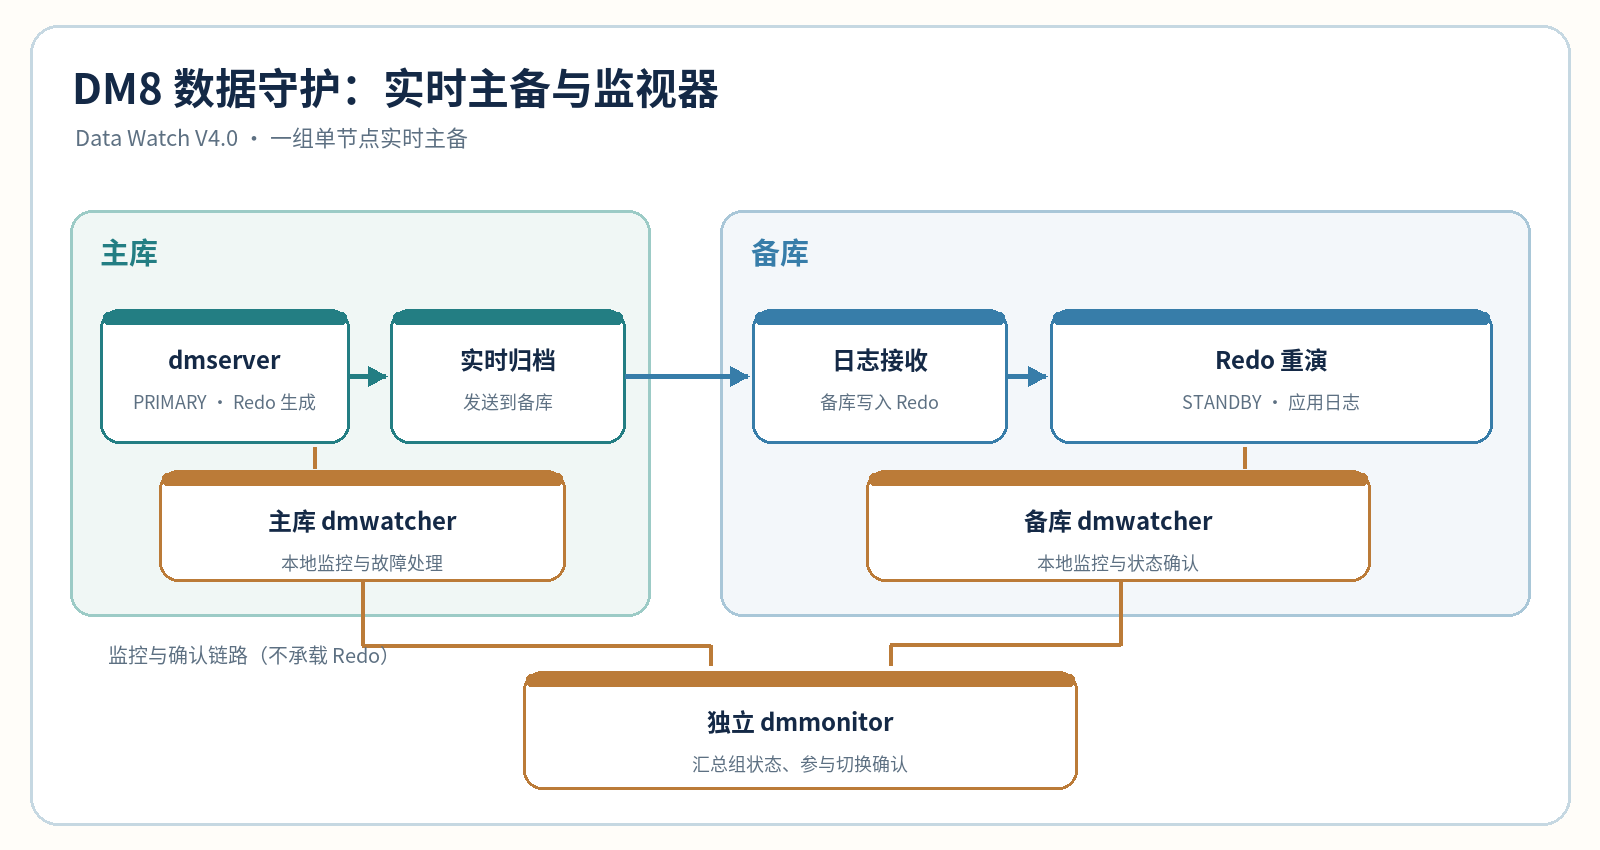 DM8 数据守护实时主备、两端守护进程与独立监视器示意
上半部分是 Redo 从主库实时归档到备库并完成重演;两端 dmwatcher 和独立 dmmonitor 负责状态监控与切换确认,不负责搬运 Redo。
1-- 主库、备库各执行一次2SELECT INSTANCE_NAME, HOST_NAME, SVR_VERSION,3 STATUS$, MODE$, OGUID4FROM V$INSTANCE;正常组里主库是 PRIMARY,备库是 STANDBY,两端 OGUID 应与监视器组配置一致。这里检查角色和实例状态,不通过 SQL 直接改模式;数据守护运行中,随意改角色会干扰守护进程判断。
1show version在 dmmonitor 输入。输出中的数据守护版本要与服务器、守护进程匹配;版本不一致时可能无法建立监控连接。这个命令显示的是监视器本身,数据库版本仍要看第 1 条。
1show global info先找组名、OGUID、主备模式、WSTATUS、INST_OK 和备库的 RSTAT。show global info 是概览;某个库异常后用 show database 下探,不能在概览里看不到节点细节就推断每个实例都健康。
1show GRP1组里应只有一个活动主库。主库、备库的 IMODE、ISTATUS、守护进程 WSTATUS 和归档 RSTAT 要一起看;备库 RSTAT=Invalid 时不能把它当成可立即接管的健康备库。
1show database GRP1.DMSTANDBY单节点库可用实例名作 db_name。重点看 FLSN、SLSN、RLSN 和待重演任务数:主库已生成日志与备库已写入、可重演、已重演是不同阶段。LSN 接近只能粗看同步,切换仍需查归档状态和恢复条件。
1list GRP1.DMSTANDBY用来核对该备库的守护类型、组名、OGUID、实例路径和切换模式。监视器的 show 反映运行状态,list 反映接收到的守护配置;两者不一致时先排查旧配置或误连的监视器。
1show arch send info GRP1.DMSTANDBY该命令显示源库到指定备库的归档同步与恢复间隔信息。若归档状态无效,先看发送是否持续、最近一次失败及主备网络,再判断是否进入 Recovery;不要直接触发切换来验证备库。
1show apply stat GRP1.DMSTANDBY输出包含接收日志长度、等待时间和实际重演耗时,单位有字节和微秒。备库 LSN 落后而发送正常时,用它判断是否卡在重演阶段;近期均值和单次最大耗时不能混为一谈。
1-- 主库执行;备库上的 REALTIME 归档状态为 NULL2SELECT ARCH_TYPE, ARCH_DEST, ARCH_STATUS, ARCH_SRC3FROM V$ARCH_STATUS4WHERE ARCH_TYPE = 'REALTIME';ARCH_STATUS=VALID 才说明这条归档链路有效;INVALID 要继续查目标实例、网络和主库日志。备库查询 REALTIME 的状态列会是 NULL,不能拿这个值判定传输故障。
1-- 主库执行;恢复完成后可能查不到记录2SELECT PRIMARY_NAME, STANDBY_NAME, PRIM_LSN, SEND_LSN,3 KBYTES_TOTAL, KBYTES_TO_RECOVER, FILES_TO_RECOVER,4 RECOVER_PERCENT5FROM V$RECOVER_STATUS;这里的百分比是主库发送进度。即使 RECOVER_PERCENT=100%,备库最后一批日志仍可能在重演;再用监视器检查 RLSN 与守护进程状态,不能把 100% 当成备库恢复完成。
1status在主、备节点各自的 dmwatcher 控制台输入。核对 GROUP_NAME、DW_STATUS 和 DW_SUB_STATUS;监视器报节点异常时,先确认本地守护进程是否仍在运行。
1show link在对应节点的 dmwatcher 控制台输入。它只列出当前正常的 TCP 连接,包括本地数据库、对端守护进程及监视器;断开的连接不会出现在结果里。缺少预期对端时,再检查地址、端口和守护进程日志。
1show monitor GRP1.DMSTANDBY在 dmmonitor 输入。切换前先确认当前普通监视器或确认监视器确实连上目标守护进程;看到多台监视器还要辨认谁有确认职责,不要把“监视器在线”直接等同于“自动接管可用”。
1tip在 dmmonitor 输入,用于快速查看系统当前运行状态。提示只能帮助决定下一步查哪一库;归档是否有效、备库 LSN 是否追平仍要用第 4、5、7 条核对。
1show open info GRP1.DMSTANDBY在 dmmonitor 输入。备库曾重启或模式变化时,OPEN 历史有助于对齐故障时间;它不是当前角色的唯一证据,回到第 1、5 条看此刻 MODE$ 和监视器状态。
1get takeover time GRP1在 dmmonitor 输入。主库正常退出且配置了 MON_TAKEOVER_SHUTDOWN 等待时,这条会给出剩余等待时间;主备正常时可能显示无自动接管实例。等待到零也不代表备库一定有完整日志,接管条件还要单独检查。
1-- 主库 DIsql 执行2SELECT ARCH_DEST, ARCH_TYPE,3 LAST_START_TIME, LAST_END_TIME,4 LAST_SEND_LSN, LAST_SEND_LEN,5 LAST_SEND_TIME6FROM V$ARCH_SEND_INFO7WHERE ARCH_DEST = 'DMSTANDBY';LAST_SEND_TIME 单位微秒,长度单位字节。连续留两次读数,看发送时间和 LSN 是否推进;一条记录很旧,才去查守护连接、实时归档状态和网络,而不是拿主备 LSN 差值直接判重演慢。
1-- 主库 DIsql 执行2SELECT ARCH_DEST, FOR_RECOVERY,3 LAST_SEND_CODE, LAST_SEND_DESC,4 TOTAL_SEND_CNT, TOTAL_SEND_LEN5FROM V$ARCH_SEND_INFO6WHERE ARCH_DEST = 'DMSTANDBY';异步恢复失败时,LAST_SEND_CODE、LAST_SEND_DESC 是直接线索。累计发送次数和长度是自统计起点以来的数,不能当成事故窗口内的实时流量;要与第 17 条最后发送时间一起看。
1-- 备库 DIsql 执行2SELECT SEQNO, TSK_MEM_USED,3 TOTAL_RECVED_NUM, TOTAL_RECVED_LEN,4 TOTAL_APPLY_NUM, TOTAL_APPLY_LEN,5 TOTAL_WAIT_TIME, TOTAL_APPLY_TIME6FROM V$RAPPLY_STAT;TSK_MEM_USED 是待重做任务占用的内存字节数;收包和重演累计量的统计口径不同,不能简单相减得“还差多少字节”。同一备库隔一段时间采样,看收包是否增长、重演是否跟上,才容易区分传输与应用阶段。
1-- 备库 DIsql 执行2SELECT SEQNO, LAST_RECVED_LEN,3 LAST_RECVED_TIME, LAST_WAIT_TIME,4 LAST_APPLY_LEN, LAST_APPLY_TIME,5 LAST_CMT_TIME6FROM V$RAPPLY_STAT;几个耗时字段单位都是微秒。LAST_CMT_TIME 是备库最新解析到的主库提交记录时间戳,不是业务从备库读到该记录的保证;它要与监视器 RLSN、最近发送时间一起核对。
1-- 备库 DIsql 执行2SELECT DSC_SEQNO, APPLY_PKG_SEQ, APPLY_LSN,3 REDOS_PARALLEL_NUM, REDO_LSN_ARR,4 RPKG_SEQ, RPKG_LSN5FROM V$RAPPLY_PARALLEL_INFO;单节点主库的 DSC_SEQNO 通常为 0。APPLY_LSN 是备库已写入联机日志的原始 LSN,RPKG_LSN 是已重演日志包的 LSN;不能把“已接收”写成“已应用”。REDO_LSN_ARR 能看各路重演线程是否有某一路明显落后。
1-- 主库、备库分别执行2SELECT DW_CONN_TIME, MON_CONFIRM,3 MID, MON_IP, MON_VERSION,4 HP_FLAG5FROM V$DMMONITOR;视图只列当前有效的监视器连接,主备两端都查,确认连接到的是预期监视器。MON_CONFIRM 说明是否确认监视器;HP_FLAG 提示监视器日志堆积,不是主备 Redo 积压。没有记录先排查连接和监视器部署,不要以为自动接管仍可正常完成。
1check recover GRP1.DMSTANDBY备库故障恢复后迟迟不同步,用这条直接看不满足 Recovery 的原因。不要用重启守护进程代替条件检查。
1check open GRP1.DMSTANDBY实例停在 MOUNT 时先执行。输出会说明守护进程为何没有通知数据库执行 OPEN FORCE。
1check open GRP1.DMPRIMARY主库重启后没有自动 OPEN,也应检查组内其他库、守护状态和归档关系,不能只看本机实例。
1show arch send info GRP1.DMSTANDBY输出中同时包含归档发送和 Recovery 间隔。它比只看 dmwatcher.ini 更接近守护进程当前内存值。
1set database GRP1.DMSTANDBY recover time 60只修改守护进程内存值,范围 3—86400 秒。完成一次 Recovery 后,内存值可能按处理结果重置。
1set group GRP1 recover time 60要求主库及主库守护进程正常。多备库环境会逐个生效,执行后分别回读。
1open database GRP1.DMSTANDBY正常情况下应由守护进程自动 OPEN。只有 check open 确认条件并按处置方案要求时才执行。
1startup dmwatcher database GRP1.DMSTANDBYWSTATUS=Shutdown 时使用。命令启动的是守护进程监控功能,不等于启动数据库实例。
1stop dmwatcher database GRP1.DMSTANDBY维护前使用。监控关闭后自动恢复和切换能力会受影响,维护结束要明确恢复。
1startup database GRP1.DMSTANDBY若 INST_AUTO_RESTART=1,守护进程会自动拉起实例,命令方式可能被拒绝。先看当前策略。
1stop database GRP1.DMSTANDBY用于维护窗口内受控停库。执行后检查守护监控是否仍开启,避免数据库被自动拉起。
1kill database GRP1.DMSTANDBY高风险命令,只用于实例无法正常退出且已有故障方案的场景。不要作为日常停库方式。
1detach database GRP1.DMSTANDBY分离前确认组内仍有可用容灾副本,并记录归档缺口。分离不是修复,只是隔离异常成员。
1attach database GRP1.DMSTANDBY重新加入前核对模式、OGUID、守护配置和恢复条件。加入后持续观察归档状态与 LSN 推进。
1grep -Ev '^\s*(#|$)' /dm/data/DAMENG/dmarch.ini重点核对归档类型、目标实例名和本地归档目录。主备两端配置含义不同,不要求文件逐字相同。
1grep -Ev '^\s*(#|$)' /dm/data/DAMENG/dmmal.ini实例名、MAL 地址、端口和组信息要与监视器看到的实例一致。
1grep -Ev '^\s*(#|$)' /dm/data/DAMENG/dmwatcher.ini核对组名、OGUID、守护类型、实例路径和自动重启策略。两个节点的角色配置不能复制错位。
1grep -Ev '^\s*(#|$)' /dm/monitor/dmmonitor.ini确认主备守护地址、确认监视器开关及组信息。确认监视器不应与主库或备库共故障域。
1grep -Hi 'OGUID' /tmp/primary.dmwatcher.ini /tmp/standby.dmwatcher.ini /tmp/dmmonitor.ini把三份文件复制到独立检查机后比对。OGUID 不一致时监视器不会把它们当成同一守护组。
1ss -lntp | grep dmserver进程监听只证明本机端口已打开,还要从对端实际测试连通性。
1nc -vz 192.168.100.12 5336地址和端口按 dmmal.ini 替换。主备双向测试并记录结果。
1nc -vz 192.168.100.11 52141确认监视器能独立访问主、备守护进程。只通一端时无法获得完整判断信息。
1nc -vz 192.168.100.12 52141确认监视器到备库的链路不经过主库故障点,避免主库故障时监视器同时失联。
1ping -c 30 192.168.100.12两端互测。没有业务写入时网络中断可能暂时不触发归档异常,因此不能只看数据库仍为 OPEN。
1date '+%F %T.%N %z'两端和监视器都执行。时间一致有利于对齐数据库、守护和操作系统日志。
1df -h /dm/arch本地归档盘满会中断归档链路。报警阈值要考虑清理周期和业务高峰增长。
1df -h /dm/data备库空间不足会拖慢或中断重演。还要检查 inode 和底层存储延迟。
1df -i /dm/arch大量小文件可能先耗尽 inode。容量百分比正常时也不能忽略 inode。
1find /dm/arch -maxdepth 1 -type f -printf '%TY-%Tm-%Td %TT %s %f\n' | sort | tail -20文件时间持续更新只能证明本地归档仍产生,不能替代实时归档发送和备库重演检查。
1ps -ef | grep '[d]mwatcher'确认启动用户、配置文件路径和进程 PID。进程存在不等于守护状态为 OPEN。
1ps -ef | grep '[d]mmonitor'确认监视器运行在预期独立节点。自动接管场景必须确保确认监视器从故障前就持续在线。
1ps -ef | grep '[d]mserver'核对主备实例实际使用的 dm.ini,避免检查了未被进程加载的旧配置。
1grep -E 'ERROR|FATAL' /dm/dmdbms/log/dm_DMSERVER_$(date +%Y%m)*.log路径按现场调整。围绕归档失效时间查看上下文,不要只保存错误关键词。
1grep -E 'ERROR|FATAL|Invalid|Recovery' /dm/dmdbms/log/dmwatcher*.log | tail -100主库守护日志能看到归档状态变化、Recovery 判断和对端连接异常。
1grep -E 'ERROR|FATAL|Invalid|Recovery' /dm/dmdbms/log/dmwatcher*.log | tail -100在备库执行并对齐同一时间窗。主备两侧日志必须一起看。
1tail -n 200 /dm/monitor/log/dmmonitor*.log确认监视器何时失联、何时确认故障以及是否执行过切换命令。
1journalctl --since '2026-09-16 10:00:00' --until '2026-09-16 10:30:00' | grep -Ei 'link|network|timeout|reset'时间换成故障窗口。链路抖动可能同时影响归档和监视器确认。
1dmesg -T | grep -Ei 'I/O error|timeout|reset|scsi|nvme'备库重演慢时,先排除磁盘延迟和设备错误,再考虑调整重演相关参数。
1choose switchover GRP1监视器会列出满足条件的备库。列表为空时先处理状态、归档或 LSN 问题,不要转用强制接管。
1show database GRP1.DMSTANDBY确认备库为 STANDBY、Open,守护进程正常,归档有效且重演进度已追平。
1show database GRP1.DMPRIMARY计划切换要求原主库也正常 Open。异常主库应走接管流程,不应硬套 Switchover。
1-- 当前主库2SELECT ARCH_TYPE, ARCH_DEST, ARCH_STATUS3FROM V$ARCH_STATUS4WHERE ARCH_TYPE = 'REALTIME';所有目标备库归档状态应有效。存在 INVALID 时先恢复链路。
1-- 目标备库2SELECT TOTAL_RECVED_NUM, TOTAL_APPLY_NUM,3 LAST_CMT_TIME, TSK_MEM_USED4FROM V$RAPPLY_STAT;与监视器 LSN 一起确认,而不是用累计包数简单相减。
1switchover GRP1.DMSTANDBY这是角色变更操作,需要登录监视器并在维护窗口执行。切换期间暂停业务写入或按应用方案摘流。
1switchover 1序号必须来自刚执行的 choose switchover 结果。候选列表变化后重新选择,不能沿用旧序号。
1show GRP1确认新主库唯一、原主库转为备库,所有守护进程和归档状态恢复正常。
1SELECT INSTANCE_NAME, STATUS$, MODE$, OGUID2FROM V$INSTANCE;两个节点分别执行。一个 PRIMARY、一个 STANDBY 才符合预期。
1-- 新主库2SELECT ARCH_DEST, ARCH_TYPE, ARCH_STATUS, ARCH_SRC3FROM V$ARCH_STATUS4WHERE ARCH_TYPE = 'REALTIME';切换完成后归档方向会反转。确认新主库到新备库的链路已有效。
1choose takeover GRP1优先使用正常接管。它要求监视器掌握故障主库的历史信息,并且组内不存在活动主库。
1show database GRP1.DMPRIMARY记录故障前模式、LSN、守护状态和归档关系。不能仅凭 ping 不通就判断主库已经安全隔离。
1show database GRP1.DMSTANDBY保存 FLSN、SLSN、RLSN 和归档状态,用于评估潜在数据缺口。
1takeover GRP1.DMSTANDBY执行前必须隔离故障主库的业务与网络回流风险。完成后立即验证唯一主库和应用连接。
1takeover 1序号必须来自本次 choose takeover。不要把 Switchover 候选序号拿来使用。
1choose takeover force GRP1只有没有正常接管候选、业务必须恢复时才评估。监视器通常选择 KLSN 最大的备库。
1takeover force GRP1.DMSTANDBY高风险操作,可能造成数据缺失或双主。必须先完成原主库隔离、缺口评估和业务授权。
1show global info确认所有组只有一个活动主库,异常旧主库没有重新上线成为第二个 PRIMARY。
1SELECT INSTANCE_NAME, STATUS$, MODE$, OGUID2FROM V$INSTANCE;在新主库执行,并做一条业务只读探测。角色正确不等于应用已经恢复。
1show link在新主库 dmwatcher 控制台查看。确认数据库、对端守护和监视器连接符合当前拓扑。
1clear database GRP1.DMSTANDBY arch send info只清理最近 N 次监控统计,不删除归档文件。清理前先导出故障证据。
1clear group GRP1 arch send info用于重新建立统计基线。多备库环境执行后会影响整组观察数据。
1clear database GRP1.DMSTANDBY apply stat不会回退重演位置,只清理监视器记录的近期统计。事故分析完成前不要执行。
1clear group GRP1 apply stat整组建立新基线时使用。执行后要重新采样,不能和清理前累计值直接比较。
1SELECT PARA_NAME, PARA_VALUE2FROM V$DM_INI3WHERE PARA_NAME = 'RLOG_SEND_APPLY_MON';该参数影响最近发送和重演统计的保留条数。主备分别核对。
1grep -i 'RLOG_SEND_THRESHOLD' /dm/data/DAMENG/dmwatcher.ini阈值要结合业务写入量设置。配置文件值和守护进程当前内存值需区分。
1grep -i 'RLOG_APPLY_THRESHOLD' /dm/data/DAMENG/dmwatcher.ini阈值过小会频繁告警,过大则延迟发现。先建立正常时段基线。
1grep -i 'INST_AUTO_RESTART' /dm/data/DAMENG/dmwatcher.ini自动重启开启时,手工启动命令可能被拒绝。维护前必须了解当前策略。
1grep -Ei 'DW_ERROR_TIME|INST_ERROR_TIME' /dm/data/DAMENG/dmwatcher.ini故障判定过短可能放大瞬时网络抖动,过长会延迟处理。修改需要整体评估。
1grep -i 'INST_SERVICE_IP_CHECK' /dm/data/DAMENG/dmwatcher.ini服务 IP 是切换后业务入口的重要组成,策略要和 VIP 管理方式一致。
1show GRP1同时核对 IMODE、ISTATUS、WSTATUS 和 RSTAT,不能只数 PRIMARY 字样。
1SELECT INSTANCE_NAME, HOST_NAME, STATUS$, MODE$, OGUID2FROM V$INSTANCE;主备各执行一次并保存时间。结果应与监视器一致。
1-- 当前主库2SELECT ARCH_DEST, ARCH_STATUS, ARCH_SRC3FROM V$ARCH_STATUS4WHERE ARCH_TYPE = 'REALTIME';所有预期备库均应有效,并且目标实例名正确。
1-- 当前主库,间隔采样2SELECT ARCH_DEST, LAST_END_TIME, LAST_SEND_LSN,3 LAST_SEND_CODE, LAST_SEND_DESC4FROM V$ARCH_SEND_INFO;连续两次读取,确认发送 LSN 和结束时间继续变化且最近错误已消失。
1-- 当前备库,间隔采样2SELECT LAST_CMT_TIME, LAST_APPLY_LEN,3 LAST_APPLY_TIME, TSK_MEM_USED4FROM V$RAPPLY_STAT;业务有写入时,提交时间和重演统计应继续推进。
1SELECT DSC_SEQNO, APPLY_LSN, RPKG_LSN,2 REDOS_PARALLEL_NUM, REDO_LSN_ARR3FROM V$RAPPLY_PARALLEL_INFO;多次采样各路位置,排除某一路长时间不动。
1SELECT MON_CONFIRM, MID, MON_IP, MON_VERSION, HP_FLAG2FROM V$DMMONITOR;主备分别执行。确认监视器应持续在线,普通监视器也要与部署清单一致。
1tip提示正常后仍要保留 SQL 和组状态证据,不能只用一条 tip 结束故障。
1show global info将结果、采样时间、变更编号和业务验证一并归档,作为本次切换或恢复记录。
1exit退出只关闭当前监视器客户端,不会停止守护进程或数据库。确认仍有正式监视器持续运行。
DM8 数据守护延迟要拆成三段看:主库有没有继续产生并发送 Redo、网络有没有把日志送到备库、备库重演有没有跟上。计划切换使用 Switchover,主库故障优先正常 Takeover;强制接管必须先隔离原主库并评估数据缺口。
建议把组名、实例名、守护端口和归档目录填进自己的巡检版本。平时把发送、重演和监视器连接基线留好,故障时会快很多。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100