高可用 & 容灾20 分钟阅读
达梦 DMDSC 共享存储集群运维 100 条命令
DMDSC 是多实例同时访问同一套数据库文件的共享存储集群。它能扛单节点故障,但节点间协调、DMCSS 心跳、DMASM 共享存储哪一层出问题,处理方法完全不同。查集群时先看 CSS、ASM 和 DB 三组状态,再到数据库里核对每个 EP 的角色与共享缓冲控制结构。
2026年9月16日阅读—点赞—收藏—
dba100damengscenario
100 条命令系列文章专栏
DMDSC 是多实例同时访问同一套数据库文件的共享存储集群。它能扛单节点故障,但节点间协调、DMCSS 心跳、DMASM 共享存储哪一层出问题,处理方法完全不同。查集群时先看 CSS、ASM 和 DB 三组状态,再到数据库里核对每个 EP 的角色与共享缓冲控制结构。
DMDSC 是多实例同时访问同一套数据库文件的共享存储集群。它能扛单节点故障,但节点间协调、DMCSS 心跳、DMASM 共享存储哪一层出问题,处理方法完全不同。查集群时先看 CSS、ASM 和 DB 三组状态,再到数据库里核对每个 EP 的角色与共享缓冲控制结构。
这篇先整理 DMCSSM 和数据库视图的基础巡检,后面再接故障节点处理。建议收藏,集群异常时也方便把节点状态和实例证据转给同事。
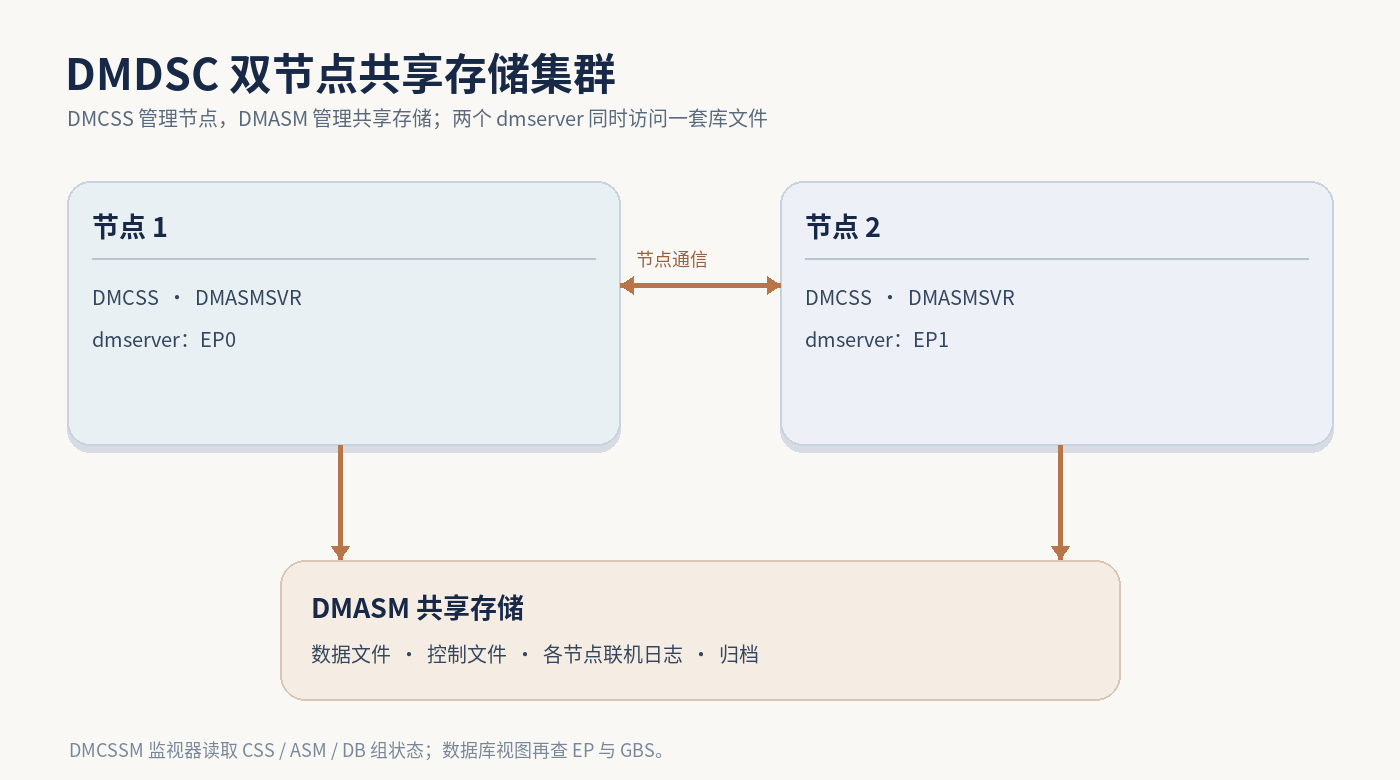 达梦 DMDSC 双节点共享存储架构示意图
示例采用 Linux、DM8 双节点、DMASM 管理共享存储。show 命令在 DMCSSM 交互提示符输入,SQL 在任一 DMDSC 节点 DIsql 执行;GBS 视图逐节点查。组名按现场配置替换。停止、强制打开或故障处理命令会影响集群,后续单列。
1show先对照各组 is_ok、活动节点和组状态。DB 组异常时也要看 ASM 是否正常 OPEN;只盯住数据库实例可能漏掉共享存储层的问题。
1show CSSCSS 是示例组名,以 DCR 配置为准。看两个 CSS 节点是否在线以及当前控制节点是谁。控制节点可能因故障重新选举,不应写死为某一台主机。
1show ASMASM 组未 OPEN 或节点不齐时,DB 组可能无法正常启动。先核对活动的 ASM 节点与共享磁盘状态,再决定是不是数据库自身故障。
1show DB看每个数据库 EP 的活动状态、实例是否打开以及异常节点。DB 仍是示例组名;组级健康和实际连接到某个数据库实例的能力还要相互验证。
1show config核对节点名、序号、地址、组名与 DCR 配置。该输出优先从主 CSS 取得;主 CSS 失效时可能改由其他 CSS 返回,发现配置不一致要先明确读到了哪个节点。
1show monitor多个监视器可以同时接入。这里确认当前监控视角和连接来源;没有监视器连接不等于 CSS 或数据库就一定失效。
1SELECT EP_NAME, EP_SEQNO, EP_MODE, EP_STATUS2FROM V$DSC_EP_INFO3ORDER BY EP_SEQNO;任一数据库节点查询结果应相同。CONTROL NODE 只会有一个;EP_STATUS=ERROR 的节点不能当作仍在正常承载连接。
1SELECT EP_NAME, EP_SEQNO, EP_GUID, EP_TIMESTAMP,2 EP_MODE, EP_STATUS3FROM V$DSC_EP_INFO4ORDER BY EP_SEQNO;节点序号和 GUID 可用于和 DCR、监视器输出对号。该视图是数据库 EP 信息,不替代 ASM 组与 CSS 组的状态检查。
1SELECT N_CTL, N_FREE_CTL, N_SUB_POOL2FROM V$DSC_GBS_POOL;GBS 控制结构用于共享页权限管理。这张视图只显示当前登录节点;两端各查一次,不能在一个节点的结果上推断另一个节点也有同样空闲量。
1SELECT POOL_ID, N_USED_CTL, N_REQUEST,2 N_FREE_REQUEST3FROM V$DSC_GBS_POOLS_DETAIL4ORDER BY N_REQUEST DESC;N_REQUEST 是额外控制块仍处于请求阶段的数量。单次快照不能说明持续瓶颈;要结合业务峰值反复取样,并对照其他节点。
1check crash over DB在 DMCSSM 输入,DB 换成现场组名。故障处理后,控制节点的 Redo 修改页还没刷盘完时,故障节点不能直接重加入。这个检查返回未结束,就先等待并追故障处理日志;别用强制启动绕过条件。
1SELECT EP_NAME, EP_SEQNO, EP_MODE,2 EP_STATUS, EP_TIMESTAMP3FROM V$DSC_EP_INFO4WHERE EP_STATUS <> 'OK'5ORDER BY EP_SEQNO;监视器 DB 组报异常后,在任一可连接的数据库节点核对 EP 视图。视图只说明数据库层 EP 状态;CSS 心跳与 ASM 共享存储还要回到第 2、3 条,空结果也不能证明所有组都正常。
1SELECT EP_NAME, EP_SEQNO, EP_STATUS2FROM V$DSC_EP_INFO3WHERE EP_MODE = 'CONTROL NODE'4ORDER BY EP_SEQNO;控制节点可能因故障重新选举,不能写死在 EP0。查到一个 OK 控制节点后,再与 DMCSSM 的 DB 组输出对照;选举期间的瞬时结果需重复采样,不据单次读数发故障处理命令。
1-- 每个 DMDSC 数据库节点分别执行2SELECT N_CTL, N_FREE_CTL,3 ROUND(100.0 * N_FREE_CTL / NULLIF(N_CTL, 0), 2)4 AS FREE_CTL_PCT5FROM V$DSC_GBS_POOL;这张视图只反映当前登录节点。空闲比例低是继续查分片池与页权限请求的线索,不是集群性能故障的单独证明;业务高峰和平峰各留一份读数。
1-- 每个 DMDSC 数据库节点分别执行2SELECT POOL_ID, N_USED_CTL,3 N_REQUEST, N_FREE_REQUEST4FROM V$DSC_GBS_POOLS_DETAIL5WHERE N_REQUEST > 06ORDER BY N_REQUEST DESC, POOL_ID;N_REQUEST 是临时额外控制块尚在请求阶段的数量,N_FREE_REQUEST 是用完后进入空闲链表的数量。两者不是业务 SQL 请求次数;持续高时再查页控制块,而不是只凭这列调大参数。
1-- 当前登录节点;TS_ID 是表空间号2SELECT TS_ID, COUNT(*) AS CONTROL_BLOCKS,3 SUM(N_REQUEST) AS PENDING_EP_REQUESTS,4 SUM(N_REVOKING) AS REVOKING_EP_REQUESTS5FROM V$DSC_GBS_CTL6GROUP BY TS_ID7ORDER BY PENDING_EP_REQUESTS DESC, TS_ID;这是页权限控制块的当前分布,不是表空间读写 IOPS。FILE_ID=-1 的记录有特殊全局封锁含义;若某表空间持续突出,再按文件、页继续看,并与应用热点对象对号。
1-- 当前登录节点;表空间号、文件号和页号按现场替换2SELECT POOL_ID, TS_ID, FILE_ID, PAGE_NO,3 FRESH_EP, FRESH_LSN,4 N_OWNER, N_REQUEST, N_REVOKING5FROM V$DSC_GBS_CTL6WHERE TS_ID = 27 AND FILE_ID = 18 AND PAGE_NO = 12345;FRESH_EP 指最近数据所在 EP,-1 表示该页尚未修改;FRESH_LSN 是最近修改 LSN。页号须来自数据库诊断信息,不能随意填;这条能看一页的权限状态,不能推断整张表都卡住。
1-- 与第 17 条在同一数据库节点执行2SELECT TS_ID, FILE_ID, PAGE_NO,3 TYPE, MODE, EP_SEQNO, REAL_FLUSH4FROM V$DSC_GBS_CTL_DETAIL5WHERE TS_ID = 26 AND FILE_ID = 17 AND PAGE_NO = 123458ORDER BY TYPE, EP_SEQNO;TYPE 区分 OWNER、REQUEST、REVOKING,MODE 的数字可组合表示多种封锁模式,不要把 3 当成一种独立模式。把 EP 序号与第 7 条实例清单对上,再查对应节点的业务等待。
1-- 当前登录节点2SELECT POOL_ID, TS_ID, FILE_ID, PAGE_NO,3 FRESH_EP, FRESH_LSN,4 N_OWNER, N_REQUEST, N_REVOKING5FROM V$DSC_GBS_CTL_LRU_FIRST6ORDER BY POOL_ID;LRU 首部只是每个控制块链表的一个位置,用来观察当前池里的页状态;不能拿它当所有热点页排名。结合第 15、16 条持续请求的池和表空间,再去查具体页。
1-- 当前登录节点;重复取样看增量2SELECT POOL_ID, SUM(N_REVOKED) AS REVOKED_COUNT,3 SUM(N_REPLACED) AS REPLACED_COUNT4FROM V$DSC_GBS_CTL5GROUP BY POOL_ID6ORDER BY REVOKED_COUNT DESC, POOL_ID;N_REVOKED、N_REPLACED 是控制块上的累计次数,不是此刻正在回收的 EP 数。要判断节点间页权限竞争,保留前后两次采样并核对业务高峰;一张累积榜单不足以决定调参或踢节点。
1SELECT TOTAL_SUCCESS, TOTAL_WAIT,2 TOTAL_DEADLOCK, HLCK_SEQ3FROM V$DSC_GLS_SYS;TOTAL_WAIT 和 TOTAL_DEADLOCK 是累计值。保存两次采样计算增量,才能判断当前时段是否仍有封锁冲突。
1SELECT TOTAL_SUCCESS, TOTAL_WAIT,2 ROUND(100.0 * TOTAL_WAIT /3 NULLIF(TOTAL_SUCCESS + TOTAL_WAIT, 0), 4) AS WAIT_PCT4FROM V$DSC_GLS_SYS;比例突然升高时,再结合业务 SQL、对象和节点间网络判断。单看累计比例无法定位是哪条 SQL。
1SELECT EPSEQ, MIN_ACTIVE_ID, NEXT_ID,2 N_ACTIVE, MAX_CMT_LSN3FROM V$DSCIDS4ORDER BY EPSEQ;EPSEQ 与 V$DSC_EP_INFO.EP_SEQNO 对应。某节点活动事务长期偏高时,再查长事务和应用连接分布。
1SELECT EPSEQ, MAX_CMT_LSN,2 MIN_LAST_CMT_LSN, MIN_CMT_TID,3 NOTIFY_VERSION4FROM V$DSCIDS5ORDER BY EPSEQ;节点间 LSN 短暂不同不一定是故障。持续拉开并伴随提交变慢时,才需要继续查 MAL 通信和磁盘刷写。
1SELECT EPSEQ, N_ACTIVE,2 MIN_ACTIVE_ID, NEXT_ID3FROM V$DSCIDS4ORDER BY N_ACTIVE DESC;这条用于判断负载是否明显偏在一个 EP。还要结合连接池配置和业务路由,不能仅凭事务数认定节点失衡。
1SELECT *2FROM V$DSC_REQUEST_STATISTIC;该视图依赖 DSC_ENABLE_MONITOR。先查看完整字段和请求类型,再选择耗时或次数列做二次统计,避免套用不同补丁版本的列名。
1SELECT PARA_NAME, PARA_VALUE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_ENABLE_MONITOR';值为 1 才会收集 DMDSC 请求时间。修改监控开关前先评估现场版本和采样需求。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_N_CTLS';DSC_N_CTLS 是静态参数。看到空闲控制块少时,先确认负载和回收是否异常,不能直接在线修改。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_N_POOLS';池数量同样属于静态配置。调整需要完整的容量评估、停库窗口和回退方案。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_RESERVE_PERCENT';该参数决定空闲控制块低到什么比例时提前启动回收。调得过高会增加回收动作,调得过低可能造成突发压力。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_TRX_CMT_LSN_SYNC';它影响节点间提交 LSN 同步方式。不能为了降低延迟随意改为弱同步,先明确一致性和故障恢复要求。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_TRX_VIEW_SYNC';参数决定事务视图是否等待其他节点响应。排查提交或查询等待时,把当前值写进证据记录。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME = 'DSC_TRX_VIEW_BRO_INTERVAL';广播间隔单位为毫秒。改小会增加节点间通信,不能把网络故障当作参数问题掩盖。
1SELECT PARA_NAME, PARA_VALUE, PARA_TYPE2FROM V$DM_INI3WHERE PARA_NAME IN ('DSC_ENABLE_MONITOR','DSC_N_CTLS',4 'DSC_N_POOLS','DSC_RESERVE_PERCENT',5 'DSC_TRX_CMT_LSN_SYNC','DSC_TRX_VIEW_SYNC',6 'DSC_TRX_VIEW_BRO_INTERVAL')7ORDER BY PARA_NAME;两个节点分别执行并保存结果。静态参数不一致时,先核对配置文件和启动来源,不要在线拼凑修改。
1SELECT INSTANCE_NAME, STATUS$, MODE$2FROM V$INSTANCE;执行节点本地视图前先记录自己连到了哪个实例,避免把 EP0 的结果误写成 EP1。
1help不同补丁版本先以现场帮助为准。故障处理中尤其不要凭记忆输入 halt、crash 或 force 命令。
1show CSS每个 CSS 只负责与自身 DMDCR_SEQNO 相同节点的自动拉起。看见一侧开启,不能推断另一侧也开启。
1set DB auto restart on这条只修改 DMCSS 内存值,不会改写 dmdcr.ini。执行后再次 show CSS 核对各节点标记。
1set DB auto restart off维护前关闭可避免实例被 CSS 再次拉起。维护结束后是否恢复,要按现场原值和变更单处理。
1set ASM auto restart onASM 是 DB 的前置层。开启后仍需确认各活动 ASM 节点已经到 OPEN,不能只看开关值。
1set ASM auto restart off停止共享存储服务前使用,并记录原状态。DB 组仍在运行时不要直接停 ASM。
1ep startup ASM如果自动拉起已开启,命令可能不允许执行,需要等待 CSS 自动处理。所有活动 CSS 正常时才能覆盖全部对应节点。
1ep startup DB只有 ASM 组和所有活动 ASM 节点都处于 OPEN,才允许启动 DB 组。启动后用 show DB 和实际连接双重验证。
1ep stop DB组级停止会先关闭自动拉起,再通知实例退出。生产执行前先停业务入口并确认两节点都能正常退出。
1ep stop ASM必须先确认 DB 组已经退出,否则命令会报错。停 ASM 前还要确认没有其他数据库组依赖它。
1ep halt DB.DSC1这是高风险操作,用于明确需要强制退出的节点。执行前确认节点名、剩余节点健康和业务连接影响。
1ep crash DB.DSC1该命令会进入集群故障处理流程,不是普通停止方式。只有故障演练或官方处置方案明确要求时使用。
1check crash over DB只有故障节点 Redo 修改页处理完成,才考虑重新加入。返回未结束时不能用强制 OPEN 绕过。
1open force DB某节点无法启动且业务必须由剩余节点恢复时才考虑。要求主 CSS 正常且监控开启,执行前应完成故障节点隔离和数据风险评估。
1open force ASMASM 共享存储层强制 OPEN 风险更高。确认故障节点不会同时访问共享盘,并按达梦技术支持方案执行。
1exit退出的只是监视器进程,不会停止 CSS、ASM 或数据库。结束维护前先保存 show、配置和故障处理结果。
1ip -brief address业务网、MAL 心跳网和共享存储网络按现场规划核对。两节点都执行,确认地址没有漂移或重复。
1# root;网卡名按现场替换2ethtool eth1重点看 Speed、Duplex 和 Link detected。DMDSC 节点通信量大,链路降速会直接放大全局页请求延迟。
1ping -c 20 192.168.100.12两边互测,记录丢包率和时延抖动。单次 ping 正常不能替代持续网络监控。
1date '+%F %T.%N %z'两节点输出放在同一记录中比较。时间漂移会影响 MAL 通信与日志对时,生产环境应交给统一时钟服务管理。
1timedatectl status确认系统时钟已同步、时区一致。若使用 chrony,还要继续看上游和偏移量。
1chronyc sources -v两节点应使用可靠时间源。? 或长期高偏移需要先处理网络或 NTP 服务。
1chronyc tracking记录 System time、Last offset 和 Leap status。不要在集群运行中手工大幅跳时钟。
1ps -ef | grep -E 'dmcss|dmasmsvr|dmserver' | grep -v grep进程存在只说明程序还在,不能代替组状态和数据库连接检查。用来确认 PID、启动用户和参数路径。
1ss -lntp | grep -E 'dmcss|dmasmsvr|dmserver'如果系统权限不足看不到进程名,可先按配置文件中的端口过滤。监听正常也不代表节点间通信一定正常。
1grep -Ev '^\s*(#|$)' /dm/dsc/config/dmdcr.ini重点确认 DMDCR_PATH、DMDCR_SEQNO、MAL 配置路径和自动拉起参数。两个节点的序号必须不同。
1grep -i '^DMDCR_SEQNO' /dm/dsc/config/dmdcr.ini节点序号要与 DCR、实例名和监视器输出对应。复制配置后忘记改序号是常见错误。
1grep -i '^DMDCR_PATH' /dm/dsc/config/dmdcr.ini两节点应访问同一块 DCR 共享设备,但 Linux 设备名仍要以现场多路径配置为准。
1grep -Ei 'DMDCR_(AUTO_OPEN_CHECK|ASM_RESTART_INTERVAL|DB_RESTART_INTERVAL|ASM_STARTUP_CMD|DB_STARTUP_CMD)' /dm/dsc/config/dmdcr.ini区分“配置文件长期策略”和 DMCSSM 临时内存开关,维护结束时按原值恢复。
1grep -i '^DMDCR_LINK_CHECK_IP' /dm/dsc/config/dmdcr.ini该地址应位于心跳网络可达范围,并且不是 DMDSC 两个节点自身。
1grep -Ev '^\s*(#|$)' /dm/dsc/config/dmasvrmal.ini核对实例序号、MAL 地址和端口。节点间对应项不一致会影响 ASM 通信。
1grep -Ev '^\s*(#|$)' /dm/dsc/config/dmmal.ini地址、端口、实例名和序号要与网络规划一致。配置正确后仍需实测端口连通。
1grep -Ev '^\s*(#|$)' /dm/dsc/config/dmcssm.ini监视器最好部署在独立机器,并配置到多个 CSS 节点,避免监控视角随单节点一起失效。
1diff -u /tmp/node0.dmdcr.ini /tmp/node1.dmdcr.ini先把两端文件复制到同一检查机。预期差异主要是节点序号和节点本地路径,其他差异逐项解释。
1diff -u /tmp/node0.dmmal.ini /tmp/node1.dmmal.iniMAL 清单通常应保持一致。无差异不代表端口可达,还要继续做网络测试。
1nc -vz 192.168.100.12 5237端口按 dmmal.ini 替换。两边互测;连接失败时查路由、防火墙和监听进程。
1# root2multipath -ll确认所有路径正常、设备 WWID 一致。不要只看 /dev/mapper 设备存在就认为存储健康。
1lsblk -o NAME,MAJ:MIN,SIZE,TYPE,FSTYPE,MOUNTPOINTS对照 DCR、VOTE 和 ASM 数据盘规划,防止把本地盘误认成共享盘。
1udevadm info --query=property --name=/dev/mapper/dm_dcr | grep -E 'DM_UUID|ID_SERIAL|DEVNAME'两节点用同一标识核对。设备路径可不同,底层唯一标识应指向同一存储。
1ls -l /dev/mapper/dm_dcr /dev/mapper/dm_vote /dev/mapper/dm_data启动用户必须具备正确权限。重启后权限丢失时,应修复 udev 或多路径规则,别临时反复 chmod。
1systemctl status DmCSSServiceDSC --no-pager服务名按安装时注册名称替换。继续核对主进程 PID、退出码和最近日志。
1systemctl status DmASMSvrServiceASM --no-pagerASM 服务正常还不等于 ASM 组已 OPEN,最终以 DMCSSM 组状态为准。
1systemctl status DmServiceDSC0 --no-pager每个节点检查自己的服务。服务层成功后还要用 SQL 验证实例可连接。
1grep -E 'ERROR|FATAL' /dm/dmdbms/log/dm_CSS*_$(date +%Y%m)*.log先保存上下文和时间,不要只统计关键词数量。路径和文件名以实际 DM_HOME/log 为准。
1grep -E 'ERROR|FATAL' /dm/dmdbms/log/dm_ASM*_$(date +%Y%m)*.log共享盘连接、I/O 和 DCR 错误优先从 ASM 日志确认,再对照系统存储日志。
1grep -E 'ERROR|FATAL' /dm/dmdbms/log/dm_DMSERVER*_$(date +%Y%m)*.log两个节点分别检查,并围绕同一时间点关联 CSS、ASM、数据库三类日志。
1tail -n 200 /dm/dmdbms/log/dm_CSS*_$(date +%Y%m)*.log适合节点刚掉线或刚恢复时快速看选举、心跳和故障处理过程。
1tail -n 200 /dm/dmdbms/log/dm_ASM*_$(date +%Y%m)*.log重点找共享设备打开失败、路径异常和组状态变化。
1journalctl --since '2026-09-16 10:00:00' --until '2026-09-16 10:30:00' -p warning时间按故障窗口替换。内核、网卡、多路径和 OOM 信息经常比数据库日志更早出现。
1dmesg -T | grep -Ei 'error|fail|timeout|reset|multipath|scsi|link.*down'记录原始时间和设备名。共享存储报错时不要急着重启两端服务。
1# root;两节点按方案执行2systemctl start DmCSSServiceDSCCSS 是 ASM 和数据库的集群控制前提。先确认两侧 CSS 活动,再等待或启动 ASM。
1# root;维护窗口2systemctl stop DmServiceDSC0正常停集群应协调所有数据库节点,不能只停一侧后立即拆共享存储。
1# root;确认 DB 组已退出2systemctl stop DmASMSvrServiceASM数据库仍在访问共享文件时禁止停止 ASM。停后用监视器确认组状态。
1# root;确认 DB、ASM 已退出2systemctl stop DmCSSServiceDSCCSS 最后停止。若配置了自动拉起,操作节奏要避免上层进程重新启动。
1SHUTDOWN IMMEDIATE;正常维护优先使用数据库命令关闭,不用 kill -9 代替。双节点停库需按现场方案协调。
1SELECT EP_NAME, EP_SEQNO, EP_MODE, EP_STATUS2FROM V$DSC_EP_INFO3ORDER BY EP_SEQNO;故障节点重加入后,确认所有预期 EP 都为 OK,并且控制节点只有一个。
1SELECT COUNT(*) AS CONTROL_NODE_COUNT2FROM V$DSC_EP_INFO3WHERE EP_MODE = 'CONTROL NODE'4 AND EP_STATUS = 'OK';稳定状态通常应返回 1。选举期间短暂变化要结合连续采样和监视器输出判断。
1SELECT COUNT(*) AS ERROR_EP_COUNT2FROM V$DSC_EP_INFO3WHERE EP_STATUS <> 'OK';返回 0 只代表数据库 EP 视图无异常,CSS、ASM、网络和共享盘仍要分别核对。
1SELECT N_CTL, N_FREE_CTL,2 ROUND(100.0 * N_FREE_CTL / NULLIF(N_CTL,0), 2) AS FREE_PCT3FROM V$DSC_GBS_POOL;两个节点分别执行。故障恢复后空闲比例应稳定,不应持续单向下降。
1SELECT COUNT(*) AS CTL_WITH_REQUESTS,2 SUM(N_REQUEST) AS REQUESTING_EPS3FROM V$DSC_GBS_CTL4WHERE N_REQUEST > 0;业务高峰可能有短暂请求。连续采样不下降时,再按表空间、文件和页定位。
1SELECT COUNT(*) AS CTL_REVOKING,2 SUM(N_REVOKING) AS REVOKING_EPS3FROM V$DSC_GBS_CTL4WHERE N_REVOKING > 0;恢复后一段时间仍大量存在,需要关联网络、节点负载和具体热点页。
1SELECT EPSEQ, N_ACTIVE, MAX_CMT_LSN,2 MIN_LAST_CMT_LSN, NOTIFY_VERSION3FROM V$DSCIDS4ORDER BY EPSEQ;确认恢复节点重新参与事务信息同步,LSN 和通知版本没有持续停滞。
1disql SYSDBA/'口令'@192.168.10.11:5236 -e "SELECT INSTANCE_NAME, STATUS$ FROM V\$INSTANCE;"分别替换为两个节点业务地址执行。口令不要写入脚本、历史记录或文章附件。
1show把 CSS、ASM、DB 三组状态和采样时间一起归档,作为恢复完成的组级证据。
1check crash over DB返回结束后,再结合双节点连接、EP 状态、GBS 和业务探测关闭故障。单条命令成功不等于整套集群已经恢复。
DMDSC 排障先分清 CSS、ASM 和数据库三层,再看节点间网络、共享盘和 GBS 页权限。节点掉线后,最关键的不是尽快把进程拉起来,而是确认故障处理结束、共享存储访问安全、所有 EP 状态一致。
建议把这份清单和现场组名、服务名、设备路径一起保存。真正出故障时,从 show 开始逐层查,比直接强制 OPEN 更稳妥。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100