高可用 & 容灾30 分钟阅读
Oracle Data Guard 日常运维与故障排查 100 条命令
Data Guard 是 Oracle 数据库中最常用的企业级容灾架构之一,通过将主库产生的 Redo 日志传输到备库并持续应用,保证主备数据库的数据一致性。当主库发生故障时,可以通过 Switchover 或 Failover 完成角色切换。
2026年9月15日阅读—点赞—收藏—
dba100oraclescenario
100 条命令系列文章专栏
Data Guard 是 Oracle 数据库中最常用的企业级容灾架构之一,通过将主库产生的 Redo 日志传输到备库并持续应用,保证主备数据库的数据一致性。当主库发生故障时,可以通过 Switchover 或 Failover 完成角色切换。
Data Guard 是 Oracle 数据库中最常用的企业级容灾架构之一,通过将主库产生的 Redo 日志传输到备库并持续应用,保证主备数据库的数据一致性。当主库发生故障时,可以通过 Switchover 或 Failover 完成角色切换。
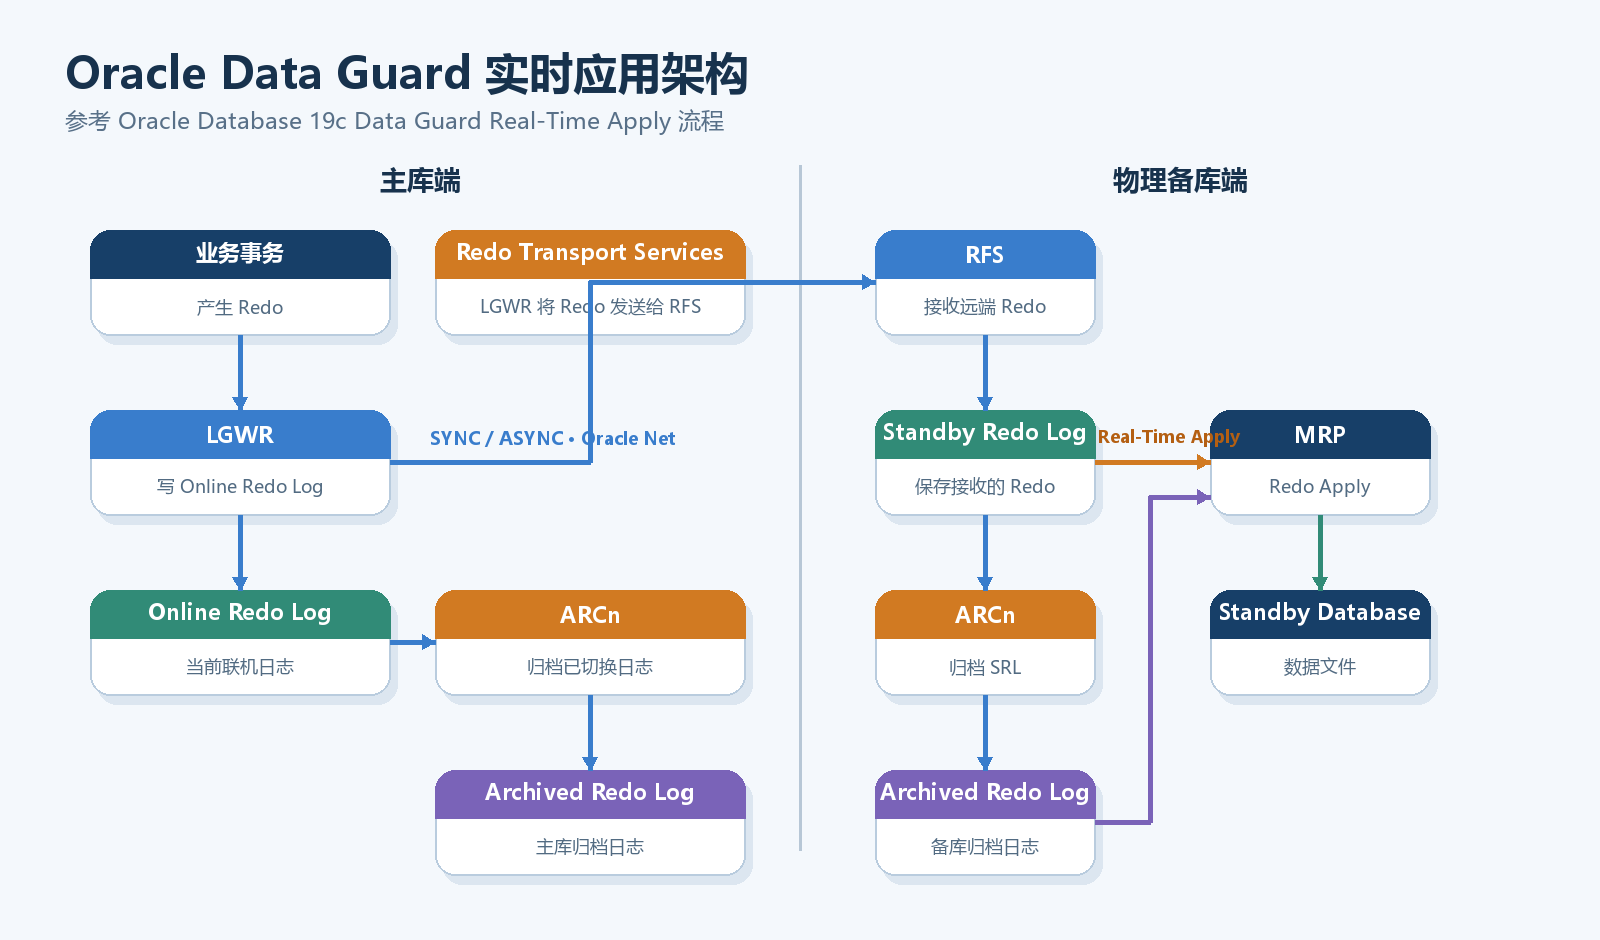 Oracle Data Guard 架构示意图
Data Guard 的日常运维主要围绕日志传输和 Redo Apply 展开。备库出现延迟时,要区分主库归档、远端传输、RFS 接收和 MRP 应用几个环节;切换主备时,还要核对数据库角色、Broker 状态及业务服务。
本文整理了 Data Guard 日常检查、延迟排查、归档缺口处理和主备切换常用的 100 条命令。内容较多,建议收藏备用。
文中以 Oracle Database 19c 物理备库为例,数据库名称、服务名及归档目的端编号请根据实际环境修改。
1-- 主备两端;CDB 在 CDB$ROOT。2SELECT dbid, name, db_unique_name, database_role3FROM v$database;1-- 主备两端;CDB 在 CDB$ROOT。2-- READ ONLY WITH APPLY 表示物理备库正在实时查询模式下打开。3SELECT database_role, open_mode, controlfile_type, cdb4FROM v$database;1-- 主备两端;CDB 在 CDB$ROOT;GV$ 查询当前数据库的各实例。2SELECT inst_id, instance_name, host_name, version_full,3 startup_time, status, database_status, thread#4FROM gv$instance5ORDER BY inst_id;1-- 主备两端;先核对连接,CDB 的全库 Data Guard 查询在 CDB$ROOT 执行。2SELECT sys_context('USERENV', 'DB_UNIQUE_NAME') AS db_unique_name,3 sys_context('USERENV', 'CON_NAME') AS con_name,4 sys_context('USERENV', 'CON_ID') AS con_id,5 sys_context('USERENV', 'SESSION_USER') AS login_user,6 sys_context('USERENV', 'ISDBA') AS isdba7FROM v$instance;1-- 主库;CDB 在 CDB$ROOT;PROTECTION_LEVEL 汇总各备库归档目的端的保护状态。2SELECT protection_mode, protection_level3FROM v$database;PROTECTION_MODE 是配置目标,PROTECTION_LEVEL 是当前整套配置实际达到的级别。两列不一致时,先查失效的归档目的端。
1-- 主库;CDB 在 CDB$ROOT;19c 的 FORCE_LOGGING 不只 YES/NO 两种值。2SELECT log_mode, force_logging3FROM v$database;1-- 主备两端;CDB 在 CDB$ROOT;跨库比较归档前先确认分支相同。2SELECT incarnation#, status, resetlogs_id,3 resetlogs_change#, resetlogs_time, prior_incarnation#4FROM v$database_incarnation5ORDER BY incarnation#;主备比较归档序号前先对这一项。RESETLOGS 分支不同,序号相同也不是同一批日志。
1-- 仅主库;CDB 在 CDB$ROOT;V$THREAD 在物理备库上不返回有意义的结果。2SELECT thread#, instance, status, enabled,3 current_group#, sequence#, last_redo_time4FROM v$thread5ORDER BY thread#;1-- 主备两端;CDB 在 CDB$ROOT。2-- MOUNT 恢复中的物理备库 CURRENT_SCN 是检查点 SCN,不能据此计算时间延迟。3SELECT database_role, current_scn, checkpoint_change#,4 resetlogs_change#, resetlogs_time5FROM v$database;1-- 主备两端;CDB 在 CDB$ROOT;此状态查询不能替代切换前的完整验证。2SELECT database_role, switchover_status,3 standby_became_primary_scn4FROM v$database;SWITCHOVER_STATUS 会随会话和日志状态变化。准备切换时连续查几次,比只截取一次结果可靠。
1-- 主备两端;CDB 在 CDB$ROOT;读取各实例当前生效值。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE name = 'log_archive_config'5ORDER BY inst_id;1-- 主备两端;CDB 在 CDB$ROOT;保留完整属性,便于核对 SERVICE/LOCATION。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE regexp_like(name, '^log_archive_dest_[0-9]+$')5 AND value IS NOT NULL6ORDER BY inst_id, to_number(regexp_substr(name, '[0-9]+$'));重点看 SERVICE、ASYNC/SYNC、AFFIRM/NOAFFIRM 和 VALID_FOR,这些属性共同决定日志发到哪里、怎样确认写盘。
1-- 主备两端;CDB 在 CDB$ROOT;ENABLE/DEFER/ALTERNATE 是配置值。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE regexp_like(name, '^log_archive_dest_state_[0-9]+$')5ORDER BY inst_id, to_number(regexp_substr(name, '[0-9]+$'));1-- 物理备库;CDB 在 CDB$ROOT;服务名还需另行验证网络连通性。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE name = 'fal_server'5ORDER BY inst_id;1-- 主备两端;CDB 在 CDB$ROOT;只显示参数,不读取密码文件内容。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE name IN ('remote_login_passwordfile', 'redo_transport_user')5ORDER BY inst_id, name;1-- 主库;CDB 在 CDB$ROOT;结合目的端 MANDATORY/OPTIONAL 属性判断。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE name = 'log_archive_min_succeed_dest'5ORDER BY inst_id;1-- 主备两端;CDB 在 CDB$ROOT;这是 LOG_ARCHIVE_MAX_PROCESSES 配置值。2SELECT inst_id, name, value3FROM gv$system_parameter4WHERE name = 'log_archive_max_processes'5ORDER BY inst_id;1-- 主库或级联备库;CDB 在 CDB$ROOT;仅查看远端目的端。2SELECT inst_id, dest_id, db_unique_name,3 transmit_mode, affirm, binding, compression4FROM gv$archive_dest5WHERE destination IS NOT NULL6 AND target IN ('STANDBY', 'REMOTE')7ORDER BY inst_id, dest_id;同步传输并不等于零数据丢失,还要看保护模式、网络和目的端是否处于有效状态。
1-- 主备两端;CDB 在 CDB$ROOT;VALID_NOW 说明当前角色下是否适用。2SELECT inst_id, dest_id, db_unique_name,3 valid_type, valid_role, valid_now4FROM gv$archive_dest5WHERE destination IS NOT NULL6ORDER BY inst_id, dest_id;1-- 主库或级联备库;CDB 在 CDB$ROOT;:dest_id 为目标编号 1..31。2-- DELAY_MINS 是归档应用延迟属性,不是当前观测到的 apply lag。3SELECT inst_id, dest_id, net_timeout, reopen_secs,4 max_failure, alternate, delay_mins5FROM gv$archive_dest6WHERE dest_id = :dest_id7ORDER BY inst_id;1-- 主备两端;CDB 在 CDB$ROOT;运行信息不会跨实例关闭保留。2SELECT inst_id, dest_id, dest_name, status,3 type, db_unique_name, error4FROM gv$archive_dest_status5WHERE status <> 'INACTIVE'6ORDER BY inst_id, dest_id;VALID 说明目的端当前可用;出现 ERROR 时,错误文本通常比状态本身更有价值。RAC 主库要在各实例分别查看。
1-- 主备两端;CDB 在 CDB$ROOT;FAIL_DATE 是最近错误时间。2SELECT inst_id, dest_id, status, fail_date,3 fail_sequence, fail_block, failure_count, error4FROM gv$archive_dest5WHERE destination IS NOT NULL6 AND (error IS NOT NULL OR failure_count > 0)7ORDER BY fail_date DESC NULLS LAST, inst_id, dest_id;1-- 主库或级联备库;CDB 在 CDB$ROOT;:dest_id 指定备库目的端。2SELECT inst_id, dest_id, db_unique_name,3 database_mode, recovery_mode4FROM gv$archive_dest_status5WHERE dest_id = :dest_id6ORDER BY inst_id;1-- 主库或级联备库;CDB 在 CDB$ROOT;:dest_id 指定物理备库。2SELECT inst_id, dest_id, srl,3 standby_logfile_count, standby_logfile_active4FROM gv$archive_dest_status5WHERE dest_id = :dest_id6ORDER BY inst_id;1-- 主库;CDB 在 CDB$ROOT;:dest_id 指定备库。2-- 异步传输或最大性能模式下,CHECK CONFIGURATION 不等同于传输故障。3SELECT inst_id, dest_id, protection_mode,4 synchronization_status, synchronized5FROM gv$archive_dest_status6WHERE dest_id = :dest_id7ORDER BY inst_id;1-- 主库或级联备库;CDB 在 CDB$ROOT。2SELECT inst_id, dest_id, db_unique_name, gap_status, error3FROM gv$archive_dest_status4WHERE type = 'PHYSICAL'5 AND status <> 'INACTIVE'6ORDER BY inst_id, dest_id;1-- 主库或级联备库;CDB 在 CDB$ROOT;:dest_id 指定物理备库。2-- 两组序号可能属于不同线程,不能直接相减,也不是实时应用的全部进度。3SELECT inst_id, dest_id,4 archived_thread#, archived_seq#,5 applied_thread#, applied_seq#6FROM gv$archive_dest_status7WHERE dest_id = :dest_id8ORDER BY inst_id;ARCHIVED_SEQ# 是对端收到的位置,APPLIED_SEQ# 是对端报告的应用位置。两者差得多,问题一般在备库应用端。
1-- 主库或级联备库;CDB 在 CDB$ROOT。2-- APPLIED_SCN 仅对已启用且活动的备库目的端有效。3SELECT inst_id, dest_id, db_unique_name, applied_scn4FROM gv$archive_dest5WHERE target IN ('STANDBY', 'REMOTE')6 AND status = 'VALID'7 AND valid_now = 'YES'8ORDER BY inst_id, dest_id;1-- 主备两端;CDB 在 CDB$ROOT;这是当前数据库看到的配置成员。2SELECT db_unique_name, parent_dbun, dest_role3FROM v$dataguard_config4ORDER BY db_unique_name;1-- 主备两端;CDB 在 CDB$ROOT;仅含视图保留的近期消息,不是完整 alert 日志。2SELECT inst_id, timestamp, facility, severity,3 dest_id, error_code, message4FROM gv$dataguard_status5WHERE severity IN ('Warning', 'Error', 'Fatal')6ORDER BY timestamp DESC, inst_id, message_num DESC7FETCH FIRST 30 ROWS ONLY;这个视图只保留近期消息。需要完整上下文时,仍要回到 alert 日志查同一时间段。
1-- 主库;CDB 在 CDB$ROOT;:dest_id 指定本地归档目的端。2-- 最大序号仅是记录高水位,不能证明此前每个序列都完整保留。3SELECT a.resetlogs_id, a.thread#, MAX(a.sequence#) AS last_archived_seq4FROM v$archived_log a5WHERE a.dest_id = :dest_id6 AND a.archived = 'YES'7 AND a.resetlogs_id = (8 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'9 )10GROUP BY a.resetlogs_id, a.thread#11ORDER BY a.thread#;RAC 每个线程各有一条进度。不要只拿最大的序号比较,否则容易漏掉某个线程的传输中断。
1-- 物理备库;CDB 在 CDB$ROOT;仅统计当前分支的 RFS 归档记录。2-- 已接收的最大序号不能证明中间没有缺口;SRL 中未归档的 redo 不在此统计中。3SELECT a.resetlogs_id, a.thread#, MAX(a.sequence#) AS last_received_seq4FROM v$archived_log a5WHERE a.registrar = 'RFS'6 AND a.resetlogs_id = (7 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'8 )9GROUP BY a.resetlogs_id, a.thread#10ORDER BY a.thread#;1-- 物理备库;CDB 在 CDB$ROOT;APPLIED 的此含义限定 REGISTRAR='RFS'。2-- 仅取 YES;IN-MEMORY 表示数据文件尚未更新,不能按 YES 统计。3SELECT a.resetlogs_id, a.thread#, MAX(a.sequence#) AS last_applied_yes_seq4FROM v$archived_log a5WHERE a.registrar = 'RFS'6 AND a.applied = 'YES'7 AND a.resetlogs_id = (8 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'9 )10GROUP BY a.resetlogs_id, a.thread#11ORDER BY a.thread#;1-- 物理备库;CDB 在 CDB$ROOT;:thread_no 为 redo 线程号。2-- 同一分支、线程、序列可有多条记录,先合并再查看。3SELECT a.resetlogs_id, a.thread#, a.sequence#,4 MAX(CASE WHEN a.applied = 'YES' THEN 1 ELSE 0 END) AS has_applied_yes,5 MAX(CASE WHEN a.applied = 'IN-MEMORY' THEN 1 ELSE 0 END) AS has_in_memory,6 COUNT(*) AS record_count7FROM v$archived_log a8WHERE a.registrar = 'RFS'9 AND a.thread# = :thread_no10 AND a.resetlogs_id = (11 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'12 )13GROUP BY a.resetlogs_id, a.thread#, a.sequence#14ORDER BY a.sequence# DESC15FETCH FIRST 30 ROWS ONLY;1-- 物理备库;CDB 在 CDB$ROOT;按分支、线程、序列去重。2-- 包含 IN-MEMORY;统计范围是当前控制文件的 RFS 记录,不能当作精确总积压。3WITH pending AS (4 SELECT a.resetlogs_id, a.thread#, a.sequence#5 FROM v$archived_log a6 WHERE a.registrar = 'RFS'7 AND a.resetlogs_id = (8 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'9 )10 GROUP BY a.resetlogs_id, a.thread#, a.sequence#11 HAVING MAX(CASE WHEN a.applied = 'YES' THEN 1 ELSE 0 END) = 012)13SELECT resetlogs_id, thread#, COUNT(*) AS sequences_without_yes,14 MIN(sequence#) AS first_seq, MAX(sequence#) AS last_seq15FROM pending16GROUP BY resetlogs_id, thread#17ORDER BY thread#;结果是“还没有出现 APPLIED=YES 的序列”,其中可能包括重复归档记录,不能直接当成缺失文件数。
1-- 物理备库;CDB 在 CDB$ROOT;这些是记录行,可能存在同序列副本。2-- IN-MEMORY 不表示可以删除日志;删除判断时应按尚未应用处理。3SELECT a.recid, a.resetlogs_id, a.thread#, a.sequence#,4 a.applied, a.name5FROM v$archived_log a6WHERE a.registrar = 'RFS'7 AND a.applied = 'IN-MEMORY'8 AND a.resetlogs_id = (9 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'10 )11ORDER BY a.thread#, a.sequence#, a.recid;1-- 物理备库;CDB 在 CDB$ROOT;显示当前恢复分支中阻塞恢复的缺口。2-- 补齐后再查;空结果仍需结合应用进程和新鲜的 lag 指标判断。3SELECT thread#, low_sequence#, high_sequence#4FROM v$archive_gap5ORDER BY thread#, low_sequence#;这里只返回当前阻塞恢复的一段 gap。补齐以后如果还有下一段,需要再次查询。
1-- 主库;CDB 在 CDB$ROOT;分支和线程必须与缺口对应。2-- :dest_id 为本地归档目的端;:low_seq/:high_seq 为缺口两端序号。3-- A/NO/非空文件名只是控制文件记录状态,还需验证实际文件存在。4SELECT resetlogs_id, thread#, sequence#, name,5 first_change#, next_change#6FROM v$archived_log7WHERE resetlogs_id = :resetlogs_id8 AND thread# = :thread_no9 AND sequence# BETWEEN :low_seq AND :high_seq10 AND dest_id = :dest_id11 AND status = 'A'12 AND deleted = 'NO'13 AND name IS NOT NULL14ORDER BY sequence#, recid;1-- 主备两端;CDB 在 CDB$ROOT;三个绑定值共同标识目标日志。2-- 备库上也只有 RFS 记录的 APPLIED 才有上述应用语义。3SELECT recid, dest_id, registrar, applied,4 status, deleted, completion_time, name5FROM v$archived_log6WHERE resetlogs_id = :resetlogs_id7 AND thread# = :thread_no8 AND sequence# = :sequence_no9ORDER BY recid;1-- 主备两端按本地记录查看;CDB 在 CDB$ROOT;只取当前分支。2-- COMPLETION_TIME 是归档完成时间,不能称为应用完成时间。3SELECT a.recid, a.resetlogs_id, a.thread#, a.sequence#,4 a.registrar, a.fal, a.completion_time5FROM v$archived_log a6WHERE a.fal = 'YES'7 AND a.resetlogs_id = (8 SELECT resetlogs_id FROM v$database_incarnation WHERE status = 'CURRENT'9 )10ORDER BY a.completion_time DESC, a.recid DESC11FETCH FIRST 30 ROWS ONLY;1-- 主备两端;CDB 在 CDB$ROOT;19c 使用 V$DATAGUARD_PROCESS。2SELECT inst_id, name, pid, role, action,3 resetlog_id, thread#, sequence#4FROM gv$dataguard_process5ORDER BY inst_id, name, pid;1-- 物理备库;CDB 在 CDB$ROOT;TASK_DONE 只描述当前进程任务。2SELECT inst_id, name, pid, role, action, task_done,3 thread#, sequence#, block#, block_count4FROM gv$dataguard_process5WHERE name = 'MRP0'6 OR role = 'managed recovery'7 OR role LIKE 'recovery%'8ORDER BY inst_id, role, pid;1-- 物理备库;CDB 在 CDB$ROOT;CLIENT_PID/CLIENT_ROLE 表示与 RFS 通信的进程。2SELECT inst_id, name, pid, role, action,3 client_pid, client_role, thread#, sequence#, block#4FROM gv$dataguard_process5WHERE name = 'RFS'6ORDER BY inst_id, pid;1-- 主备两端;CDB 在 CDB$ROOT;单次快照需结合消息和后续采样判断。2SELECT inst_id, name, pid, role, action,3 task_time, dest_id, resetlog_id, thread#, sequence#4FROM gv$dataguard_process5WHERE action IN ('ERROR', 'WAIT_FOR_GAP')6ORDER BY inst_id, name, pid;1-- 物理备库应用实例;CDB 在 CDB$ROOT;主库查询不会返回这些行。2-- 多次查询 DATUM_TIME 不变,说明未收到源库的新指标数据,旧的零延迟不能作证明。3SELECT source_db_unique_name, name, value, unit,4 time_computed, datum_time5FROM v$dataguard_stats6WHERE name IN ('transport lag', 'apply lag')7ORDER BY name;除了数值,还要看 DATUM_TIME。这个时间不更新时,显示的延迟可能只是旧值。
1-- 物理备库应用实例;CDB 在 CDB$ROOT;这是估算耗时,不是完成时刻。2-- 存在 gap 时,只估算最早 gap 之前已收到但尚未应用的 redo。3SELECT name, value, unit, time_computed, datum_time4FROM v$dataguard_stats5WHERE name = 'apply finish time';1-- 物理备库;在启动 MRP0 的协调实例查询;CDB 在 CDB$ROOT。2-- Multi-Instance Redo Apply 下部分项未填充或为 0,保留原始单位解读。3SELECT start_time, item, units, sofar4FROM v$recovery_progress5WHERE type = 'MEDIA RECOVERY'6 AND item IN ('Active Apply Rate', 'Average Apply Rate', 'Maximum Apply Rate')7ORDER BY item;应用速率短时波动很大,最好间隔几分钟取两次,再与归档产生速度比较。
1-- 物理备库;在启动 MRP0 的协调实例查询;CDB 在 CDB$ROOT。2-- TIMESTAMP 是最后应用的 redo 记录时间;COMMENTS 显示对应 SCN。3SELECT start_time, item, timestamp, comments4FROM v$recovery_progress5WHERE type = 'MEDIA RECOVERY'6 AND item = 'Last Applied Redo';1-- 物理备库;CDB 在 CDB$ROOT;COUNT 是采样次数,不能当作当前延迟。2-- TIME 要连同 UNIT 解读,各桶的单位可能不同。3SELECT name, time, unit, count, last_time_updated4FROM v$standby_event_histogram5WHERE upper(name) = 'APPLY LAG'6 AND count > 07ORDER BY CASE unit8 WHEN 'seconds' THEN 19 WHEN 'minutes' THEN 210 WHEN 'hours' THEN 311 WHEN 'days' THEN 412 ELSE 513 END, time;这里的 COUNT 是历史采样次数,不是当前等待应用的日志数量。
1-- 物理备库;在启动 MRP0 的协调实例查询;CDB 在 CDB$ROOT。2-- 这些是当前恢复操作的统计;结合 START_TIME 和 UNITS 比较后续采样。3SELECT start_time, item, units, sofar, total4FROM v$recovery_progress5WHERE type = 'MEDIA RECOVERY'6 AND item IN ('Redo Applied', 'Log Files', 'Active Time', 'Elapsed Time')7ORDER BY item;1-- 主库、备库分别执行;CDB 在 CDB$ROOT2SELECT thread#, group#, sequence#, bytes / 1024 / 1024 AS size_mb,3 members, archived, status4FROM v$log5ORDER BY thread#, group#;1-- 主库、备库分别执行;主库也要为角色互换准备 SRL2SELECT thread#, group#, sequence#, bytes / 1024 / 1024 AS size_mb,3 used / 1024 / 1024 AS used_mb, archived, status4FROM v$standby_log5ORDER BY thread#, group#;1-- 主库;记下结果,与第 54 条的备库结果逐线程比较2SELECT thread#, COUNT(*) AS online_groups,3 MAX(bytes) / 1024 / 1024 AS largest_log_mb4FROM v$log5GROUP BY thread#6ORDER BY thread#;1-- 物理备库;每个源线程的 SRL 组数至少比源库在线组多 1 组2-- 每组 SRL 不小于源库最大的在线日志;主备互换方向也要核对3SELECT thread#, COUNT(*) AS standby_groups,4 MIN(bytes) / 1024 / 1024 AS smallest_srl_mb5FROM v$standby_log6GROUP BY thread#7ORDER BY thread#;通常每个源线程至少准备“在线日志组数 + 1”组 SRL,而且 SRL 不能小于源端在线日志。
1-- 主库、备库分别执行;空 STATUS 通常表示正常2SELECT group#, type, status, member3FROM v$logfile4ORDER BY type, group#, member;1-- 物理备库;新增文件失败时结合告警日志检查2SELECT file#, con_id, name, status3FROM v$datafile4WHERE UPPER(name) LIKE '%UNNAMED%'5ORDER BY con_id, file#;出现 UNNAMED 文件,多半是主库新增数据文件后备库无法按预期创建。先查 alert 日志,不要直接改文件名。
1-- 物理备库;运行中的恢复可能使 FUZZY 为 YES,需结合应用状态判断2SELECT file#, con_id, status, error, recover, fuzzy,3 checkpoint_change#, checkpoint_time4FROM v$datafile_header5ORDER BY con_id, file#;1-- 物理备库;与文件头、告警日志一起看,不能仅凭空结果认定文件正常2SELECT file#, con_id, online_status, error, change#, time3FROM v$recover_file4ORDER BY con_id, file#;1-- 主库;该时间不是备库损坏时间,发现记录后再核对对应文件2SELECT file#, con_id, name, unrecoverable_change#, unrecoverable_time3FROM v$datafile4WHERE unrecoverable_time >= SYSDATE - 75ORDER BY unrecoverable_time DESC;UNRECOVERABLE_TIME 表示主库执行不可恢复操作的时间。发现记录后,还要确认相应数据文件是否已经重新备份并同步到备库。
1-- 主库、备库分别执行;CDB 在 CDB$ROOT2SELECT name, value3FROM v$parameter4WHERE name IN ('standby_file_management', 'db_file_name_convert', 'log_file_name_convert',5 'db_create_file_dest', 'db_create_online_log_dest_1',6 'db_recovery_file_dest')7ORDER BY name;1# oracle;主库服务器,DG_SERVICE 换成日志传输使用的网络别名2# tnsping 只检查别名解析和监听可达,不验证数据库登录3$ORACLE_HOME/bin/tnsping "$DG_SERVICE"1# oracle;主库服务器,使用目标端已有的 SYSDBA 账号2# 交互输入口令,不在命令行填写;连接后核对 DB_UNIQUE_NAME3$ORACLE_HOME/bin/sqlplus -L "sys@$DG_SERVICE as sysdba"1-- 主库、备库分别执行;只能核对账号和权限,不能证明两端口令相同2SELECT username, sysdba, sysdg, account_status3FROM v$pwfile_users4ORDER BY username;1-- 使用 TDE 的主库、备库;CDB 在 CDB$ROOT,保留各容器结果2SELECT con_id, status, wallet_type, wrl_type, wrl_parameter3FROM v$encryption_wallet4ORDER BY con_id;1-- 主库、备库分别执行;这是 FRA 配额,仍需检查底层存储余量2SELECT name, ROUND(space_limit / 1024 / 1024 / 1024, 2) AS limit_gb,3 ROUND(space_used / 1024 / 1024 / 1024, 2) AS used_gb,4 ROUND(space_reclaimable / 1024 / 1024 / 1024, 2) AS reclaimable_gb,5 number_of_files6FROM v$recovery_file_dest;SPACE_RECLAIMABLE 只是 Oracle 认为可以回收的空间,不等于已经释放。FRA 接近上限时还要检查归档删除条件。
1-- 主库、备库分别执行;百分比相对于 FRA 配额2SELECT file_type, percent_space_used, percent_space_reclaimable,3 number_of_files4FROM v$recovery_area_usage5ORDER BY percent_space_used DESC;1-- 主库、备库分别执行;保留窗口是目标,不能保证任意时间点可闪回2SELECT oldest_flashback_scn, oldest_flashback_time, retention_target,3 ROUND(flashback_size / 1024 / 1024 / 1024, 2) AS flashback_gb,4 ROUND(estimated_flashback_size / 1024 / 1024 / 1024, 2) AS estimated_gb5FROM v$flashback_database_log;最早闪回时间只是当前已有闪回日志的范围,不能把它当成固定承诺的恢复点。
1-- 主库、备库分别执行;RAC 每个实例各查一次2SELECT name, value3FROM v$diag_info4WHERE name IN ('ADR Home', 'Diag Trace', 'Diag Alert', 'Default Trace File')5ORDER BY name;1-- 主库、备库分别执行;本实例 ADR;筛选结果不能代替完整告警日志2SELECT originating_timestamp, message_text3FROM v$diag_alert_ext4WHERE originating_timestamp >= SYSTIMESTAMP - INTERVAL '1' DAY5 AND (message_text LIKE '%ORA-%' OR message_text LIKE '%MRP%'6 OR message_text LIKE '%RFS%' OR message_text LIKE '%Data Guard%')7ORDER BY originating_timestamp DESC8FETCH FIRST 100 ROWS ONLY;1-- 主库、备库分别执行;TRUE 仅表示启动 Broker 进程,不等于已加入配置2SELECT name, value3FROM v$parameter4WHERE name IN ('dg_broker_start', 'dg_broker_config_file1',5 'dg_broker_config_file2')6ORDER BY name;1# oracle;已设置目标实例的 ORACLE_HOME 和 ORACLE_SID2# 本地操作系统认证可查询;需要远程重启的切换使用口令或钱包认证3$ORACLE_HOME/bin/dgmgrl /1-- DGMGRL;以下 pri、stby 均替换为实际 DB_UNIQUE_NAME;2SHOW CONFIGURATION;1-- DGMGRL;VERBOSE 会立即重新评估配置健康状态;2SHOW CONFIGURATION VERBOSE;VALIDATE 会立即检查配置。报告里只要还有 warning,就继续展开对应数据库,不要只看最后一行。
1-- DGMGRL;pri 为当前主库 DB_UNIQUE_NAME;2SHOW DATABASE VERBOSE 'pri';1-- DGMGRL;stby 为目标物理备库 DB_UNIQUE_NAME;2SHOW DATABASE VERBOSE 'stby';1-- DGMGRL;RAC 主库的不同实例可能返回不同状态;2SHOW DATABASE 'pri' 'LogXptStatus';1-- DGMGRL;在发送 redo 的数据库上检查;2SHOW DATABASE 'pri' 'InconsistentLogXptProps';1-- DGMGRL;RecvQEntries 用于物理备库的日志应用进度检查;2SHOW DATABASE 'stby' 'RecvQEntries';RecvQEntries 表示已经收到、尚未应用的队列。队列持续增长,说明接收正常而应用跟不上。
1-- DGMGRL;读取目标备库属性,不会修改 SYNC/ASYNC 设置;2SHOW DATABASE 'stby' 'LogXptMode';1-- DGMGRL;DelayMins 是人为设置的分钟数,不是当前实测延迟;2SHOW DATABASE 'stby' 'DelayMins';1-- DGMGRL;检查报告中的 Ready for Switchover 及所有告警;2VALIDATE DATABASE VERBOSE 'stby';重点看 Ready for Switchover。如果不是 YES,下面列出的检查项就是切换前要处理的问题。
1-- DGMGRL;会发起成员间连接检查;2VALIDATE NETWORK CONFIGURATION FOR ALL;1-- DGMGRL;Oracle Clusterware 管理的数据库按 Broker 报告解释结果;2VALIDATE STATIC CONNECT IDENTIFIER FOR ALL;1-- DGMGRL;参数不同未必错误,按两端角色和路径逐项确认;2VALIDATE DATABASE 'stby' SPFILE;参数差异不一定是故障,文件路径和角色相关参数本来就可能不同。这里主要找不符合设计的差异。
1-- DGMGRL;只显示目标拓扑,不执行角色切换;2SHOW CONFIGURATION WHEN PRIMARY IS 'stby';1-- DGMGRL;已启用 FSFO 时,计划切换目标也受其目标配置限制;2SHOW FAST_START FAILOVER;1-- DGMGRL;核对 Observer 主机和主观察者状态;2SHOW OBSERVER;1-- DGMGRL;DGConnectIdentifier 用于成员间连接,须能从各成员正确解析;2SHOW DATABASE 'stby' 'DGConnectIdentifier';1-- 主库;仅用于未由 Broker 管理的物理备库配置2-- stby 换成备库 DB_UNIQUE_NAME;VERIFY 不执行切换,但可能返回告警3ALTER DATABASE SWITCHOVER TO stby VERIFY;这条只适用于没有交给 Broker 管理的配置。使用 Broker 时,应以 VALIDATE DATABASE 的结果为准。
1-- 主库、备库分别执行;RAC 保留实例号2-- 参数值不能证明服务已注册,切换后还要验证业务服务和实际连接3SELECT inst_id, name, value4FROM gv$system_parameter5WHERE name IN ('local_listener', 'remote_listener')6ORDER BY inst_id, name;1-- OPEN 主库;归档所有已启用线程并强制日志切换,注意归档 I/O2-- 执行后在备库复查接收和应用状态3ALTER SYSTEM ARCHIVE LOG CURRENT;1-- DGMGRL;维护操作,会增加应用延迟;不会停止日志传输;2-- 成员须为 ENABLE,RAC 按整库调整状态;维护完成后用第 93 条恢复;3EDIT DATABASE 'stby' SET STATE='APPLY-OFF';1-- DGMGRL;成员须为 ENABLE,恢复后复查应用进程、延迟和数据库状态;2-- READ ONLY 下同时应用需要 Active Data Guard 许可,否则使用 MOUNT;3EDIT DATABASE 'stby' SET STATE='APPLY-ON';1-- 物理备库;仅用于未由 Broker 管理的配置,会增加应用延迟2ALTER DATABASE RECOVER MANAGED STANDBY DATABASE CANCEL;1-- 物理备库;未由 Broker 管理,当前为 MOUNT,RAC 其他实例也不能处于 OPEN2-- SRL 配置正确时可实时应用,不需要加 USING CURRENT LOGFILE3ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT FROM SESSION;1-- 物理备库;未由 Broker 管理,当前为 MOUNT,已停止该库所有实例的 Redo Apply2-- 此条只打开查询,不启动应用3ALTER DATABASE OPEN READ ONLY;1-- 物理备库;未由 Broker 管理,当前为 READ ONLY2-- 只读同时应用需要 Oracle Active Data Guard 许可;执行后应为 READ ONLY WITH APPLY3ALTER DATABASE RECOVER MANAGED STANDBY DATABASE DISCONNECT FROM SESSION;1-- 主库;未由 Broker 管理;确认 DEST_2 确实是目标备库2-- 先记录各实例原值;此示例要求各实例目标均为 DEST_2,原状态均为 ENABLE3-- 维护窗口使用,会失去该目的地的实时保护;先检查保护模式和其他同步目的地4-- 不适用于最大保护模式下的唯一合格备库,维护完成用第 99 条恢复5ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=DEFER SCOPE=MEMORY SID='*';1-- 主库;对应第 98 条的临时暂停,不改变 SPFILE 中的原有值2-- 仅当各实例原状态均为 ENABLE 时使用,否则按记录恢复各自原值3-- 恢复后检查传输错误、GAP 和延迟,确认已追平4ALTER SYSTEM SET LOG_ARCHIVE_DEST_STATE_2=ENABLE SCOPE=MEMORY SID='*';1-- DGMGRL;维护窗口内执行,交换主备角色会影响连接和服务;2-- 已停止业务写入,完成同步、Broker 验证和服务检查;第 89 条仅适用非 Broker 配置;3-- 两端均已 ENABLE,主库 TRANSPORT-ON,目标 APPLY-ON 且 DelayMins=0;4-- 确认重启连接及两端认证可用;FSFO 启用时 stby 须为允许目标;5-- pri_service 为主库网络连接名,stby 为目标备库 DB_UNIQUE_NAME;6CONNECT sys@pri_service;7SWITCHOVER TO 'stby';8-- 完成后复查两端角色、保护状态、日志应用和应用实际连接;9-- 失败先核对两端角色和告警,不要盲目重试;切换完成后重新连接两端,确认角色已经交换、备库开始应用,并检查服务是否注册到新的主库。
备库延迟排查时,主库归档序号、备库接收序号和应用序号要按线程逐一对照,比较前先确认 RESETLOGS 分支一致。切换完成后,除了核对两端角色,还要确认新备库已经开始应用、业务服务注册正常。
其他 Data Guard 和数据库运维命令,继续放在 ORA100 · DBA100:
微信里搜索小程序 「三笠的百令册」,也可以直接查。