备份恢复 & 迁移30 分钟阅读
Oracle Data Pump 导入导出与迁移 100 条命令
Oracle Data Pump 是数据库对象和数据导入导出的常用工具。迁移时麻烦的往往不是 `expdp`、`impdp` 怎么敲,而是目录权限、作业中断、导入目标已有对象,以及任务结束后的对象核对。这篇按实际处理顺序整理常用命令。需要迁库或续跑作业时可以先收藏,遇到问题直接查对应一段。
2026年9月16日阅读—点赞—收藏—
dba100oraclescenario
100 条命令系列文章专栏
Oracle Data Pump 是数据库对象和数据导入导出的常用工具。迁移时麻烦的往往不是 `expdp`、`impdp` 怎么敲,而是目录权限、作业中断、导入目标已有对象,以及任务结束后的对象核对。这篇按实际处理顺序整理常用命令。需要迁库或续跑作业时可以先收藏,遇到问题直接查对应一段。
Oracle Data Pump 是数据库对象和数据导入导出的常用工具。迁移时麻烦的往往不是 expdp、impdp 怎么敲,而是目录权限、作业中断、导入目标已有对象,以及任务结束后的对象核对。这篇按实际处理顺序整理常用命令。需要迁库或续跑作业时可以先收藏,遇到问题直接查对应一段。
示例基于 Linux 和 Oracle Database 19c。命令中的连接串、目录对象、作业名和文件名都按现场替换;在 PDB 做导入导出时先确认连接的是正确的业务 PDB。
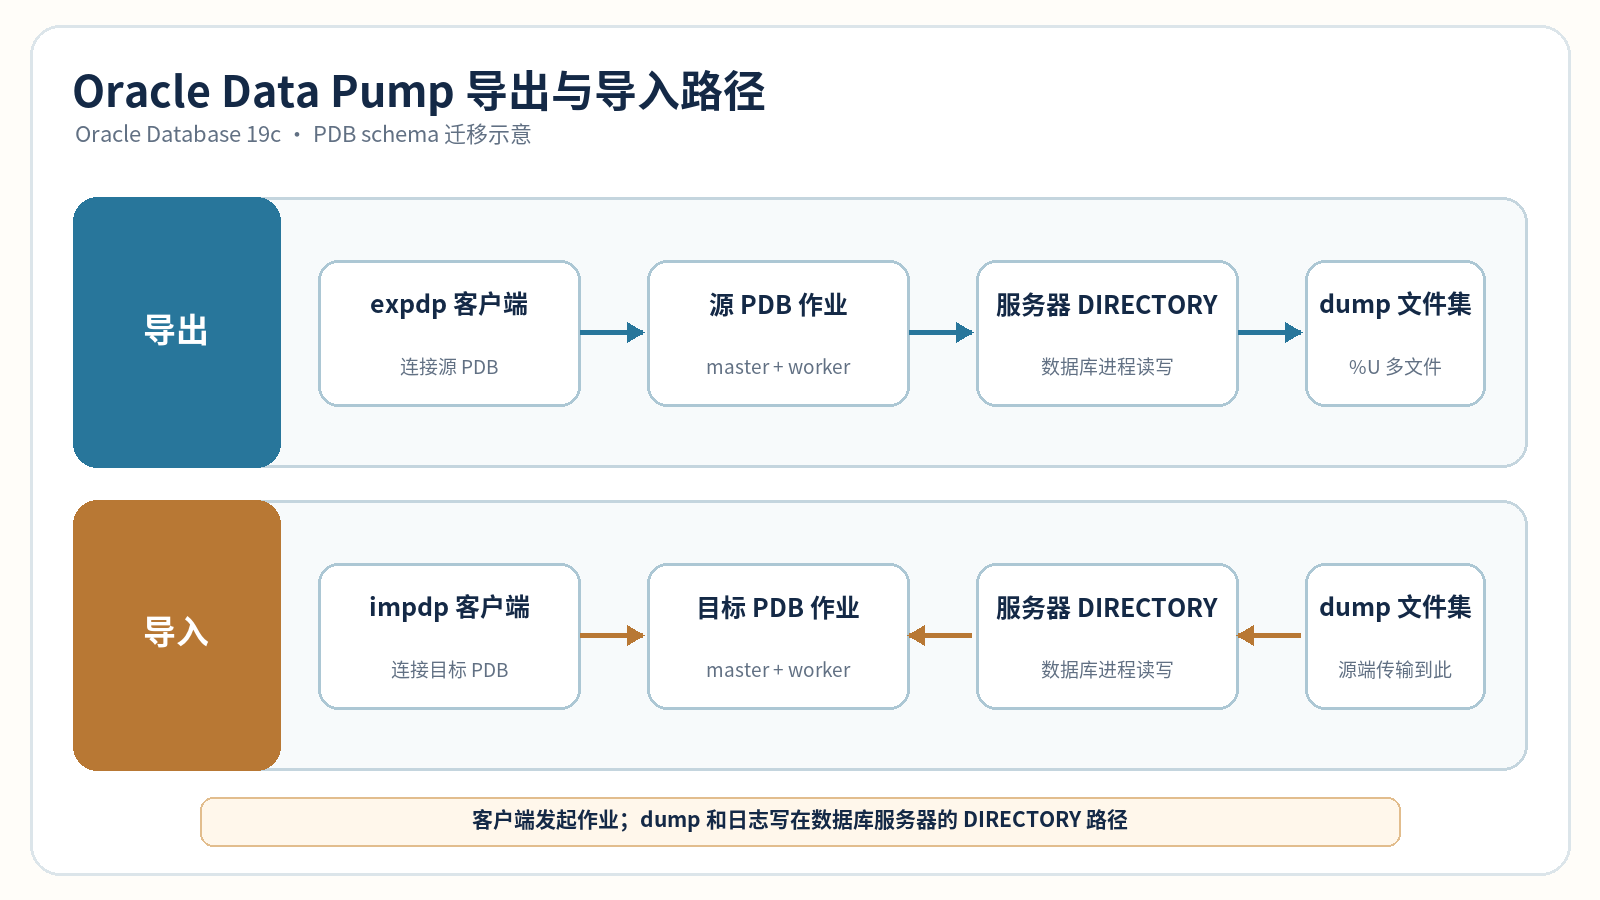 Oracle Data Pump 导出与导入路径
Data Pump 客户端只负责发起和管理作业;真正读写 dump 的是数据库服务器进程。跨服务器迁移时,导出文件要先搬到目标库可访问的目录。
1SELECT sys_context('USERENV', 'CON_NAME') con_name FROM dual;Data Pump 的目录对象、用户和作业主控表都与连接容器有关。连接根容器却打算导出某个 PDB 的业务 schema,是迁移脚本里常见的起点错误。
1SELECT directory_name, directory_path2FROM dba_directories3ORDER BY directory_name;DIRECTORY_PATH 是数据库服务器上的路径,不是运行 expdp 客户端的机器路径。目录对象存在还不够,数据库软件属主需要实际文件系统权限,作业账号也要有目录对象的读写权限。
1SELECT owner_name, job_name, operation, job_mode,2 state, degree, attached_sessions3FROM dba_datapump_jobs4ORDER BY owner_name, job_name;这里也可能显示已停作业留下的主控表。先区分 EXECUTING、NOT RUNNING 与已经结束的残留记录,再决定是否 ATTACH;不能看到表名像 SYS_EXPORT_* 就直接删除。
1SELECT owner_name, job_name, instance_id, session_type2FROM dba_datapump_sessions3WHERE job_name = 'SYS_EXPORT_SCHEMA_01'4ORDER BY instance_id, session_type;作业卡住时先查是否还有 worker。ATTACHED_SESSIONS=0 只表示客户端没挂在作业上,不说明服务端 worker 都已经退出。
1expdp app_user@SALES_PDB ATTACH=APP_USER.SYS_EXPORT_SCHEMA_01ATTACH 进入交互模式,不会新建一份导出。挂接前先用第 3 条确认 owner 和 job name;如果原作业用了加密密码,重新挂接时还需要按原方式提供密码,不应写在共享脚本里。
1SELECT grantee, privilege, common, inherited2FROM dba_tab_privs3WHERE table_name = 'DPUMP_DIR'4AND type = 'DIRECTORY'5ORDER BY grantee, privilege;导出账号通常需要目录的 READ 和 WRITE 权限。这里查的是数据库对象授权;文件系统层面的权限要在数据库服务器上另核对。PDB 内的本地授权与根容器公共授权也要分清。
1# 在数据库服务器执行;先把路径换成第 2 条查到的 DIRECTORY_PATH2df -h /u02/dpump估算 dump 文件量时还要留出日志与并行文件的空间。客户端电脑有足够磁盘空间,与数据库服务器能否写出 dump 没有关系。
1expdp app_user@SALES_PDB DIRECTORY=DPUMP_DIR \2 DUMPFILE=app_user_202609.dmp LOGFILE=app_user_202609_exp.log \3 SCHEMAS=APP_USER JOB_NAME=APP_USER_EXP_202609先写明 schema、目录和作业名,日志文件与 dump 文件不要混用。默认情况下已有同名 dump 文件会使作业报错;生产任务给每次导出唯一文件名,不要随手加 REUSE_DUMPFILES=YES。
1-- 在源 PDB 连接下执行2SELECT dbms_flashback.get_system_change_number AS export_scn FROM dual;导出多张相关表时可以使用同一个 SCN。先确认 UNDO 保留能覆盖导出时长;FLASHBACK_SCN 解决读一致性问题,不负责保留已生成 dump 文件。
1# 123456789 是第 9 条确定的现场 SCN2expdp app_user@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_scn.dmp LOGFILE=app_user_scn.log \4 SCHEMAS=APP_USER FLASHBACK_SCN=123456789这会以指定 SCN 读取一致性数据。导出跑得久、UNDO 不够时仍可能发生快照过旧;不要把 FLASHBACK_SCN 当作自动增加 UNDO 空间的开关。
1expdp app_user@SALES_PDB DIRECTORY=DPUMP_DIR \2 DUMPFILE=app_user_metrics.dmp LOGFILE=app_user_metrics.log \3 SCHEMAS=APP_USER LOGTIME=ALL METRICS=YESLOGTIME=ALL 给屏幕和日志消息加时间,METRICS=YES 记录对象数与阶段耗时。遇到“进度不动”时,可先从日志判断卡在元数据还是表数据,再挂接作业查实时状态。
1expdp app_user@SALES_PDB DIRECTORY=DPUMP_DIR \2 DUMPFILE=app_user_%U.dmp LOGFILE=app_user_parallel.log \3 SCHEMAS=APP_USER PARALLEL=4%U 给多个 dump 文件生成不同序号。并行度只是最大 worker 数,实际 worker 还受对象大小、访问方法和资源限制;不能只因为有 4 个文件就宣称作业加速了 4 倍。RAC 跨实例并行时,目录还必须在所有参与节点可见;并行导出有 Enterprise Edition 和对象权限限制。
1Export> STATUS先用第 5 条挂到目标作业,再输入 STATUS。它会显示当前阶段和估计进度;百分比长时间不变时继续查 worker、等待和日志,不要仅凭估计值判断作业已失败。
1Export> STATUS=300每 300 秒在终端输出一次状态,适合长任务观察。定时状态写到当前标准输出,不写入 Data Pump 日志;要留记录时还需保存终端输出或另查作业日志。
1Export> STOP_JOB这会让 worker 完成当前任务后有序停止,并提示确认。停作业前记录 dump 文件集和主控表;停止后不能删掉它们再期待 START_JOB 无损续跑。可传输表空间模式的导出另有不可续跑限制。
1Export> START_JOB先用第 5 条重新挂接,再在交互模式启动。主控表和整套 dump 文件必须保持原样;可传输表空间模式的导出不能按这个办法续跑。启动后查 STATUS,看 worker 是否重新工作。
1Export> PARALLEL=2这是调整当前作业的活跃进程数,不改已经写出的 dump 文件。把并行度调低也要等正在处理的任务到有序结束点;若目录在 RAC 节点间不共享,不能靠临时降低并行度解决已写文件的可见性问题。
1SELECT d.job_name, d.session_type, s.sid, s.serial#,2 s.event, s.state3FROM dba_datapump_sessions d4JOIN gv$session s5 ON s.inst_id = d.instance_id AND s.saddr = d.saddr6WHERE d.owner_name = 'APP_USER'7AND d.job_name = 'APP_USER_EXP_202609'8ORDER BY d.session_type, s.sid;WORKER 在等 I/O、UNDO 还是锁,要看它实际的会话等待。RAC 用 INSTANCE_ID 对到正确实例;看到一个 worker 等待,不等于所有 worker 都停了。
1-- 当前会话在目标 PDB2SELECT directory_name, directory_path3FROM dba_directories4WHERE directory_name = 'DPUMP_DIR';导入时 dump 文件要位于目标数据库服务器可读的目录,而不是源服务器目录。迁库前把文件集、校验值和目录授权记下来;只复制一个并行作业的首个 %U 文件会使导入失败。
1# 在目标 PDB 连接;只写 SQL 文件,不导入业务对象2impdp app_user@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp \4 SQLFILE=app_user_preview.sql SCHEMAS=APP_USER重点看用户、表空间、表和索引会建到哪里。SQLFILE 不会执行这些 DDL,也不展示实际行数据;文件中有些 PL/SQL 块不应直接当脚本运行。SQL 文件目录不能指向 ASM + 路径。
1-- 目标 PDB2SELECT object_type, COUNT(*) object_count3FROM dba_objects4WHERE owner = 'APP_USER'5GROUP BY object_type6ORDER BY object_count DESC;已有对象越多,越要明确 TABLE_EXISTS_ACTION。这条只看对象数量,不能确认同名表的列、约束或数据是否与 dump 相同;关键表要逐一比对。
1-- 目标 PDB2SELECT tablespace_name, status, contents3FROM dba_tablespaces4WHERE tablespace_name IN ('APP_DATA', 'APP_INDEX');做 REMAP_TABLESPACE 时目标永久表空间必须先存在,目标用户也要有配额。这里能证明名称和类型,不证明还有足够空闲空间;导入前继续查文件与自动扩展上限。
1# 目标 PDB;APP_TEST 用户、权限和表空间配额先按迁移方案准备2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_test_imp.log \4 SCHEMAS=APP_USER REMAP_SCHEMA=APP_USER:APP_TESTREMAP_SCHEMA 改对象归属,不会自动修好应用代码里写死的 schema 名称、数据库链路或跨 schema 授权。导入前查目标账号权限,导入后还要检查无效对象和引用关系。
1# 目标 PDB;APP_DATA 已建立,APP_TEST 有足够配额2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_remap_tbs.log \4 SCHEMAS=APP_USER REMAP_SCHEMA=APP_USER:APP_TEST \5 REMAP_TABLESPACE=OLD_DATA:APP_DATA只映射由本次导入创建的对象。若目标表已存在且使用 SKIP、APPEND 或 TRUNCATE,该旧表所在表空间不会被这项参数搬走;域索引里的自定义存储配置也要另查。
1# 目标 PDB;已有表保持原样,其他可导入对象仍按作业范围处理2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_skip.log \4 SCHEMAS=APP_USER TABLE_EXISTS_ACTION=SKIPSKIP 是普通导入的默认值,但写在命令里更容易看清迁移意图。已有表的数据、索引、触发器和授权都不会被 dump 中对应内容覆盖;不能拿“导入成功”当成这批旧表已经同步。
1# 只导入 SALES.ORDERS 的行;先核对主键、触发器和重复数据2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=orders_append.log \4 TABLES=APP_USER.ORDERS CONTENT=DATA_ONLY \5 TABLE_EXISTS_ACTION=APPENDAPPEND 不清理旧数据。重复主键可能直接报错;没有唯一约束时反而可能把重复行写进去。CONTENT=DATA_ONLY 的默认动作就是 APPEND,这里仍明确写出,避免把默认值当成“只补缺少的行”。
1# 目标表数据会被清空;先查外键引用、触发器和回退方案2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=orders_truncate.log \4 TABLES=APP_USER.ORDERS TABLE_EXISTS_ACTION=TRUNCATETRUNCATE 保留目标表的定义与依赖对象,却删除旧行。源、目标表列不完全相同时要先核对可装载列;有引用约束的表尤其不能把它当作普通覆盖。
1# 会 DROP 并重建目标表;仅用于已批准的测试或迁移窗口2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=orders_replace.log \4 TABLES=APP_USER.ORDERS TABLE_EXISTS_ACTION=REPLACEREPLACE 会把目标表及其依赖对象删除,再按 dump 重建。目标端额外加过的索引、授权或触发器可能不在 dump 里;动手前先导出目标 DDL,核对引用它的外键。
1# 目标 PDB;先创建用户、表、索引等结构,具体对象由 dump 范围决定2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_metadata.log \4 SCHEMAS=APP_USER CONTENT=METADATA_ONLY结构先到位并不等于迁移完成。导入后看日志中的失败对象,再查表和索引状态;业务行需要另一个数据导入步骤。
1# 在数据库服务器上;路径按 DBA_DIRECTORIES 查到的实际路径替换2grep -nE 'ORA-[0-9]+|Job .*completed with' /data/dpump/app_metadata.log“作业完成”与“所有对象导入成功”不是一回事。先看具体 ORA 错误和对应对象,不能只看日志末尾的 elapsed time。导入日志在服务器 DIRECTORY 下,不在启动 impdp 的客户端当前目录。
1-- 目标 PDB;REMAP_SCHEMA 后改查目标 owner2SELECT object_type, object_name, status3FROM dba_objects4WHERE owner = 'APP_TEST'5AND status <> 'VALID'6ORDER BY object_type, object_name;无效对象要结合导入日志和 DBA_ERRORS 看具体编译错误。统计出几个 INVALID 只能说明当前状态,不能证明是这次导入造成的;最好与导入前的目标库清单对照。
1SELECT name, type, line, position, text2FROM dba_errors3WHERE owner = 'APP_TEST'4ORDER BY name, sequence;先看缺少的对象、授权或数据库链路,再决定是否重编译。迁移后原 schema 被重映射,代码中写死的 APP_USER 仍可能留在过程文本里。
1-- 源 PDB:APP_USER;目标 PDB:REMAP_SCHEMA 后的 APP_TEST2-- 分别连接对应 PDB 执行,不要在同一连接上连续运行3SELECT COUNT(*) FROM app_user.orders; -- 源库4SELECT COUNT(*) FROM app_test.orders; -- 目标库在目标库查到行数还不够;源端必须按导出 SCN 或停写窗口确定比较口径。COUNT(*) 会读取表数据,大表可先比对抽样键与分区,再在验收窗口做全量核对。
1SELECT username, tablespace_name,2 bytes / 1024 / 1024 used_mb,3 max_bytes / 1024 / 1024 quota_mb4FROM dba_ts_quotas5WHERE username = 'APP_TEST'6ORDER BY tablespace_name;MAX_BYTES=-1 表示无限配额;配额够不够还要结合表空间可用容量。对象已导入不代表应用继续写入不会遇到配额错误,尤其是目标账号预建但只给了临时额度时。
1-- 目标 PDB;owner_name 和 job_name 换成实际作业值2SELECT owner_name, job_name, operation, job_mode,3 state, degree, attached_sessions4FROM dba_datapump_jobs5WHERE owner_name = 'APP_ADMIN'6AND job_name = 'APP_USER_IMP_202609';NOT RUNNING 的记录可能是停止的作业,也可能是残留的 master table。先查作业日志和 dump 文件集,再决定续跑或清理;不要看见一个名字就直接删 master table。
1# 使用原作业 owner,在目标 PDB 挂接;随后进入 Import> 提示符2impdp app_admin@SALES_PDB ATTACH=APP_USER_IMP_202609挂接不是重做导入。先在交互提示符执行 STATUS,确认停在什么对象和阶段;续跑要求 master table 与原 dump 文件集仍在,目录对象也能访问。
1Import> STATUSSTATUS 给出作业总体信息和当前处理对象,不保证某张表已经完整装载。若日志显示某对象报错,先处理对象、权限或空间问题,再谈 START_JOB。
1Import> STOP_JOB停止前先向业务确认导入中的目标表是否可留在当前状态。这个命令等待 worker 做完当前任务并询问确认;要续跑就保留 master table 和 dump 文件,不能顺手清理目录。
1Import> START_JOB先挂接到原作业并解决造成停止的问题。续跑以后查 STATUS 和日志;如果原 dump 文件被移走或改名,START_JOB 返回的错误不能靠反复重试解决。
1# 客户端工作目录中的 app_imp.par;由 impdp 客户端读取2DIRECTORY=DPUMP_DIR3DUMPFILE=app_user_202609.dmp4LOGFILE=app_user_imp_202609.log5SCHEMAS=APP_USER6REMAP_SCHEMA=APP_USER:APP_TEST7METRICS=YES参数复杂时,把导入范围、映射和日志名留在文件里,比临时敲一长串更容易审阅。PARFILE 是客户端本地文件;dump 和日志依旧走数据库服务器的 DIRECTORY,两种路径不要混。
1# 目标 PDB;当前目录已有 app_imp.par2impdp app_admin@SALES_PDB PARFILE=app_imp.par开跑前保存参数文件版本和 dump 文件清单。作业失败后要沿用同一组参数核对,不能只凭终端历史猜当时用过哪些 REMAP 或过滤条件。
1-- 目标 PDB;数据库链路由数据库服务器用于访问源库2SELECT owner, db_link, host, username3FROM dba_db_links4WHERE db_link LIKE 'SRC_PDB_LINK%';链路存在不代表连通,后续还要做实际查询并核对源 PDB、权限和网络加密。NETWORK_LINK 的导入不产生 dump 文件,目标端仍可用 DIRECTORY 写日志;不要把它和先 expdp 再搬文件的方案混在一起。
1-- 目标 PDB;只检验链路基础连通性2SELECT 1 FROM dual@src_pdb_link;返回一行只能说明这条链路能做简单查询,不能证明 Data Pump 导入账号对源 schema 有权限,也不能证明网络传输加密。再用源对象做一次授权范围内的查询。
1# 目标 PDB;源链路已核对,APP_USER 在源库可读2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 NETWORK_LINK=SRC_PDB_LINK SCHEMAS=APP_USER \4 REMAP_SCHEMA=APP_USER:APP_TEST LOGFILE=app_network_imp.log作业在目标库执行,通过数据库链路读取源库对象与数据,DIRECTORY 这里只承接目标端日志。网络方式受源、目标版本差距、对象类型与权限约束;大型迁移要先评估链路带宽和中断后如何处理目标库已有对象。
1SELECT object_path, comments2FROM schema_export_objects3WHERE object_path LIKE 'TABLE%'4ORDER BY object_path;INCLUDE、EXCLUDE 用的是 Data Pump 对象路径,不是随意猜的 DBA_OBJECTS.OBJECT_TYPE 字符串。先查该模式可用路径,再写过滤规则;导出模式改为 FULL 或 TABLES 后,要换对应的路径视图。
1# 目标 PDB;先确认迁移方案允许忽略 dump 中的优化器统计2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_no_stats.log \4 SCHEMAS=APP_USER EXCLUDE=STATISTICS过滤统计只适合计划在目标环境重新收集统计的迁移。不能在生产切换前忘了补统计,否则对象和行数据都在,SQL 计划仍可能明显变差。EXCLUDE 和 INCLUDE 不能在同一作业里并用。
1-- 目标 PDB;确认数据装载已结束,按迁移窗口执行2BEGIN3 dbms_stats.gather_schema_stats(4 ownname => 'APP_TEST',5 options => 'GATHER AUTO');6END;7/第 46 条排除了源统计后,要在目标库补这一环。GATHER AUTO 让数据库选需要收集的对象;完成后抽查关键表的 LAST_ANALYZED 和 SQL 实际计划,不能只看过程没有报错。
1SELECT owner, index_name, table_name,2 index_type, status3FROM dba_indexes4WHERE table_owner = 'APP_TEST'5AND partitioned = 'NO'6AND status = 'UNUSABLE'7ORDER BY table_name, index_name;非分区索引出现 UNUSABLE 时,需要查导入日志、底层表和重建条件。分区索引还得查索引分区与子分区状态;DBA_INDEXES.STATUS 只说明非分区索引,不能覆盖所有分区的可用性。
1SELECT table_name, constraint_name,2 constraint_type, status, validated3FROM dba_constraints4WHERE owner = 'APP_TEST'5AND table_name IN ('ORDERS', 'ORDER_ITEMS')6ORDER BY table_name, constraint_type, constraint_name;ENABLED 和 VALIDATED 要分开看:能拦住新写入,不一定说明迁移前的旧行都曾被完整验证。主键、外键不符合迁移方案时,先对导入日志和源端 DDL,不要直接启用约束。
1SELECT owner, trigger_name, table_name,2 triggering_event, status3FROM dba_triggers4WHERE table_owner = 'APP_TEST'5AND table_name IN ('ORDERS', 'ORDER_ITEMS')6ORDER BY table_name, trigger_name;表数据完整也可能在应用第一次写入时碰到触发器错误。核对触发器是否在目标库存在、是否启用,再结合 DBA_ERRORS 看编译状态;源端有触发器不代表这次过滤参数一定把它导入了。
1SELECT owner, table_name, grantee,2 privilege, grantable3FROM dba_tab_privs4WHERE owner = 'APP_TEST'5AND table_name IN ('ORDERS', 'ORDER_ITEMS')6ORDER BY table_name, grantee, privilege;REMAP_SCHEMA 不等于给应用账号补齐权限。源端、目标端的授权要按同一份应用账号清单比;只查对象 owner 自己能 SELECT,容易漏掉业务账号实际访问路径。
1-- 目标 PDB;源端连接后把 APP_TEST 改为 APP_USER,比较同一截止点2SELECT COUNT(*) rows_count,3 MIN(order_date) first_order_date,4 MAX(order_date) last_order_date5FROM app_test.orders;总行数相同仍可能缺了一段日期或多了重复批次。日期范围能帮我们发现明显装载缺口,但它也不是逐行一致性证明;关键订单号仍需按迁移验收口径抽查。
1# 源 PDB;确认已获相应功能授权,口令由终端交互输入2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_secure.dmp LOGFILE=app_secure_exp.log \4 SCHEMAS=APP_USER ENCRYPTION=ALL \5 ENCRYPTION_MODE=PASSWORD ENCRYPTION_PWD_PROMPT=YES跨环境搬运 dump 时,明文文件往往比传输本身更容易出问题。口令不要写进命令行或参数文件,交互提示可避免它直接出现在终端命令和进程参数里;导入端必须保管并输入同一口令。Data Pump 加密还涉及版本和 Oracle Advanced Security 授权,开作业前先核对。
1# 目标 PDB;先核对 dump 文件、口令保管与目标 schema2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_secure.dmp LOGFILE=app_secure_imp.log \4 SCHEMAS=APP_USER REMAP_SCHEMA=APP_USER:APP_TEST \5 ENCRYPTION_PWD_PROMPT=YES这条对应第 53 条的 PASSWORD 模式。口令错误或文件不完整,应先核对导出记录和文件校验,不要改口令继续试;若 dump 使用透明加密模式,导入前还要检查目标数据库的钱包条件。
1# 源 PDB;仅在确认 Advanced Compression 授权后使用2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_comp_%U.dmp LOGFILE=app_comp.log \4 SCHEMAS=APP_USER COMPRESSION=DATA_ONLY \5 COMPRESSION_ALGORITHM=LOWDATA_ONLY 在这里是压缩的数据范围,不是只导出数据;元数据仍会导出。LOW 倾向减少 CPU 消耗,实际压缩比要拿本库样本测。全数据压缩需要 Advanced Compression 许可,不能只因空间紧张就默认打开。
1# 源 PDB;目标对象已按同一结构建好时才考虑2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_rows.dmp LOGFILE=app_rows_exp.log \4 TABLES=APP_USER.ORDERS CONTENT=DATA_ONLY这次 CONTENT=DATA_ONLY 才是导出内容:文件不包含表、索引等定义。它适合已先部署结构的增量装载或测试,不适合拿来做完整 schema 迁移;导入前还要明确目标表已有数据如何处理。
1# 目标 PDB;目标用户默认表空间及配额已核对2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_no_segattr.log \4 SCHEMAS=APP_USER REMAP_SCHEMA=APP_USER:APP_TEST \5 TRANSFORM=SEGMENT_ATTRIBUTES:NSEGMENT_ATTRIBUTES:N 会让适用对象的 DDL 去掉 STORAGE 和 TABLESPACE 属性。若只想去掉存储参数、仍保留源表空间,应使用 TRANSFORM=STORAGE:N;这两种结果别靠猜,先用第 20 条的 SQLFILE 看实际 DDL。
1# 源 PDB;只计算预计表行数据量,不实际导出2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 SCHEMAS=APP_USER ESTIMATE_ONLY=YES ESTIMATE=STATISTICS \4 NOLOGFILE=YESESTIMATE_ONLY=YES 不会生成 dump,适合先判断目标文件系统大致够不够。估算只针对表行数据,不包括元数据;统计过旧、压缩、行过滤等都会让预测与实际文件大小偏离。最终仍要给日志、多个 dump 分片和余量留空间。
1-- 源库;一致性导出前看保留秒数与最长查询耗时2SELECT begin_time, end_time, maxquerylen,3 tuned_undoretention, ssolderrcnt4FROM v$undostat5ORDER BY begin_time DESC6FETCH FIRST 12 ROWS ONLY;第 10 条按 SCN 导出时,UNDO 至少要支撑作业持续读取旧版本。MAXQUERYLEN 与 TUNED_UNDORETENTION 都以秒计;SSOLDERRCNT 有值说明窗口内出现过 ORA-01555,但不能单凭这三个数保证下次导出绝不会失败。
1-- 源库;检查导出窗口里的 UNDO 空间压力2SELECT begin_time, end_time,3 unxpstealcnt, nospaceerrcnt, ssolderrcnt4FROM v$undostat5WHERE begin_time >= SYSDATE - 16ORDER BY begin_time;UNXPSTEALCNT 反映尝试抢占未过期 extent,NOSPACEERRCNT 反映请求空间却没有空闲可用。两项升高时不要只调大 UNDO_RETENTION 参数,应核对 UNDO 表空间、写入量和预期导出时长。
1# 源 PDB;表名先和业务对象清单核对2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=orders.dmp LOGFILE=orders_exp.log \4 TABLES=APP_USER.ORDERS,APP_USER.ORDER_ITEMS表模式只带指定表及相关对象,不是完整 schema 备份。依赖的序列、同义词、包和其他表要单列检查,别因为导出日志是 success 就认为业务已能启动。
1# 源 PDB;结构预审,文件里没有表行数据2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_metadata.dmp LOGFILE=app_metadata.log \4 SCHEMAS=APP_USER CONTENT=METADATA_ONLY这份 dump 可以先用于目标库 DDL 预演。METADATA_ONLY 不带数据,不能当成业务表备份;统计信息随元数据导入后的处理也要按目标库计划确认。
1# 保存为 orders_recent.par;源 PDB,日期边界按迁移方案替换2DIRECTORY=DPUMP_DIR3DUMPFILE=orders_recent.dmp4LOGFILE=orders_recent.log5TABLES=APP_USER.ORDERS6QUERY=APP_USER.ORDERS:"WHERE ORDER_DATE >= DATE '2025-01-01'"运行 expdp app_admin@SALES_PDB PARFILE=orders_recent.par。过滤条件放参数文件,少折腾 shell 引号。QUERY 只限制表行,不等于自动维护和它有关的订单明细;多表间的业务一致性要自己核对。
1# 源 PDB;目标用于测试,禁止当成完整迁移文件2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=orders_sample.dmp LOGFILE=orders_sample.log \4 TABLES=APP_USER.ORDERS SAMPLE=5SAMPLE=5 约取 5% 的表行。随机抽样不保证主从表的关联完整,导入后的外键失败和应用测试异常不能简单归因于目标库。
1-- 目标 PDB;源端用同一 SQL 改 owner 后逐列比较2SELECT column_id, column_name, data_type,3 data_length, data_precision, data_scale, nullable4FROM dba_tab_columns5WHERE owner = 'APP_TEST'6AND table_name = 'ORDERS'7ORDER BY column_id;第 26 条的 APPEND 和第 27 条的 TRUNCATE 都会遇到已有表。先比较列名、类型、长度和可空性;源目标结构相近也可能因新增非空列或字符长度差异导致装载失败。
1-- 目标 PDB;导入前记录,别把原有行算进本次导入2SELECT COUNT(*) AS before_rows,3 MIN(order_date) AS first_order_date,4 MAX(order_date) AS last_order_date5FROM app_test.orders;只看导入后的总行数,分不清原本就在目标库的行和本次新装的行。这个基线还要连同截止时间保存;APPEND 之后才能明确本次新增了多少。
1-- 目标 PDB;ORDER_ID 按实际业务唯一键替换2SELECT order_id, COUNT(*) AS copies3FROM app_test.orders4GROUP BY order_id5HAVING COUNT(*) > 1;已有重复键要先查原因。若目标表没有唯一约束,APPEND 可能继续把重复行写进去;若有约束,导入可能直接报错。这里查的是目标库现状,不是 dump 内的重复行。
1-- 目标 PDB;TRUNCATE、REPLACE 前查看依赖关系2SELECT child.owner AS child_owner,3 child.table_name AS child_table,4 child.constraint_name AS foreign_key,5 child.status AS foreign_key_status6FROM dba_constraints child7JOIN dba_constraints parent8 ON child.r_owner = parent.owner9 AND child.r_constraint_name = parent.constraint_name10WHERE child.constraint_type = 'R'11AND parent.owner = 'APP_TEST'12AND parent.table_name = 'ORDERS';外键引用不仅影响截断和重建,也影响迁移后的应用写入。遇到依赖表时应把主子表装载顺序、停写范围和回退方案写进迁移单,而不是运行时临时禁用约束。
1# 目标 PDB;验收方案允许隔离坏行时才考虑2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_rows.dmp LOGFILE=app_constraint.log \4 TABLES=APP_USER.ORDERS CONTENT=DATA_ONLY \5 DATA_OPTIONS=SKIP_CONSTRAINT_ERRORS这只在外部表装载路径上对非延迟约束错误起作用,坏行会写入日志;延迟约束违规仍会使整批回滚。作业结束后要统计拒绝行并和业务方确认,不能仅凭 job completed 就通过验收。
1-- 目标 PDB;源端用同一筛选条件和截止 SCN 对照2SELECT COUNT(*) AS rows_count3FROM app_test.orders4WHERE order_date >= DATE '2025-01-01';如果第 63 条按日期导出,这里也要按相同条件验收。行数相同不代表每行相同;关键订单号、金额和关联明细,还需按业务抽样或校验规则对账。
1# 源 PDB;目录所在文件系统要能容纳所有分片2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_part_%U.dmp LOGFILE=app_part.log \4 SCHEMAS=APP_USER FILESIZE=5GB%U 让 Data Pump 在分片达到上限后继续生成新文件;没有可扩展模板而文件写满时,作业可能无法继续。分片上限不是整个导出大小,容量预算仍要看总量。
1# 源 PDB;DPUMP_A、DPUMP_B 均已建目录对象并授予权限2expdp app_admin@SALES_PDB \3 DUMPFILE=DPUMP_A:app_a_%U.dmp,DPUMP_B:app_b_%U.dmp \4 LOGFILE=DPUMP_A:app_exp.log SCHEMAS=APP_USER \5 PARALLEL=2目录前缀指 Oracle DIRECTORY 对象,不是客户端本地路径。不同文件系统可以减轻单盘压力;前提是两个目录都能写、都有余量,作业并行度也不能超过现场 CPU 和 I/O 能承受的范围。
1# 源 PDB;状态频率单位为秒2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_status_%U.dmp LOGFILE=app_status.log \4 SCHEMAS=APP_USER STATUS=60STATUS=60 让客户端周期性打印进度,方便判断是否仍在搬运数据。终端上暂时没有新行不等于作业停了;还要查主控表、worker 和日志。
1# 源 PDB;作业名在同一 schema 内应避免冲突2expdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_named_%U.dmp LOGFILE=app_named.log \4 SCHEMAS=APP_USER JOB_NAME=APP_EXP_202609后续 ATTACH 和 DBA_DATAPUMP_JOBS 都要用这个名称。重跑之前先确认旧作业已结束或清理,不能仅凭同名日志文件推断是同一个 job。
1-- ATTACH 到原 job,在 Export> 提示符输入2ADD_FILE=DPUMP_B:app_extra_%U.dmp作业并行度增加或原目录余量不足时,可以给同一个 job 补文件。先确认新 DIRECTORY 权限和空间,补文件后要把它写进传输清单;漏掉这份文件,目标导入就不是完整 dump 集。
1-- Export> 提示符;对后续生成的文件生效2FILESIZE=10GB这不会把已经写出的分片重新切割。第 71 条是启动时设上限,这条是在运行中调整;变更原因和分片清单都要记录,交接时别假设所有文件同样大。
1-- Export> 提示符;数据库 I/O 被挤占时按窗口方案调整2PARALLEL=1第 17 条展示了调整 worker,这里给出现场降载值。调低并行度不会让正在运行的对象瞬间停写;要看数据库负载和作业状态的后续变化,不要只看命令返回成功。
1-- Export> 提示符;需在终端持续看日志时输入2CONTINUE_CLIENT它会把客户端切回日志显示模式;如果 job 已停止,还会尝试启动原 job。因而停止后的作业不能随手输入这条,先确认第 16 条所述的续跑条件。
1-- Export> 提示符;确认后台 job 正在运行2EXIT_CLIENT退出客户端不会取消运行中的 Data Pump job。需要在下一个班次接管时,记录 owner、job 名称、日志路径和目录对象,后续用 ATTACH 查看。
1-- Export> 提示符;确认不再续跑且已有重新导出方案2KILL_JOBKILL_JOB 会终止 job 并删除主控表,不能再用 START_JOB 续跑。它不会替你删除已产生的 dump 和日志文件;残留文件应和新作业名称分开,避免误用半截 dump。
1# 目标 PDB;目标表空间名称与配额已预审2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_no_storage.log \4 SCHEMAS=APP_USER TRANSFORM=STORAGE:N第 57 条的 SEGMENT_ATTRIBUTES:N 连 TABLESPACE 子句一起去掉;这里仅移除 STORAGE,仍保留源 DDL 的表空间指向。要迁移到不同表空间时,还需结合映射参数并先看 SQLFILE。
1# 测试 PDB;源与目标在同一数据库且 schema 不同时检查对象类型2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_new_oid.log \4 SCHEMAS=APP_USER REMAP_SCHEMA=APP_USER:APP_TEST \5 TRANSFORM=OID:N同库导入到另一个 schema 时,源对象类型的 OID 可能与原对象冲突。OID:N 让新对象取得新 OID;普通跨库迁移不应把它当成固定模板参数,先检查 dump 里有没有用户定义类型。
1# 目标 PDB;确认有清理计划,避免主控表长期堆积2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_keep_master.log \4 SCHEMAS=APP_USER KEEP_MASTER=YES成功作业通常删除主控表;这里显式保留,适合需要审计作业明细的迁移。主控表不是业务表,也不是完整导入报告;查完后按管理流程清理。
1# 隔离测试 PDB;只创建主控表,不装载业务对象2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=app_master_only.log \4 MASTER_ONLY=YES JOB_NAME=APP_DUMP_INSPECTMASTER_ONLY 让作业停在可检查主控表的阶段,适合 dump 来自外部环境、对象清单不明时先验文件。主控表结构不是稳定的业务接口;按 Oracle 的 Data Pump 说明审查,别把它当常规生产查询视图。
1# 目标 PDB;dump 中须确实有该表及相关元数据2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_user_202609.dmp LOGFILE=orders_only.log \4 TABLES=APP_USER.ORDERS REMAP_SCHEMA=APP_USER:APP_TEST大 schema 迁移失败时,可以隔离一张表重做或预演。已有表如何处理仍要按第 25—28 条选,不能仅凭 TABLES 参数认定不会碰到现有对象。
1# 目标 PDB;核对新名称与应用 SQL、授权清单一致2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=orders.dmp LOGFILE=orders_rename.log \4 TABLES=APP_USER.ORDERS REMAP_SCHEMA=APP_USER:APP_TEST \5 REMAP_TABLE=APP_USER.ORDERS:ORDERS_STAGEREMAP_TABLE 可把表落到临时验收名称,不会顺手改应用代码里写死的表名、同义词或别的 SQL 文本。若目标已有 ORDERS_STAGE,先检查冲突动作。
1# 保存为 orders_import_recent.par;目标 PDB2DIRECTORY=DPUMP_DIR3DUMPFILE=orders.dmp4LOGFILE=orders_import_recent.log5TABLES=APP_USER.ORDERS6REMAP_SCHEMA=APP_USER:APP_TEST7QUERY=APP_USER.ORDERS:"WHERE ORDER_DATE >= DATE '2025-01-01'"运行 impdp app_admin@SALES_PDB PARFILE=orders_import_recent.par。这次过滤发生在导入侧:dump 仍可能包含全量行,不能把过滤后的目标行数当作源 dump 的总行数。先检查谓词与表结构是否匹配。
1# 目标 PDB;装载路径与性能需在测试库比较2impdp app_admin@SALES_PDB DIRECTORY=DPUMP_DIR \3 DUMPFILE=app_rows.dmp LOGFILE=app_no_append_hint.log \4 TABLES=APP_USER.ORDERS CONTENT=DATA_ONLY \5 DATA_OPTIONS=DISABLE_APPEND_HINT这个选项影响装载时使用 APPEND hint 的方式,不等于 TABLE_EXISTS_ACTION=APPEND 的业务含义。选它之前要考虑表空间、redo、并行与约束;不要把参数名相近的两个 APPEND 混成一件事。
1-- 目标 PDB;先看统计是否新鲜,必要时执行实际 COUNT2SELECT partition_name, num_rows, last_analyzed3FROM dba_tab_partitions4WHERE table_owner = 'APP_TEST'5AND table_name = 'ORDERS'6ORDER BY partition_position;NUM_ROWS 来自统计信息,不是实时 COUNT(*)。导入只漏了某个分区时,总行数可能掩盖问题;需要按源端相同分区边界查实际行数。
1-- 目标 PDB;关注业务过滤列的统计是否来自源环境2SELECT column_name, num_distinct, num_nulls,3 last_analyzed4FROM dba_tab_col_statistics5WHERE owner = 'APP_TEST'6AND table_name = 'ORDERS'7ORDER BY column_name;对象和数据导入完成后,SQL 仍可能因为旧统计选择差计划。先看关键列的统计时间和分布,再决定是否在目标库重新收集;不要在切换时临时对整个 schema 无差别收集。
1# 数据库服务器;先从 ALL_DIRECTORIES 确认 DPUMP_DIR 的真实路径2find /u01/dpump -maxdepth 1 -type f -name 'app_part_*.dmp' \3 -printf '%f %s bytes\n' | sort第 71 条设置了 FILESIZE,最终分片数可能多于启动时的并行数。交接 dump 时把所有分片列清楚,不要只搬第一份;文件名和大小也要与作业日志对上。
1# 数据库服务器;导出结束后生成并保管同一份清单2sha256sum /u01/dpump/app_part_*.dmp > /u01/dpump/app_part.sha256传输到目标主机后,对同名文件运行 sha256sum -c app_part.sha256。校验能发现文件传输损坏,不会证明这次 Data Pump 包含了所有业务对象;对象清单仍要用日志和目标库核对。
1-- 目标 PDB;导入完成后核对应用连接账号2SELECT username, account_status, profile,3 default_tablespace, temporary_tablespace4FROM dba_users5WHERE username IN ('APP_TEST', 'APP_LOGIN');对象都导进来了,账号却锁定或过期,应用仍会登录失败。REMAP_SCHEMA 主要处理对象归属,不保证目标应用账号状态与源库相同。
1-- 目标 PDB;源端用同一账号清单对照2SELECT grantee, privilege, admin_option3FROM dba_sys_privs4WHERE grantee IN ('APP_TEST', 'APP_LOGIN')5ORDER BY grantee, privilege;系统权限通常应少而明确。迁移后程序报权限错时先找具体语句和对象,不能为了赶切换就给应用账号补 DBA 角色。
1-- 目标 PDB;检查业务连接默认启用的角色2SELECT grantee, granted_role, default_role3FROM dba_role_privs4WHERE grantee IN ('APP_TEST', 'APP_LOGIN')5ORDER BY grantee, granted_role;角色已授予但不是默认角色,登录后能用的权限可能与预期不同。不过存储过程内的权限判断还要看直接授权,不能用“角色存在”替代对象授权核验。
1-- 目标 PDB;尤其关注仍指向源 schema 或远端 DB link 的名称2SELECT owner, synonym_name, table_owner,3 table_name, db_link4FROM dba_synonyms5WHERE owner IN ('APP_TEST', 'APP_LOGIN')6ORDER BY owner, synonym_name;同义词名看着正确,也可能仍指向源端 schema 或数据库链路。若新旧库同名对象并存,应用上线前要用实际连接账号测试解析结果。
1-- 目标 PDB;链路账号和 HOST 的变更需单独管理2SELECT owner, db_link, username, host3FROM dba_db_links4WHERE owner IN ('APP_TEST', 'APP_LOGIN')5ORDER BY owner, db_link;Data Pump 不会替我们判断业务链路该指向哪套环境。链路存在也不代表能连通或权限正确;上线前应从目标库按实际业务账号执行一条只读测试查询。
1-- 目标 PDB;避免装载后第一次写入才发现唯一性配置缺失2SELECT table_name, constraint_name, constraint_type,3 status, validated4FROM dba_constraints5WHERE owner = 'APP_TEST'6AND table_name IN ('ORDERS', 'ORDER_ITEMS')7AND constraint_type IN ('P', 'U')8ORDER BY table_name, constraint_name;第 49 条核对所有约束,这里聚焦业务键:主键或唯一约束没恢复,APPEND 后的重复数据可能一路写进生产。发现状态与源端不同,应先找导入日志和索引状态。
1-- 连接目标 PDB 的 APP_LOGIN 账号;保持只读2SELECT COUNT(*) AS accessible_rows3FROM app_test.orders;管理员能查表,不能证明应用账号也能查。实际业务账号查询能同时验证登录、同义词或对象名、对象授权和表数据访问,但它还不是完整业务回归测试。
1-- 目标 PDB;ORDER_ID 换成验收抽样清单中的真实订单2SELECT o.order_id,3 COUNT(i.order_id) AS item_count4FROM app_test.orders o5LEFT JOIN app_test.order_items i6 ON i.order_id = o.order_id7WHERE o.order_id IN (10001, 10002, 10003)8GROUP BY o.order_id9ORDER BY o.order_id;第 33、52、70 条看了总量和时间范围,最后还要抽查主子表是否一起到齐。样本应来自业务方的订单清单;明细条数相同仍需再核对金额、状态等关键字段。
Data Pump 迁移别只盯着导入作业的最后一行。dump 分片有没有搬齐、目标表原来有没有数据、对象定义和授权是否到位,都要在切换前逐项核对。导入日志记录作业过程,真正能不能用,还得让业务账号连上目标库查表、跑关键功能。
 ORA100 DBA100 系列海报
更多数据库场景命令放在 ORA100 · DBA100:
微信里搜索小程序 「三笠的百令册」,也可以随时查。