MySQL Group Replication 集群运维 100 条命令
前言
Group Replication 是 MySQL 的组复制方案:成员通过组通信维持同一份成员视图,事务进入组后还要经过认证,再在成员上应用。单主模式下只有一个 PRIMARY 承接写入。值班时看到三台机器都能连,并不能直接说集群健康;成员是否 ONLINE、当前主节点是谁、认证队列与远端应用队列是否积压,都要分开看。
这篇把成员状态、事务认证、流控和恢复通道的检查放在一起。遇到副本落后或主节点变化,先用组视图对齐各节点观察结果,再查队列和错误。建议收藏,切换窗口也方便逐项核对。
示例采用 Linux、MySQL 8.4 LTS、三节点单主模式。SQL 默认在任意在线成员执行,需要在特定成员执行的会逐条注明。实例名和地址按现场替换;修改成员状态的命令放在诊断之后。
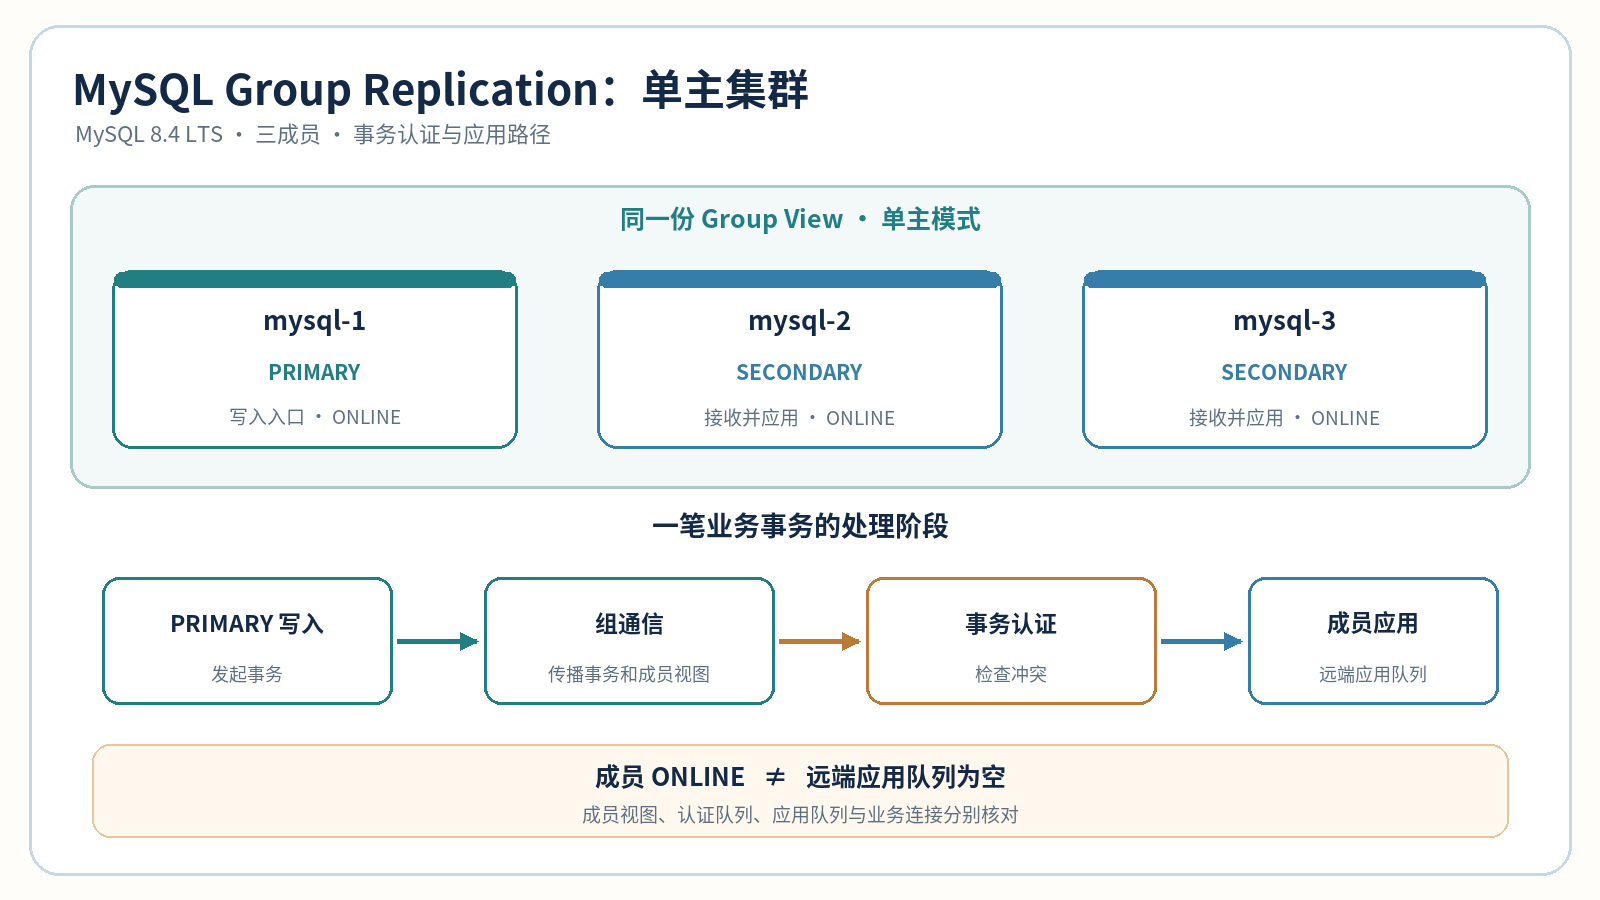
MySQL Group Replication 单主模式成员视图、认证与远端应用示意
图中组通信、事务认证和各成员应用是不同步骤。PRIMARY 的业务写入不等于其他成员此刻已经应用完相同事务。
一、成员状态与主节点
1. 核对本节点版本与 UUID
MEMBER_ID 用的就是成员 UUID。计划重建或重新加入成员时,先记录本节点身份;不要把主机名相同当成 UUID 相同。
2. 查看本节点看见的所有组成员
正常三节点单主组应有一个 PRIMARY,其余成员为 SECONDARY 且 ONLINE。RECOVERING 还在补数据,UNREACHABLE 是本节点怀疑联系不上它;网络分区时,要在其他在线成员也取一次快照,不能只凭一台节点的视图宣称组已经完整。
3. 单独确认当前 PRIMARY 身份
无结果、多个结果或主成员不是 ONLINE,都不能继续按平时的写流量路径判断。先对照第 2 条的全员视图与各节点日志;客户端实际连接落点仍需另查。
4. 找出尚未进入 ONLINE 的成员
RECOVERING 与 ERROR 处理方向不同:前者看恢复通道和待应用事务,后者要查该成员错误日志。视图里没有某节点,也可能是成员已离组;应核对预期三节点清单,而不是把空结果直接当成全组健康。
5. 统计当前视图里的在线成员数
三节点组的在线数量下降时要关注是否仍有多数成员可通信。这里是本节点看到的成员视图 ,不是对所有网络分区的仲裁证明;须在其他成员上交叉核对,并检查组通信与业务写入状态。
二、事务认证与应用进度
6. 查看各成员当前组视图 ID 与认证队列
COUNT_TRANSACTIONS_IN_QUEUE 是待认证 事务,不是已经认证后待重放的队列。组成员变更时 VIEW_ID 会变化;跨节点比较统计前先确认它们看到的是同一个视图,并留意远端成员统计有刷新间隔。
7. 查看各成员收到但尚未应用的事务数
某个成员的远端应用队列持续增长,说明它收到组事务后应用跟不上。和第 6 条的认证队列拆开看,才知道慢在认证前还是应用阶段;REMOTE_APPLIED 是累计计数,要看两次采样的增量。
8. 检查事务认证冲突是否增加
冲突数与本地回滚数都要看增量 。单主模式下频繁出现认证冲突或回滚,要核对是否发生了成员角色变化、应用重试或异常写入;仅凭一次累计数不能定性为正在冲突。
9. 核对已在所有成员提交的 GTID 集
这列是组统计中的“所有成员已提交”GTID 集,按固定间隔更新 ,并非每次业务提交后立即同步刷新。切换前可用它作交叉依据,但还要核对各成员本地执行的 GTID 与当前组视图,不能把一次相同结果当成最终一致性验收。
10. 查看本节点组复制应用通道是否运行
SERVICE_STATE=ON 表示 applier 线程存在并处于活跃或空闲状态,不说明队列为零。COUNT_TRANSACTIONS_RETRIES 是累计重试次数,持续上升时再下探 worker 错误与锁等待。组通道由 Group Replication 管理,不要按普通副本随意 START REPLICA。
三、分布式恢复通道
11. 查看分布式恢复通道的接收状态
group_replication_recovery 是新成员补齐事务用的通道,和常规组事务的 group_replication_applier 不同。连接错误要去该成员的错误日志找上下文;通道没有当前错误,也要核对恢复是否仍在推进,不能只靠 SERVICE_STATE=ON 判断已追平。
12. 查看恢复通道的应用服务与重试
恢复通道接收日志正常但成员长时间不进 ONLINE 时,再检查应用端是否停止或反复重试。第 11 条是接收,第 12 条是应用;两端都在运行,也可能只是待补事务量大,需要结合组成员状态和执行 GTID 的变化判断。
四、流控与应用线程
13. 查看流控模式及认证、应用阈值
阈值单位是事务数 ,分别对应第 6 条的待认证队列和第 7 条的待应用队列。DISABLED 不会因队列增长自动限流;QUOTA 才会按流控机制调节。排障先看队列是否连续增长和哪个成员落后,不要把调高阈值当成清理积压。
14. 找出恢复通道出错的应用 worker
第 12 条只看通道是否运行;这里能定位具体停下来的 worker。错误号为 0 仅表示没有记录到使 worker 停止的错误,恢复长期不推进时还要检查正在应用的事务和错误日志。不要把恢复通道当作普通异步复制通道重置。
15. 看恢复 worker 正在应用哪笔事务
一笔事务长时间停在同一 worker,先对照重试数、锁等待和错误日志。APPLYING_TRANSACTION 为空也可能是 worker 空闲,不能凭空值认定恢复完成;要看成员是否已进入 ONLINE。
16. 对照恢复 worker 最近应用的 GTID
最近应用的 GTID 和完成时间持续变化,说明恢复仍在推进。并行 worker 之间顺序不能简单按 WORKER_ID 推断;各 worker 都不变化时再查接收端是否有新事务,以及成员错误日志。
17. 找出组事务应用通道报错的 worker
这是正常组事务应用通道,与第 14 条的分布式恢复通道分开查。应用错误可能令成员退出组;先保留错误日志和事务上下文,再决定重建或重新加入,不要为了清掉告警直接重置通道元数据。
18. 核对成员驱逐和自动重入设置
驱逐超时是成员产生怀疑之后额外等待的秒数,不包括最初的故障检测时间。自动重入针对被驱逐或失去多数成员等场景,不会修复 applier 错误;尝试期间节点保持超级只读,读请求仍可能读到旧数据。
19. 检查失去多数成员后的等待设置
少数派无法取得仲裁,事务可能被阻塞。这个超时决定少数派等多久才转入错误状态;值为 0 时不会因等待超时自动退出。网络分区处理必须在所有成员上核对组视图,不能在单节点随意强制新成员列表。
20. 查看本成员最近一次组视图与实际状态
本节点显示 ONLINE,不代表其他成员仍承认它在组内;成员被驱逐而通信尚未恢复时,本地视图可能滞后。把这条结果和其他在线成员的组视图交叉比对,再查是否真的有多数成员可通信。
五、成员维护前后的组状态
21. 确认仍有几名 ONLINE 成员
三节点组维护一名成员后,剩下两名需要保持通信。这里仅是当前连接成员看到的组视图;两节点组若再停一名就没有多数派,不能拿旧截图作为停机依据。
22. 列出各成员角色和版本
维护主节点前先找当前 PRIMARY,确认接替节点都 ONLINE。滚动升级还要看版本:混合版本期间,主节点的可选范围受组复制兼容规则约束,不能只按服务器性能挑人。
23. 核对目标成员当前是否允许写入
单主模式的辅助成员通常是超级只读。若准备停的是主节点,先确认应用写入入口已经有切换方案;查询只说明该成员此刻的设置,不能证明代理已经改路由。
24. 核对组是否仍为单主模式
本文按单主模式写,前一项应为 ON,后一项应为 OFF。这两项是组级设置,不能在在线组里把普通 SET GLOBAL 当作切换模式的办法;模式变化另有组复制函数和全组影响。
25. 查看各成员的自动选主权重
主节点离组后,版本兼容性先影响候选资格,同版本候选之间再参考权重。member_weight 是自动选举偏好,不是当前主节点的身份;要做明确的计划切换,使用指定成员函数并做业务验收。
26. 检查成员重启时会否自动加入组
维护期间要知道 MySQL 进程重启后是否会自动重入。bootstrap_group 在普通成员上应为 OFF;只在明确的全组重启流程中短时启用,不能因为某成员掉线就自行 bootstrap,避免形成另一个组。
27. 查看组通信协议与写入共识并发
协议版本要兼顾组里最旧的成员版本。此表是组级信息,适合升级前记录;WRITE_CONCURRENCY 不是业务并发连接数,也不能用它推算这次维护一定不会降吞吐。
28. 在目标成员停止组复制
只在计划维护的这一名成员执行。停后从其他成员确认它已离组、剩余成员仍能写入;若该节点是主节点,会触发新主选举。命令返回不等于客户端连接都已迁移。
29. 确认维护成员已经离组
目标应显示 OFFLINE;随后在其他成员再查一次组视图。成员离组后,本地视图不再是全组现状的可靠来源,不能用这条替代剩余多数派确认。
30. 在剩余成员确认新主和组成员
停的是主节点时,应出现新的 PRIMARY,辅助节点仍 ONLINE。还要通过业务入口做实际写入检查,并确认被维护节点不再接收写流量;只看到选主完成,不代表客户端连接池已经切过来。
六、成员回归
31. 核对待回归成员的种子节点地址
group_seeds 用的是组通信地址,至少要有一台仍 ONLINE 的成员可达。MySQL 通信栈和 XCom 的连接与权限规则不同;种子地址写对了,也要确认目标端口、防火墙与认证。
32. 查看本成员对外公布的组通信地址
local_address 是成员间通信地址,不能拿它给业务连接数据库。它必须能被其他成员解析并访问;采用 MySQL 通信栈时还要与服务器监听地址相符。这里把 SQL 端口一起列出来,方便排除把两种地址写混的错误。
33. 确认回归成员仍属于原来的组
group_uuid 应一致,member_uuid 应各不相同。克隆或重建过实例时尤其要查这两个值;把旧配置复制到新机器,不能因此把两个 MySQL 实例变成同一个成员身份。
34. 启动已完成维护的成员的组复制
这是回到现有组,不是重新 bootstrap 全组。命令返回后成员可能先处于 RECOVERING,要等补齐事务并进 ONLINE;若恢复账号或网络有问题,继续查第 11、14 条及错误日志。
35. 从在线成员观察回归节点的状态变化
RECOVERING 表示还在分布式恢复,ONLINE 才进入组的正常成员视图。查询为空时先列全组成员,核对 UUID;不能因为待回归节点的本地 SQL 能连,就宣布它已重新入组。
36. 看回归成员的组事务应用队列是否在下降
队列下降、远端应用数增加,说明正在追赶。COUNT_TRANSACTIONS_REMOTE_APPLIED 是累计值,队列偶尔升高也可能只是组内新事务较多;要看连续几次采样,配合成员状态。
37. 查这次恢复是否可能触发远程克隆
与合适 donor 的事务差超过阈值时,组复制可能使用远程克隆;低于阈值或克隆不可用则走 donor 二进制日志。阈值不等于“已经触发克隆”的证明,具体路径要看成员日志和 clone 状态。不要为了让它立即克隆就把活跃组阈值调得很低。
38. 查看找不到合适 donor 时会重试多久
这两项分别控制连接 donor 的重试次数和没有合适 donor 时的等待间隔。它们不是成员应用事务的速度限制;连续失败应先查恢复通道错误、donor 可用性和网络,不能只把次数调大。
39. 确认恢复成员是否安装了 Clone 插件
没有结果或不是 ACTIVE 时,不能假设远程克隆可用;组复制仍可能走增量恢复,但前提是合适 donor 保留了所需的二进制日志。Clone 是否真的发生,还要看分布式恢复日志。
40. 查看可用 donor 仍保留哪些二进制日志
增量恢复要能从 donor 取到回归成员缺的事务。列出文件只是第一步:还要对照回归成员的 GTID 缺口和 donor 的 GTID、日志保留情况。缺口已被清理掉时,单纯重试连接不会补回数据。
七、增量恢复与 Clone
41. 记下候选 donor 已执行的 GTID 集
donor 已执行的 GTID 是判断回归成员缺口的基准。组在继续写入时它会变化,因此要记录取样时间;若几名 donor 的 GTID 差异很大,先查其成员状态和远端应用队列。
42. 记下回归成员本地已执行的 GTID 集
本地 GTID 里既可能有组事务,也可能有本地意外写入产生的事务。比较前先核对组 UUID 与成员身份;不能把所有额外 GTID 都简单解释成“备库领先”。
43. 算出回归成员还缺哪些 GTID
返回空集合表示这份 donor 快照中的 GTID 本地都已有,不等于此刻组里没有新提交。返回非空时,再看 donor 的 gtid_purged 和日志保留;不能凭一个 GTID 范围就猜所需二进制日志文件名。
44. 判断 donor 是否已经清理掉缺口所在的 GTID
gtid_purged 记录已执行但不在当前二进制日志中的 GTID。若回归成员缺的事务已落在 donor 的 purged 集里,该 donor 不能靠增量恢复提供这些日志;要找其他保留完整日志的 donor,或评估 Clone。
45. 看回归成员本次是否真的走了 Clone
这张表只保留当前或上一次 Clone,不是历史审计表。source 是实际 donor 地址,Failed 后要读错误号和日志;无行不能据此认定增量恢复正常,继续查恢复通道。
46. 查看 Clone 卡在哪个阶段
FILE COPY、PAGE_COPY、REDO_COPY 等阶段耗时不同。进度停住时,看磁盘和网络,再查 Clone 错误;DATA 与 ESTIMATE 是阶段读数,不能把一个阶段的百分比直接当成整个成员恢复完成率。
47. 核对 Clone 带来的 GTID 与日志位置
Clone 会携带 donor 的复制坐标,之后回归成员还要继续补齐 Clone 期间产生的新事务。这里的 gtid_executed 是 Clone 时的基线,不是当前组最终 GTID;Completed 也不等于成员已经 ONLINE。
48. 查看恢复通道最近一次收到 donor 心跳的时间
持续有心跳而事务不前进,重点转到应用 worker、GTID 缺口和 donor 日志;CONNECTING 或错误号非零,先查网络、账号和认证。心跳计数可能在重启或重置后清零,要看时间和增量。
49. 查回归成员最近的组复制错误日志
这张表是有限大小的内存环形缓冲,旧日志会被覆盖。成员长期卡在 RECOVERING 时,按具体错误号到实例错误日志找完整上下文;不能因表里没有相关行就认为没有报错。
八、计划换主
50. 核对各成员的事务一致性级别
默认的 BEFORE_ON_PRIMARY_FAILOVER 会在新主仍有旧主事务待应用时暂缓新请求。某成员单独改了全局或会话级别,切换后客户端的等待和读到的数据可能与预期不同;核对配置,不要在切换窗口直接全组改成最强级别。
51. 列出可接替主节点的在线成员
候选成员先要 ONLINE。混合版本升级期间,还需看 MySQL 的最低版本选主限制;这条排序只是方便人工核对,不能把第一个结果机械地当成合法新主。
52. 查当前主节点上还没结束的 InnoDB 事务
指定新主函数会等待当前主节点正在运行的事务;给了超时还可能断开没有进入提交阶段的会话。长事务要提前和业务方处理,不能把函数长时间不返回直接归咎于组通信。
53. 看当前主节点上是否有长时间运行的 DDL
MySQL 8.4 的指定换主也会等待正在运行的 DDL。看到 ALTER TABLE 等操作,应先确认能否等它完成;直接断开或强制切换可能影响业务和结构变更。PROCESSLIST 是瞬时视图,必要时多次取样。
54. 从候选节点本地读出换主函数需要的 UUID
函数参数是成员 UUID,不是主机名。目标必须仍为在线辅助成员;查询无结果或本地仍在 RECOVERING,先处理成员状态,不能用旧维护记录里的 UUID 硬试。
55. 指定在线成员成为新的 PRIMARY
第二个参数是当前主节点运行中事务的等待上限,单位秒;设置后新事务也不能再从旧主开始。函数会等事务和 DDL,返回文本要读具体结果。它只改变组内 PRIMARY,客户端路由还得由 Router、代理或应用处理。
56. 在另一名在线成员回读主节点角色
预期只有目标成员为 PRIMARY,原主变成 SECONDARY,其余成员仍 ONLINE。换个成员回读是为了确认成员视图已传播;单台节点一瞬间的结果不代表路由已切完。
57. 在新主直连确认超级只读已关闭
目标应是组视图里的 PRIMARY 且允许写入。若仍超级只读,先查组成员状态和选主动作,不要手工关掉 super_read_only 来掩盖未完成的切换。
58. 在原主直连确认已转为只读成员
旧主应不再接受写入。offline_mode 可能由现场成员退出动作控制,不能要求它一定为某个固定值;关键是组角色、只读状态与业务入口一致,避免旧连接继续向它发送写请求。
59. 换主后核对新主的认证与应用队列
新主若仍在补旧主事务,一致性级别可能让新请求等待。看队列是否继续下降,远端应用数是否前进;ONLINE 和 PRIMARY 两个状态本身不说明 backlog 已清零。
60. 从业务使用的入口核对实际连接节点
用只读账号就能检查新连接落点,无需为验收额外写业务表。还要检查应用连接池的旧连接和真实写请求是否按预期完成;组内选主成功并不会自动替客户端换连接。
九、组通信与多数派故障
61. 看本节点最近怀疑过哪些成员失联
JSON 里每个成员地址对应被本节点怀疑的次数。某节点持续升高时,去查两端组通信日志、网络丢包和端口,而不是仅凭当前 ONLINE 状态说网络没问题;计数是本地视角,须与其他成员比较。
62. 观察共识流程是否反复进入扩展轮次
持续增长可能表示成员对提案响应慢或网络有问题。与第 61 条怀疑次数和组通信延迟一起看;单次非零值只是历史累计,不是此刻故障。该类状态值在成员重启或重新入组后会重置。
63. 看共识提案的平均耗时有没有上升
time_sum 是累计耗时,不能直接拿总时间除以一次采样的提案数。两次采样都没有重置时,用耗时增量除以提案增量,才能看近期共识耗时是否上升;组中没有提案时不要硬算平均值。
64. 核对最后一次共识完成时间
这个时间长时间不变,结合业务事务是否真的进入组、队列是否增长判断。空闲组没有新提案时不变化也正常;若业务持续写入而认证队列和时间都停住,才值得转查通信和多数派。
65. 检查组通信是否还在使用同一协议栈
XCom 走成员通信地址与 IP allowlist;MYSQL 栈走服务器监听与成员认证。协议栈配置不一致时,新成员可能连不上种子;当前组仍在线,也不代表下一次重入不会失败。
使用 XCom 时,其他成员要允许这台成员的组通信地址。若现场用 MYSQL 通信栈,此允许列表不参与成员认证;要改查成员账号与 TLS。不能把 SQL 客户端白名单和组通信白名单当成一回事。
67. 查看成员有没有留下强制成员列表配置
force_members 是丢失多数派时人工强制重建组视图的特殊入口,不应作为日常修复手段。若非空,先查此前操作记录和各节点组视图;在网络分区未查清前随意强制成员列表,可能造出另一份不一致的组。
68. 从故障成员本机看组视图
这里读到的是当前节点的视图。网络分区时,不同节点可能给同一成员标出不同状态;把各节点结果放在一起,才能判断是成员真正停机,还是组通信被隔断。UNREACHABLE 只说明当前节点联系不到它,不能据此直接认定它已停机。
69. 对照各节点看到的在线人数
三节点组只有一名成员可通信时,原视图已失去多数派,事务提交会停住。这个统计仍需和其他节点的视图、主机状态一起看。计划内逐个退出的成员与突发失联,组视图的变化也不一样。
70. 核对失联节点是否仍在对外服务
能连接 SQL 端口,不等于还属于原组。特别是 Router 或业务直连失联节点时,要确认它是否处于超级只读或离线状态。准备人工重建组前,所有将被排除的节点必须确认停机,不能只凭客户端连接失败判断。
71. 记录失去多数派后的事务等待设置
unreachable_majority_timeout=0 时,少数派上的提交可能一直等待。事后再修改超时值,不能解除已经发生的多数派丢失;先查故障原因与节点去向,再选恢复路径。
72. 查看失联节点的组通信地址
组通信地址和客户端 SQL 地址不一定相同。XCom 网络分区排查要核对这里的地址、端口和允许列表;MYSQL 通信栈还要核对服务器监听和成员认证。人工 force_members 所需的是组通信地址,不能拿业务连接地址代替。
73. 在主机上核实 MySQL 是否真的停止
这是“排除成员前”的物理确认,不是组内状态检查。若机器失联,不能因为 systemctl 无法执行就写成“已停机”;需要由主机、网络或存储负责人确认隔离,保留证据。Oracle 官方文档明确提醒:被排除的成员若实际形成另一份多数派,强制新视图会造成人工脑裂。
74. 比对故障前后各节点已执行的 GTID
单主模式分区时,原主可能有其他节点尚未拿到的事务。若打算把原主排除,先比 GTID;它带着新组没有的事务回来时会被拒绝。GTID 只能说明事务集合,仍需结合应用队列与业务写入记录判断。
75. 查看应用通道已认证但尚未执行的事务集合
全组重启选引导节点时,不能只比较 gtid_executed。Group Replication 还可能有已经认证、尚未应用的事务,官方重启步骤要求把这部分一并比较。原主或最后关机的节点,都不一定是事务最完整的节点。
十、全组停机后的恢复
76. 全组重启前阻止成员自行建组
全组停机后的恢复不是单节点重入。比较事务集合期间,先在各节点的配置文件把 group_replication_start_on_boot 设为 OFF,确保 MySQL 启动后不会抢先加入组;任何节点都不能预先把 bootstrap_group=ON 写进配置文件。实际修改配置和启停 MySQL 要按现场维护流程进行。
77. 全组停机后确认成员处于 OFFLINE
组复制插件已安装但未运行时,本地成员状态应为 OFFLINE。若仍见 ONLINE 或 RECOVERING,不要开始比较事务集合;先按维护方案停止组复制并确认停止。全组恢复期间还要隔离业务写入,避免 GTID 集合边查边变化。
78. 分别收集成员的已执行与已认证事务
这是第 74、75 条在全组重启时的联合留存。选引导节点看的是两份事务集合的并集,不是仅看已执行 GTID。若某成员查不到应用通道记录,不能把空结果当作零事务;先查插件、通道状态和日志。
79. 找出已认证但未计入已执行的事务
这部分事务已经认证,尚未列入 gtid_executed。比较成员完整事务集合时,要把它和已执行 GTID 一起算进去。若应用通道没有返回记录,先查状态和日志,不能直接把它判成空集合。
80. 比较两台成员谁缺少事务
只要 only_on_a 与 only_on_b 同时非空,两台成员就不是简单的“谁更新”。这通常提示额外事务、分叉或数据来源异常,需要先查原因。选引导节点应找事务集合覆盖其他所有成员的节点;不能凭 GTID 数量或节点角色排序。
81. 只在选定成员上引导全组
这是全组重启的关键步骤,三句要连续执行并检查每句返回。引导开关只应临时打开一次,绝不能留在 my.cnf 中。若中途失败,先把开关复位,查错误日志、事务集合和当前组视图;不要换台节点再盲目重试。
82. 引导后确认组里只有创始成员
引导成功后应先看到单成员组,并确认该节点角色和状态。若出现另一名成员,先查它是否自动启动或已加入,暂缓后续节点回归。SQL 返回成功也不能代替组视图核对。
83. 在待回归成员检查引导开关已关闭
回归成员不能再次引导同名组。bootstrap_group 必须为 OFF;如果 start_on_boot 已打开,先查它是否在比较事务集合期间自行启动过组复制。只有创始成员的组视图确认无误,才让其他成员逐台加入。
84. 核对回归成员仍指向原组及正确的种子
这几个值在重启期间被改错,成员可能连不上创始成员,或误进另一组。尤其注意 XCom 组通信端口与 SQL 客户端端口的区别。若创始成员地址变过,先按官方配置步骤修正,再启动回归成员。
85. 逐台启动其余成员的组复制
先等这台成员进入 ONLINE,再处理下一台。加入过程中可能走分布式恢复或 Clone;START 返回不代表数据已经追平。若成员带有创始组没有的额外事务,不能删 GTID 硬塞回组,先核对分叉和恢复方案。
86. 在创始成员核对回归节点入组结果
目标应逐台变为 ONLINE,单主组始终只有一名 PRIMARY。若成员长时间留在 RECOVERING,回头查它的恢复通道和错误日志。这里只证明组视图,业务入口与读写路由仍要另查。
87. 计算回归成员与创始成员还差多少 GTID
ONLINE 之后仍需看是否追上业务需要的事务点。结果为空说明这两个已执行集合在该方向上无缺口,但不能单凭它证明 Router 路由、写入权限或应用一致性。若有额外事务,还要做反向差集核对。
88. 各成员确认没有留下再次引导的配置
bootstrap_group 应为 OFF,没有人工重建组视图时 force_members 应为空。运行时读数还要与配置文件核对:bootstrap_group=ON 留在配置文件里,下次重启可能形成另一份同名组。
89. 确认全组回归后自动重入策略已恢复
全组重启期间临时关闭了 start_on_boot,恢复后要按现场原策略重新设置;官方文档允许恢复为 ON。这项只影响下次服务启动,不是本次成员是否已追平的证据。别忘了核对配置文件,否则运行时和下一次启动行为可能不同。
90. 从业务入口核对实际连接落点
全组视图恢复后,还要从业务所用入口连一次。写入口应落到新主,读入口落到允许服务的在线成员;这条只检查连接落点,不替代业务读写验收。若代理仍指向故障前的主节点,先修正路由,再宣告恢复。
十一、认证开销与组通信读数
91. 看本地事务被组认证回滚了多少
单主组也可能因认证或事务来源问题出现本地回滚。这里的累计数不能直接当错误率;要看同一节点、同一组视图中两次采样的增量,并对照应用收到的具体失败信息。频繁增加时,先查热点行、长事务和客户端重试。
92. 看认证数据库是否持续膨胀
rows_validating 是仍留在冲突检测结构里的行数,不是表的实际行数。若认证队列已降下来但它仍持续攀升,再查认证垃圾回收和事务负载;不要把它误读成业务表膨胀。
93. 检查组复制内存仪表是否开启
下一条内存统计依赖这些仪表。若 enabled=NO,不能把空结果解释为组复制没有内存开销。需要长期观测时,再按现场监控策略启用相应仪表。
94. 统计组复制当前及历史峰值内存
这只统计 Group Replication 仪表记录的内存,不是 mysqld 进程的总 RSS。大事务、消息缓存和认证数据都可能推高峰值;如果进程内存上升而这里没有变化,要检查仪表是否开启并结合操作系统读数。
95. 找出占内存最多的组复制事件
总量高只是现象。这张表能进一步区分认证结构、事务传输和消息缓存的开销。若相应仪表没启用,排序结果会缺项;先确认第 93 条,再结合当时的事务队列和网络负载判断。
96. 看认证垃圾回收有没有变慢
耗时累计值的单位是微秒。看单次平均耗时要用同一节点两次采样的增量相除;只有总耗时涨了、而执行次数也涨了,并不能说明回收变慢。与第 92 条认证结构的行数一起看更有意义。
97. 对照组通信控制消息的往返时间
往返耗时统计同样以微秒累计。某节点的平均耗时突然升高,结合成员失联怀疑和网络读数,才能判断是通信慢还是业务事务大。不同节点重启或重新入组后计数可能重置,不能直接比较绝对值。
98. 对照事务数据消息的往返时间和大小
同一时间窗的消息数、字节数和往返耗时放在一起看。消息变大而往返时间同步升高,先查大事务和网络带宽;消息大小没变而耗时飙升,再查组通信、主机调度和成员状态。累计计数并不等于瞬时吞吐。
99. 检查强一致事务是否在等其他成员
这些计数说明二级成员上的事务因为 AFTER 或 BEFORE_AND_AFTER 一致性保证而等待。事务延迟不一定是认证冲突:先核对第 50 条当前级别,再比较两次采样的等待次数与总耗时。如果级别不同,不能把这组读数直接当成整个组的事务延迟。
100. 核对运行中的组通信协议版本
这里返回的是当前组协议支持的最低 MySQL 版本,不一定等于本机版本。混合版本升级后,要确认协议是否仍停留在旧级别;消息分片等能力取决于组协议,不只取决于新节点安装的版本。未加入组时函数可能返回错误字符串,不能把它当作正常协议版本。
总结
组复制故障先看每台机器自己的成员视图,别只在一台上看到 ONLINE 就以为全组一致。写入卡住,沿认证、组通信和远端应用往下查;遇到全组停机,先比较已执行和已认证的事务,再决定由谁引导。恢复完成还得从业务入口确认主节点,避免组里恢复了,连接仍落在旧地址上。
这类场景命令会继续整理到 ORA100 · DBA100 :
https://ora100.com/dba100
微信里搜索小程序 「三笠的百令册」 ,值班时可以直接按场景查。