performance30 分钟阅读
MySQL 主从复制延迟与故障排查 100 条命令
MySQL 主从复制把源库提交的事务写进 binlog,副本接收后落到 relay log,再由应用线程执行。业务说“副本落后了”,先别急着调并行度:源库有没有写出日志、接收线程是否连着源库、应用线程是否卡在某个事务,问题可能落在不同位置。
2026年9月16日阅读—点赞—收藏—
dba100mysqlscenario
100 条命令系列文章专栏
MySQL 主从复制把源库提交的事务写进 binlog,副本接收后落到 relay log,再由应用线程执行。业务说“副本落后了”,先别急着调并行度:源库有没有写出日志、接收线程是否连着源库、应用线程是否卡在某个事务,问题可能落在不同位置。
MySQL 主从复制把源库提交的事务写进 binlog,副本接收后落到 relay log,再由应用线程执行。业务说“副本落后了”,先别急着调并行度:源库有没有写出日志、接收线程是否连着源库、应用线程是否卡在某个事务,问题可能落在不同位置。
这篇按接收、应用和 GTID 三条线整理常用检查。尤其要记住:Seconds_Behind_Source 显示 0,也不能单独证明副本已经追平源库。需要定位故障时,把线程状态与 GTID 差集对起来看。建议先收藏,值班时顺着链路查更方便。
示例采用 Linux、MySQL 8.4 LTS、InnoDB 异步 GTID 复制。SQL 默认在副本运行,源库命令会注明;通道、实例和账号按现场替换。改变复制配置、跳过事务及故障切换的操作会放在诊断命令之后,并标明前提。
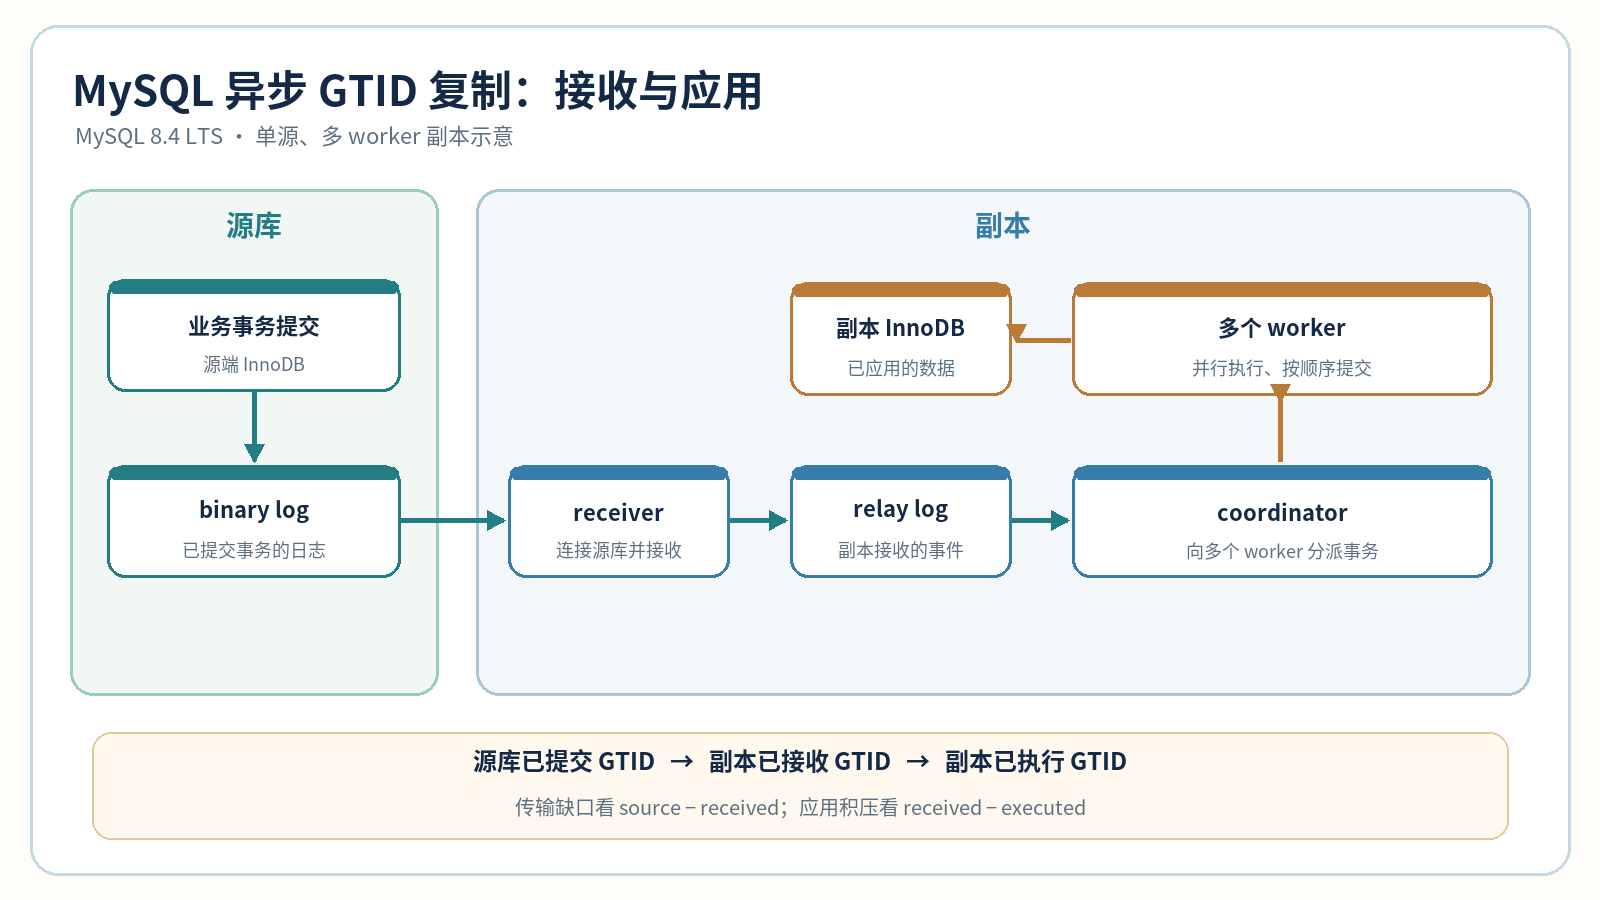 MySQL 异步 GTID 复制接收与应用路径
图里是多 worker 副本:源库提交后写 binlog,副本 receiver 收进 relay log,再由 coordinator 分给 worker 应用。已接收与已执行是两件事;单线程副本没有图中的 coordinator 记录。
1SELECT @@version, @@server_id, @@server_uuid, @@hostname;先确认连到的到底是哪个实例。故障切换或网络重连后,客户端连接串没变,不代表背后还连着原来的副本;server_uuid 比一个可重复使用的主机名更适合核对实例身份。
1SHOW REPLICA STATUS\G重点看 Source_Host、Replica_IO_Running、Replica_SQL_Running、错误信息和 GTID 集合。多源复制会返回多行,要先找到业务使用的通道;Seconds_Behind_Source 只是应用线程与接收线程之间的近似时间差,网络慢时可能显示 0。
1SHOW REPLICA STATUS FOR CHANNEL 'sales_channel'\G多源副本不要拿另一条正常通道的延迟判断业务库已追平。通道名先从第 2 条查到,FOR CHANNEL 的结果仍需结合接收和 worker 表检查。
1-- 在源库执行2SHOW BINARY LOG STATUS\G记录源库当前 File、Position 和 Executed_Gtid_Set。这是一瞬间的快照,源库仍在写入时位点会继续前进;做追平判断要同时保存副本快照,不能拿不同时间的两组值硬比。
1-- 在源库执行2SHOW REPLICAS;这只列出当前或曾连接并注册的副本,不是完整的业务拓扑清单。某个副本缺席时,先查它的接收线程与源端网络、权限,不要立即认定实例已经下线。
1SELECT channel_name, source_uuid, service_state,2 received_transaction_set3FROM performance_schema.replication_connection_status;SERVICE_STATE 可以是 ON、OFF 或 CONNECTING。收到的 GTID 集说明 receiver 已将事务接收进来,并不说明 worker 已提交这些事务;接收集合增长而应用集合不动,问题多半在后半段。
1SELECT channel_name, last_error_number,2 last_error_message, last_error_timestamp3FROM performance_schema.replication_connection_status4WHERE last_error_number <> 0;先读错误码和时间,再查副本错误日志。这里记的是最近一次导致接收线程停止的错误;没查到记录,不代表当前网络没有抖动,还要看线程状态和重连过程。
1SELECT channel_name, service_state,2 remaining_delay, count_transactions_retries3FROM performance_schema.replication_applier_status;REMAINING_DELAY 只在配置了延迟复制且正在等待目标延迟时有值,不能把 NULL 解读成“零延迟”。重试次数上涨时,再去查哪个 worker 遇到瞬时错误。
1SELECT channel_name, worker_id, service_state,2 last_error_number, last_error_message,3 last_error_timestamp4FROM performance_schema.replication_applier_status_by_worker5WHERE last_error_number <> 0;多线程复制里,一个 worker 因主键冲突或缺表停下,汇总状态未必说清是哪条事务。这里的错误可以对到副本错误日志;先核对事务和业务数据,别用跳过 GTID 的办法掩盖数据差异。
1SELECT @@GLOBAL.gtid_executed AS executed_gtids,2 @@GLOBAL.gtid_purged AS purged_gtids;gtid_executed 包含副本已经执行或被登记为已执行的事务;gtid_purged 是其中已不在当前 binlog 里的部分。它们不能单独说明源库还有多少事务未送达,下一步要对照源库的 GTID 集和接收线程状态。
1-- 源库;与副本取样时间尽量靠近2SELECT @@GLOBAL.gtid_executed AS source_executed_gtids;复制追平要知道源库已经提交了哪些事务。源库持续写入时 GTID 集会变化,先记下取样时间;后面第 12、13 条使用同一份快照,别每算一次又换源端集合。
1-- 副本;先将第 11 条真实结果复制到 @source_gtids2SET @source_gtids = '3E11FA47-71CA-11E1-9E33-C80AA9429562:1-57';3SELECT channel_name,4 GTID_SUBTRACT(@source_gtids, received_transaction_set)5 AS not_received_gtids6FROM performance_schema.replication_connection_status7WHERE channel_name = 'sales_channel';代码里的 UUID 和序号只是手册格式示例,必须替换为现场源库快照。差集不空时先查 receiver 连接、源库 binlog 保留范围和网络;不要把这批未收到的 GTID 算到 worker 头上。
1SELECT channel_name,2 GTID_SUBTRACT(received_transaction_set,3 @@GLOBAL.gtid_executed) AS pending_apply_gtids4FROM performance_schema.replication_connection_status5WHERE channel_name = 'sales_channel';这个差集指向 relay log 后半段积压。副本还有本地事务或其他复制通道时,gtid_executed 是实例级集合,不能把差集简单理解为某个 worker 的专属队列;先结合 worker 和 coordinator 状态看。
1SELECT @@GLOBAL.replica_parallel_workers AS workers,2 @@GLOBAL.replica_parallel_type AS parallel_type,3 @@GLOBAL.replica_preserve_commit_order AS preserve_order;MySQL 8.4 默认启用多 worker,并保持提交顺序。配置是背景信息,不是调高 worker 就一定能消除延迟;一个大事务、锁等待或源端连续提交的依赖事务,仍可能限制并行应用。
1SELECT channel_name, service_state,2 last_error_number, last_error_message,3 processing_transaction4FROM performance_schema.replication_applier_status_by_coordinator;单线程副本在这张表里没有记录;多线程副本则由 coordinator 分派事务。它报错时不要只读 SHOW REPLICA STATUS 的汇总文本,还要看第 9 条的各 worker 错误。
1SELECT channel_name, worker_id, service_state,2 last_applied_transaction,3 last_applied_transaction_original_commit_timestamp4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6ORDER BY worker_id;各 worker 的“最近提交”可能不同。不要挑 GTID 数字最大的那个就宣布全通道追平;看接收集合与已执行集合的差集,再对停住或报错的 worker 查事务详情。
1SHOW FULL PROCESSLIST;找到 receiver、coordinator 和 worker 的线程状态,区分源库断连、relay log 等待与事务应用。这个快照只说明当前瞬间;碰到持续延迟,间隔取几次并结合错误日志,才能判断它是否一直卡在同一个动作。
1SELECT channel_name, host, port, user,2 auto_position, ssl_allowed, gtid_only3FROM performance_schema.replication_connection_configuration4WHERE channel_name = 'sales_channel';切换过源库后,先核对 HOST、PORT 与预期拓扑,别只凭通道名认源库。AUTO_POSITION=1 表示使用 GTID 自动定位;SSL_ALLOWED 是配置值,还要查看连接实际使用的 TLS 方式。
1SELECT channel_name, service_state,2 last_heartbeat_timestamp, count_received_heartbeats3FROM performance_schema.replication_connection_status4WHERE channel_name = 'sales_channel';接收线程连着源库但长时间没看到新事务时,心跳能提供另一条链路线索。心跳时间不动先看连接状态和源端网络;收到心跳也不能证明所有业务事务已应用。
1-- 源库;检查副本需要的日志是否仍在列表里2SHOW BINARY LOGS;Log_name、File_size 是源端当前保留文件的清单。副本断连太久而源库已清掉所需日志时,只把接收线程重新启动,无法凭空补回缺失事件;要先核对 GTID 缺口和备份重建方案。
1-- 源库2SELECT @@GLOBAL.binlog_expire_logs_seconds AS expire_seconds,3 @@GLOBAL.binlog_expire_logs_auto_purge AS auto_purge;过期秒数是清理策略,不能直接推出某个文件此刻还在。MySQL 可以在启动或 flush binlog 时自动清理已到期文件;副本停机时间超过保留窗口前,要确认实际日志清单和是否有独立备份。
1SELECT channel_name, worker_id, service_state,2 applying_transaction,3 applying_transaction_start_apply_timestamp4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6ORDER BY worker_id;同一个 worker 的 APPLYING_TRANSACTION 连续几次快照都不变时,再看它当前线程的等待与错误。事务大、锁冲突和提交顺序等待会呈现不同状态,不能只凭“GTID 没变”定性。
1SELECT channel_name, worker_id,2 applying_transaction_retries_count,3 applying_transaction_last_transient_error_number,4 applying_transaction_last_transient_error_message5FROM performance_schema.replication_applier_status_by_worker6WHERE channel_name = 'sales_channel'7AND applying_transaction_retries_count > 0;死锁或锁等待超时可能触发重试,重试并不一定已经让通道停止。若计数持续上涨,先定位对应业务事务和锁关系;重试耗尽后要从第 9 条的停止错误看最终原因。
1SELECT @@GLOBAL.log_error AS error_log_path;SHOW REPLICA STATUS 的错误文本通常还需要错误日志上下文,尤其是 worker 多、错误反复出现的时候。这里给出服务器配置的日志位置;容器或托管环境可能把日志输出到别的收集端,要按实际部署读取。
1-- 在源库运行,把副本当前 @@GLOBAL.gtid_executed 原样填入2SELECT GTID_SUBTRACT(@@GLOBAL.gtid_purged,3 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-1200')4 AS purged_but_missing_on_replica;结果非空表示源库已经清掉了副本仍缺的事务;自动定位再连接时不能从现有 binlog 补回这段。先核对备份、其他副本和源端日志保留情况,不能靠 RESET REPLICA 或强行改 gtid_purged 把数据缺口抹掉。
1-- 在副本运行,把源库同一时刻的 @@GLOBAL.gtid_executed 填入2SELECT GTID_SUBSET(3 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-1200',4 @@GLOBAL.gtid_executed) AS source_set_applied;返回 1 表示给定源库快照中的 GTID 均已执行;返回 0 时继续看第 12、13 条的接收和应用缺口。这个结论只覆盖取快照的时点,源库若还在写入,就不能据此宣称切换时没有数据差异。
1SELECT w.channel_name, w.worker_id, w.thread_id,2 t.name AS thread_name, t.processlist_state3FROM performance_schema.replication_applier_status_by_worker AS w4LEFT JOIN performance_schema.threads AS t5 ON t.thread_id = w.thread_id6WHERE w.channel_name = 'sales_channel'7ORDER BY w.worker_id;第 22 条找到停滞的 worker 后,用 THREAD_ID 查它的线程状态。复制 worker 是后台线程,PROCESSLIST_ID 可能为空;不要用客户端连接 ID 去硬配。通道停止后 THREAD_ID 也会变成 NULL。
1SELECT w.channel_name, w.worker_id, w.applying_transaction,2 e.event_name, e.timer_wait3FROM performance_schema.replication_applier_status_by_worker AS w4JOIN performance_schema.events_waits_current AS e5 ON e.thread_id = w.thread_id6WHERE w.channel_name = 'sales_channel'7AND e.end_event_id IS NULL8ORDER BY w.worker_id;END_EVENT_ID IS NULL 排除了已经结束的最近一次等待。这仍是一张瞬时快照;某个 worker 查不到行,可能只是当时没有被记录的等待,不能认定它没有阻塞。连续取样并结合第 23 条的重试错误、业务锁关系再判断。TIMER_WAIT 单位为皮秒,未启用计时的事件可能为 NULL。
1SELECT channel_name, desired_delay2FROM performance_schema.replication_applier_configuration3WHERE channel_name = 'sales_channel';DESIRED_DELAY 是源端提交后副本至少要等的秒数。设置了延迟副本时,Seconds_Behind_Source 高于 0 不一定是应用故障;先拿它和设计的延迟目标对比。
1SELECT channel_name, service_state,2 remaining_delay, count_transactions_retries3FROM performance_schema.replication_applier_status4WHERE channel_name = 'sales_channel';等待计划延迟结束时 REMAINING_DELAY 才有值,其他时间为 NULL。不要把 NULL 解释成一定已追平;还需看接收/执行 GTID 集合及 worker 状态。
1SELECT channel_name, filter_name, filter_rule,2 configured_by, active_since3FROM performance_schema.replication_applier_filters4WHERE channel_name = 'sales_channel'5ORDER BY filter_name;某张表没有同步,不一定是线程停了。先确认是否被通道过滤;FILTER_RULE 要和具体库表名对上,规则为空并不说明全局过滤也为空。
1SELECT filter_name, filter_rule, configured_by,2 active_since3FROM performance_schema.replication_applier_global_filters4ORDER BY filter_name;全局规则会影响通道之外的复制应用范围。检查数据差异时,把通道专属规则和全局规则一起保存;只看 SHOW REPLICA STATUS 的运行状态无法证明这张表本来就应该同步。
1SELECT channel_name, connection_retry_interval,2 connection_retry_count, heartbeat_interval3FROM performance_schema.replication_connection_configuration4WHERE channel_name = 'sales_channel';重试间隔和次数决定断连后 receiver 多久再试、何时放弃;心跳间隔则影响“源端暂时没新事务”时的链路观察。它们是配置,不是当前断连次数,当前错误仍查接收状态。
1SELECT channel_name, ssl_allowed,2 ssl_verify_server_certificate, tls_version,3 ssl_ca_file4FROM performance_schema.replication_connection_configuration5WHERE channel_name = 'sales_channel';SSL_ALLOWED 说明是否允许加密,TLS_VERSION 是允许的版本清单,都不能直接证明现在这条 receiver 连接确实使用了哪套 cipher。证书变更后断连,要结合接收错误和源端安全配置排查。
1SELECT @@GLOBAL.relay_log_purge AS auto_purge,2 @@GLOBAL.relay_log_recovery AS recovery_on_restart;relay_log_purge 控制已不需要的 relay log 是否自动清理;relay_log_recovery 影响副本重启时的 relay log 恢复路径。不要为“保留线索”临时关清理、让磁盘填满;配置变更应有明确目的和回退。
1SELECT @@GLOBAL.gtid_mode AS gtid_mode,2 @@GLOBAL.enforce_gtid_consistency AS consistency,3 @@GLOBAL.log_replica_updates AS log_replica_updates;副本还要给下游供数据时,自己的 binlog 更新策略很关键。log_replica_updates 打开不代表链路完整;有过滤、跳过事务或缺失 GTID 时,下游仍可能出现空洞。
1SELECT @@GLOBAL.server_id AS server_id,2 @@GLOBAL.server_uuid AS server_uuid;复制拓扑内身份冲突会造成连接和事件处理异常。server_id 用于传统复制身份,server_uuid 参与 GTID 标识;重建副本时不能把旧实例的数据目录直接复制后不检查 UUID。
1SELECT @@GLOBAL.read_only AS read_only,2 @@GLOBAL.super_read_only AS super_read_only;副本被应用或运维脚本误写,会让数据核对更难。两个值都要查:read_only 只限制普通权限账号,super_read_only 进一步限制高权限写入;它们也不能阻止复制线程正常应用。
1-- 源库;用于理解 relay event 内容与下游审计能力2SELECT @@GLOBAL.binlog_format AS binlog_format,3 @@GLOBAL.binlog_row_image AS row_image;MySQL 8.4 的复制诊断主要围绕 row event。ROW_IMAGE=MINIMAL 会减少事件内容,拿 binlog 做逐字段取证时要知道它不一定含更新前后的全行;不能只因文件小就认为日志信息够用。
1SELECT @@GLOBAL.replica_transaction_retries AS retry_limit;第 23 条看具体 worker 的瞬时重试,这里看同一事务最多允许自动重试多少次。锁冲突长期未消失时,提高上限可能只是让通道更晚报错,先找占锁事务和应用顺序。
1SELECT @@GLOBAL.rpl_stop_replica_timeout AS stop_timeout_seconds;STOP REPLICA 客户端等到超时报错时,停止动作仍可能继续执行。不能只看客户端的返回值,必须再查通道状态。改这个超时也不能解决 worker 卡住的原因。
1-- 副本;接收新事务会暂停,应用线程可继续处理已有 relay log2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';用于源库连接维护或需要暂时截住新日志的窗口。多通道实例务必写 FOR CHANNEL;省略它可能影响所有通道。执行前留存位点和通道状态。
1SELECT channel_name, service_state,2 last_error_number, last_error_message3FROM performance_schema.replication_connection_status4WHERE channel_name = 'sales_channel';正常停止应看到 SERVICE_STATE=OFF。若 STOP REPLICA 返回超时,更需要这条回读;错误号、错误内容也一并留存,免得把原有连接故障误算成维护结果。
1-- 副本;恢复从源库读取 binlog2START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';命令成功只表示线程启动请求已被接受,源库连接可能还未建立。不要立刻宣布复制恢复,接着看接收状态和日志是否继续前进。
1SHOW REPLICA STATUS FOR CHANNEL 'sales_channel';重点对照 Replica_IO_Running、Last_IO_Error、Source_Host 和 Retrieved_Gtid_Set。Replica_IO_Running=Yes 才表示线程运行且已连接;连续取两次 GTID 快照更容易确认确实又收到事务。
1-- 副本;relay log 可继续接收,但不再应用到数据表2STOP REPLICA SQL_THREAD FOR CHANNEL 'sales_channel';适用于应用故障取证或受控维护。此时源库写入照常,relay log 会积压;先确认磁盘余量、业务对副本数据时效的要求。并行副本停止 worker 时还可能需要收拢事务间隙。
1SELECT channel_name, service_state,2 remaining_delay, count_transactions_retries3FROM performance_schema.replication_applier_status4WHERE channel_name = 'sales_channel';SERVICE_STATE=OFF 才算真正停下。第 30 条用于判断故意延迟,这里是维护动作回读;两次查询的目的不同,不要把暂时停止应用当成延迟副本的设计值。
1-- 副本;开始执行 relay log 中积压的事务2START REPLICA SQL_THREAD FOR CHANNEL 'sales_channel';线程启动后可能马上碰到旧错误又停下。尤其是唯一键冲突、缺表或磁盘满,要先处理根因,不能靠反复 START REPLICA 掩盖问题。
1SELECT channel_name, worker_id, service_state,2 last_applied_transaction, last_applied_transaction_end_apply_timestamp,3 last_error_number, last_error_message4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6ORDER BY worker_id;取两次快照,对比 LAST_APPLIED_TRANSACTION 是否推进,并检查有没有新的 worker 错误。源库暂时没新事务时 GTID 不变化也正常,仍要核对接收、应用线程状态。
1-- 在执行停启命令的会话中,操作前先检查2SELECT t.processlist_id, x.state, x.gtid3FROM performance_schema.threads AS t4JOIN performance_schema.events_transactions_current AS x5 ON x.thread_id = t.thread_id6WHERE t.processlist_id = CONNECTION_ID()7 AND x.state = 'ACTIVE';START REPLICA 和 STOP REPLICA 会隐式提交当前会话尚未提交的事务。若查到 ACTIVE 行,不要在这个会话直接运行停启命令;先处理原事务,或者换独立管理会话。该查询依赖 Performance Schema 的事务采集,查不到行时不能单靠它证明会话一定没有事务。
1SELECT @@GLOBAL.relay_log_basename AS relay_log_basename;这条查 relay log 实际落在哪个目录。文件名和位点仍从第 2/3 条的复制状态读取:Relay_Log_File、Relay_Log_Pos 属于副本,Source_Log_File、Exec_Source_Log_Pos 属于源端,不能交叉使用。
1-- 副本;文件名和位置取自第 51 条,只取有限行2SHOW RELAYLOG EVENTS IN 'replica-relay-bin.000123'3FROM 456789 LIMIT 20 FOR CHANNEL 'sales_channel';先看 Event_type、Server_id 和 Info 是否对应报错事务。没有 LIMIT 可能返回整份日志,线上排障不要这么做。它也不是完整的逐事件解码工具,取证要再用 mysqlbinlog。
1# 副本主机;文件、位置先按第 51 条核实,仅读取不回放2mysqlbinlog --start-position=456789 --base64-output=DECODE-ROWS -vv \3 /var/lib/mysql/replica-relay-bin.000123 | lessDECODE-ROWS -vv 便于阅读行变化,但展示的是解码结果,不是源库当时提交的原始 SQL;列通常显示为 @1、@2。不要把这份输出直接送进 mysql 执行。
1-- 源库;文件名和位置来自复制状态中的源端字段2SHOW BINLOG EVENTS IN 'mysql-bin.000456' FROM 123456 LIMIT 20;源端事件和 relay event 可用 GTID、Server_id、位点串起来看;但 End_log_pos 在 relay log 显示的是源端 binlog 的结束位点,不能直接拿它当副本 relay 文件位置。
1# 源库主机;位置窗口尽量缩小,输出供取证,不用于回放2mysqlbinlog --start-position=123456 --stop-position=234567 \3 --base64-output=DECODE-ROWS -vv /var/lib/mysql/mysql-bin.000456 | less用于比对源端写入和副本 relay event。截取范围必须包含完整事务才能解释执行先后;随手从某个 row event 中间截断,会丢失事务上下文。日志含业务数据,留存和分享时按现场权限处理。
1SELECT channel_name, worker_id, applying_transaction,2 last_applied_transaction, last_error_number,3 last_error_message4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6 AND last_error_number <> 0;若 APPLYING_TRANSACTION 不为空,先拿这个 GTID 找源端和 relay log。若为空,再看 LAST_APPLIED_TRANSACTION 与错误消息;它不保证报错事务就是最近成功提交的那个。
1SELECT channel_name, service_state,2 processing_transaction, last_error_number,3 last_error_message4FROM performance_schema.replication_applier_status_by_coordinator5WHERE channel_name = 'sales_channel';并行应用时 coordinator 负责把事务分给 worker。它自己报错和 worker 执行时报错是两类问题;单线程副本这张表为空,不能把“无行”当成“无错误”。
1SELECT channel_name,2 COUNT(*) AS worker_count,3 SUM(last_error_number <> 0) AS workers_with_error4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6GROUP BY channel_name;多个 worker 同时报错时,不要只修第一条错误就宣布恢复。先记录每个 worker 的错误与 GTID,再判断是不是同一个源端事件造成的连锁反应。单线程模式查不到 worker 行时,应改看通道应用状态和错误日志。
1SELECT channel_name, received_transaction_set,2 last_heartbeat_timestamp, last_error_number3FROM performance_schema.replication_connection_status4WHERE channel_name = 'sales_channel';取两次快照比较 RECEIVED_TRANSACTION_SET。源库没有新提交时它不增长是正常的;此时心跳时间、receiver 连接状态更能说明链路是否仍在工作。
1-- GTID 换成第 56 条定位到的实际事务2SELECT GTID_SUBSET('aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:12345',3 @@GLOBAL.gtid_executed) AS already_executed;结果为 1 表示指定 GTID 已在实例执行集合里,为 0 表示尚未执行。若 worker 报“事务重复”但这里为 0,就不能只按 GTID 重复判断,需继续核对行内容和唯一键;GTID 已执行也不等于目标表数据一定一致。
1SELECT channel_name, host, port, auto_position, gtid_only2FROM performance_schema.replication_connection_configuration3WHERE channel_name = 'sales_channel';AUTO_POSITION=1 才是按 GTID 自动找源端位置;GTID_ONLY=1 又表示通道元数据不持久化文件名和位点。准备换源时先弄清现有模式,不能把源端 binlog 位点和 GTID 模式混写进同一条变更命令。
1-- 将候选源的 @@GLOBAL.gtid_executed 快照替换进第二个参数2SELECT GTID_SUBTRACT(@@GLOBAL.gtid_executed,3 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-20000') AS not_on_candidate;结果非空,说明副本已执行集合中有候选源没有的 GTID。可能是本地写入、其他通道事务,也可能是候选源少了数据;先分清来源,不能仅凭“两个集合不等”直接换源。
1-- 将候选源的完整 gtid_executed 快照换成现场值2SELECT GTID_SUBTRACT(3 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-20000',4 @@GLOBAL.gtid_executed) AS missing_on_replica;非空集合说明副本还欠候选源的事务。还要确认候选源仍保留这些 GTID 所在的 binlog;若已清理,自动定位也补不回来。快照必须在同一切换窗口采集,源端仍在写时两次结果不宜直接比较。
1-- 使用切换窗口从源库取得的真实 GTID 快照;最长等 30 秒2SELECT WAIT_FOR_EXECUTED_GTID_SET(3 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-20000', 30)4 AS wait_result;返回 0 是指定集合已执行,1 是超时;超时不是失败事务的诊断,还需检查线程和错误。这个函数看整个实例的执行集,不能证明特定业务通道的数据逐表一致;它也不会主动启动停掉的复制线程。
1SELECT channel_name, auto_position,2 source_connection_auto_failover,3 connection_retry_interval, connection_retry_count4FROM performance_schema.replication_connection_configuration5WHERE channel_name = 'sales_channel';SOURCE_CONNECTION_AUTO_FAILOVER=1 要配合 GTID 自动定位。它会在现有源的重连尝试耗尽后选备选源;重试参数过大时,故障转移可能来得很晚。读到配置为 1,也不能证明备选源列表正确或可连接。
1SELECT channel_name, host, port, network_namespace,2 weight, managed_name3FROM performance_schema.replication_asynchronous_connection_failover4WHERE channel_name = 'sales_channel'5ORDER BY weight DESC, host, port;权重高的候选源优先尝试,同权重可能随机排序。逐个确认地址、端口、网络命名空间及数据资格;“候选列表非空”不是容灾验收,目标库若缺 GTID 或其 binlog 已清理,连接成功仍可能复制失败。
1SELECT @@GLOBAL.replica_net_timeout AS net_timeout_seconds;副本超过该时间没收到数据或心跳,receiver 会认为连接断了并重试。调整这个值不会自动同步已设置的心跳间隔;若心跳间隔反而更长,源库没新事务时会制造无谓重连。
1SELECT c.channel_name, c.heartbeat_interval,2 @@GLOBAL.replica_net_timeout AS net_timeout_seconds3FROM performance_schema.replication_connection_configuration AS c4WHERE c.channel_name = 'sales_channel';对照心跳与超时即可发现明显不合理的配置。这里是诊断查询,真正修改心跳要走受控的 CHANGE REPLICATION SOURCE TO,并在变更后回读 receiver 状态和源端连接。
1-- 副本;换源前保存当前 GTID/来源/错误信息及回退方案2STOP REPLICA FOR CHANNEL 'sales_channel';这里停的是两类线程,与第 42、46 条单独停 receiver 或 applier 不同。SOURCE_AUTO_POSITION=1 的换源命令要求两类线程都已停止;多通道实例务必限定通道,别让其他业务链路一起停。
1SELECT c.channel_name,2 c.service_state AS receiver_state,3 a.service_state AS applier_state4FROM performance_schema.replication_connection_status AS c5JOIN performance_schema.replication_applier_status AS a6 ON a.channel_name = c.channel_name7WHERE c.channel_name = 'sales_channel';两列都应为 OFF。STOP REPLICA 客户端若超时,操作还可能在后台继续;必须回读状态再变更来源,不能凭返回消息推断线程已经停完。
1-- 副本;仅在候选源 GTID/数据资格/仍保留的 binlog 均已核对后执行2CHANGE REPLICATION SOURCE TO3 SOURCE_HOST = 'mysql-source-new.example.com',4 SOURCE_PORT = 3306,5 SOURCE_AUTO_POSITION = 16FOR CHANNEL 'sales_channel';第 62—63 条的集合对比要先做。命令会更新复制元数据并隐式提交当前会话事务;新源若缺副本还需要的事务,或者这些 binlog 已被清理,GTID 自动定位不会凭空补出数据。未写的账号、TLS 参数一般保留旧值,仍要确认它们适用于新源。
1-- 副本;两类线程一起启动2START REPLICA FOR CHANNEL 'sales_channel';线程启动成功不等于已连上新源,也不等于应用持续正常。后面应核对实际源 UUID、接收 GTID 与 worker 错误;若马上报错,先停下取证,不能反复启动当作修复。
1SELECT channel_name, service_state, source_uuid,2 last_error_number, last_error_message3FROM performance_schema.replication_connection_status4WHERE channel_name = 'sales_channel';配置 HOST 指向新地址只是元数据;SOURCE_UUID 才能帮助确认 receiver 实际连到哪台实例。若仍是 CONNECTING、UUID 为空或持续报错,再查 DNS、端口、TLS 和新源上的复制账号。
1SELECT channel_name, count_received_heartbeats,2 last_heartbeat_timestamp, received_transaction_set3FROM performance_schema.replication_connection_status4WHERE channel_name = 'sales_channel';连续取样。源端无新事务时,接收 GTID 不推进也正常,可以看心跳是否更新;心跳更新仍不能证明此前缺失的业务事务已补齐,切换点 GTID 还需单独验证。
1-- 副本;仅用于已启用或计划启用的异步连接故障转移通道2SELECT asynchronous_connection_failover_add_source(3 'sales_channel', 'mysql-source-b.example.com', 3306, '', 70);最后的 70 是优先权重,范围 1—100。加入列表前要确认该实例与现源共享正确的 GTID 数据、复制账号和 binlog 仍可读;它只是候选地址配置,不会修好数据不一致。
1-- 副本;接收线程必须停止,应用线程可继续处理 relay log2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';3CHANGE REPLICATION SOURCE TO4 SOURCE_CONNECTION_AUTO_FAILOVER = 15FOR CHANNEL 'sales_channel';6START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';必须先使用 GTID 自动定位并有合格备选源。自动换源是在当前来源的重试用尽后尝试列表内候选源;结合第 65 条的重试参数估计切换时机。最后要回读 receiver 实际连接,不能把“自动”理解成自动校验数据一致。
1-- 副本;确认它不是唯一可用的备选源2SELECT asynchronous_connection_failover_delete_source(3 'sales_channel', 'mysql-source-b.example.com', 3306, '');退役或数据落后的实例应及时移出候选列表。执行后用第 66 条确认列表结果,并留存下一台可用候选源;若列表只剩无效地址,通道断连时自动故障转移也救不了。
1-- 副本;在变更方案明确要求固定来源时执行2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';3CHANGE REPLICATION SOURCE TO4 SOURCE_CONNECTION_AUTO_FAILOVER = 05FOR CHANNEL 'sales_channel';6START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';例如切换演练需要避免 receiver 自行跳到其他来源时,可受控关闭。配置改完后回读第 65 条;生产长期关闭时要明确人工故障处理路径,不能仅删候选列表就当作关闭了机制。
1SELECT @@GLOBAL.replica_preserve_commit_order2 AS preserve_commit_order;并行应用未保持提交顺序时,更容易在意外停止后留下事务间隙。它不是“是否有间隙”的直接检测;遇到意外停机或 worker 报错,还要查 GTID、relay log 和第 15/16 条的 coordinator、worker 状态。
1-- 仅针对仍用文件位点的多线程副本;GTID 自动定位通道不照搬2START REPLICA UNTIL SQL_AFTER_MTS_GAPS3FOR CHANNEL 'legacy_channel';这条只执行填平 relay log 事务间隙所需的部分事务。MySQL 8.4 的 GTID 自动定位通道会跳过传统位点的间隙计算,不能拿它当 GTID 修复命令;文件位点模式中,间隙未补完就 RESET REPLICA 会丢失所需日志。
1-- 副本;先停止业务通道 SQL_THREAD,再用真实目标 GTID 替换2START REPLICA SQL_THREAD UNTIL3 SQL_BEFORE_GTIDS = aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:123454FOR CHANNEL 'sales_channel';用于定位可疑事务之前的副本状态。applier 碰到指定集合中的事务就停,不会应用这个 GTID;集合含多个事务时,先碰到哪一个取决于 relay log 顺序,不一定是数字最小的那个。
1-- 副本;真实 GTID 集来自切换窗口的源端快照2START REPLICA SQL_THREAD UNTIL3 SQL_AFTER_GTIDS = aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:1-123454FOR CHANNEL 'sales_channel';用于受控追到一个切换点。指定集合都已处理才停;在它们之间收到的其他事务也可能一并应用,所以不能把它理解为“严格只执行这些 GTID”。完成后记录实际执行集,再决定是否继续正常复制。
1SELECT channel_name, worker_id,2 applying_transaction,3 last_error_number, last_error_message4FROM performance_schema.replication_applier_status_by_worker5WHERE channel_name = 'sales_channel'6 AND last_error_number <> 07ORDER BY worker_id;必须拿真正失败的 APPLYING_TRANSACTION,不能从最近成功提交的事务猜 GTID。先用第 52—55 条看事件内容,再决定能否修数据后重试;跳事务会留下业务数据差异。
1-- 副本;跳事务前先按第 69 条停止该通道2SELECT @@GLOBAL.gtid_owned AS currently_owned_gtids;空事务若要占用的 GTID 仍出现在这里,不能由管理会话抢先写入。先确认是哪条线程持有、报错事务是否真正停止,再执行第 85 条。这个集合只显示正在处理的 GTID,不能代替失败事件取证。
1-- 副本独立管理会话;仅在原事务内容已确认不需要应用时2SET GTID_NEXT = 'aaaaaaaa-bbbb-cccc-dddd-eeeeeeeeeeee:12345';3BEGIN;4COMMIT;5SET GTID_NEXT = 'AUTOMATIC';空事务占用该 GTID,后续 applier 将自动跳过来源相同的事务。事前必须记录原事件、数据差异和补偿方案;若这个副本未来还会成为下游源,空事务也可能进入它的 binlog。别把跳过用作唯一键冲突的默认处理办法。
1-- 在执行第 85 条的同一个管理会话中查询2SELECT @@SESSION.gtid_next AS next_gtid_mode;应返回 AUTOMATIC,否则后续手工事务可能继续试图使用刚才的固定 GTID。第 60 条再核对它是否进入执行集合;两项都正确也不代表业务表已补齐,需要按原事务内容处理差异。
1SELECT channel_name, desired_delay2FROM performance_schema.replication_applier_configuration3WHERE channel_name = 'delay_channel';DESIRED_DELAY 是这条通道配置的秒数,等同于 SHOW REPLICA STATUS 中的 SQL_Delay。故意延迟的副本不能只凭 Seconds_Behind_Source 判为故障,还应查 receiver、applier 及事务提交时间。
1-- 仅在该副本确实承担误操作回退用途时;先停应用线程2STOP REPLICA SQL_THREAD FOR CHANNEL 'delay_channel';3CHANGE REPLICATION SOURCE TO SOURCE_DELAY = 36004FOR CHANNEL 'delay_channel';5START REPLICA SQL_THREAD FOR CHANNEL 'delay_channel';receiver 可以继续收日志,延迟的是 applier。先确认磁盘能容纳新增 relay log,再按第 87 条方式回读延迟状态。改成延迟副本后,它不再适合作为要求最新数据的即时切换目标。
1-- 确认解除延迟的业务影响;先停应用线程2STOP REPLICA SQL_THREAD FOR CHANNEL 'delay_channel';3CHANGE REPLICATION SOURCE TO SOURCE_DELAY = 04FOR CHANNEL 'delay_channel';5START REPLICA SQL_THREAD FOR CHANNEL 'delay_channel';恢复到 0 只改后续应用策略,不保证积压立刻清空。解除前留存可回退的时间点;如果这台副本是误删除兜底,提前解除延迟可能把误删也追上来。
1SELECT channel_name, connection_retry_interval,2 connection_retry_count, heartbeat_interval3FROM performance_schema.replication_connection_configuration4WHERE channel_name = 'sales_channel';重试间隔与次数决定自动换源前可能等待多久。现场先按网络中断时长和故障转移目标估算,不要把重试次数调大就当作提高可用性。
1-- 副本;记录原值,按故障切换要求选择新值2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';3CHANGE REPLICATION SOURCE TO4 SOURCE_CONNECT_RETRY = 5,5 SOURCE_RETRY_COUNT = 126FOR CHANNEL 'sales_channel';7START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';该组合代表每隔 5 秒重试,最多 12 次;它并不等于“60 秒保证完成故障切换”,还受连接超时、DNS、TLS 和候选源状态影响。执行后回读第 90 条并观察实际连接。
1SELECT channel_name, heartbeat_interval,2 @@GLOBAL.replica_net_timeout AS net_timeout_seconds3FROM performance_schema.replication_connection_configuration4WHERE heartbeat_interval >= @@GLOBAL.replica_net_timeout;正常应无结果。它检查的是实例全部通道,适合修改网络超时之后做影响核对;心跳间隔为 0 代表关闭心跳,也要另行排查。
1-- 副本;先确认 replica_net_timeout 大于 15 秒2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';3CHANGE REPLICATION SOURCE TO SOURCE_HEARTBEAT_PERIOD = 154FOR CHANNEL 'sales_channel';5START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';源库长时间没新事务时,心跳能帮助 receiver 判断连接仍存活。设为 0 会关闭心跳,不适合随手用作“减少网络流量”的办法。回读第 90 条再看心跳计数是否继续推进。
1-- 实例级参数,影响该副本的所有复制通道;先评估其他通道2SET GLOBAL replica_net_timeout = 60;改值不会立刻影响正在运行的 receiver,要在下一次 START REPLICA 后生效。心跳间隔也不会随之自动改动;需要持久化时再按 MySQL 参数管理方式处理,不能误以为 SET GLOBAL 会跨重启保存。
1SELECT channel_name, host, ssl_allowed,2 ssl_verify_server_certificate, ssl_ca_file3FROM performance_schema.replication_connection_configuration4WHERE ssl_allowed = 'Yes'5 AND ssl_verify_server_certificate = 0;这些通道允许 TLS,却没有核对源端证书。先按实际证书配置与源地址查清原因,再改校验参数;SSL_ALLOWED=Yes 本身不能证明当前连接确实完成 TLS 握手。
1-- 副本;CA 文件要已存在且由 mysqld 可读,先在新源验证证书2STOP REPLICA IO_THREAD FOR CHANNEL 'sales_channel';3CHANGE REPLICATION SOURCE TO4 SOURCE_SSL = 1,5 SOURCE_SSL_CA = '/etc/mysql/replication-ca.pem',6 SOURCE_SSL_VERIFY_SERVER_CERT = 17FOR CHANNEL 'sales_channel';8START REPLICA IO_THREAD FOR CHANNEL 'sales_channel';修改后看 receiver 是否稳定连接,并在服务端核对实际 TLS 会话。证书校验失败不能临时关闭校验硬闯;先查证书 SAN、CA 和新源地址是否一致。
1SELECT channel_name, service_state, remaining_delay,2 count_transactions_retries3FROM performance_schema.replication_applier_status4WHERE channel_name = 'retired_channel';这条先看应用线程是否仍在运行、是否处于延迟等待,以及失败重试次数。它不能单独证明 relay log 已处理完;还需对照接收集和执行集、worker 错误,以及业务切换记录。未应用事务尚需保留时,不能执行后面的清理。
1-- 仅在重建副本方案已批准、未应用 relay log 已取证后执行2STOP REPLICA FOR CHANNEL 'sales_channel';3RESET REPLICA FOR CHANNEL 'sales_channel';RESET REPLICA 会删除该通道所有 relay log,包含尚未应用的事件,但不会清除 GTID 执行历史,也通常保留连接参数。它用于干净重建,不是解决复制延迟或缺 GTID 的日常修复命令。
1-- 确认下游不用、备份和审计留存完毕2STOP REPLICA FOR CHANNEL 'retired_channel';3RESET REPLICA ALL FOR CHANNEL 'retired_channel';ALL 会连连接配置和这个通道一起删掉,不能拿来“试试能否修好”。多通道实例必须保留 FOR CHANNEL;误删后仅有 GTID 历史,不能还原被删 relay log 与原连接配置。
1SELECT channel_name2FROM performance_schema.replication_connection_configuration3WHERE channel_name = 'retired_channel';应无结果。还要查其他通道是否照常连接和应用,避免操作范围写错。这个查询只能证明配置层已删除,不能证明业务已在新链路上稳定运行。
MySQL GTID 复制排障先确认复制线程和通道,再区分日志没有送达、Relay Log 没有应用,还是事务本身执行缓慢。重建副本、跳过事务和 RESET REPLICA 都会改变复制链路,必须在保留证据和确认 GTID 集合之后执行。
GTID、通道名和复制账号可以提前整理成现场巡检清单。发生延迟或中断时,从源端位点、接收线程和应用线程按顺序检查,通常比直接重启复制更快。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100