performance30 分钟阅读
MySQL 慢 SQL 与执行计划排查 100 条命令
MySQL 慢查询不是只看一条 SQL 跑了几秒。偶发慢、每次都慢、执行次数多导致总耗时高,处理方法不同。先从语句摘要里找到最该查的 SQL,再对照执行计划、扫描行数和实际运行结果,比较容易看出问题在索引、统计信息,还是数据量与写法。
2026年9月16日阅读—点赞—收藏—
dba100mysqlscenario
100 条命令系列文章专栏
MySQL 慢查询不是只看一条 SQL 跑了几秒。偶发慢、每次都慢、执行次数多导致总耗时高,处理方法不同。先从语句摘要里找到最该查的 SQL,再对照执行计划、扫描行数和实际运行结果,比较容易看出问题在索引、统计信息,还是数据量与写法。
MySQL 慢查询不是只看一条 SQL 跑了几秒。偶发慢、每次都慢、执行次数多导致总耗时高,处理方法不同。先从语句摘要里找到最该查的 SQL,再对照执行计划、扫描行数和实际运行结果,比较容易看出问题在索引、统计信息,还是数据量与写法。
这篇先整理日常定位和执行计划的命令。线上出现慢 SQL 时可以按症状翻查;觉得有用,先收藏,排查时也方便转给开发同事。
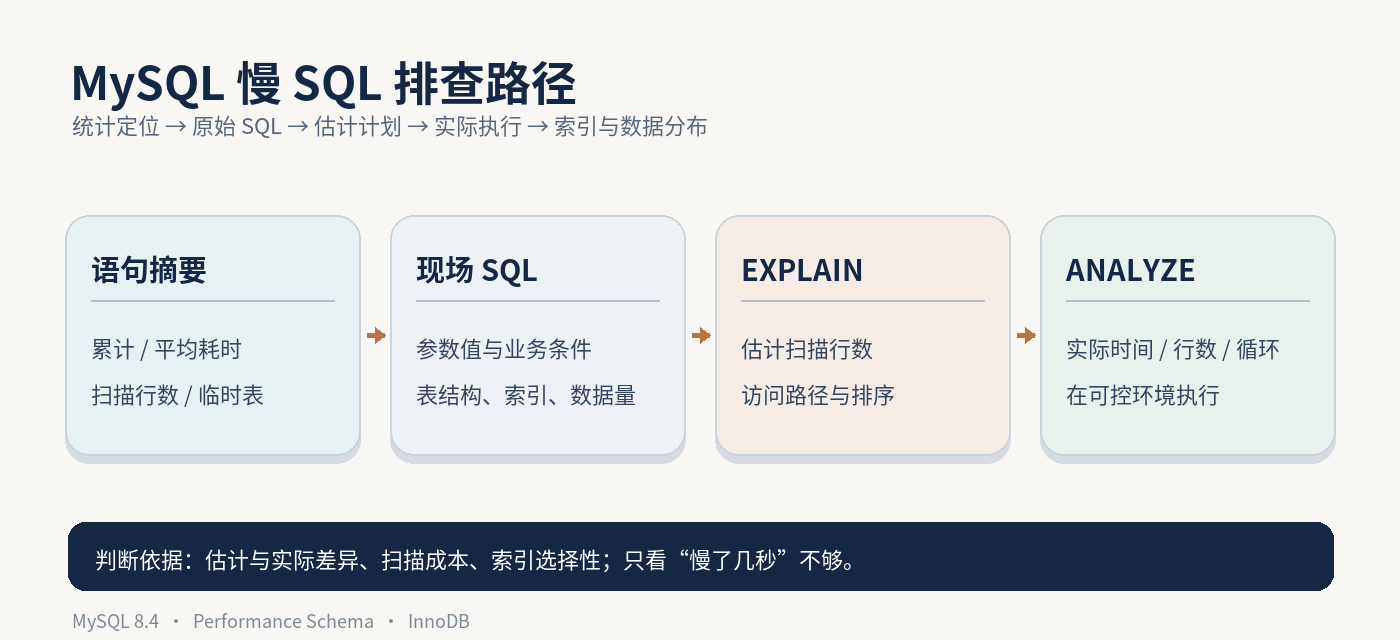 MySQL 慢 SQL 排查路径示意图
示例采用 MySQL 8.4。Performance Schema 的摘要和历史事件受采集开关、表容量影响;EXPLAIN ANALYZE 会实际执行语句,生产环境先确认 SQL 的读写影响。
1SHOW VARIABLES LIKE 'performance_schema';如果是 OFF,后面查语句摘要不会有完整数据;这个开关不是临时执行几条 SQL 就能补回历史记录。
1SELECT NAME, ENABLED2FROM performance_schema.setup_consumers3WHERE NAME IN ('events_statements_current',4 'events_statements_history',5 'events_statements_history_long',6 'statements_digest');摘要要看 statements_digest;历史 SQL 要看相应 history consumer。没开采集时,不要把“查不到”写成“没有慢 SQL”。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 ROUND(SUM_TIMER_WAIT / 1000000000000, 2) AS total_sec,3 ROUND(AVG_TIMER_WAIT / 1000000000000, 3) AS avg_sec,4 FIRST_SEEN, LAST_SEEN5FROM performance_schema.events_statements_summary_by_digest6WHERE DIGEST IS NOT NULL7ORDER BY SUM_TIMER_WAIT DESC8LIMIT 20;SUM_TIMER_WAIT 单位是皮秒。累计耗时高的 SQL 不一定单次最慢,可能只是调用量大;DIGEST_TEXT 是归一化语句,参数值要到应用日志或采样事件里找。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 ROUND(AVG_TIMER_WAIT / 1000000000000, 3) AS avg_sec,3 ROUND(MAX_TIMER_WAIT / 1000000000000, 3) AS max_sec4FROM performance_schema.events_statements_summary_by_digest5WHERE DIGEST IS NOT NULL AND COUNT_STAR >= 106ORDER BY AVG_TIMER_WAIT DESC7LIMIT 20;先用执行次数过滤掉只跑过一两次的偶然样本,再比较平均和峰值。阈值 10 仅是示例,值班时按观察窗口调整。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 SUM_ROWS_EXAMINED, SUM_ROWS_SENT,3 ROUND(SUM_ROWS_EXAMINED / NULLIF(SUM_ROWS_SENT, 0), 1)4 AS examined_per_sent5FROM performance_schema.events_statements_summary_by_digest6WHERE DIGEST IS NOT NULL AND SUM_ROWS_EXAMINED > 07ORDER BY SUM_ROWS_EXAMINED DESC8LIMIT 20;这个比例只能提示扫描成本;聚合查询本来就可能读很多行却只返回一行,不能仅凭比例判定索引失效。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 SUM_CREATED_TMP_TABLES, SUM_CREATED_TMP_DISK_TABLES,3 SUM_SORT_ROWS, SUM_SORT_MERGE_PASSES4FROM performance_schema.events_statements_summary_by_digest5WHERE DIGEST IS NOT NULL6ORDER BY SUM_CREATED_TMP_DISK_TABLES DESC7LIMIT 20;落盘临时表、排序归并多,可能与 GROUP BY、ORDER BY 或结果集大小有关。还要回看具体计划,不能把所有临时表都当成错误。
1EXPLAIN SELECT order_id, created_at2FROM appdb.orders3WHERE customer_id = 100014ORDER BY created_at DESC5LIMIT 20;替换成现场 SQL 与真实参数。先看 type、key、rows、Extra;rows 是估计扫描量,不是这次实际读取量。
1EXPLAIN FORMAT=TREE SELECT order_id, created_at2FROM appdb.orders3WHERE customer_id = 100014ORDER BY created_at DESC5LIMIT 20;树形输出更容易看清过滤、排序和索引扫描谁先执行。这里只生成计划,没有把业务查询完整跑一遍。
1EXPLAIN FORMAT=JSON SELECT order_id, created_at2FROM appdb.orders3WHERE customer_id = 100014ORDER BY created_at DESC5LIMIT 20;JSON 适合保存和比较计划细节。同一条 SQL 的计划会受统计信息、参数选择性和会话设置影响,复现时这些条件要对上。
1EXPLAIN ANALYZE FORMAT=TREE SELECT order_id, created_at2FROM appdb.orders3WHERE customer_id = 100014ORDER BY created_at DESC5LIMIT 20;actual time、rows、loops 可以和估计值逐节点比较。这条会真的执行查询,不能拿未经确认的更新或删除语句直接在线上试;测试库的数据量也要接近现场。
1SELECT THREAD_ID, EVENT_NAME, SQL_TEXT,2 ROUND(TIMER_WAIT / 1000000000000, 2)3 AS elapsed_sec,4 ROWS_EXAMINED, ROWS_SENT5FROM performance_schema.events_statements_current6WHERE TIMER_WAIT >= 3 * 10000000000007ORDER BY TIMER_WAIT DESC;摘要只告诉你同类 SQL 过去的聚合,这里看还在执行的事件。TIMER_WAIT 是皮秒,计时器或语句采集未开启时可能为空;跑完的 SQL 不会一直留在 current 表里,故障取样要及时保存。
1SELECT t.PROCESSLIST_ID AS conn_id,2 t.PROCESSLIST_USER, t.PROCESSLIST_HOST,3 e.SQL_TEXT,4 ROUND(e.TIMER_WAIT / 1000000000000, 2)5 AS elapsed_sec6FROM performance_schema.events_statements_current AS e7JOIN performance_schema.threads AS t8 ON t.THREAD_ID = e.THREAD_ID9WHERE e.TIMER_WAIT >= 3 * 100000000000010ORDER BY e.TIMER_WAIT DESC;THREAD_ID 是 Performance Schema 内部号,PROCESSLIST_ID 才是客户端连接 ID。拿后者对应用连接池和请求日志,找实际参数;SQL 文本可能被截断,当前语句也可能在取样过程中结束。
1SELECT THREAD_ID, EVENT_ID, SQL_TEXT,2 ROUND(TIMER_WAIT / 1000000000000, 2)3 AS elapsed_sec,4 ROWS_EXAMINED, ROWS_SENT5FROM performance_schema.events_statements_history_long6WHERE TIMER_WAIT >= 3 * 10000000000007ORDER BY TIMER_END DESC8LIMIT 50;history_long 只保留最近结束的有限数量事件,不是永久慢查询日志;没有结果先检查第 2 条 consumer 和第 19 条容量。这里的 SQL 原文比归一化摘要更接近现场,但预处理参数仍可能缺失,要结合应用日志。
1SELECT THREAD_ID, EVENT_ID,2 ROWS_EXAMINED, ROWS_SENT,3 SQL_TEXT4FROM performance_schema.events_statements_history_long5WHERE ROWS_EXAMINED > 1000006ORDER BY ROWS_EXAMINED DESC7LIMIT 30;第 5 条是摘要累计扫描行数,这条看单次执行。10 万行只是筛选示例;批量作业、聚合查询本来可能扫描很多,先看 SQL 目的和返回结果,再决定是否去查索引/计划。历史样本被覆盖后就不能复原。
1SELECT THREAD_ID, EVENT_ID,2 CREATED_TMP_TABLES,3 CREATED_TMP_DISK_TABLES,4 SORT_MERGE_PASSES, SQL_TEXT5FROM performance_schema.events_statements_history_long6WHERE CREATED_TMP_DISK_TABLES > 07ORDER BY CREATED_TMP_DISK_TABLES DESC,8 SORT_MERGE_PASSES DESC9LIMIT 30;摘要第 6 条提示某类 SQL 经常产生磁盘临时表,这里找具体一次。落盘不一定就是慢的根因;还要看行数、数据类型、排序/分组计划与实际耗时。别看到一张磁盘临时表就立刻调大内存参数。
1SELECT SCHEMA_NAME, DIGEST_TEXT,2 QUERY_SAMPLE_TEXT,3 QUERY_SAMPLE_SEEN,4 ROUND(QUERY_SAMPLE_TIMER_WAIT5 / 1000000000000, 3)6 AS sample_sec7FROM performance_schema.events_statements_summary_by_digest8WHERE DIGEST IS NOT NULL9 AND QUERY_SAMPLE_TEXT IS NOT NULL10ORDER BY AVG_TIMER_WAIT DESC11LIMIT 20;MySQL 8.4 摘要可留一个样本 SQL,便于看到比 DIGEST_TEXT 更具体的写法。它不是所有参数组合的代表,也不一定恰好是最慢那次;QUERY_SAMPLE_SEEN 与历史事件要对故障时间,真实业务参数仍请应用侧补齐。
1SELECT SCHEMA_NAME, DIGEST_TEXT,2 COUNT_STAR,3 ROUND(AVG_TIMER_WAIT4 / 1000000000000, 3) AS avg_sec,5 ROUND(MAX_TIMER_WAIT6 / 1000000000000, 3) AS max_sec,7 ROUND(MAX_TIMER_WAIT8 / NULLIF(AVG_TIMER_WAIT, 0), 1)9 AS max_over_avg10FROM performance_schema.events_statements_summary_by_digest11WHERE DIGEST IS NOT NULL AND COUNT_STAR >= 2012ORDER BY max_over_avg DESC13LIMIT 20;平均不高、峰值很高的 SQL,可能只在某些参数或并发时段慢。max_over_avg 用来筛候选,不是 P95/P99 分位数;要找峰值那次的参数和等待,还得翻历史事件或应用链路。
1SELECT NAME, ENABLED, TIMED2FROM performance_schema.setup_instruments3WHERE NAME IN ('statement/sql/select',4 'statement/sql/insert',5 'statement/sql/update',6 'statement/sql/delete');consumer 已开启,单项 instrument 若没计时,也可能看不到完整耗时。先确认目标语句类型的 ENABLED/TIMED;修改采集设置前评估开销与排障时间范围。打开它只能记录之后的语句,不会补回已过去的慢请求。
1SHOW VARIABLES WHERE Variable_name IN2 ('performance_schema_events_statements_history_size',3 'performance_schema_events_statements_history_long_size',4 'performance_schema_max_sql_text_length');history 是每线程最近事件,history_long 是全局最近事件;两者容量有限,忙时覆盖很快。SQL 文本有长度上限,超长批次可能被截断。这些是启动配置,值班时先读清楚,不要以为调整后能找回昨日已丢的 SQL。
1SELECT SUM(COUNT_STAR) AS all_statements,2 SUM(CASE WHEN DIGEST IS NULL3 THEN COUNT_STAR ELSE 0 END)4 AS null_digest_statements,5 ROUND(100 * SUM(CASE WHEN DIGEST IS NULL6 THEN COUNT_STAR ELSE 0 END)7 / NULLIF(SUM(COUNT_STAR), 0), 2)8 AS null_digest_pct9FROM performance_schema.events_statements_summary_by_digest;摘要表容量满时,无法单独收录的语句可能汇到 DIGEST=NULL 行。占比很高,前面按 digest 排出的“Top SQL”代表性就会变差;先看摘要表容量与采集负载,不能把排行当成覆盖全部工作量的证明。
1SHOW INDEX FROM appdb.orders;先核对索引名称、列顺序和 Cardinality,再谈“为什么没走索引”。Cardinality 是估计值,不能拿它当精确的去重计数;组合索引尤其要看每个前缀的列顺序。
1SELECT INDEX_NAME, SEQ_IN_INDEX, COLUMN_NAME,2 CARDINALITY, INDEX_TYPE, IS_VISIBLE3FROM information_schema.STATISTICS4WHERE TABLE_SCHEMA = 'appdb'5 AND TABLE_NAME = 'orders'6ORDER BY INDEX_NAME, SEQ_IN_INDEX;索引多时,这样比翻 SHOW INDEX 更容易对照 SQL 的筛选、排序列。IS_VISIBLE=NO 的索引默认不会供优化器选用;CARDINALITY 仍是估算,不能只凭一个数字决定删索引。
1SHOW CREATE TABLE appdb.orders;排查计划前先看字段类型、字符集、组合索引和分区定义。拿 VARCHAR 列与数字常量比较、跨字符集连接,都可能让预期索引失效;示例表名换成现场的慢 SQL 对象。
1SELECT database_name, table_name, last_update,2 n_rows, clustered_index_size,3 sum_of_other_index_sizes4FROM mysql.innodb_table_stats5WHERE database_name = 'appdb'6 AND table_name = 'orders';这里看的是 InnoDB 持久统计,不是实时行数。表刚做过大量写入,last_update 很旧且估计行数与现场差距明显时,可以怀疑统计过时;读取 mysql 系统表需要相应权限,查不到也要先核对权限和持久统计设置。
1SELECT index_name, last_update, stat_name,2 stat_value, sample_size, stat_description3FROM mysql.innodb_index_stats4WHERE database_name = 'appdb'5 AND table_name = 'orders'6ORDER BY index_name, stat_name;n_diff_pfx 系列记录索引前缀的不同值估计,stat_description 对应列;拿它对照谓词顺序,比笼统说“索引选择性差”更有用。样本页数小、数据又明显倾斜时,估计误差可能很大;这些记录也不是实时精确计数。
1SHOW VARIABLES WHERE Variable_name IN2 ('innodb_stats_persistent',3 'innodb_stats_auto_recalc',4 'innodb_stats_persistent_sample_pages');先弄清统计信息是否持久化、是否自动重算、采样页数是多少。同一个 SQL 换库后计划不同,配置和统计快照都值得比较;别为了让计划“好看”就临时把采样页数调大。
1SELECT SCHEMA_NAME, TABLE_NAME, COLUMN_NAME,2 HISTOGRAM3FROM information_schema.COLUMN_STATISTICS4WHERE SCHEMA_NAME = 'appdb'5 AND TABLE_NAME = 'orders'6 AND COLUMN_NAME = 'status';status 这类状态列常常分布不均。直方图可以帮助估计单列谓词的行数,但不是所有慢 SQL 都需要建直方图;没有记录时先对照实际参数分布和计划,读这张视图也要有相应对象权限。
1ANALYZE TABLE appdb.orders;这是维护命令,不是只读查询。先保存慢 SQL 的原计划、耗时和统计更新时间,再选业务低峰执行;刷新统计可能改变其他 SQL 的索引选择。完成后用相同参数重新看计划,不能只因为这条命令成功就认定故障已解决。
1ANALYZE TABLE appdb.orders2 UPDATE HISTOGRAM ON status WITH 16 BUCKETS;仅在确认 status 分布倾斜、优化器估错行数且这列适合单列统计时使用。直方图更新会影响依赖该表的执行计划;先留旧计划和测试参数,执行后检查第 27 条的内容及业务 SQL 的回归结果。16 桶是示例,不是统一最佳值。
1EXPLAIN FORMAT=JSON2SELECT order_id, created_at3FROM appdb.orders4WHERE status = 'PAID'5 AND created_at >= '2026-09-01 00:00:00'6 AND created_at < '2026-09-02 00:00:00'7ORDER BY created_at DESC8LIMIT 50;把这条与更新统计前同一 SQL、同一参数的计划比较,重点看选择的索引、估计扫描行数与排序方式。EXPLAIN 不等于真实执行耗时;若要测实际表现,回到第 10 条,在可控环境跑 EXPLAIN ANALYZE。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4WHERE created_at >= '2026-09-01 00:00:00'5 AND created_at < '2026-09-02 00:00:00';先看 type 是不是 range,再看 key 和估计 rows。有索引却全表扫,不必马上强制走索引:范围覆盖大部分表时,全表扫可能更便宜;拿真实日期段及表大小复核。
1EXPLAIN2SELECT order_id3FROM appdb.orders4WHERE DATE(created_at) = '2026-09-01';如果 created_at 有普通 B-tree 索引,给列套 DATE() 往往让范围访问变困难。和第 31 条比较时,要确认两条 SQL 的日期边界、时区和返回结果一致,再讨论改写,不能只看 key 是否显示索引名。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4WHERE created_at >= '2026-09-01 00:00:00'5ORDER BY created_at DESC6LIMIT 20;假如订单表只有 (customer_id, created_at) 组合索引,而这条 SQL 没有 customer_id,不能期待它像单列 created_at 索引那样高效定位。先用第 22 条核对实际列顺序;MySQL 8.4 也可能考虑 skip scan,最终以现场计划为准。
1EXPLAIN2SELECT order_id3FROM appdb.orders4WHERE customer_id = 100015 AND created_at >= '2026-09-01 00:00:00';传统计划的 key_len 可辅助判断索引前缀用到哪里,却不能直接等同于“用了几个字段”。字段类型、可空性都会影响长度;最好与 used_key_parts 的 JSON 计划及第 22 条索引定义一起看。
1EXPLAIN FORMAT=JSON2SELECT order_id3FROM appdb.orders4WHERE customer_id = 100015 AND created_at >= '2026-09-01 00:00:00';保存 JSON 输出,找表访问节点的 key、used_key_parts、rows_examined_per_scan。它们仍是优化器估计;拿真实值做 EXPLAIN ANALYZE 时再比较实际行数,不要把估计行数抄成执行结果。
1EXPLAIN ANALYZE2SELECT order_id, created_at3FROM appdb.orders4WHERE customer_id = 100015ORDER BY created_at DESC, order_id DESC6LIMIT 20 OFFSET 50000;这条会真的读数据,先在测试库或确认可控的只读场景执行。深分页即使走索引,也可能先遍历大量行再丢弃;看实际读取行数和耗时,再与上一页末尾键值定位的写法比较。没有稳定排序列,改分页方式还可能造成漏行或重复。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4WHERE customer_id = 100015 AND (created_at, order_id) <6 ('2026-09-01 12:00:00', 500001)7ORDER BY created_at DESC, order_id DESC8LIMIT 20;键值来自上一页最后一条,不能随意填。和第 36 条比计划前先确认排序方向及并列时间的处理;行构造器不一定把两个索引列都转成有效的范围边界,若估计扫描仍高,可再测试等价的分支条件写法。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4WHERE customer_id = 100015 AND (created_at < '2026-09-01 12:00:00'6 OR (created_at = '2026-09-01 12:00:00'7 AND order_id < 500001))8ORDER BY created_at DESC, order_id DESC9LIMIT 20;这条与第 37 条在普通非空排序列下表达相同边界,但优化器可能给出不同范围计划。实际表若允许 created_at 为 NULL,结果语义需要单独处理;先验结果集,再比扫描量。
1EXPLAIN2SELECT o.order_id3FROM appdb.orders AS o4JOIN appdb.customers AS c5 ON c.customer_id = o.customer_id6WHERE c.customer_id = 10001;先用第 23 条核对两边 customer_id 的类型、长度、字符集与排序规则。若连接列定义不一致,隐式转换可能影响索引访问;计划里还要看谁是驱动表、被驱动表每次读多少行,不是看到 JOIN 就认为一定慢。
1EXPLAIN2SELECT order_id3FROM appdb.orders4WHERE customer_id = 10001;5SHOW WARNINGS;两句要在同一会话连续执行。SHOW WARNINGS 可看到扩展计划的改写信息或提示,排查谓词被怎样处理时有用;其中重写后的文本是优化器内部展示,不保证与业务 SQL 的执行细节完全等价。
1SET optimizer_trace = 'enabled=on';只给当前会话开,随后立刻执行待分析的计划语句。跟踪用于解释优化器考虑过哪些方案、为何选或放弃某个访问路径;开启后别拿这个会话跑一长串无关 SQL。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4WHERE customer_id = 100015ORDER BY created_at DESC6LIMIT 20;与第 41 条在同一会话连续执行。这里用 EXPLAIN 生成计划,避免直接运行业务查询;跟踪内容仍会受统计信息和这次的真实参数影响,不能拿一个样本解释所有客户。
1SELECT TRACE, MISSING_BYTES_BEYOND_MAX_MEM_SIZE,2 INSUFFICIENT_PRIVILEGES3FROM information_schema.OPTIMIZER_TRACE;TRACE 中看候选索引、行数估计和成本比较,不要只找最终 chosen。MISSING_BYTES_BEYOND_MAX_MEM_SIZE 大于零说明跟踪被内存上限截断;权限不足也可能让内容不完整。它只能看到本会话的跟踪。
1SET optimizer_trace = 'enabled=off';这个设置不是业务 SQL 的长期优化开关。关闭后再复测常规计划,保存第 43 条的跟踪与参数;不能把跟踪开启后的测试会话直接交还给连接池。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4 USE INDEX (idx_orders_customer_created)5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;索引名必须先由第 21、22 条确认。USE INDEX 缩小优化器可选范围,用来比较“若采用这条索引会怎样”;它不保证一定走该索引,更不能仅因估计 cost 变低就改生产代码。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4 FORCE INDEX (idx_orders_customer_created)5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;FORCE INDEX 会提高全表扫描的相对成本,但也不等于实际执行一定更快。它适合做对照实验:如果指定索引的估计行数与实际相差很大,先查统计信息和参数分布,不要靠强制提示掩盖根因。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4 IGNORE INDEX (idx_orders_customer_created)5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;和未加提示的计划比较,看看优化器会选另一个索引、排序还是全表扫。排除索引只是诊断手段,不等于建议删索引;同一索引可能仍支撑其他重要 SQL。
1EXPLAIN2SELECT order_id, created_at3FROM appdb.orders4 USE INDEX FOR ORDER BY (idx_orders_customer_created)5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;FOR ORDER BY 把提示范围限定在排序相关的索引选择;它与不带范围的提示不是同一件事。先对照扫描节点和 Extra 中的排序信息,检查返回结果需求,别为了消掉 filesort 就牺牲更便宜的筛选路径。
1EXPLAIN ANALYZE2SELECT order_id, created_at3FROM appdb.orders4 FORCE INDEX (idx_orders_customer_created)5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;这条会实际执行 SELECT。与普通计划用相同参数、相近负载分别测,不要只比两份估计计划的 cost;若业务参数波动大,还要覆盖高频与极端参数。强制索引让单次样本变快,不代表整个工作负载都受益。
1EXPLAIN SELECT2 /*+ SET_VAR(optimizer_switch = 'use_invisible_indexes=on') */3 order_id, created_at4FROM appdb.orders5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;如果现场已建不可见索引,这个提示只在这一条计划语句中让优化器考虑它,不必把索引直接改为可见。与普通 EXPLAIN 比较 key 和估计行数;没有不可见索引时结果通常没有差别,真实收益仍需受控执行与回归验证。
1SELECT db, query, exec_count, avg_latency,2 max_latency, rows_examined_avg, last_seen3FROM sys.statements_with_runtimes_in_95th_percentile4WHERE db = 'appdb'5ORDER BY avg_latency DESC6LIMIT 20;这里筛的是语句摘要的平均耗时分布,不是某条 SQL 单次执行的 P95。先看 exec_count:只跑过一次的慢语句和每天跑十万次的慢语句,不该按同一个优先级处理。query 是归一化文本,不能从中还原当时的参数。
1SELECT db, query, exec_count, no_index_used_count,2 total_latency, digest3FROM sys.statements_with_full_table_scans4WHERE db = 'appdb'5ORDER BY no_index_used_count DESC, total_latency DESC6LIMIT 20;no_index_used_count 高,先核对扫描的究竟是大表还是小表,再查 WHERE 条件和第 21—30 条的索引统计。小表扫描有时比索引访问便宜;不能看到这列就要求加索引。
1SELECT object_schema, object_name,2 rows_full_scanned, latency3FROM sys.schema_tables_with_full_table_scans4WHERE object_schema = 'appdb'5ORDER BY rows_full_scanned DESC6LIMIT 20;这条从表看扫描量,第 52 条从语句摘要看没有使用索引的次数。两边对上后,再拿具体 SQL 做计划分析。这里的累计值受 Performance Schema 采集期影响,不是表从建库以来的终身统计。
1SELECT db, query, exec_count, memory_tmp_tables,2 disk_tmp_tables, tmp_tables_to_disk_pct3FROM sys.statements_with_temp_tables4WHERE db = 'appdb'5ORDER BY disk_tmp_tables DESC6LIMIT 20;先看 disk_tmp_tables 和执行次数,再读 tmp_tables_to_disk_pct。聚合、窗口函数、派生表都可能需要内部临时表;落盘数高时要检查查询写法、返回列宽和实际计划,不能只调大一个内存参数。
1SELECT db, query, exec_count, sort_merge_passes,2 avg_sort_merges, rows_sorted3FROM sys.statements_with_sorting4WHERE db = 'appdb'5ORDER BY sort_merge_passes DESC6LIMIT 20;sort_merge_passes 是排序归并的累计次数。把执行次数、排序行数和 SQL 的 ORDER BY / GROUP BY 一起看:频繁执行的排序与偶尔一次的大排序,处理办法不同。filesort 本身也不等于磁盘排序。
1SELECT db, query, exec_count, total_latency,2 cpu_latency, lock_latency, rows_examined_avg3FROM sys.statement_analysis4WHERE db = 'appdb'5ORDER BY total_latency DESC6LIMIT 20;先把累计耗时大的语句挑出来,再看 CPU、锁等待和扫描行数。lock_latency 只覆盖语句事件记录到的锁耗时,不能当成所有等待时间;如果这列低而 SQL 仍慢,还要查单次事件、I/O 和实际计划。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 ROUND(QUANTILE_95 / 1e12, 3) AS p95_seconds,3 ROUND(QUANTILE_99 / 1e12, 3) AS p99_seconds4FROM performance_schema.events_statements_summary_by_digest5WHERE SCHEMA_NAME = 'appdb'6ORDER BY QUANTILE_99 DESC7LIMIT 20;与第 51 条不同,这里的 QUANTILE_95、QUANTILE_99 是同一个 digest 的耗时直方图估计,原值单位是皮秒。COUNT_STAR 太小或语句分布跨了多种参数时,不要把这个估计当成服务接口的精确 P99。
1SELECT SCHEMA_NAME, DIGEST, DIGEST_TEXT,2 QUERY_SAMPLE_TEXT, QUERY_SAMPLE_SEEN3FROM performance_schema.events_statements_summary_by_digest4WHERE SCHEMA_NAME = 'appdb'5 AND DIGEST = '替换为现场 digest 值';先用第 52 条的 digest 定位,再看样本原文和采样时间。样本可能不是最慢那次,也可能因 SQL 文本长度限制被截断;拿它做 EXPLAIN 前,要核对业务参数和样本是否仍有代表性。
1SELECT SCHEMA_NAME, DIGEST_TEXT, COUNT_STAR,2 FIRST_SEEN, LAST_SEEN3FROM performance_schema.events_statements_summary_by_digest4WHERE SCHEMA_NAME = 'appdb'5ORDER BY LAST_SEEN DESC6LIMIT 20;LAST_SEEN 能帮你分清“刚才还在跑”和“采集期早些时候留下的慢 SQL”。它不是业务调用日志;如果摘要表已被清空、容量已满或采集关过,不能从缺行推断 SQL 没执行。
1SELECT db, query, exec_count, errors,2 warnings, last_seen3FROM sys.statements_with_errors_or_warnings4WHERE db = 'appdb'5ORDER BY errors DESC, warnings DESC6LIMIT 20;重试和异常 SQL 也会拉高总耗时。先确认错误类型、调用方和最近一次发生时间;这里给的是摘要计数,不是具体错误码,仍需看应用日志或单次语句事件。
1SELECT OBJECT_SCHEMA, OBJECT_NAME,2 COUNT_READ, SUM_TIMER_READ,3 COUNT_WRITE, SUM_TIMER_WRITE4FROM performance_schema.table_io_waits_summary_by_table5WHERE OBJECT_SCHEMA = 'appdb'6ORDER BY SUM_TIMER_WAIT DESC7LIMIT 20;这张表统计 handler 层的表访问等待,能先找出访问压力集中的表。它是采集期累计值,不是一条 SQL 的耗时分解;同时看读写次数,避免只按总等待排序误判。
1SELECT INDEX_NAME, COUNT_FETCH, SUM_TIMER_FETCH2FROM performance_schema.table_io_waits_summary_by_index_usage3WHERE OBJECT_SCHEMA = 'appdb'4 AND OBJECT_NAME = 'orders'5ORDER BY COUNT_FETCH DESC;INDEX_NAME = 'PRIMARY' 表示主键索引;NULL 在读操作中表示没有使用索引,但插入也记在 NULL 行。因此这里用 COUNT_FETCH,不要用 COUNT_STAR 判断全表扫描。索引统计会在索引结构变更后重置。
1SELECT COUNT_FETCH, SUM_TIMER_FETCH2FROM performance_schema.table_io_waits_summary_by_index_usage3WHERE OBJECT_SCHEMA = 'appdb'4 AND OBJECT_NAME = 'orders'5 AND INDEX_NAME IS NULL;与第 52 条语句摘要结合看:表侧读操作无索引多,才值得把相关 SQL 的计划找出来。这个数字仍不能证明哪一条具体 SQL 扫了全表,也不能把插入操作混进来。
1SELECT COUNT_FETCH, SUM_TIMER_FETCH,2 COUNT_INSERT, SUM_TIMER_INSERT,3 COUNT_UPDATE, SUM_TIMER_UPDATE,4 COUNT_DELETE, SUM_TIMER_DELETE5FROM performance_schema.table_io_waits_summary_by_table6WHERE OBJECT_SCHEMA = 'appdb'7 AND OBJECT_NAME = 'orders';如果业务说“查订单变慢”,先看是否同一时段写入、更新也显著增多。这里是表级累计,不能凭它宣布读写冲突;需要结合时间窗口、单次语句与锁等待观察。
1SELECT EVENT_NAME, COUNT_STAR,2 ROUND(SUM_TIMER_WAIT / 1e12, 3) AS wait_seconds3FROM performance_schema.events_waits_summary_global_by_event_name4WHERE COUNT_STAR > 05ORDER BY SUM_TIMER_WAIT DESC6LIMIT 20;先分清文件 I/O、同步原语和表访问等事件类型。它是所有线程的累计等待,不能直接归到第 3 条的某个 SQL 摘要;等待事件采集未开启时,空结果没有诊断意义。
1-- 连接 ID 换成现场值;THREAD_ID 是 Performance Schema 内部线程号2SELECT w.EVENT_NAME, w.COUNT_STAR,3 ROUND(w.SUM_TIMER_WAIT / 1e12, 3) AS wait_seconds4FROM performance_schema.events_waits_summary_by_thread_by_event_name AS w5JOIN performance_schema.threads AS t6 ON t.THREAD_ID = w.THREAD_ID7WHERE t.PROCESSLIST_ID = 123458ORDER BY w.SUM_TIMER_WAIT DESC9LIMIT 20;这能把等待收窄到连接,但仍包含该连接采集期跑过的多条语句。连接退出后线程汇总可能不再可查;要定位某次执行,继续看单次语句和嵌套事件。
1SELECT EVENT_NAME, COUNT_READ, SUM_NUMBER_OF_BYTES_READ,2 COUNT_WRITE, SUM_NUMBER_OF_BYTES_WRITE,3 ROUND(SUM_TIMER_WAIT / 1e12, 3) AS wait_seconds4FROM performance_schema.file_summary_by_event_name5WHERE COUNT_STAR > 06ORDER BY SUM_TIMER_WAIT DESC7LIMIT 20;文件事件按 instrument 汇总,并非磁盘设备监控。缓存命中会让 SQL 没有相应文件读事件;读写字节和等待时间要一起看,再用系统 I/O 指标核对。
1SELECT FILE_NAME, EVENT_NAME,2 COUNT_READ, SUM_NUMBER_OF_BYTES_READ,3 COUNT_WRITE, SUM_NUMBER_OF_BYTES_WRITE,4 ROUND(SUM_TIMER_WAIT / 1e12, 3) AS wait_seconds5FROM performance_schema.file_summary_by_instance6WHERE COUNT_STAR > 07ORDER BY SUM_TIMER_WAIT DESC8LIMIT 20;第 67 条按事件类型看,这条按文件看。文件路径能帮助区分表空间、日志等对象;同一 SQL 也可能涉及多个文件,不能把排第一的文件直接认作慢 SQL 的唯一原因。
1SELECT NAME, ENABLED2FROM performance_schema.setup_consumers3WHERE NAME IN ('events_statements_current',4 'events_statements_history_long',5 'events_stages_current',6 'events_stages_history_long',7 'events_waits_current',8 'events_waits_history_long')9ORDER BY NAME;历史表默认不一定开启,尤其等待历史。没有采集,后面的单次执行关联查不到行,不能解释成“这条 SQL 没有等待”。调整采集设置前先评估开销和采集窗口。
1SELECT NAME, ENABLED, TIMED2FROM performance_schema.setup_instruments3WHERE NAME LIKE 'wait/io/table/%'4 OR NAME LIKE 'wait/io/file/%'5ORDER BY NAME;ENABLED = 'YES' 才产生事件,TIMED = 'YES' 才有等待时间。只开 consumer 不开 instrument,或只开 instrument 不开对应历史 consumer,都不能拼出一次执行的等待链。
1SELECT THREAD_ID, EVENT_ID, DIGEST, SQL_TEXT,2 ROUND(TIMER_WAIT / 1e12, 3) AS elapsed_seconds3FROM performance_schema.events_statements_history_long4WHERE CURRENT_SCHEMA = 'appdb'5 AND TIMER_WAIT >= 3e126ORDER BY TIMER_WAIT DESC7LIMIT 20;THREAD_ID + EVENT_ID 定位这一次执行;一个 DIGEST 可以对应很多次执行。历史表容量有限,慢语句可能很快被新事件覆盖。
1-- 内部线程号和事件号取第 71 条的同一行2SELECT EVENT_NAME, OPERATION, OBJECT_SCHEMA, OBJECT_NAME,3 ROUND(TIMER_WAIT / 1e12, 6) AS wait_seconds4FROM performance_schema.events_waits_history_long5WHERE THREAD_ID = 123456 AND NESTING_EVENT_TYPE = 'STATEMENT'7 AND NESTING_EVENT_ID = 678908ORDER BY TIMER_WAIT DESC9LIMIT 30;这里只取直接嵌在该语句下的等待。等待也可能嵌在阶段下,空结果不能证明执行没有等待;继续看第 73、74 条。
1-- THREAD_ID、语句事件号换成第 71 条的值2SELECT EVENT_ID, EVENT_NAME,3 ROUND(TIMER_WAIT / 1e12, 6) AS stage_seconds4FROM performance_schema.events_stages_history_long5WHERE THREAD_ID = 123456 AND NESTING_EVENT_TYPE = 'STATEMENT'7 AND NESTING_EVENT_ID = 678908ORDER BY EVENT_ID;阶段能说明执行大致花在什么步骤,但不是完整、互斥的成本模型。只有阶段 instrument 和历史 consumer 都开启时才有记录;阶段名还要和当时的计划一起读。
1-- 线程号、语句事件号取第 71 条2SELECT st.EVENT_NAME AS stage_name,3 w.EVENT_NAME AS wait_name,4 w.OPERATION, w.OBJECT_SCHEMA, w.OBJECT_NAME,5 ROUND(w.TIMER_WAIT / 1e12, 6) AS wait_seconds6FROM performance_schema.events_stages_history_long AS st7JOIN performance_schema.events_waits_history_long AS w8 ON w.THREAD_ID = st.THREAD_ID9 AND w.NESTING_EVENT_TYPE = 'STAGE'10 AND w.NESTING_EVENT_ID = st.EVENT_ID11WHERE st.THREAD_ID = 1234512 AND st.NESTING_EVENT_TYPE = 'STATEMENT'13 AND st.NESTING_EVENT_ID = 6789014 AND (w.EVENT_NAME LIKE 'wait/io/file/%'15 OR w.EVENT_NAME LIKE 'wait/io/table/%')16ORDER BY w.TIMER_WAIT DESC17LIMIT 30;这条把等待挂到阶段,再把阶段挂回同一次语句。历史缓存可能只保留其中一层;缺行时先复查采集开关和缓存容量。
1SELECT t.PROCESSLIST_ID, s.SQL_TEXT,2 w.EVENT_NAME AS current_wait,3 w.OPERATION, w.OBJECT_SCHEMA, w.OBJECT_NAME4FROM performance_schema.events_statements_current AS s5JOIN performance_schema.threads AS t6 ON t.THREAD_ID = s.THREAD_ID7LEFT JOIN performance_schema.events_waits_current AS w8 ON w.THREAD_ID = s.THREAD_ID9 AND w.END_EVENT_ID IS NULL10WHERE s.CURRENT_SCHEMA = 'appdb'11 AND s.END_EVENT_ID IS NULL12 AND s.TIMER_WAIT >= 3e1213ORDER BY s.TIMER_WAIT DESC14LIMIT 20;END_EVENT_ID IS NULL 排除已经结束、但仍留在 current 表中的上一条事件。这是瞬时观察;current_wait 为空,可能是当下没有等待,也可能是等待 consumer 未启用。应连续取样,不能把一次快照当成完整时间线。
1SHOW GLOBAL VARIABLES2WHERE Variable_name IN ('slow_query_log', 'slow_query_log_file',3 'log_output', 'long_query_time',4 'min_examined_row_limit');慢日志要同时满足启用、超过耗时阈值、达到扫描行数门槛。log_output = NONE 时即使开关为 ON,也不会写入常规慢日志。先读现有配置,别因为查不到慢 SQL 就马上把全局阈值降到零。
1SHOW SESSION VARIABLES2WHERE Variable_name IN ('long_query_time',3 'min_examined_row_limit');long_query_time 和 min_examined_row_limit 可有会话值。第 76 条的全局值不能证明某个业务连接实际用了同一阈值;排查时要对准运行 SQL 的连接或复现会话。
1SHOW GLOBAL STATUS LIKE 'Slow_queries';它是达到慢查询条件的累计计数,不是慢日志文件的行数;采集开启前后分别读一次才有窗口增量。慢日志输出位置为 NONE 时,计数仍不能当成已有文件证据。
1-- 仅当前复现连接;现场确认慢日志已启用并指定输出2SET SESSION long_query_time = 0.5;这不会改其他连接的阈值。设置后在同一个连接执行待复现 SQL,再查日志与执行计划;连接断开时会话设置结束。慢日志在语句执行结束后写入,不会立刻展示正在跑的语句。
1SHOW GLOBAL VARIABLES2WHERE Variable_name IN ('log_queries_not_using_indexes',3 'log_throttle_queries_not_using_indexes');如果额外记录无索引查询,而限流值为零,日志可能被大量小表扫描刷满。慢日志里的“无索引”不能直接认作性能问题;结合第 52 条和实际计划判断。
1# 在数据库服务器或已授权复制日志的分析机上;路径换成现场文件2mysqldumpslow -s at -t 20 /var/log/mysql/mysql-slow.log工具会把相似语句中的数字和字符串归一化,输出平均时间和次数。先看出现频率,再回原日志找具体参数;-s at 不是 P95,也不能把归一化后的文本直接作为可复现 SQL。
1# 只读取已存在的 FILE 慢日志2mysqldumpslow -s c -t 20 /var/log/mysql/mysql-slow.log这条优先找高频问题,第 81 条优先找平均值高的问题。同一 SQL 模板可能因参数不同走不同计划;确定优化对象后,再回到原始 SQL、索引统计和第 10 条的实际执行检查。
1-- 仅当第 76 条的 log_output 含 TABLE 时继续查表2SHOW CREATE TABLE mysql.slow_log;先确认慢日志实际写在表里,再看 start_time、query_time、rows_examined 和 sql_text 的定义。log_slow_extra 增加的字段只写 FILE,不会把这些扩展计数加进 mysql.slow_log。
1-- 时间窗口换成故障发生时段;TABLE 日志可能很大2SELECT start_time, db, query_time, lock_time,3 rows_examined, rows_sent, sql_text4FROM mysql.slow_log5WHERE start_time >= '2026-09-16 10:00:00'6 AND start_time < '2026-09-16 10:10:00'7 AND db = 'appdb'8ORDER BY query_time DESC9LIMIT 20;这比摘要更接近当时运行的 SQL,但慢日志表使用 CSV 引擎,长时间窗口查询可能很重;先缩小时间和库名。日志是语句执行后写入的,不能用来观察尚未结束的 SQL。
1-- 故障时间窗口换成现场值2SELECT start_time, query_time, rows_examined,3 rows_sent, sql_text4FROM mysql.slow_log5WHERE start_time >= '2026-09-16 10:00:00'6 AND start_time < '2026-09-16 10:10:00'7 AND db = 'appdb'8 AND rows_examined >= 1000009 AND rows_sent <= 10010ORDER BY rows_examined DESC11LIMIT 20;这是找计划分析候选的条件,不是优化结论。rows_examined 高可能是过滤条件、连接顺序或索引前缀造成的;取出原 SQL 后检查真实参数与执行计划。
1SELECT table_schema, table_name,2 innodb_buffer_allocated,3 innodb_buffer_pages, innodb_buffer_rows_cached4FROM sys.schema_table_statistics_with_buffer5WHERE table_schema = 'appdb'6 AND table_name = 'orders';这是当前 Buffer Pool 中该表的占用,不是表在磁盘上的大小。查询慢而占用较少时,还要对照实际读取、全实例 Buffer Pool 压力和查询范围;不能直接用这个数推断命中率。
1SELECT table_schema, table_name,2 rows_fetched, io_read_requests, io_read,3 io_read_latency4FROM sys.schema_table_statistics_with_buffer5WHERE table_schema = 'appdb'6 AND table_name = 'orders';rows_fetched 是表访问读出的行数,io_read 是文件读取字节,两者不是同一层指标。缓存命中时行数上升也未必伴随文件读取;要做前后对照,需在相同采集窗口里分别取增量。
1SELECT table_schema, table_name, index_name,2 rows_selected, select_latency,3 rows_inserted, insert_latency,4 rows_updated, update_latency5FROM sys.schema_index_statistics6WHERE table_schema = 'appdb'7 AND table_name = 'orders'8ORDER BY rows_selected DESC;第 62 条看底层索引访问次数,这条用 sys 视图看读取行数及写入维护负担。想增加索引改善慢查询,也要考虑写入成本;不能仅因一个索引 rows_selected 很低就删掉它,它可能服务于低频但关键的业务 SQL。
1SHOW GLOBAL STATUS LIKE 'Uptime';后面“未使用索引”的判断依赖采集期。实例刚重启、Performance Schema 汇总刚清过或业务低峰时,缺少索引事件并不代表它不再被业务使用;还要覆盖月末、批处理等低频工作负载。
1SELECT object_schema, object_name, index_name2FROM sys.schema_unused_indexes3WHERE object_schema = 'appdb'4ORDER BY object_name, index_name;这张清单适合作为索引审查起点,不是删除名单。它受实例运行时间和采集重置影响;还要核对唯一约束、外键依赖、低频 SQL 与回滚方案。
1SELECT table_name, redundant_index_name,2 redundant_index_columns,3 dominant_index_name, dominant_index_columns,4 subpart_exists5FROM sys.schema_redundant_indexes6WHERE table_schema = 'appdb'7 AND table_name = 'orders';视图按索引列定义找冗余关系。subpart_exists 提醒你检查前缀索引;覆盖关系不等于两个索引在所有查询、排序和写入上的表现相同。真正删索引前,先用实际工作负载验证。
1SELECT index_name, rows_selected,2 select_latency, rows_inserted,3 rows_updated, rows_deleted4FROM sys.schema_index_statistics5WHERE table_schema = 'appdb'6 AND table_name = 'orders'7 AND index_name = 'idx_customer_created';第 90、91 条提到某个索引时,再查它在采集期的读写情况。这里的写入行数是索引维护负担,不能单凭它决定删除;查询计划、业务频率和约束都要核对。
1-- customer_id 换成第 84 条原 SQL 的参数2EXPLAIN FORMAT=TREE3SELECT order_id, created_at4FROM appdb.orders5WHERE customer_id = 100016ORDER BY created_at DESC7LIMIT 20;与第 8 条通用树形计划不同,这里刻意使用慢日志中的参数。同一摘要下,热门客户和冷门客户可能估算不同;没有原参数时,不能拿任意值的计划代替故障现场。
1-- 必须紧跟第 93 条,在同一会话执行2SHOW WARNINGS;扩展输出能看到优化器改写和部分提示处理情况。SHOW WARNINGS 只读上一条语句的诊断信息,中间插入别的 SQL 就会丢掉对应关系;输出中的改写文本可能含特殊标记,不应直接复制执行。
1-- 连接 ID 取第 11、12 条;查看其他用户连接需 PROCESS 权限2EXPLAIN FOR CONNECTION 12345;业务 SQL 还在跑时,这比拿猜测的参数重新 EXPLAIN 更贴近现场。连接必须仍在执行可解释的语句;计划是当时的优化器选择,不会显示已完成执行的真实行数。
1SELECT @@SESSION.optimizer_switch AS optimizer_switch,2 @@SESSION.explain_format AS explain_format;同一 SQL 在不同会话里可能受优化器开关影响。比较开发环境与线上计划时,先把两边的设置记下;只比较 SQL 文本和索引定义不够。
1-- 在准备复现 SQL 的同一连接中执行2SHOW SESSION STATUS3WHERE Variable_name IN ('Handler_read_key', 'Handler_read_next',4 'Handler_read_rnd_next',5 'Created_tmp_tables',6 'Created_tmp_disk_tables',7 'Sort_merge_passes');把当前计数留作基线。SHOW STATUS 本身也可能影响部分全局计数,所以这里看会话值,并在同一连接内做前后差;它不是某条 SQL 的自动独立计数器。
1-- customer_id 换成慢日志原值;先确认查询成本和返回量2SELECT order_id, created_at3FROM appdb.orders4WHERE customer_id = 100015ORDER BY created_at DESC6LIMIT 20;第 93 条只看估算计划,这条实际跑查询。生产大表先在受控窗口或可复现环境执行;记录耗时、返回行数和参数,别把一次缓存预热后的结果当成稳定性能。
1-- 在同一连接中执行;SQL 摘要和 EVENT_ID 与复现记录核对2SELECT EVENT_ID, SQL_TEXT, ROWS_EXAMINED, ROWS_SENT,3 CREATED_TMP_TABLES, CREATED_TMP_DISK_TABLES,4 NO_INDEX_USED, SORT_MERGE_PASSES,5 ROUND(TIMER_WAIT / 1e12, 3) AS elapsed_seconds6FROM performance_schema.events_statements_history7WHERE THREAD_ID = (SELECT THREAD_ID8 FROM performance_schema.threads9 WHERE PROCESSLIST_ID = CONNECTION_ID())10ORDER BY EVENT_ID DESC11LIMIT 10;历史表也会收录你随后执行的诊断 SQL,别直接拿第一行当第 98 条。按 SQL_TEXT、时间和事件号找复现查询;采集未开或历史容量太小时,这次执行也可能已经被覆盖。
1-- 同一连接;与第 97 条留存值相减2SHOW SESSION STATUS3WHERE Variable_name IN ('Handler_read_key', 'Handler_read_next',4 'Handler_read_rnd_next',5 'Created_tmp_tables',6 'Created_tmp_disk_tables',7 'Sort_merge_passes');前后差能补充观察扫描、排序和临时表变化,但第 99、100 条诊断 SQL 本身也会产生少量计数。要看单次查询,优先读第 99 条的语句事件;会话差值作为交叉检查。
排慢 SQL,先确定是偶发、长期慢,还是调用量太大。摘要负责找对象,慢日志给具体参数,执行计划和单次事件负责验证。改索引、改 SQL 后,再用同一批参数和业务流量回头看,别只看一张更好看的 EXPLAIN。
 ORA100 DBA100 命令系列海报
更多数据库运维命令,见 ORA100 · DBA100:https://ora100.com/dba100
微信里也可以搜索小程序 「三笠的百令册」。