高可用 & 容灾30 分钟阅读
OceanBase 日志流与高可用运维 100 条命令
OceanBase 4.x 以日志流(LS)为复制和恢复的基本单元。同一个租户可能有多条 LS,每条 LS 的 Leader、Paxos 成员和日志位点都要单独核对。业务遇到写入失败或副本延迟,先确认是哪条 LS 出问题,再看它是否有 Leader、成员是否齐、日志是否同步;直接按租户整体状态判断,很容易漏掉局部故障。
2026年9月16日阅读—点赞—收藏—
dba100oceanbasescenario
100 条命令系列文章专栏
OceanBase 4.x 以日志流(LS)为复制和恢复的基本单元。同一个租户可能有多条 LS,每条 LS 的 Leader、Paxos 成员和日志位点都要单独核对。业务遇到写入失败或副本延迟,先确认是哪条 LS 出问题,再看它是否有 Leader、成员是否齐、日志是否同步;直接按租户整体状态判断,很容易漏掉局部故障。
OceanBase 4.x 以日志流(LS)为复制和恢复的基本单元。同一个租户可能有多条 LS,每条 LS 的 Leader、Paxos 成员和日志位点都要单独核对。业务遇到写入失败或副本延迟,先确认是哪条 LS 出问题,再看它是否有 Leader、成员是否齐、日志是否同步;直接按租户整体状态判断,很容易漏掉局部故障。
本文整理 V4.3.3 日志流高可用排查命令。前面的查询用于定位,后面会写副本迁移、成员变更与故障窗口的检查。需要时可以按 LS_ID 查,建议收藏备用。
示例采用 OceanBase 数据库分布式版 V4.3.3、MySQL 模式,在 root@sys 下查询 oceanbase 视图。租户 ID、LS_ID 和 OBServer 地址要换成现场值;不把用户租户的 DBA_ 视图当成系统租户的全局清单。
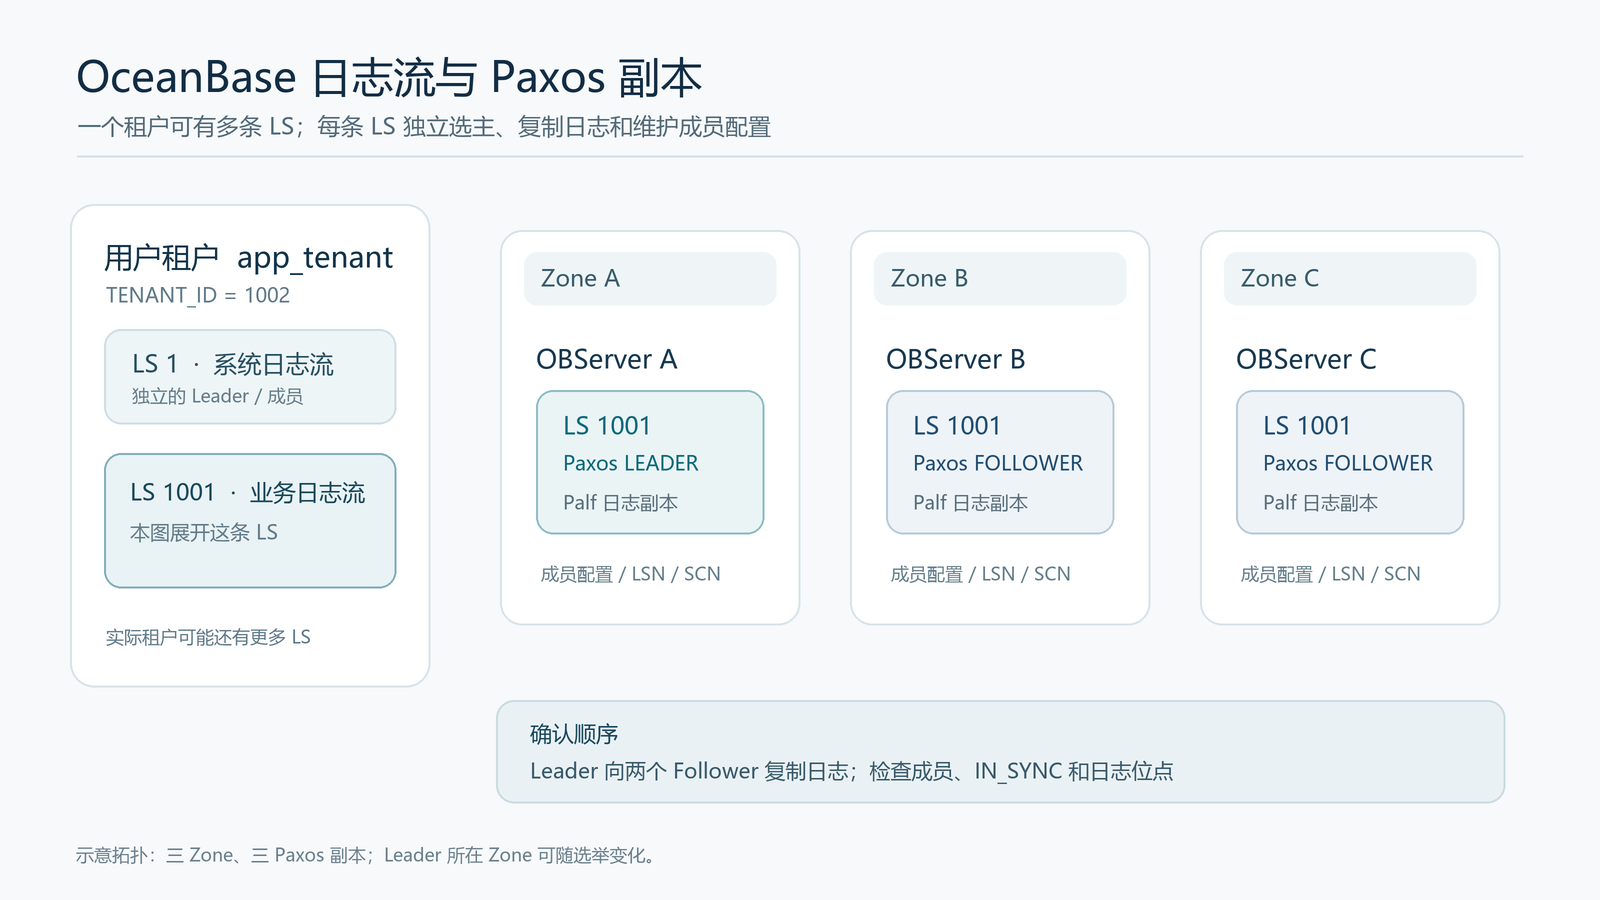 OceanBase 一个租户内多条日志流及一条 LS 的三 Zone Paxos 副本示意
图中只展开 LS 1001:这条 LS 在三个 Zone 的 OBServer 上有一个 Leader、两个 Follower。LS 1 有自己的成员和 Leader;图里没有把两条 LS 合成同一个 Paxos 组。
1-- root@sys2SELECT TENANT_ID, LS_ID, STATUS, PRIMARY_ZONE,3 UNIT_GROUP_ID, LS_GROUP_ID4FROM oceanbase.CDB_OB_LS5WHERE TENANT_ID = 10026ORDER BY LS_ID;CDB_OB_LS 是系统租户看全库 LS 的入口。先记住业务租户有哪些 LS、各自状态和 Primary Zone;之后的副本、Leader 查询都按 TENANT_ID + LS_ID 限定,别拿不同 LS 的结果拼在一起。
1-- root@sys2SELECT TENANT_ID, LS_ID, SVR_IP, SVR_PORT,3 ROLE, IN_SYNC, PROPOSAL_ID4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 1002 AND LS_ID = 10016ORDER BY SVR_IP, SVR_PORT;一行对应一台 OBServer 上这条 LS 的 Palf 状态。ROLE 看 Leader/Follower,IN_SYNC 看是否同步;状态随选举和日志写入变化,排障时最好连取两次,并记下观察时间。
1-- root@sys2SELECT l.TENANT_ID, l.LS_ID, l.STATUS3FROM oceanbase.CDB_OB_LS AS l4LEFT JOIN oceanbase.GV$OB_LOG_STAT AS s5 ON s.TENANT_ID = l.TENANT_ID6 AND s.LS_ID = l.LS_ID7 AND s.ROLE = 'LEADER'8WHERE l.TENANT_ID = 10029 AND s.LS_ID IS NULL10ORDER BY l.LS_ID;结果非空,说明这次全局快照没看到对应 LS 的 Leader。一次查询可能正好撞上选举窗口,先复查,再看 OBServer 在线情况、成员列表和最近副本任务;不要立即手工改成员。
1-- root@sys2SELECT TENANT_ID, LS_ID, SVR_IP, SVR_PORT,3 PROPOSAL_ID, CONFIG_VERSION4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 10026 AND LS_ID = 10017 AND ROLE = 'LEADER';PROPOSAL_ID 反映 Paxos 选举任期,CONFIG_VERSION 对应成员配置版本。连续快照里 Leader 地址或任期频繁变化,再查节点、网络和副本同步;不要把某次正常的 Leader 切换当成持续故障。
1-- root@sys2SELECT TENANT_ID, LS_ID, PAXOS_MEMBER_LIST,3 PAXOS_REPLICA_NUM, CONFIG_VERSION4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 10026 AND LS_ID = 10017 AND ROLE = 'LEADER';成员地址列表和配置副本数要一起看。PAXOS_MEMBER_LIST 反映参与选举的成员,不等于所有只读副本;若实际看到的副本少于成员清单,继续查节点是否离线及副本重建任务。
1-- root@sys2SELECT TENANT_ID, LS_ID, SVR_IP, SVR_PORT,3 ROLE, IN_SYNC, END_LSN, MAX_LSN4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 10026 AND IN_SYNC <> 'YES'7ORDER BY LS_ID, SVR_IP;先确认这些副本所在 LS 的 Leader 是否稳定,再对比日志位点。IN_SYNC=NO 是定位入口,不应单靠它决定迁移或删除副本;短时写入高峰也可能让快照里的状态波动。
1-- root@sys2SELECT LS_ID, SVR_IP, SVR_PORT, ROLE,3 END_LSN, END_SCN, MAX_LSN, MAX_SCN4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 1002 AND LS_ID = 10016ORDER BY ROLE, SVR_IP;END_LSN/END_SCN 是可消费的连续多数派位点,MAX_LSN/MAX_SCN 是最大写入点。比较各副本时要用同一条 LS、同一次查询;两类位点意义不同,不能拿它们简单相减当成“业务延迟秒数”。
1-- root@sys2SELECT LS_ID, SVR_IP, SVR_PORT, ROLE,3 BASE_LSN, BEGIN_LSN, BEGIN_SCN4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 1002 AND LS_ID = 10016ORDER BY SVR_IP;BASE_LSN 是最大可回收位点,BEGIN_LSN/BEGIN_SCN 是当前可提供日志消费的最小范围。排查日志订阅或副本追赶问题时,要确认请求的起点仍在可用范围内;不能用这几个值推断备份已完成。
1-- root@sys2SELECT LS_ID, SVR_IP, ROLE, ACCESS_MODE3FROM oceanbase.GV$OB_LOG_STAT4WHERE TENANT_ID = 1002 AND LS_ID = 10015ORDER BY SVR_IP;主租户日志流通常是 APPEND,备租户场景可出现 RAW_WRITE。若写入异常,先结合租户角色和 LS Leader 判断;不要只凭某个副本的访问模式就认定租户已切换。
1-- root@sys2SELECT LS_ID, SVR_IP, SVR_PORT,3 ROLE, PROPOSAL_ID, CONFIG_VERSION4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 1002 AND LS_ID = 10016ORDER BY SVR_IP, SVR_PORT;副本变更窗口里,成员配置版本是否一致要与任务状态一起看。版本暂时不同不等于最终变更失败;若长时间不收敛,再按 LS_ID 查迁移、添加、删除副本任务和 OBServer 事件日志。
1-- root@sys2SELECT TENANT_ID, LS_ID, TASK_ID, TASK_TYPE,3 TASK_STATUS, CREATE_TIME, MODIFY_TIME4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 10026ORDER BY CREATE_TIME;添加、迁移、删除副本和修改 Paxos 数量都可能出现在这里。先按 LS_ID 跟异常日志流对齐;任务仍在表中不一定代表已经失败,但 MODIFY_TIME 长时间不变值得继续查执行节点和事件日志。
1-- root@sys;TASK_ID 用第 11 条真实返回值替换2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 TARGET_REPLICA_SVR_IP, TARGET_REPLICA_SVR_PORT,4 SOURCE_REPLICA_SVR_IP, SOURCE_REPLICA_SVR_PORT,5 DATA_SOURCE_SVR_IP, DATA_SOURCE_SVR_PORT6FROM oceanbase.CDB_OB_LS_REPLICA_TASKS7WHERE TENANT_ID = 1002 AND LS_ID = 10018 AND TASK_ID = 'task_id_from_previous_query';目标副本节点、原副本节点和实际数据源可能是不同机器。若复制慢,先找出真正的数据源和目标节点,再查两端磁盘、网络及日志位置;删除副本类任务的某些源字段可能为空,不能一概当成元数据丢失。
1-- root@sys2SELECT TASK_ID, TASK_TYPE, IS_MANUAL,3 PRIORITY, COMMENT, CREATE_TIME4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 1002 AND LS_ID = 10016ORDER BY CREATE_TIME;IS_MANUAL=FALSE 常见于 RootService 自动容灾任务,TRUE 表示由运维命令触发。人工任务先查变更单和执行人;自动任务先查它为什么被调度,不要在任务进行中又发一条冲突的成员变更。
1-- root@sys;阈值示例 10 分钟,按现场任务规模调整2SELECT TENANT_ID, LS_ID, TASK_ID, TASK_TYPE,3 TASK_STATUS, MODIFY_TIME4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 10026 AND MODIFY_TIME < DATE_SUB(NOW(), INTERVAL 10 MINUTE)7ORDER BY MODIFY_TIME;这只筛出值得排查的任务,不能证明它们一定卡死。副本全量迁移可能本来就很久;结合任务状态、目标节点磁盘和同一 TASK_ID 的事件记录,判断是否真的没有进展。
1-- root@sys;TASK_ID 换成现场值2SELECT TASK_ID, TASK_EXEC_SVR_IP,3 TASK_EXEC_SVR_PORT, START_TIME, MODIFY_TIME4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 1002 AND LS_ID = 10016 AND TASK_ID = 'task_id_from_previous_query';后续查服务器事件与 observer.log 要到任务执行节点,而不是只去 Leader 节点。执行节点字段为空时,先判断任务是否尚未调度、是否已进入结束阶段,再看 RootService 记录。
1-- root@sys;地址来自第 2 条或副本任务2SELECT SVR_IP, SVR_PORT, ZONE, STATUS,3 START_SERVICE_TIME, STOP_TIME4FROM oceanbase.DBA_OB_SERVERS5WHERE SVR_IP = '10.0.0.11';STATUS=ACTIVE 还要结合 START_SERVICE_TIME、STOP_TIME 看是否真正对外服务。目标节点没起来时,先处理节点问题;反复触发 LS 迁移只会叠加任务。地址也应对 RPC 端口,不要把 SQL 端口当副本端口。
1-- root@sys2SELECT s.LS_ID, s.SVR_IP, s.SVR_PORT,3 n.ZONE, n.STATUS, s.ROLE, s.IN_SYNC4FROM oceanbase.GV$OB_LOG_STAT AS s5LEFT JOIN oceanbase.DBA_OB_SERVERS AS n6 ON n.SVR_IP = s.SVR_IP AND n.SVR_PORT = s.SVR_PORT7WHERE s.TENANT_ID = 1002 AND s.LS_ID = 10018ORDER BY n.ZONE, s.SVR_IP;先看异常副本是不是集中在同一 Zone 或同一节点;这比只数 IN_SYNC=NO 更容易区分局部节点故障与 LS 自身问题。没有匹配到节点信息时,检查端口和当前节点元数据,不要直接认为该副本已经不存在。
1-- root@sys;事件属性以实际 NAME1/NAME2 对照2SELECT TIMESTAMP, SVR_IP, SVR_PORT,3 EVENT, NAME3, VALUE3, NAME4, VALUE44FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY5WHERE MODULE = 'ELECTION'6 AND VALUE1 = '1002' AND VALUE2 = '1001'7ORDER BY TIMESTAMP DESC LIMIT 30;多次无主或 Leader 抖动时,顺时间看选举事件的节点、提案和原因。VALUE1/2 是事件的通用属性槽位,先核对 NAME1/2 是否真是 tenant_id、ls_id;不同事件不能不看名称就套过滤条件。
1-- root@sys;只取最近记录,避免扫整份事件历史2SELECT TIMESTAMP, MODULE, EVENT,3 NAME1, VALUE1, NAME2, VALUE2,4 NAME5, VALUE5, NAME6, VALUE65FROM oceanbase.DBA_OB_ROOTSERVICE_EVENT_HISTORY6WHERE MODULE LIKE '%disaster%'7ORDER BY TIMESTAMP DESC LIMIT 50;RootService 记录的是任务为什么被安排、源和目标怎么选。先用 NAME* 辨认每个 VALUE* 对应的属性,再按 TENANT_ID/LS_ID/TASK_ID 找第 11 条的任务;不要只凭某个 VALUE6 非零就猜任务失败。
1-- root@sys;任务 ID 来自第 11 条2SELECT TIMESTAMP, SVR_IP, SVR_PORT,3 MODULE, EVENT, NAME5, VALUE5,4 NAME6, VALUE6, EXTRA_INFO5FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY6WHERE VALUE5 = 'task_id_from_previous_query'7ORDER BY TIMESTAMP LIMIT 100;官方示例里副本任务 ID 放在 VALUE5,但字段仍是通用属性;先确认 NAME5='task_id'。按时间线看 storage_ha 开始、复制、收尾事件,比只盯着任务表的 INPROGRESS 更能找到卡住的环节。
1-- root@sys;同一任务下筛选失败标记2SELECT TIMESTAMP, SVR_IP, EVENT,3 NAME6, VALUE6, EXTRA_INFO4FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY5WHERE VALUE5 = 'task_id_from_previous_query'6 AND NAME6 = 'is_failed' AND VALUE6 = '1'7ORDER BY TIMESTAMP;看第一个失败步骤以及之后是否已经重试成功。没有 is_failed=1 记录不代表任务完全成功:也可能事件尚未写入、任务还没真正执行,需与任务状态和 RootService 记录对照。
1-- root@sys;地址用第 12 条目标副本节点替换2SELECT TIMESTAMP, EVENT, NAME1, VALUE1,3 NAME2, VALUE2, NAME5, VALUE54FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY5WHERE SVR_IP = '10.0.0.12'6 AND MODULE = 'storage_ha'7ORDER BY TIMESTAMP DESC LIMIT 50;同一节点若多条 LS 的复制任务都受影响,应优先查这个 OBServer 的磁盘、网络和服务状态;只修一条 LS 的任务通常解决不了共同原因。事件 VALUE* 的含义仍要看同列 NAME*。
1-- root@sys;两个地址来自第 12 条2SELECT SVR_IP, SVR_PORT, ZONE,3 STATUS, START_SERVICE_TIME, STOP_TIME4FROM oceanbase.DBA_OB_SERVERS5WHERE SVR_IP IN ('10.0.0.12', '10.0.0.13')6ORDER BY SVR_IP;迁移慢或重建停住,数据源和目标都要看。源节点能读不代表目标有足够日志盘或数据盘容量;在线状态只是第一关,空间和任务事件要继续核对。
1-- root@sys;统计窗口示例为最近 1 小时2SELECT SVR_IP, SVR_PORT, EVENT, COUNT(*) AS event_count3FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY4WHERE MODULE = 'ELECTION'5 AND TIMESTAMP >= DATE_SUB(NOW(), INTERVAL 1 HOUR)6GROUP BY SVR_IP, SVR_PORT, EVENT7ORDER BY event_count DESC;这是把选举抖动定位到节点的粗筛,不是“超过多少次就故障”的固定阈值。高频节点再回到第 18 条按 LS_ID 和时间线查看,避免把其他租户的正常选举算到本租户。
1-- root@sys;任务 ID 来自第 11 条2SELECT TENANT_ID, LS_ID, TASK_ID,3 TASK_STATUS, MODIFY_TIME4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 10026 AND TASK_ID = 'task_id_from_previous_query';任务从“运行中”表消失,只说明这里不再记录它。V4.3.3 可以接着查 CDB_OB_LS_REPLICA_TASK_HISTORY 的状态和结果,再用 RootService、OBServer 事件与最终副本位置核对;不能把任务消失直接当成成功。若它一直在表中且 MODIFY_TIME 不更新,把第 20—22 条的事件和执行节点日志一起留存。
1-- root@sys2SELECT TENANT_ID, TENANT_NAME,3 LOCALITY, PRIMARY_ZONE, STATUS4FROM oceanbase.DBA_OB_TENANTS5WHERE TENANT_ID = 1002;LOCALITY 是租户副本分布的目标约束,PRIMARY_ZONE 是 Leader 优先位置;都不是“当前这条 LS 实际在哪台节点”的实时结果。先记录目标布局,再和 LS 副本落点对比。
1-- root@sys2SELECT l.LS_ID, l.PRIMARY_ZONE,3 s.SVR_IP AS LEADER_IP, n.ZONE AS LEADER_ZONE4FROM oceanbase.CDB_OB_LS AS l5JOIN oceanbase.GV$OB_LOG_STAT AS s6 ON s.TENANT_ID = l.TENANT_ID AND s.LS_ID = l.LS_ID7 AND s.ROLE = 'LEADER'8LEFT JOIN oceanbase.DBA_OB_SERVERS AS n9 ON n.SVR_IP = s.SVR_IP AND n.SVR_PORT = s.SVR_PORT10WHERE l.TENANT_ID = 100211ORDER BY l.LS_ID;Leader 不在首选 Zone,可能是故障切换或暂时均衡,不应立刻当成无主。先确认该 Zone 是否仍有可用副本、租户 Locality 是否满足,再结合选举事件判断是否需要处理。
1-- root@sys;地址来自第 12 条目标节点2SELECT SVR_IP, SVR_PORT, ZONE,3 LOG_DISK_CAPACITY, LOG_DISK_ASSIGNED,4 LOG_DISK_IN_USE5FROM oceanbase.GV$OB_SERVERS6WHERE SVR_IP = '10.0.0.12';三项都是字节,但各自意义不同:总容量、Unit 已分配额度和实际日志占用。准备加副本或迁移时,两类剩余空间都要看;不能只看操作系统磁盘 df,忽略 OceanBase 可用的日志盘配额。
1-- root@sys;单位转为 GiB2SELECT SVR_IP,3 ROUND((LOG_DISK_CAPACITY - LOG_DISK_ASSIGNED)4 / 1024 / 1024 / 1024, 2) AS allocatable_log_gib,5 ROUND((LOG_DISK_CAPACITY - LOG_DISK_IN_USE)6 / 1024 / 1024 / 1024, 2) AS physical_log_gib7FROM oceanbase.GV$OB_SERVERS8WHERE SVR_IP = '10.0.0.12';allocatable_log_gib 决定还能给 Unit 分多少额度,physical_log_gib 反映实际使用余量。两者不能互换;若前者不足,副本落点/Unit 规格方案需要调整,即使物理盘暂时还有空也不够。
1-- root@sys2SELECT SVR_IP, ZONE, DATA_DISK_HEALTH_STATUS,3 DATA_DISK_CAPACITY, DATA_DISK_IN_USE,4 DATA_DISK_ABNORMAL_TIME5FROM oceanbase.GV$OB_SERVERS6WHERE SVR_IP = '10.0.0.12';副本添加、重建不仅需要日志盘,也会写数据盘。健康状态 WARNING/ERROR 或近期异常记录出现时,先处理节点存储问题,再考虑把新副本放上去;空间够不代表磁盘健康。
1-- root@sys;阈值 20 GiB 为示例,按副本规模调整2SELECT SVR_IP, SVR_PORT, ZONE,3 ROUND((LOG_DISK_CAPACITY - LOG_DISK_ASSIGNED)4 / 1024 / 1024 / 1024, 2) AS free_log_gib5FROM oceanbase.GV$OB_SERVERS6WHERE ZONE = 'zone2'7 AND LOG_DISK_CAPACITY - LOG_DISK_ASSIGNED8 < 20 * 1024 * 1024 * 10249ORDER BY free_log_gib;这条是扩副本前的容量粗筛,不是固定报警阈值。副本实际需要的额度取决于租户 Unit 规格、现有落点和任务类型;Zone 内所有候选节点都不足时,不要直接发添加副本命令碰碰运气。
1-- root@sys2SELECT TENANT_ID, UNIT_ID, ZONE, SVR_IP, SVR_PORT,3 STATUS4FROM oceanbase.GV$OB_UNITS5WHERE TENANT_ID = 10026 AND SVR_IP = '10.0.0.12'7ORDER BY UNIT_ID;LS 副本要落在租户有资源位置的 OBServer 上。目标地址若没有对应 Unit,先核对资源池/Unit 的 Zone 布局;仅仅节点在线、磁盘有空,不能保证该租户副本能迁进去。
1-- root@sys;把目标 LS 的副本与服务器空间关联2SELECT s.LS_ID, s.SVR_IP, s.ROLE, s.IN_SYNC,3 ROUND((n.LOG_DISK_CAPACITY - n.LOG_DISK_IN_USE)4 / 1024 / 1024 / 1024, 2) AS log_disk_free_gib,5 n.DATA_DISK_HEALTH_STATUS6FROM oceanbase.GV$OB_LOG_STAT AS s7JOIN oceanbase.GV$OB_SERVERS AS n8 ON n.SVR_IP = s.SVR_IP AND n.SVR_PORT = s.SVR_PORT9WHERE s.TENANT_ID = 1002 AND s.LS_ID = 100110ORDER BY s.ROLE, s.SVR_IP;若落后的副本恰好集中在日志盘余量低或数据盘异常的节点,先排除存储瓶颈。单次空间快照不能证明磁盘就是复制延迟根因,还要结合日志位点变化和节点事件时间线。
1-- root@sys;资源池记录的租户 ID 与目标租户一致2SELECT RESOURCE_POOL_ID, NAME, TENANT_ID,3 UNIT_COUNT, UNIT_CONFIG_ID,4 ZONE_LIST, REPLICA_TYPE5FROM oceanbase.DBA_OB_RESOURCE_POOLS6WHERE TENANT_ID = 10027ORDER BY NAME;资源池的 ZONE_LIST 和副本类型,是判断目标 Zone 是否有租户资源布局的第一份配置。UNIT_COUNT 不能当成当前某条 LS 的副本数;第 32 条实际 Unit 落点、第 5 条实际副本清单要分别核对。资源池记录和租户 Locality 不一致时,先查资源变更过程。
1-- root@sys2SELECT ZONE, COUNT(*) AS unit_count,3 COUNT(DISTINCT SVR_IP) AS server_count4FROM oceanbase.GV$OB_UNITS5WHERE TENANT_ID = 10026GROUP BY ZONE7ORDER BY ZONE;资源池说“覆盖 zone2”,不等于目标节点上已有 Unit。这里数出租户在每个 Zone 的实际落点,和第 34 条计划配置对照;同一 Zone 的 Unit 数与某条 LS 的 Paxos 副本数也不是同一个概念。
1-- root@sys;先用第 34 条确认 UNIT_CONFIG_ID2SELECT p.NAME AS pool_name,3 c.NAME AS unit_config_name,4 c.LOG_DISK_SIZE, c.MEMORY_SIZE,5 c.MIN_CPU, c.MAX_CPU6FROM oceanbase.DBA_OB_RESOURCE_POOLS AS p7JOIN oceanbase.DBA_OB_UNIT_CONFIGS AS c8 ON c.UNIT_CONFIG_ID = p.UNIT_CONFIG_ID9WHERE p.TENANT_ID = 1002;第 28、29 条看节点日志盘总量与剩余额度;这里看租户 Unit Config 预计要占多少日志盘。若目标节点可分配额度小于规格,先改资源布局方案,不能只因操作系统磁盘空闲就安排副本迁移。CPU、内存也要留余量。
1-- root@sys;zone2 为准备承接副本的 Zone2SELECT u.UNIT_ID, u.ZONE,3 u.SVR_IP, u.SVR_PORT,4 u.STATUS AS unit_status,5 s.STATUS AS server_status,6 s.DATA_DISK_HEALTH_STATUS7FROM oceanbase.GV$OB_UNITS AS u8JOIN oceanbase.GV$OB_SERVERS AS s9 ON s.SVR_IP = u.SVR_IP10 AND s.SVR_PORT = u.SVR_PORT11WHERE u.TENANT_ID = 100212 AND u.ZONE = 'zone2'13ORDER BY u.SVR_IP, u.UNIT_ID;有 Unit 的节点才进入候选名单,再看 OBServer 服务状态和数据盘健康。Unit 状态与 OBServer 状态来自两张不同视图;任何一侧异常,都不应直接发副本任务。这里尚未检查同一台节点是否已有该 LS 副本,要和第 5 条对照。
1-- root@sys;把 LS_ID 换成报障日志流2SELECT s.LS_ID, n.ZONE,3 COUNT(*) AS replica_rows,4 SUM(s.ROLE = 'LEADER') AS leader_rows,5 SUM(s.IN_SYNC = 'YES') AS in_sync_rows6FROM oceanbase.GV$OB_LOG_STAT AS s7JOIN oceanbase.GV$OB_SERVERS AS n8 ON n.SVR_IP = s.SVR_IP9 AND n.SVR_PORT = s.SVR_PORT10WHERE s.TENANT_ID = 100211 AND s.LS_ID = 100112GROUP BY s.LS_ID, n.ZONE13ORDER BY n.ZONE;这是实际节点上的 Palf 状态行数,不是 Locality 配置。若某 Zone 完全没有可用副本,先看第 26 条目标分布及第 34、35 条资源落点;IN_SYNC 读数还需结合位点差和连续取样。不能把 replica_rows 直接叫做 Paxos 投票成员数。
1-- root@sys;这里仅做候选节点粗筛,不发迁移任务2SELECT u.UNIT_ID, u.SVR_IP, u.SVR_PORT,3 ROUND((s.LOG_DISK_CAPACITY - s.LOG_DISK_ASSIGNED)4 / 1024 / 1024 / 1024, 2) AS allocatable_log_gib,5 s.DATA_DISK_HEALTH_STATUS6FROM oceanbase.GV$OB_UNITS AS u7JOIN oceanbase.GV$OB_SERVERS AS s8 ON s.SVR_IP = u.SVR_IP9 AND s.SVR_PORT = u.SVR_PORT10WHERE u.TENANT_ID = 100211 AND u.ZONE = 'zone2'12ORDER BY allocatable_log_gib DESC;第 37 条确认节点与 Unit 状态,这里把第 29 条可分配日志盘额度接进候选列表。排序靠前也不等于一定可落副本:Unit Config 规格、已有同一 LS 副本、Locality 和任务冲突都要再核对。用途是缩小候选范围,不是自动选目标节点。
1-- root@业务租户,MySQL 模式;不是 root@sys2SELECT LS_ID, SVR_IP, SVR_PORT,3 ZONE, ROLE, REPLICA_TYPE, REBUILD4FROM oceanbase.DBA_OB_LS_LOCATIONS5WHERE LS_ID = 10016ORDER BY ZONE, SVR_IP;前面 GV$OB_LOG_STAT 看节点瞬时 Palf 状态,这里从业务租户字典读副本布局。REPLICA_TYPE 区分全功能与只读等副本,不能拿行数直接算 Paxos 多数派;REBUILD 帮助识别正在重建的落点。副本任务窗口里两套读数短时不一致,要带时间复查。
1-- root@业务租户,MySQL 模式2SELECT LS_ID, SVR_IP, SVR_PORT,3 MEMBER_LIST, PAXOS_REPLICA_NUMBER,4 LEARNER_LIST5FROM oceanbase.DBA_OB_LS_LOCATIONS6WHERE LS_ID = 10017 AND ROLE = 'LEADER';MEMBER_LIST 是 Leader 记录的成员地址,PAXOS_REPLICA_NUMBER 是配置副本数,LEARNER_LIST 单列只读成员。将它与第 5 条 Palf 成员配置对照;若正迁移或加副本,先看任务进行到哪一步,不能仅凭一次清单差异立即补发成员变更。
1-- root@业务租户,MySQL 模式2SELECT LS_ID, REPLICA_TYPE,3 COUNT(*) AS location_rows,4 SUM(ROLE = 'LEADER') AS leader_rows5FROM oceanbase.DBA_OB_LS_LOCATIONS6GROUP BY LS_ID, REPLICA_TYPE7ORDER BY LS_ID, REPLICA_TYPE;这张清单适合找哪条 LS 的布局与其他 LS 不一样。location_rows 是视图中的副本位置条数,不是有效投票数;要判断写入多数派,仍看第 5、41 条成员清单和副本在线状态。只读副本也可能使总行数高于 Paxos 配置数。
1-- root@业务租户,MySQL 模式2SELECT LS_ID, SVR_IP, SVR_PORT,3 ZONE, REPLICA_TYPE, REBUILD,4 MODIFY_TIME5FROM oceanbase.DBA_OB_LS_LOCATIONS6WHERE REBUILD = 'TRUE'7ORDER BY LS_ID, MODIFY_TIME;标记为重建的副本要与第 11—15 条任务和第 20—22 条执行事件对号。这个标记不是复制进度百分比;如果同一位置长期不变,要看任务 ID、数据源、节点空间和日志。不同版本的布尔展示形式需在现场回读确认,不能靠空结果断定没有重建。
1-- root@业务租户,MySQL 模式2SELECT LS_ID, SVR_IP, SVR_PORT,3 ZONE, ROLE, CREATE_TIME,4 MODIFY_TIME5FROM oceanbase.DBA_OB_LS_LOCATIONS6WHERE LS_ID = 10017ORDER BY MODIFY_TIME DESC;副本迁移后,位置变化时间有助于将字典状态和 RootService 任务时间线对齐。MODIFY_TIME 不是日志复制进度更新时间;位置没变而 GV$OB_LOG_STAT 位点继续追赶,并不矛盾。结果应与任务的 MODIFY_TIME 分开记。
1-- root@业务租户,MySQL 模式2SELECT LS_ID, SVR_IP,3 SVR_PORT AS rpc_port,4 SQL_PORT AS sql_port,5 ZONE, ROLE6FROM oceanbase.DBA_OB_LS_LOCATIONS7WHERE LS_ID = 10018ORDER BY SVR_IP;排节点网络或副本任务时用的是 OBServer/RPC 地址;业务连库则走 SQL 端口。两种端口混用,会把副本心跳或 Palf 复制误判成业务连接可达性问题。拿这份位置记录对照节点监控、网络策略与第 16 条服务器信息。
1-- root@sys;检查所有目标租户 LS,异常结果需复采2SELECT LS_ID,3 SUM(ROLE = 'LEADER') AS leader_rows,4 COUNT(*) AS observed_rows5FROM oceanbase.GV$OB_LOG_STAT6WHERE TENANT_ID = 10027GROUP BY LS_ID8HAVING leader_rows <> 19ORDER BY LS_ID;第 3 条找没有 Leader 的 LS,这条连本次快照出现多条 Leader 记录的情况也筛出。选举期间全局视图可能并非严格同一时刻采样;先连取两次,再对照 PROPOSAL_ID、节点状态和选举事件。不能凭一次 leader_rows 就宣布脑裂。
1-- root@sys2SELECT LS_ID,3 COUNT(DISTINCT CONFIG_VERSION) AS version_count,4 COUNT(*) AS observed_rows5FROM oceanbase.GV$OB_LOG_STAT6WHERE TENANT_ID = 10027GROUP BY LS_ID8HAVING version_count > 19ORDER BY version_count DESC, LS_ID;第 10 条对单条 LS 看每个副本版本,这条适合先筛全租户。正在加、迁、删副本时短时版本不齐不奇怪;如果任务已结束却一直不收敛,再回第 11、20 条找任务和事件。CONFIG_VERSION 是带 proposal/config_seq 的文本,这里只统计是否一致,不用字符串排序判断先后;版本差也不是复制延迟秒数。
1-- root@sys;LSN 差是位点差,不是时间延迟2SELECT f.LS_ID, f.SVR_IP,3 l.SVR_IP AS leader_ip,4 l.END_LSN AS leader_end_lsn,5 f.END_LSN AS follower_end_lsn,6 l.END_LSN - f.END_LSN AS end_lsn_gap7FROM oceanbase.GV$OB_LOG_STAT AS f8JOIN oceanbase.GV$OB_LOG_STAT AS l9 ON l.TENANT_ID = f.TENANT_ID10 AND l.LS_ID = f.LS_ID11 AND l.ROLE = 'LEADER'12WHERE f.TENANT_ID = 100213 AND f.ROLE <> 'LEADER'14ORDER BY end_lsn_gap DESC15LIMIT 30;第 7 条列出一条 LS 的各副本位点,这里先找差值较大的候选。END_LSN 是连续可消费位点,减出来的值不能直接写成“落后多少秒”;还要连续取样,确认副本是否正在追赶、Leader 是否稳定。只读副本与 Paxos Follower 也需分开看。
1-- root@sys2SELECT n.ZONE, s.LS_ID,3 COUNT(*) AS replica_rows,4 SUM(s.IN_SYNC <> 'YES') AS not_in_sync_rows5FROM oceanbase.GV$OB_LOG_STAT AS s6JOIN oceanbase.GV$OB_SERVERS AS n7 ON n.SVR_IP = s.SVR_IP8 AND n.SVR_PORT = s.SVR_PORT9WHERE s.TENANT_ID = 100210GROUP BY n.ZONE, s.LS_ID11HAVING not_in_sync_rows > 012ORDER BY not_in_sync_rows DESC, n.ZONE, s.LS_ID;第 6 条列具体不同步副本,这条看异常是否集中在同一 Zone。如果一个 Zone 多条 LS 同时落后,优先查该 Zone 的 OBServer、网络、日志盘和事件;也要确认是否有共同的写入高峰,不能把 Zone 聚集直接当成网络故障证据。
1-- root@sys;配置值仅取 Leader 记录2SELECT s.LS_ID, COUNT(*) AS observed_rows,3 MAX(CASE WHEN s.ROLE = 'LEADER'4 THEN s.PAXOS_REPLICA_NUM END)5 AS configured_paxos_replicas,6 SUM(s.IN_SYNC = 'YES') AS in_sync_rows7FROM oceanbase.GV$OB_LOG_STAT AS s8WHERE s.TENANT_ID = 10029GROUP BY s.LS_ID10ORDER BY s.LS_ID;观察到的行数包含本次视图呈现的各种日志副本,不能直接拿它减 PAXOS_REPLICA_NUM 判缺票。真要判断多数派,查第 5、41 条的成员清单、每个成员是否在线以及 Leader 状态;这里只先发现与平常布局明显不同的 LS。
1-- root@sys;租户 ID 换成现场值2SELECT TENANT_ID, UNIT_ID, ZONE, SVR_IP, SVR_PORT, STATUS3FROM oceanbase.GV$OB_UNITS4WHERE TENANT_ID = 10025 AND STATUS IN ('MIGRATING IN', 'MIGRATING OUT')6ORDER BY ZONE, UNIT_ID;Unit 正在迁入或迁出时,副本位置和资源占用也会变化。先把这些 Unit 与第 11 条副本任务对上,再决定是否安排新的迁移。
1-- root@sys2SELECT TENANT_ID, UNIT_ID, ZONE, SVR_IP, SVR_PORT, STATUS,3 LOG_DISK_SIZE, LOG_DISK_IN_USE4FROM oceanbase.GV$OB_UNITS5WHERE TENANT_ID = 10026 AND STATUS IN ('ERROR', 'MARK DELETING', 'WAIT GC', 'DELETING')7ORDER BY ZONE, UNIT_ID;ERROR 与正在删除的几个状态含义不同。准备把副本落到某节点时,先确认该节点的 Unit 是 NORMAL,再结合第 16 条看 OBServer 状态。
1-- root@sys;节点地址换成现场值2SELECT SVR_IP, SVR_PORT, ZONE, DATA_DISK_HEALTH_STATUS,3 DATA_DISK_ABNORMAL_TIME, DATA_DISK_IN_USE, DATA_DISK_CAPACITY4FROM oceanbase.GV$OB_SERVERS5WHERE SVR_IP = '10.0.0.12'6 AND SVR_PORT = 2882;第 30 条看当前健康状态,这条补上次异常时间。现在显示 NORMAL,也可能在重建任务失败时发生过抖动;继续核对节点事件和存储日志。
1-- root@sys2SELECT SVR_IP, SVR_PORT, ZONE,3 LOG_DISK_CAPACITY, LOG_DISK_ASSIGNED, LOG_DISK_IN_USE,4 LOG_DISK_CAPACITY - LOG_DISK_ASSIGNED AS unassigned_bytes,5 LOG_DISK_CAPACITY - LOG_DISK_IN_USE AS unused_bytes6FROM oceanbase.GV$OB_SERVERS7WHERE ZONE = 'zone2'8ORDER BY unassigned_bytes DESC;unassigned_bytes 用来估算还能给 Unit 分多少日志盘规格;unused_bytes 是当前物理空闲。两者不是一回事。安排新 Unit 前再核对第 36 条 Unit Config 的 LOG_DISK_SIZE。
1-- root@sys2SELECT ZONE, COUNT(*) AS unit_rows,3 SUM(LOG_DISK_SIZE) AS allocated_log_bytes,4 SUM(LOG_DISK_IN_USE) AS used_log_bytes5FROM oceanbase.GV$OB_UNITS6WHERE TENANT_ID = 10027GROUP BY ZONE8ORDER BY ZONE;这里看租户在各 Zone 分配了多少 Unit 日志盘规格、实际用了多少。unit_rows 不是 LS 副本数;副本布局仍以第 40 条为准。
1-- root@sys;租户 ID 换成现场值2SELECT LS_ID, COUNT(*) AS tablet_count3FROM oceanbase.CDB_OB_TABLET_TO_LS4WHERE TENANT_ID = 10025GROUP BY LS_ID6ORDER BY tablet_count DESC, LS_ID;CDB_OB_LS 看 LS 状态,这里看每条 LS 承载了多少 Tablet。故障 LS 的 Tablet 较多,可能影响较多表或分区;数量不是访问量,也不能据此估算业务损失。
1-- root@sys;LS_ID 换成异常日志流2SELECT TABLET_ID, LS_ID3FROM oceanbase.CDB_OB_TABLET_TO_LS4WHERE TENANT_ID = 10025 AND LS_ID = 10016ORDER BY TABLET_ID7LIMIT 50;先拿到 ID,再用表位置视图找对应对象。这里只取前 50 条用于排查,不能拿查询结果当完整 Tablet 清单。LS 自身若在迁移或删除,位置记录和节点运行状态可能暂时不同步。
1-- root@sys;库名、表名换成故障业务对象2SELECT DISTINCT TABLE_ID, TABLET_ID, LS_ID,3 PARTITION_NAME, SUBPARTITION_NAME4FROM oceanbase.CDB_OB_TABLE_LOCATIONS5WHERE TENANT_ID = 10026 AND DATABASE_NAME = 'appdb'7 AND TABLE_NAME = 'orders'8 AND TABLE_TYPE = 'USER TABLE'9ORDER BY LS_ID, TABLET_ID;同一个分区的多个副本会占多行,所以先去重。一个分区表可能分布在多条 LS;查出 LS_ID 后再对应第 2、40 条的日志状态与副本位置。只查表名容易撞到其他库的同名表,库名和租户 ID 要一起限定。
1-- root@sys;分区名换成现场值2SELECT TABLET_ID, LS_ID, PARTITION_NAME,3 ZONE, SVR_IP, SVR_PORT, ROLE, REPLICA_TYPE4FROM oceanbase.CDB_OB_TABLE_LOCATIONS5WHERE TENANT_ID = 10026 AND DATABASE_NAME = 'appdb'7 AND TABLE_NAME = 'orders'8 AND PARTITION_NAME = 'p202609'9ORDER BY LS_ID, ZONE, SVR_IP;业务如果只报一个分区的数据访问异常,这条能把分区、Tablet、LS 和各副本落点对上。ROLE 是位置视图中的角色,不代替 GV$OB_LOG_STAT 的实时选举和日志位点;副本迁移期间最好同时保存两套读数。
1-- root@sys;同表的多个分区和副本只计一次2SELECT DATABASE_NAME, COUNT(DISTINCT TABLE_ID) AS table_count3FROM oceanbase.CDB_OB_TABLE_LOCATIONS4WHERE TENANT_ID = 10025 AND LS_ID = 10016 AND TABLE_TYPE = 'USER TABLE'7GROUP BY DATABASE_NAME8ORDER BY table_count DESC, DATABASE_NAME;先知道影响可能落在哪些库,才方便通知业务方逐项验收。这里的表数不含索引表、LOB 辅助表,也不表示这些表都已经不可用;下一步还要按第 58 条列具体表名,并结合应用报错、租户连接和 LS 状态判断影响范围。
1-- root@sys;按 LS_ID 找具体对象2SELECT DISTINCT DATABASE_NAME, TABLE_NAME, TABLE_ID3FROM oceanbase.CDB_OB_TABLE_LOCATIONS4WHERE TENANT_ID = 10025 AND LS_ID = 10016 AND TABLE_TYPE = 'USER TABLE'7ORDER BY DATABASE_NAME, TABLE_NAME;第 60 条只有每个库的表数,这条给出表名。一个表的不同分区可能分布在不同 LS,查到它并不等于整张表不可访问;先把受影响分区和应用报错对起来。
1-- root@sys;库名、表名换成需要核对的业务表2SELECT LS_ID, COUNT(DISTINCT TABLET_ID) AS tablet_count3FROM oceanbase.CDB_OB_TABLE_LOCATIONS4WHERE TENANT_ID = 10025 AND DATABASE_NAME = 'appdb'6 AND TABLE_NAME = 'orders'7 AND TABLE_TYPE = 'USER TABLE'8GROUP BY LS_ID9ORDER BY LS_ID;副本位置会产生多行,必须按 TABLET_ID 去重。这样能看出同一张表是否还落在其他 LS;不能用 Tablet 数量推算业务访问比例。
1-- root@sys;节点 IP 换成异常 OBServer2SELECT DATABASE_NAME, COUNT(DISTINCT TABLE_ID) AS table_count3FROM oceanbase.CDB_OB_TABLE_LOCATIONS4WHERE TENANT_ID = 10025 AND SVR_IP = '10.0.0.11'6 AND TABLE_TYPE = 'USER TABLE'7GROUP BY DATABASE_NAME8ORDER BY table_count DESC, DATABASE_NAME;这条统计的是节点上存在副本的表。节点离线后,位置视图可能仍保留它的记录;实际可用性要看该表所在 LS 的其他副本是否正常、是否选出了 Leader。
1-- root@sys;确认节点和表名后再查2SELECT DISTINCT PARTITION_NAME, SUBPARTITION_NAME,3 TABLET_ID, LS_ID, REPLICA_TYPE4FROM oceanbase.CDB_OB_TABLE_LOCATIONS5WHERE TENANT_ID = 10026 AND DATABASE_NAME = 'appdb'7 AND TABLE_NAME = 'orders'8 AND SVR_IP = '10.0.0.11'9ORDER BY LS_ID, TABLET_ID;如果只有一部分分区报错,这里先找故障节点上的 Tablet,再按 LS_ID 查日志和其他副本。不要把“副本位于故障节点”直接写成“该分区丢失”。
1-- root@sys;Tablet ID 由第 57、59 或 64 条取得2SELECT TABLET_ID, LS_ID, ZONE, SVR_IP, SVR_PORT,3 ROLE, REPLICA_TYPE4FROM oceanbase.CDB_OB_TABLE_LOCATIONS5WHERE TENANT_ID = 10026 AND TABLET_ID = 2000017ORDER BY ZONE, SVR_IP, SVR_PORT;看同一 Tablet 的副本是否还分布在其他 Zone。位置记录只能说明副本布局;节点是否在线、Palf 日志是否追上、Leader 是否可服务,仍要回到第 2、6、16 条核实。
1-- root@sys;V4.3.3 起可查任务历史2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 CREATE_TIME, FINISH_TIME, EXECUTE_RESULT4FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY5WHERE TENANT_ID = 10026 AND LS_ID = 10017ORDER BY CREATE_TIME DESC8LIMIT 20;第 11、25 条只能看到仍在运行的任务。这里按 LS 找已结束的任务,先看 TASK_STATUS 和 EXECUTE_RESULT,再对照任务目标节点和最终副本位置;历史中有 COMPLETED 也不能代替业务访问验收。
1-- root@sys;TASK_ID 从运行表或事件记录取得2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 SOURCE_REPLICA_SVR_IP, SOURCE_REPLICA_SVR_PORT,4 TARGET_REPLICA_SVR_IP, TARGET_REPLICA_SVR_PORT,5 EXECUTE_RESULT, COMMENT6FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY7WHERE TENANT_ID = 10028 AND TASK_ID = 'YB42AC1E87D7-000639016D9D80C8-0-0';同一条 LS 可能连续发生多次任务,按 TASK_ID 才能把这次迁移与下一次自动调度分开。返回空行先核对任务是否仍在第 11 条的运行表,以及 ID、租户是否写对;不能直接说历史丢了。
1-- root@sys;时间范围按故障窗口调整2SELECT LS_ID, TASK_ID, TASK_TYPE,3 TASK_STATUS, FINISH_TIME, EXECUTE_RESULT4FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY5WHERE TENANT_ID = 10026 AND FINISH_TIME >= NOW() - INTERVAL 1 DAY7 AND TASK_STATUS IN ('FAILED', 'CANCELED')8ORDER BY FINISH_TIME DESC;先看结果码,再按任务 ID 查第 20—22 条的 RootService 和 OBServer 事件。CANCELED 可能是管理员取消,也可能是后续调度替换;不看 IS_MANUAL、COMMENT 和事件记录就给它定性,容易误判。
1-- root@sys;只统计目标租户2SELECT TASK_TYPE, TASK_STATUS,3 COUNT(*) AS task_count4FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY5WHERE TENANT_ID = 10026 AND CREATE_TIME >= NOW() - INTERVAL 1 DAY7GROUP BY TASK_TYPE, TASK_STATUS8ORDER BY task_count DESC, TASK_TYPE;如果副本任务频繁失败或取消,不要只处理最近一条。先看失败是否集中在某种类型,再按任务 ID、节点和执行结果追根因;数量是任务数,不是故障 LS 数。
1-- root@sys;IS_MANUAL 是历史任务的来源标志2SELECT IS_MANUAL, TASK_TYPE, TASK_STATUS,3 COUNT(*) AS task_count4FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY5WHERE TENANT_ID = 10026 AND LS_ID = 10017GROUP BY IS_MANUAL, TASK_TYPE, TASK_STATUS8ORDER BY IS_MANUAL, task_count DESC;同一条 LS 上人工迁移与自动补副本可能前后出现。IS_MANUAL 帮你区分任务来源,但人工操作的工单、目标节点和时间仍要与任务 ID 对上,不能把所有历史都归到一次维护里。
1-- root@sys;迁移副本只允许同 Zone2SELECT SVR_IP, SVR_PORT, ZONE, STATUS3FROM oceanbase.DBA_OB_SERVERS4WHERE (SVR_IP = '10.0.0.11' AND SVR_PORT = 2882)5 OR (SVR_IP = '10.0.0.12' AND SVR_PORT = 2882)6ORDER BY SVR_IP;两行应属于同一 Zone,并且目标节点应正常提供服务。跨 Zone 迁移不能靠这条 MIGRATE REPLICA 实现;先看租户 Locality 和副本规划,别把目的地址直接换到另一 Zone。
1-- root@sys;目标节点地址与第 71 条保持一致2SELECT UNIT_ID, TENANT_ID, ZONE, SVR_IP, SVR_PORT,3 STATUS4FROM oceanbase.GV$OB_UNITS5WHERE TENANT_ID = 10026 AND SVR_IP = '10.0.0.12'7 AND SVR_PORT = 2882;目标节点没有该租户可用 Unit,副本就没有合适的资源位置。即使有 Unit,还要按第 28—30 条确认日志盘和数据盘余量;这里只解决“能否落在这个节点”的第一层条件。
1-- root@sys;迁移目标不能已有相同 LS 副本2SELECT TENANT_ID, LS_ID, SVR_IP, SVR_PORT,3 ZONE, REPLICA_TYPE4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017 AND SVR_IP = '10.0.0.12'8 AND SVR_PORT = 2882;预期为空行。若已有副本,先弄清它是既有布局还是未完成任务留下的位置;不能再发同一 LS 到同一节点的迁移命令。
1-- root@sys;发新任务前查看运行中任务2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 SOURCE_REPLICA_SVR_IP, TARGET_REPLICA_SVR_IP4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 10026 AND LS_ID = 1001;如果已有迁移、加副本、改类型等任务,先按任务 ID 查进度,不能用再次提交来“催”系统。即使这里为空,也要结合第 66 条确认上一轮任务的结果和最终副本布局。
1-- root@sys;保留变更前的 Leader 与所有副本地址2SELECT LS_ID, ZONE, SVR_IP, SVR_PORT,3 ROLE, REPLICA_TYPE, REBUILD4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017ORDER BY ZONE, SVR_IP;这份结果要和任务 ID、执行时间一起留存。迁移结束后比对源副本是否离开、目标副本是否完整,不能只凭 ALTER SYSTEM 返回成功写维护结论。
1-- root@sys;变更命令,源/目标地址与租户名按现场核实2ALTER SYSTEM MIGRATE REPLICA3 LS = 10014 SOURCE = '10.0.0.11:2882'5 DESTINATION = '10.0.0.12:2882'6 TENANT = 'app_tenant';官方语法一次只迁一份副本,目标节点必须有可用 Unit 且没有这条 LS 的副本。先完成第 71—75 条和变更审批;任务执行期间不要给同一 LS 同时加副本、删副本或改 Paxos 成员数。这里不指定 DATA_SOURCE,由系统选可用数据源。
1-- root@sys;提交后立即按 LS 和目标节点查2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 TASK_EXEC_SVR_IP, TASK_EXEC_SVR_PORT,4 TARGET_REPLICA_SVR_IP, TARGET_REPLICA_SVR_PORT,5 MODIFY_TIME6FROM oceanbase.CDB_OB_LS_REPLICA_TASKS7WHERE TENANT_ID = 10028 AND LS_ID = 10019 AND TARGET_REPLICA_SVR_IP = '10.0.0.12';记下 TASK_ID,后续事件和历史结果都按这个 ID 追。若没查到,可能任务很快结束,也可能提交没有被接受;先查第 78 条的历史和实际副本位置,别重复执行第 76 条。
1-- root@sys;任务 ID 用第 77 条取得的值2SELECT TASK_ID, TASK_STATUS, FINISH_TIME,3 EXECUTE_RESULT, SOURCE_REPLICA_SVR_IP,4 TARGET_REPLICA_SVR_IP5FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY6WHERE TENANT_ID = 10027 AND TASK_ID = 'YB42AC1E87D7-000639016D9D80C8-0-0';COMPLETED 说明容灾任务完成,再按第 75 条重查副本布局和 Palf 日志。FAILED 则要看结果码、目标节点容量及第 20—22 条的执行事件,不能直接换个节点重试。
1-- root@sys;仅对已核实的运行中 ADD/MIGRATE 任务使用2ALTER SYSTEM CANCEL REPLICA TASK3 TASK_ID = 'YB42AC1E87D7-000639016D9D80C8-0-0'4 TENANT = 'app_tenant';只支持取消正在执行的加副本或迁移任务,不能拿它取消已完成任务或其他容灾操作。命令返回成功只表示 RootService 发出了取消请求;任务到后期可能无法真正取消,必须回读历史状态。
1-- root@sys;以历史结果为准2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 FINISH_TIME, EXECUTE_RESULT4FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY5WHERE TENANT_ID = 10026 AND TASK_ID = 'YB42AC1E87D7-000639016D9D80C8-0-0';历史中 TASK_STATUS = CANCELED 才能确认取消成功。如果仍是 COMPLETED 或 FAILED,按最终状态处理,并重新查副本位置;别因为第 79 条没有报错就按“已取消”通知业务。
1-- root@sys;转换前保存每份副本的位置和类型2SELECT REPLICA_TYPE, ZONE, SVR_IP, SVR_PORT,3 ROLE, REBUILD4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017ORDER BY REPLICA_TYPE, ZONE, SVR_IP;FULL 副本可以参与选主,READONLY 副本不能。要转换哪一份、转换后各 Zone 留下什么类型,先从实际落点列清楚;不能只按租户 Locality 推测现场已经满足配置。
1-- root@sys;成员变更前以 Leader 记录为准2SELECT LS_ID, SVR_IP, SVR_PORT,3 MEMBER_LIST, LEARNER_LIST,4 PAXOS_REPLICA_NUMBER5FROM oceanbase.CDB_OB_LS_LOCATIONS6WHERE TENANT_ID = 10027 AND LS_ID = 10018 AND ROLE = 'LEADER';MEMBER_LIST 与 LEARNER_LIST 要分开读。转换全功能副本为只读时,官方要求 PAXOS_REPLICA_NUM 相应减少 1,并保证修改后仍有多数派;现有成员数和可用性必须先核对。
1-- root@sys;目标租户名称和 Locality 一起留存2SELECT TENANT_ID, TENANT_NAME,3 LOCALITY, PRIMARY_ZONE4FROM oceanbase.DBA_OB_TENANTS5WHERE TENANT_ID = 1002;手工转换如果与租户 Locality 不一致,后续自动调度可能再把布局调整回去。先确认这次转换是修复偏差还是修改长期规划;长期规划变化另有租户配置流程,不能只执行一条副本命令。
1-- root@sys;转换类型前按目标 LS 查任务2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 SOURCE_REPLICA_TYPE, TARGET_REPLICA_TYPE4FROM oceanbase.CDB_OB_LS_REPLICA_TASKS5WHERE TENANT_ID = 10026 AND LS_ID = 1001;运行中还有迁移、加副本或成员数调整时,先查任务状态和目标。官方限制同一条 LS 的这些操作不能随意叠加;不能用新命令覆盖一个没有结束的任务。
1-- root@sys;节点地址应来自第 81 条2SELECT LS_ID, SVR_IP, SVR_PORT,3 ROLE, IN_SYNC, END_LSN, MAX_LSN4FROM oceanbase.GV$OB_LOG_STAT5WHERE TENANT_ID = 10026 AND LS_ID = 10017 AND SVR_IP = '10.0.0.11'8 AND SVR_PORT = 2882;这份副本若已经落后、正在重建或节点不稳定,先处理日志同步问题。副本类型转换不是修复 Palf 日志缺口的办法;转换期间也要把第 2、6 条的全 LS 状态一起观察。
1-- root@sys;变更示例仅适用于已确认从 3F 调整为 2F 的方案2ALTER SYSTEM MODIFY REPLICA3 LS = 10014 SERVER = '10.0.0.11:2882'5 REPLICA_TYPE = 'R'6 PAXOS_REPLICA_NUM = 27 TENANT = 'app_tenant';这会改变 Paxos 成员配置,不是“降低这份副本的读取优先级”。官方要求 3→2 每次只减 1、变更后仍能形成多数派,且 PAXOS_REPLICA_NUM 与 Leader 成员清单满足约束;第 81—85 条、Locality 方案、业务窗口和回退方案都要先确认。现场若不是 3F→2F,不能照抄数字。
1-- root@sys;按 LS 和目标副本地址取得 TASK_ID2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 SOURCE_REPLICA_TYPE, TARGET_REPLICA_TYPE,4 MODIFY_TIME5FROM oceanbase.CDB_OB_LS_REPLICA_TASKS6WHERE TENANT_ID = 10027 AND LS_ID = 10018 AND TARGET_REPLICA_SVR_IP = '10.0.0.11';提交第 86 条后记下任务 ID,不要因为命令立即返回就认为成员切换完成。目标副本地址和类型应与变更单一致;查询空行时按任务历史及最终落点查,不重复提交。
1-- root@sys;TASK_ID 换成第 87 条得到的值2SELECT TASK_ID, TASK_TYPE, TASK_STATUS,3 SOURCE_REPLICA_TYPE, TARGET_REPLICA_TYPE,4 FINISH_TIME, EXECUTE_RESULT5FROM oceanbase.CDB_OB_LS_REPLICA_TASK_HISTORY6WHERE TENANT_ID = 10027 AND TASK_ID = 'YB42AC1E87D7-000639016D9D80C8-0-0';历史中 TYPE TRANSFORM 已完成,才进入副本与成员清单的回读。若失败,保留结果码、RootService 事件和变更前布局;不能再试一个 PAXOS_REPLICA_NUM 数字碰碰运气。
1-- root@sys;与第 81 条同一条件,做前后对照2SELECT REPLICA_TYPE, ZONE, SVR_IP, SVR_PORT,3 ROLE, REBUILD4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017ORDER BY REPLICA_TYPE, ZONE, SVR_IP;目标地址应变为只读副本,同时其他全功能副本仍在预期 Zone。任务状态与位置记录不一致时,先等记录收敛、再看事件和节点 Palf 状态;不要把短时不一致当成又需要发变更命令。
1-- root@sys;查看新 Leader 记录的成员与法定成员数2SELECT LS_ID, SVR_IP, SVR_PORT,3 MEMBER_LIST, LEARNER_LIST,4 PAXOS_REPLICA_NUMBER5FROM oceanbase.CDB_OB_LS_LOCATIONS6WHERE TENANT_ID = 10027 AND LS_ID = 10018 AND ROLE = 'LEADER';与第 82 条相比,目标副本应从 Paxos 成员转入只读成员,成员数应与审批方案一致。还要查其余 FULL 副本的日志同步和业务写入;只看到数值从 3 变成 2,不等于转换期间业务没有受影响。
1-- root@sys;目标节点须持有 FULL 副本2SELECT LS_ID, ZONE, SVR_IP, SVR_PORT,3 ROLE, REPLICA_TYPE, REBUILD4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017 AND SVR_IP = '10.0.0.12'8 AND SVR_PORT = 2882;这里应看到正常的全功能副本。只读副本不能当 Leader;位置记录显示 FULL 后还要按第 92 条核对 Palf 同步,正在重建的副本不宜作为切换目标。
1-- root@sys;与现任 Leader 的位点同场比较2SELECT SVR_IP, SVR_PORT, ROLE,3 IN_SYNC, END_LSN, MAX_LSN,4 PROPOSAL_ID5FROM oceanbase.GV$OB_LOG_STAT6WHERE TENANT_ID = 10027 AND LS_ID = 10018ORDER BY ROLE, SVR_IP;目标副本应同步,且节点在线。保存这份变更前快照,切换后才能分辨正常任期变化与日志复制异常;单看 IN_SYNC 的一个值,不足以覆盖选举期间的波动。
1-- root@sys;地址与计划切换目标一致2SELECT SVR_IP, SVR_PORT, ZONE, STATUS,3 LOG_DISK_CAPACITY, LOG_DISK_IN_USE,4 DATA_DISK_HEALTH_STATUS5FROM oceanbase.GV$OB_SERVERS6WHERE SVR_IP = '10.0.0.12'7 AND SVR_PORT = 2882;计划把 Leader 切到哪台服务器,先确认那台服务器的服务状态与磁盘健康。网络问题需结合节点日志和业务连接测试;这里的磁盘、服务状态是切换前的基本检查。
1-- root@sys;变更示例,租户和 RPC 地址按现场替换2ALTER SYSTEM SWITCH REPLICA LEADER3 LS = 10014 SERVER = '10.0.0.12:2882'5 TENANT = 'app_tenant';只切目标租户的一条 LS,范围比按整台节点或整个 Zone 切换更容易控制。第 91—93 条确认目标副本、日志和节点后,再在维护窗口执行;活跃事务可能在 Leader 变更期间受到影响。此语法见 OceanBase 官方 4.1 与 4.6 文档,V4.3.3 终稿须再按目标版本核对。
1-- root@sys;与第 91 条的目标地址对照2SELECT TENANT_ID, LS_ID, ZONE,3 SVR_IP, SVR_PORT, ROLE4FROM oceanbase.CDB_OB_LS_LOCATIONS5WHERE TENANT_ID = 10026 AND LS_ID = 10017ORDER BY ROLE, ZONE, SVR_IP;新 Leader 应出现在预定节点,原 Leader 应转为 Follower。位置视图短时可能落后于选举状态;把第 96 条的 Palf 读数也保存下来再确认。
1-- root@sys;连续查两次,保留观察时间2SELECT SVR_IP, SVR_PORT, ROLE,3 PROPOSAL_ID, IN_SYNC,4 END_LSN, MAX_LSN5FROM oceanbase.GV$OB_LOG_STAT6WHERE TENANT_ID = 10027 AND LS_ID = 10018ORDER BY SVR_IP, SVR_PORT;这条看实时角色、提案任期和各副本日志位点。期望只有一个 Leader,其余副本继续同步;若 Leader 在节点间反复变化,就回查选举事件和节点网络,不把一次成功切换当成排障结束。
1-- root@sys;先按时间与 MODULE 取事件,再核对属性名称2SELECT TIMESTAMP, SVR_IP, SVR_PORT,3 EVENT, NAME1, VALUE1,4 NAME2, VALUE2, NAME3, VALUE35FROM oceanbase.DBA_OB_SERVER_EVENT_HISTORY6WHERE MODULE = 'ELECTION'7 AND TIMESTAMP >= NOW() - INTERVAL 30 MINUTE8ORDER BY TIMESTAMP DESC9LIMIT 50;事件属性用 NAME* 和 VALUE* 成对读,找到目标租户与 LS 的切换记录。若出现多次竞选、回切或选举失败,结合第 96 条任期变化还原顺序。
1-- root@sys;扫描本租户所有 LS,排除局部无主2SELECT l.LS_ID, l.STATUS3FROM oceanbase.CDB_OB_LS AS l4LEFT JOIN oceanbase.GV$OB_LOG_STAT AS s5 ON s.TENANT_ID = l.TENANT_ID6 AND s.LS_ID = l.LS_ID7 AND s.ROLE = 'LEADER'8WHERE l.TENANT_ID = 10029 AND s.LS_ID IS NULL10ORDER BY l.LS_ID;预期为空。手工只切一条 LS,但节点、Zone 或网络故障可能同时影响其他 LS;有结果先复查是否处于短暂选举窗口,再查对应 LS 的成员和日志。
1-- 连接 app_tenant 的业务账号;订单号须来自现场已知记录2SELECT order_id, created_at3FROM appdb.orders4WHERE order_id = 500001;用业务实际访问的库和表验证读请求,而不是只在 root@sys 看内部视图。表名、订单号和账号都应换成现场值;读成功还不能代替写入验证,写链路应由业务方按维护验收方案执行。
1-- root@sys;为工单保存最终 Leader 落点2SELECT LS_ID, ZONE, SVR_IP, SVR_PORT3FROM oceanbase.CDB_OB_LS_LOCATIONS4WHERE TENANT_ID = 10025 AND ROLE = 'LEADER'6ORDER BY LS_ID;和变更前的 Leader 清单对照,确认目标 LS 已转移、其他 LS 没有意外迁走。把任务结果、节点状态、Palf 同步和业务验收一并放进工单,后续出现回切也有基线可查。
OceanBase 的高可用排查要落实到具体 LS。先记下租户 ID、LS_ID 和当前 Leader,再对副本位置、Palf 位点、任务 ID 与节点事件。手工迁副本要检查同 Zone 的 Unit 和容量;改副本类型要先算 Paxos 成员数;切 Leader 后看实时角色、日志同步和业务访问。变更命令返回成功,只是回读的起点。
 ORA100 DBA100 命令系列海报
其他数据库的高可用与运维专题放在 ORA100 · DBA100:https://ora100.com/dba100
微信小程序搜索 「三笠的百令册」,也能查这套命令。