备份恢复 & 迁移30 分钟阅读
PostgreSQL 基础备份与 PITR 运维 100 条命令
PostgreSQL 的 PITR(时间点恢复)依赖两样东西:一份可用的基础备份,以及从备份开始直到目标时间点的 WAL。备份文件还在,并不等于能恢复;归档漏了一个文件,恢复就可能停在半路。
2026年9月16日阅读—点赞—收藏—
dba100postgresqlscenario
100 条命令系列文章专栏
PostgreSQL 的 PITR(时间点恢复)依赖两样东西:一份可用的基础备份,以及从备份开始直到目标时间点的 WAL。备份文件还在,并不等于能恢复;归档漏了一个文件,恢复就可能停在半路。
PostgreSQL 的 PITR(时间点恢复)依赖两样东西:一份可用的基础备份,以及从备份开始直到目标时间点的 WAL。备份文件还在,并不等于能恢复;归档漏了一个文件,恢复就可能停在半路。
这篇从备份前的检查写起,再看归档是否持续工作、基础备份是否完整,最后用隔离实例演练恢复。命令用到时可以直接翻,建议先收藏,也欢迎分享给负责备份的同事。
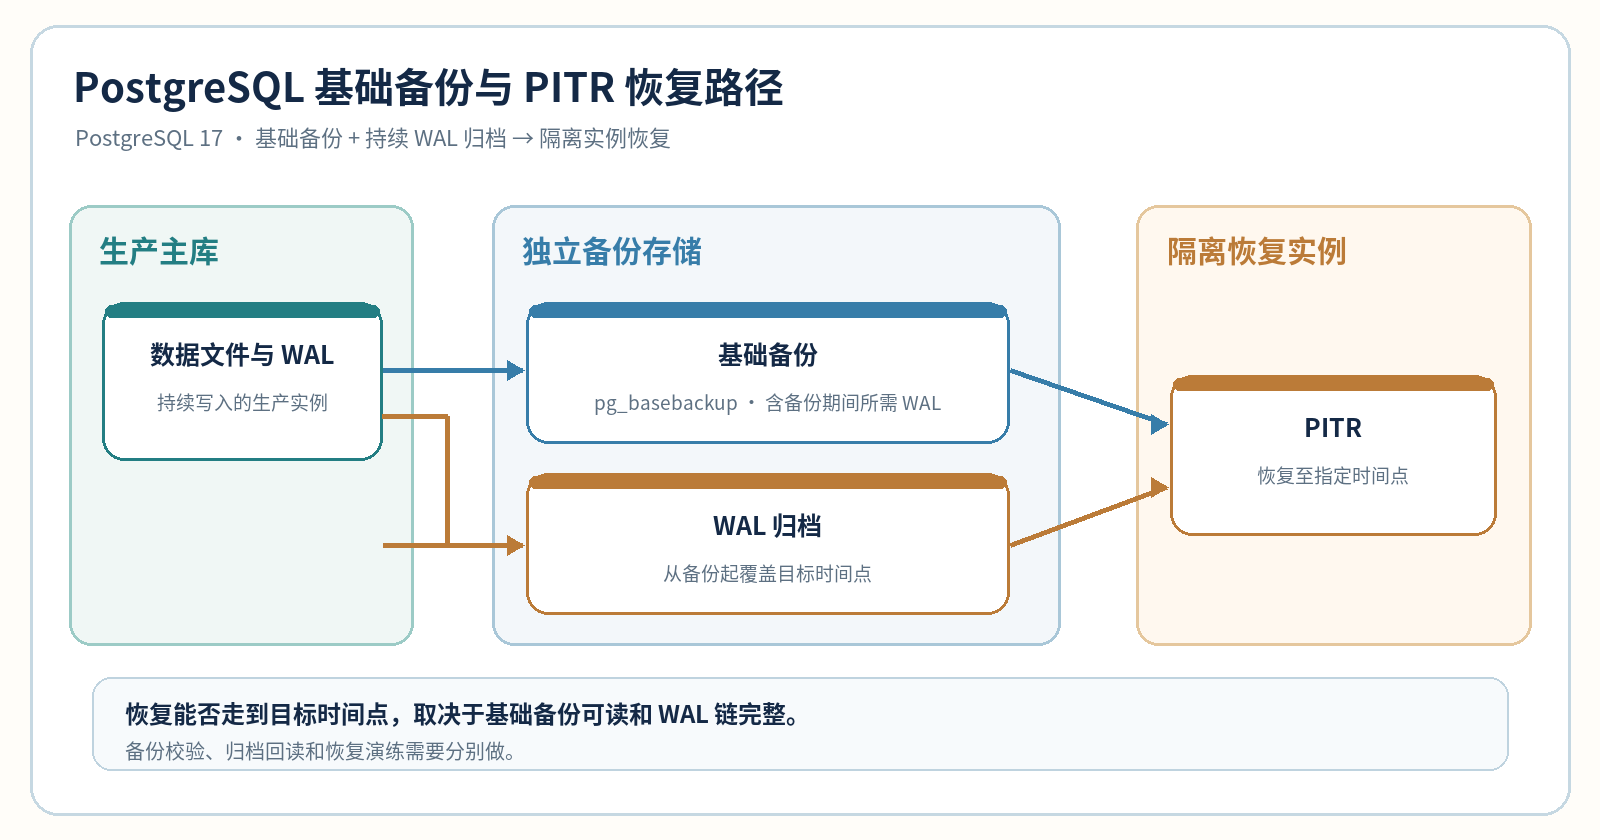 PostgreSQL 基础备份与 PITR 架构图
示例采用 PostgreSQL 17、Linux。库名、账号、备份目录和归档目录按现场修改;恢复演练使用独立实例,不能覆盖正在运行的数据库。下面的解包示例只适用于没有外部表空间的实例;有外部表空间时,先安排好每个表空间的独立恢复路径,再动手解包。
1SELECT version(), current_setting('data_directory') AS data_directory,2 pg_is_in_recovery() AS is_standby;基础备份和归档检查应先确定当前连接的是主库。pg_is_in_recovery() 为 true 时,当前实例处于恢复状态。
1SELECT name, setting, unit, source2FROM pg_settings3WHERE name IN ('wal_level', 'archive_mode', 'archive_command',4 'archive_library', 'archive_timeout')5ORDER BY name;PITR 需要持续保留 WAL。这里先确认 wal_level、归档开关和归档命令;archive_mode 的修改需要重启实例才能生效。
1SELECT archived_count, last_archived_wal, last_archived_time,2 failed_count, last_failed_wal, last_failed_time, stats_reset3FROM pg_stat_archiver;不要只看 archived_count。失败次数是否增长、最后成功归档的时间是否跟得上业务写入,更能说明归档是不是卡住了。统计自 stats_reset 起累计。
1SELECT pg_current_wal_lsn() AS current_lsn,2 pg_walfile_name(pg_current_wal_lsn()) AS current_wal_file;当前 WAL 文件通常还在写入,文件名出现在这里不代表它已归档。对照上一条的 last_archived_wal,确认归档是否持续推进。
1SELECT rolname, rolcanlogin, rolreplication2FROM pg_roles3WHERE rolname = 'backup_repl';pg_basebackup 连接主库需要具备复制权限的账号。只看到账号存在还不够,登录能力、pg_hba.conf 放行和连接测试也要核对。
1pg_basebackup -h pg-primary -U backup_repl \2 -D /backup/base/2026-09-15 -F tar -X stream -P目标目录必须不存在或为空。-X stream 同时收集备份期间需要的 WAL;目录应放在独立备份存储,不要只留在主库同一块磁盘上。使用表空间时,还要检查额外的表空间 tar 文件。
1SELECT pid, phase, backup_total, backup_streamed,2 tablespaces_total, tablespaces_streamed3FROM pg_stat_progress_basebackup;这张视图只展示正在运行的备份进程。结束后没有行是正常现象,不能据此判断这次备份是否成功;成功与否仍要看客户端退出状态、备份文件和后续校验。
1find /backup/base/2026-09-15 -maxdepth 1 -type f \2 \( -name '*.tar' -o -name 'backup_manifest' \) -printf '%f %s bytes\n'tar 格式备份至少应核对 base.tar、WAL tar 和 backup_manifest;有表空间时还会生成其他 tar。文件清单只是第一步,仍需解包、校验并实际恢复一次。
1find /backup/wal-archive -maxdepth 1 -type f -printf '%T@ %f\n' \2 | sort -nr | head -20看文件时间时要和数据库的 pg_stat_archiver 对照。归档命令返回成功,只表示命令按配置完成;备份端能否取回 WAL,还需要单独验证。
1find /backup/base/2026-09-15 -type f -printf '%P %s bytes\n' \2 | sort把文件清单和大小保存下来,便于后续交接与比较。它不能代替 pg_verifybackup 或恢复演练。
1tar -tf /backup/base/2026-09-15/base.tar | head -40确认这份包确实来自预期的基础备份,再检查包中有没有 backup_label 和数据目录文件。tar -tf 只列目录,不检查文件内容。
1tar -tf /backup/base/2026-09-15/pg_wal.tar | head -40本例使用 -F tar -X stream,备份期间的 WAL 写在单独的 pg_wal.tar 中。它保证这份基础备份启动所需的 WAL,但要恢复到更晚的时间,仍需要连续归档。
1install -d -m 700 /restore/pg17/data恢复目录必须为空,且与生产的 data_directory 不同。后面的命令由 PostgreSQL 软件属主执行;不要拿生产数据目录直接试。
1tar -xf /backup/base/2026-09-15/base.tar \2 -C /restore/pg17/data这一步只适用于上文限定的“没有外部表空间”示例。若原库有外部表空间,不能让备份中的链接指回生产路径,要先按 tablespace_map 安排恢复位置。
1install -d -m 700 /restore/pg17/data/pg_wal2tar -xf /backup/base/2026-09-15/pg_wal.tar \3 -C /restore/pg17/data/pg_wal不要把 pg_wal.tar 解到数据目录根下。pg_verifybackup 默认从 pg_wal 查找恢复这份基础备份所需的 WAL。
1cp /backup/base/2026-09-15/backup_manifest \2 /restore/pg17/data/backup_manifesttar 格式的 manifest 单独保存。校验工具默认读取数据目录根下的 backup_manifest;如果单独保管,也可以用 -m 指定路径。
1pg_verifybackup -P /restore/pg17/data使用与备份服务器主版本相同的 pg_verifybackup。它核对 manifest、文件大小与校验和,并解析这份备份恢复所需的 WAL。校验通过还不能证明指定时间点的所有后续归档都齐全,更不能代替真正启动一次恢复实例。
1sed -n '1,35p' /restore/pg17/data/backup_label恢复目标必须在基础备份结束之后。backup_label 能帮助识别备份,但目标时间仍应结合备份完成记录和实际事件时间核对;不要凭一个文件名猜恢复点。
1stat -c '%U %G %a %n' /restore/pg17/data \2 /restore/pg17/data/pg_wal \3 /restore/pg17/data/backup_manifest实例启动前把属主和权限检查一遍。恢复副本应由运行该 PostgreSQL 实例的账号持有;权限不对时先修复副本,不要改生产目录。
1cat >> /restore/pg17/data/postgresql.auto.conf <<'EOF'2restore_command = 'cp /backup/wal-archive/%f %p'3recovery_target_time = '2026-09-15 18:00:00+08'4recovery_target_action = 'pause'5listen_addresses = '127.0.0.1'6port = 554327archive_mode = 'off'8EOF这是隔离实例的示例配置,时间必须改成现场确认过的目标,且晚于基础备份结束时间。%f 是要取回的归档文件名,%p 是 PostgreSQL 要写入的路径;取不到文件时命令要返回非零。选择 pause 是为了先查看恢复点的数据,别让实例一到目标就直接进入读写状态。
1touch /restore/pg17/data/recovery.signalPostgreSQL 启动时看到 recovery.signal 才会按恢复配置读取归档。文件应建在隔离副本的数据目录,不是生产目录。
1postgres -D /restore/pg17/data -C recovery_target_time启动前先确认解析出的目标时间。若原备份带有 postgresql.auto.conf 或配置引用,追加后要核对最终生效值,避免被旧参数或重复项影响。
1pg_ctl -D /restore/pg17/data \2 -l /restore/pg17/recovery.log start示例端口在第 20 条设为 55432,并只监听本机。pg_ctl 返回后仍要查恢复日志和实际恢复状态;达到目标时间点可能还需要继续读取 WAL。
1pg_ctl -D /restore/pg17/data status这里只能确认进程状态。进程在,不代表归档链完整,也不代表已经恢复到目标时间。
1-- 连接隔离实例,端口 554322SELECT pg_is_in_recovery() AS recovering,3 pg_last_wal_replay_lsn() AS replay_lsn,4 pg_last_xact_replay_timestamp() AS last_xact_time;last_xact_time 是最后重放事务在原库的提交或回滚时间,不一定恰好等于设定的目标时间。还要检查恢复日志有没有报告缺失的 WAL 或尚未到达恢复目标。
1-- 连接隔离实例,端口 554322SELECT pg_get_wal_replay_pause_state() AS pause_state;返回 paused 才表示重放已经停住。pause requested 只是收到暂停请求,不能当成完成。此时在隔离实例核对关键表和业务记录,才知道选的恢复点是否合适。
1grep -E 'recovery stopping|recovery has paused|could not restore|requested WAL|FATAL|PANIC' \2 /restore/pg17/recovery.log | tail -50日志里的单次“取不到 .history 文件”未必是故障;要结合前后记录看实例最后是否到达目标。配置了目标却没读到目标所需 WAL,PostgreSQL 会报错并停止,不应把启动过一次算作演练成功。
1-- 连接隔离实例,端口 554322SELECT name, setting, source3FROM pg_settings4WHERE name IN ('restore_command', 'recovery_target_time',5 'recovery_target_action', 'recovery_target_inclusive',6 'recovery_target_timeline', 'port', 'listen_addresses')7ORDER BY name;这里读的是运行实例实际采用的配置,比只翻文件可靠。尤其要核对时间的 UTC 偏移、是否包含恰好落在目标时间的事务,以及当前沿哪条 timeline 恢复。
1find /backup/wal-archive -maxdepth 1 -type f \2 -name '*.history' -printf '%f %s bytes\n' | sort发生过 PITR 或切换后,归档里可能有多个 timeline。.history 文件记录分叉,恢复到指定分支时不能只保留 WAL 段而把它们删掉。
1-- 在生产主库执行2SELECT a.last_archived_wal, w.timeline_id, w.segment_number3FROM pg_stat_archiver AS a4CROSS JOIN LATERAL pg_split_walfile_name(a.last_archived_wal) AS w5WHERE a.last_archived_wal IS NOT NULL;WAL 文件名的前八位是 timeline ID。看数值前先确认拿的是正常 24 位 WAL 段名,而不是 .history 或备份历史文件;这条只分析最近一次成功归档的段。
1find /backup/wal-archive -maxdepth 1 -type f \2 -regextype posix-extended \3 -regex '.*/[0-9A-F]{24}' -printf '%f\n' | sort | tail -40用于把恢复日志请求的文件名和备份端实际保存的文件对上。清单连续“看起来没断”也不能证明 WAL 可解析;仍要靠恢复日志和实际重放来确认。
1-- 生产主库;确认有需要尽快归档的事务后执行2SELECT pg_switch_wal();归档只处理已完成的 WAL 段。若刚做完关键变更又要测试归档是否跟上,可手动切换;没有新 WAL 活动时它可能不产生新段。调用返回不代表目标存储已经写入,随后还要查归档状态和备份端文件。
1-- 在生产主库执行2SELECT last_archived_wal, last_archived_time,3 last_failed_wal, last_failed_time4FROM pg_stat_archiver;第 32 条之后不能马上拿这个结果下结论。等归档进程完成,再核对文件在独立备份端能读取;统计视图只是数据库这一侧的结果。
1-- 在生产主库执行;示例名称须保持唯一2SELECT pg_create_restore_point('before_release_20260915') AS restore_lsn;准备发布或批量修改时,命名恢复点比事后猜时间更明确。名称不要重复:恢复使用 recovery_target_name 时会停在首先匹配到的记录。恢复点也必须在选用的基础备份结束之后。
1-- 在生产主库执行;使用上一条返回的 LSN2SELECT pg_walfile_name('0/5000000'::pg_lsn) AS restore_point_wal;把上一条真实返回的 LSN 替换进来,记录对应 WAL 文件名。这个文件还要等待写满或切换后才会归档;若演练要恢复到该点,务必验证备份端能取回它和前面的完整链。
1# 备份端;文件名使用第 35 条的结果,仅读取2pg_waldump --path=/backup/wal-archive --limit=30 \3 000000010000000000000005pg_waldump 能确认归档段至少可被当前版本工具解析,也能看到附近记录的 LSN;它并不证明基础备份和整条归档链足够完成恢复。文件属于哪条 timeline,先从文件名前八位和 .history 核对。
1pg_waldump --rmgr=list取证时可以用 --rmgr 缩小输出,例如找事务提交、检查点记录。资源管理器列表应以当前 PostgreSQL 安装的工具输出为准,不要把一个版本的名称硬套到另一个版本。
1# 备份端;LSN 和段名来自实际恢复点记录2pg_waldump --path=/backup/wal-archive \3 --start=0/5000000 --end=0/5001000 \4 000000010000000000000005这条用于缩小恢复点附近的记录窗口。起止 LSN 要落在给定段可读的范围内;pg_waldump 只展示当前指定 timeline,跨时间线恢复必须分别查看各分支。
1# 备份端;例如恢复日志正在请求 timeline 22cat /backup/wal-archive/00000002.history.history 记录子 timeline 从父 timeline 的哪个位置分叉。看到目标分支的文件还不够,要确认基础备份所在时间线能沿这条历史记录走到目标点;若分叉早于基础备份,不能靠改 recovery_target_timeline 硬恢复。
1-- 连接隔离实例,端口 554322SELECT timeline_id, prev_timeline_id,3 redo_wal_file, checkpoint_lsn4FROM pg_control_checkpoint();控制文件里的当前/前一条 timeline、redo WAL 文件,要和基础备份、.history 及本次恢复日志对上。这是控制文件的检查点信息,未必等于刚刚重放的最新位置;最新重放仍看第 25 条。
1-- 连接隔离实例,端口 554322SELECT pg_is_in_recovery() AS still_in_recovery;到达恢复点并暂停时应仍在 recovery 状态。若返回 false,实例可能已经完成恢复并切出新时间线,不能再用“重放继续前进”判断这次演练;查恢复日志确认究竟是自动完成还是被人工提升。
1-- 连接隔离实例,端口 55432;仅在接收 WAL 的恢复实例有意义2SELECT pg_last_wal_receive_lsn() AS received_lsn,3 pg_last_wal_replay_lsn() AS replayed_lsn;若这份 PITR 副本只用 restore_command 从归档取 WAL、没有流复制接收,received_lsn 可能是 NULL。不能因此说归档没取到;看重放位置、日志里的取档记录与备份端文件更合适。
1-- 连接隔离实例;有流复制接收时才计算2SELECT pg_wal_lsn_diff(pg_last_wal_receive_lsn(),3 pg_last_wal_replay_lsn()) AS pending_bytes4WHERE pg_last_wal_receive_lsn() IS NOT NULL;这只是两个 LSN 的距离,不是“还差多少秒”。归档恢复通常没有 receive LSN,查询就无行;定位 PITR 是否到目标,应以目标配置、恢复日志和第 26 条的暂停状态为准。
1# 在解包后的基础备份目录;只读 manifest2python3 -c 'import json; p="/restore/pg17/data/backup_manifest"; m=json.load(open(p)); print(m["System-Identifier"]); print(m["WAL-Ranges"])'PostgreSQL 17 的 manifest 记录系统标识和基础备份一致性所需的 WAL 起止区间。它说的是让这份备份变成一致状态的最低需求,不包含恢复到更晚目标点所需的所有归档;还得结合目标时间和归档链核对。
1-- 连接隔离实例,端口 554322SELECT system_identifier, pg_control_last_modified3FROM pg_control_system();system_identifier 应和第 44 条 manifest 里的 System-Identifier 一致。若不一致,数据目录和归档可能来自不同集群,不能靠文件名看起来相同就继续恢复。
1-- 连接隔离实例,端口 554322SELECT min_recovery_end_lsn, min_recovery_end_timeline,3 backup_end_lsn, end_of_backup_record_required4FROM pg_control_recovery();这条查控制文件记载的基础备份恢复边界,适合核对备份结束记录是否被要求、最低恢复位置在哪条 timeline。它不是恢复演练“成功”的单独证明;目标时间、暂停状态和业务数据仍要核实。
1-- 仅在端口 55432 的隔离实例;确认目标数据已核对且准备结束 PITR2SELECT pg_wal_replay_resume();recovery_target_action=pause 达到目标后可以先查数据,再决定是否继续。调用这条会让恢复继续并结束当前目标恢复;若目标选错、还想改到更晚时间,应先停隔离实例、修改目标后重启,不能把恢复过头的实例再倒回去。
1-- 连接隔离实例,端口 554322SELECT pg_is_in_recovery() AS still_in_recovery,3 pg_last_wal_replay_lsn() AS last_replayed_lsn;结束目标恢复后应为 false;若仍为 true,先查日志和暂停状态,别把第 47 条返回成功当成已经完成。最后重放 LSN 留在记录里,方便跟当初选定的恢复点比对。
1# 只操作 /restore/pg17/data;停机前再次确认端口、数据目录2pg_ctl -D /restore/pg17/data stop -m fast -w隔离实例如已完成恢复,会成为可写的新分支。演练结束要停掉,避免它继续占用 55432 端口或被误接入业务。fast 会中断连接并安全关库;不要把示例目录替换成生产主库目录。
1pg_ctl -D /restore/pg17/data status第 49 条有返回值仍要看同一数据目录是否已经停止。若 pg_ctl status 仍报告在运行,不要删除恢复目录或复用端口;先查日志和进程归属,确保没有误停、误启别的实例。
前面的 tar 全备可以直接用于那次演练。增量备份要另外维护一条“全备—增量—合成全备”的依赖链;以下示例用 plain 格式,且假定没有额外表空间。若有表空间,必须配置独立映射目录,不能把备份写到生产表空间路径。
1-- 生产主库2SELECT name, setting, unit3FROM pg_settings4WHERE name IN ('summarize_wal', 'wal_summary_keep_time', 'wal_level')5ORDER BY name;PostgreSQL 17 增量备份依赖 WAL 摘要。summarize_wal=off 时不能临时拿旧全备 manifest 发起增量;wal_summary_keep_time 要覆盖两次备份之间的最长间隔。摘要不是 WAL 归档,两者都要保留。
1-- 生产主库2SELECT summarized_tli, summarized_lsn,3 pending_lsn, summarizer_pid4FROM pg_get_wal_summarizer_state();摘要进程在跑但 summarized_lsn 长时间不动,先查日志和 WAL 设置。这个位置只能表示摘要处理进度;增量是否能做,还得对照参考全备的起始 LSN 和实际保存的摘要区间。
1-- 生产主库2SELECT tli, start_lsn, end_lsn3FROM pg_available_wal_summaries()4ORDER BY tli, start_lsn;参考全备以来的 WAL 必须有连续的摘要区间,否则增量备份会失败。时间线发生分叉时尤其要核对 tli;摘要文件不能代替原始 WAL,也不能作为 PITR 恢复输入。
1# 备份端;目录须为空;无额外表空间或已按现场映射2pg_basebackup -h pg-primary.example.com -U backup_user \3 -D /backup/pg17/full-20260915 -Fp -X stream \4 --manifest-checksums=SHA256 --progress这份全备的 backup_manifest 后面要用作增量参考。-X stream 收集备份期间所需 WAL,但恢复到更晚时刻仍依赖持续归档。不要在生产数据目录旁边复用同名路径;先做文件校验再交付备份仓库。
1# 备份端;使用同版本 PostgreSQL 17 工具2pg_verifybackup /backup/pg17/full-20260915先检查全备的数据文件、manifest 以及备份期间所需 WAL。校验通过也只证明当前目录的静态完整性;后续恢复到更晚时间仍要检查持续归档。全备已被增量引用后,不能因为有一份较新的增量就删除它。
1# 备份端;参考全备和其依赖的 WAL 摘要仍在,目标目录须为空2pg_basebackup -h pg-primary.example.com -U backup_user \3 -D /backup/pg17/inc-20260916 -Fp -X stream \4 --incremental=/backup/pg17/full-20260915/backup_manifest \5 --manifest-checksums=SHA256 --progress增量文件不能直接拿去启动数据库。摘要区间缺失、参考 manifest 来自别的集群,或者目标是没有新 restartpoint 的备库,都可能使备份失败。即使增量备份完成,恢复时仍要取得全备和之后所需的 WAL。
1# 备份端;看依赖链是否误接到另一集群2python3 -c 'import json; a="/backup/pg17/full-20260915/backup_manifest"; b="/backup/pg17/inc-20260916/backup_manifest"; x=json.load(open(a)); y=json.load(open(b)); print(x["System-Identifier"], y["System-Identifier"], x["System-Identifier"]==y["System-Identifier"])'输出最后应为 True。同一系统标识只是必要条件,不说明这两份备份构成合法连续依赖链;真正合成前还要用下一条预检查,并核对两份备份各自的完整性。
1# 隔离备份端;不创建输出目录2pg_combinebackup --dry-run \3 -o /restore/pg17/synthetic-20260916 \4 /backup/pg17/full-20260915 /backup/pg17/inc-20260916备份目录必须从旧到新列出,漏掉中间增量会使依赖链不成立。--dry-run 检查能否合成,但不读取验证每个文件的内容,也不证明 WAL 足够恢复到目标时刻。
1# 隔离备份端;输出目录须不存在或为空;保留原始备份链2pg_combinebackup \3 -o /restore/pg17/synthetic-20260916 \4 /backup/pg17/full-20260915 /backup/pg17/inc-20260916合成结果是新的基础备份,不等于数据库已经恢复。确认输出目录、表空间映射和权限;随后按第 20—26 条的隔离恢复方法设置 recovery.signal、取回归档 WAL 并实际重放。
1# 同版本 PostgreSQL 17 工具;WAL 另按归档链与恢复演练检查2pg_verifybackup --no-parse-wal /restore/pg17/synthetic-20260916--no-parse-wal 只核对 manifest 和数据文件,不验证恢复所需 WAL;不能把它的通过写成“PITR 可恢复”。接着还要核对归档链和恢复目标,在隔离实例实际启动并检查业务数据。
1-- 生产主库;间隔几分钟采两次,观察计数是否继续变化2SELECT archived_count, failed_count,3 last_archived_wal, last_failed_wal, stats_reset4FROM pg_stat_archiver;failed_count 是从 stats_reset 起的累计值,不能把一个非零数字直接当成“现在仍在失败”。有些归档进程异常退出不会计入这个视图;计数不动而 WAL 积压时,还要看服务端日志和待归档标记。
1-- 生产主库;需要 pg_monitor 或对应函数执行权限2SELECT count(*) AS pending_ready_files3FROM pg_ls_archive_statusdir()4WHERE name LIKE '%.ready';.ready 表示等待 archiver 处理。连续采样发现数量上涨,说明产生速度超过归档速度或归档失败;只有少量新标记并不必然异常,还要结合最后归档时间和源库写入量。
1-- 生产主库2SELECT name, modification3FROM pg_ls_archive_statusdir()4WHERE name LIKE '%.ready'5ORDER BY modification6LIMIT 20;长期不动的最旧标记比单纯的积压数量更能说明问题。取掉 .ready 后缀,把 WAL 名称与第 61 条的失败文件、数据库日志及备份端文件核对;不要手工删标记来“消除告警”。
1# 在生产主库主机,只读检查;数据目录按第 1 条实际值替换2du -sh /var/lib/postgresql/17/main/pg_wal归档失败时已完成的 WAL 段不能安全回收,pg_wal 可能持续长大。du 是目录占用,不能单独归因于归档:复制槽、wal_keep_size 和检查点配置也可能留住 WAL。容量紧张时先确保归档存储与归档命令恢复,别手工删除 pg_wal 文件。
1# 在备份端执行,目标目录按实际归档配置替换2df -h /backup/wal-archive归档目录满时,archiver 会反复重试,源库 pg_wal 也可能被拖满。确认挂载确实是目标备份存储,不要只看本地路径名;空间足够还需检查权限、网络和重复文件冲突。
1# 在归档命令实际执行的主机,以 postgres 软件属主执行2test -d /backup/wal-archive && test -w /backup/wal-archive命令退出码为 0 才表示该账号看到目录且有写权限。归档路径若是远程挂载,还要检查挂载状态和延迟;test -w 不能证明写入后已经落盘,也不能证明现有同名文件内容正确。
1# 文件名来自第 61 条;只在源端该段仍存在时比较2sha256sum \3 /var/lib/postgresql/17/main/pg_wal/000000010000000000000005 \4 /backup/wal-archive/000000010000000000000005两个摘要相同,才能把“归档端已有同名文件”当作重试时可接受的情况。不同摘要可能是两个集群共用归档目录或文件损坏,不能覆盖旧文件硬闯。源端文件已回收时不要编造比较结果,改查备份仓库的文件校验记录。
1-- 生产主库;与第 62 条隔几分钟连续观察2SELECT name, modification3FROM pg_ls_archive_statusdir()4WHERE name LIKE '%.done'5ORDER BY modification DESC6LIMIT 10;.done 是当前数据目录记录的归档完成标记。它可能随 WAL 回收消失,不是完整的历史账本;若最新 .done 与 .ready 长期不变,就去查日志里的归档进程错误和备份端实际文件。
1-- 生产主库;采两次样本后比较 wal_bytes 与归档计数2SELECT wal_bytes, wal_records, stats_reset3FROM pg_stat_wal;wal_bytes 也是累计值,须对照 stats_reset 和采样间隔。源库持续大量生成 WAL 而 archived_count 不推进,优先查第 62—67 条;两个统计视图的重置时间可能不同,不能直接用两列累计值相减。
1# 在生产主库主机;日志路径按 logging_collector / 服务配置替换2grep -E 'archive command failed|archiver process|could not archive' \3 /var/log/postgresql/postgresql-17-main.log | tail -50归档命令被信号终止、找不到可执行文件等异常,可能导致 archiver 重启,未必写进 pg_stat_archiver.failed_count。日志里先按时间和 WAL 名称定位错误,再检查存储、权限、同名文件内容;不要为让计数归零而重置统计。
1-- 在生产主库执行;先确认每个槽对应的消费端2SELECT slot_name, slot_type, active, active_pid,3 restart_lsn, wal_status4FROM pg_replication_slots5ORDER BY restart_lsn NULLS LAST;restart_lsn 是槽的消费端可能还需要的最旧 WAL 位置。槽不活跃而位置长期不动,pg_wal 增长也许是它留住 WAL,并非 archiver 失败;先找到实际消费端,不能直接删除槽。
1-- 在生产主库执行;只作同一时刻的容量排查2SELECT slot_name, active,3 pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn))4 AS retained_wal_estimate5FROM pg_replication_slots6WHERE restart_lsn IS NOT NULL7ORDER BY pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) DESC;这是当前 LSN 到槽起点的逻辑距离,不能当作 pg_wal 目录实占字节;文件段、检查点和其他保留设置都会影响磁盘占用。与第 64 条的 du 一起看,才好判断哪条链路需要处理。
1-- PostgreSQL 17;在生产主库执行2SELECT slot_name, wal_status, safe_wal_size,3 pg_size_pretty(safe_wal_size) AS safe_wal_left4FROM pg_replication_slots5ORDER BY safe_wal_size NULLS LAST;wal_status='lost' 表示槽已不可用;unreserved 表示所需 WAL 可能在下次检查点移除。safe_wal_size 为 NULL 不一定是故障:保留上限 max_slot_wal_keep_size=-1 或槽已 lost 都会如此,必须结合状态判断。
1-- 在生产主库执行;单位按 pg_settings 中的 unit 解读2SELECT name, setting, unit, source3FROM pg_settings4WHERE name IN ('max_slot_wal_keep_size', 'wal_keep_size',5 'max_wal_size', 'min_wal_size')6ORDER BY name;max_slot_wal_keep_size=-1 表示复制槽没有这个保留上限,消费端停掉时可能一直堆 WAL。wal_keep_size 是另一条保留机制;max_wal_size 是触发检查点的软限制,不是 pg_wal 目录的绝对容量上限。
1-- PostgreSQL 17;在生产主库执行2SELECT slot_name, slot_type, active,3 inactive_since, restart_lsn, wal_status4FROM pg_replication_slots5WHERE active = false6ORDER BY inactive_since NULLS LAST;不活跃可能是备库维护、订阅断线或备份工具暂停,不一定是废弃槽。先核对消费端、最近恢复记录和保留的最旧 WAL;若已处于 lost,消费端通常需要重新建立同步链,而不是只把槽重新激活。
1-- 生产主库;不要在输出中泄露归档脚本的访问凭据2SELECT name, setting, source3FROM pg_settings4WHERE name IN ('archive_mode', 'archive_command', 'archive_library')5ORDER BY name;archive_mode=on 不够,还要看实际执行的是命令还是归档模块。归档脚本若引用外部凭据,记录配置时应脱敏;配置无误也要查最近归档成功记录和目标端文件。
1SELECT name, setting, unit, source2FROM pg_settings3WHERE name = 'archive_timeout';低写入库可能很久不切换 WAL 段,归档只处理已完成的段。archive_timeout 限制段切换间隔,但设得太短会显著增加归档文件量;恢复时间目标不能只靠这个参数推算,还要看最后一次成功归档时间。
1-- 生产主库;只是当前距离最近归档成功的时间2SELECT now() - last_archived_time AS since_last_archive,3 last_archived_wal, last_archived_time,4 failed_count, last_failed_time5FROM pg_stat_archiver;没有新 WAL 段、实例低写入时,时间间隔变长未必是故障。先对照第 69 条的 WAL 生成增量和第 62 条的 .ready;连续有待归档文件而成功时间不动,才要查归档命令错误。
1# 在归档备份端执行;.backup 是备份历史文件,不是数据备份本体2find /backup/wal-archive -maxdepth 1 -type f -name '*.backup' -print历史文件记载基础备份的 WAL 边界,可用于对照备份目录和归档目录。不存在不自动说明备份失败:不同工具、路径和备份方式的记录机制可能不同;还是以 manifest、备份文件及真实恢复为准。
1# 文件名取自第 79 条;只读2cat /backup/wal-archive/000000010000000000000005.00000020.backup核对标签、开始/结束 WAL 位置和时间,与备份目录的 backup_label、manifest 对上。文件名示例不能照搬;若历史文件和备份文件属于不同系统标识或不同时间线,先停下恢复计划,查是否混用了归档目录。
1# 备份端;文件名前缀取自确认过的时间线和 WAL 范围2find /backup/wal-archive -maxdepth 1 -type f \3 -name '0000000100000000000000*' -printf '%f\n' | sort这里是对一个明确范围做文件盘点,不能用“最新文件名大于目标”推断中间段全在。归档可能存在 .partial、压缩后缀和新时间线;要按实际恢复链逐段核对,并在隔离实例重放。
1-- 生产主库;文件名取自备份端实测清单2SELECT timeline_id, segment_number3FROM pg_split_walfile_name('000000020000000000000005');WAL 文件名前八位是时间线,不能把分叉前后的两组 WAL 当作一条平直序列。函数返回的段号适合与备份端清单对照;真正的分叉关系还得读第 39 条的 .history 文件。
1# 在配置备份端;路径按本次基础备份的归档号替换2find /backup/pg17/config-20260916 -maxdepth 1 -type f \3 \( -name 'postgresql.conf' -o -name 'pg_hba.conf' \4 -o -name 'pg_ident.conf' \) -printWAL 归档重放数据库变更,却不会恢复手工编辑的外置配置文件。演练实例的端口、认证和目录配置还要另行保存与复核;发现某份配置副本缺失时,应补备份策略,不能靠重放 WAL 找回来。
1# 仅对专用、可清理的暂存归档目录做 dry-run;保留边界由所有恢复需求共同确定2pg_archivecleanup -n /backup/wal-staging \3 000000010000000000000005-n 不删除文件,只打印计划清理名单。长期归档库或多实例共用的归档目录不能按单个副本的 %r 清理;必须先确认所有备份、时间点恢复和副本需要的最旧 WAL,才能决定清理边界。
1-- 只在隔离演练实例检查2SELECT name, setting, source3FROM pg_settings4WHERE name = 'archive_cleanup_command';隔离 PITR 使用的是长期归档仓库时,不应让演练副本自动清理它。pg_archivecleanup 适合单个副本专用的暂存归档区;若该参数指向共用仓库,启动恢复前先纠正配置。
1-- 连接隔离演练实例;多个恢复目标同时配置会导致启动错误2SELECT name, setting, source3FROM pg_settings4WHERE name IN ('recovery_target', 'recovery_target_time',5 'recovery_target_lsn', 'recovery_target_name',6 'recovery_target_xid')7 AND setting <> ''8ORDER BY name;同一次恢复只能选时间、LSN、命名点、事务 ID 或 immediate 中的一种。查询在运行实例执行,只能说明这次已启动的配置;若实例启动失败,改查配置文件和启动日志。
1-- 隔离演练实例2SELECT name, setting, source3FROM pg_settings4WHERE name = 'recovery_target_inclusive';默认 on,目标时间、LSN 或事务 ID 恰好等于某笔事务边界时会包含它。要恢复到误操作发生之前,先核对事件时间和 WAL 证据,再决定是否用 off;对命名恢复点,这个参数不决定边界。
1-- 隔离演练实例2SELECT name, setting, source3FROM pg_settings4WHERE name = 'recovery_target_timeline';默认 latest,从归档中选择最新可用时间线。若曾做过 PITR 或备库提升,可能必须指定历史分支;应先看第 39 条的分叉记录和基础备份所属时间线,不能盲目把 latest 当成目标业务历史。
1-- 隔离演练实例2SELECT name, setting, source3FROM pg_settings4WHERE name = 'recovery_target_action';pause 便于停在目标点只读检查,promote 会结束恢复并开放读写,shutdown 会停机。本文演练采用 pause;业务记录尚未核对前,不要把“到达恢复时间”与“可以开放写入”画等号。
1-- 隔离实例;需超级用户或相应查看权限2SELECT sourcefile, sourceline, name, setting,3 applied, error4FROM pg_file_settings5WHERE name LIKE 'recovery_target%'6 OR name = 'restore_command'7 OR error IS NOT NULL8ORDER BY sourcefile, sourceline;pg_file_settings 展示当前文件内容和解析问题,applied=false 有时只是后一条覆盖前一条;真正生效值仍要查 pg_settings。若启动失败,该视图无法查询,应在副本目录直接检查配置与恢复日志。
1-- 隔离实例;仍处于暂停恢复状态时也可读目录2SELECT datname, datallowconn, datconnlimit3FROM pg_database4WHERE datistemplate = false5ORDER BY datname;核对业务库是否都在、是否允许连接,再逐库检查对象。目录里出现数据库名不代表其中表数据已符合目标时间,也不说明外置配置文件和应用连接串已恢复。
1-- 隔离实例2SELECT spcname, pg_tablespace_location(oid) AS location3FROM pg_tablespace4ORDER BY spcname;自定义表空间的位置必须落在隔离恢复的映射路径,不能指向生产目录。pg_default、pg_global 的位置显示为空属正常;若恢复启动时表空间路径缺失,优先检查解包和映射步骤。
1-- 连接隔离实例的业务库;schema 与表名按现场换2SELECT to_regclass('public.orders') AS orders_table,3 to_regclass('public.payments') AS payments_table;返回非空才说明名称能解析到关系。表存在只是最低检查;后续还要按真实误操作涉及的订单号、支付流水或其他业务键查具体行,不能仅凭对象名宣布恢复成功。
1-- 只在隔离恢复的业务库执行;订单号按事故记录替换2SELECT order_id, status, updated_at3FROM public.orders4WHERE order_id = 20260915001;这条示例故意用事故记录里的唯一业务键,比全表 count(*) 更能检验目标点是否选对。生产侧应留存误操作前的审计、日志或业务确认记录作对照;示例表名和列名须按现场调整。
1-- 隔离业务库;时间窗与业务谓词按事故记录确定2SELECT status, COUNT(*) AS rows3FROM public.orders4WHERE updated_at >= TIMESTAMPTZ '2026-09-15 17:55:00+08'5 AND updated_at < TIMESTAMPTZ '2026-09-15 18:00:00+08'6GROUP BY status7ORDER BY status;按事件前的短时间窗看业务状态分布,再和原库审计及应用日志比对。恢复到 18:00 并不保证这五分钟内所有业务都完整:归档链、事务提交时间和恢复目标的包含规则仍要逐项核对。
1-- 隔离业务库;表名按现场替换2SELECT conname, contype, convalidated3FROM pg_constraint4WHERE conrelid = 'public.orders'::regclass5ORDER BY conname;恢复后读表能成功,还应查主键、唯一键和业务相关约束。convalidated=false 可能是原库就未验证,不应立即归因于恢复;要与基线库的对象定义和事故前记录对照。
1-- 隔离业务库2SELECT extname, extversion3FROM pg_extension4ORDER BY extname;扩展对象记录在数据库里,扩展的共享库文件却依赖恢复主机的软件环境。目录查询只能核对注册信息;应用用到 PostGIS、pgcrypto 等扩展时,还要在隔离实例调用一个只读功能确认软件文件和版本匹配。
1-- 隔离实例2SELECT name, setting3FROM pg_settings4WHERE name IN ('listen_addresses', 'port')5ORDER BY name;本文示例应只监听 127.0.0.1:55432。恢复数据可能含生产账号和业务信息,演练副本开放到生产网络前必须先完成访问控制;这条只查数据库配置,还要核对实际进程监听和防火墙。
1-- 隔离实例;需超级用户或 pg_monitor2SELECT timeline_id, prev_timeline_id,3 checkpoint_lsn, redo_lsn, checkpoint_time4FROM pg_control_checkpoint();控制文件能帮你确认演练副本当前位于哪条时间线、从哪里开始重放。它不是“恢复目标已达到”的证明;仍须有暂停记录、最后重放位置和业务行的对照结果。
1-- 隔离实例;将输出连同目标时间、备份 ID、归档范围一起存档2SELECT now() AS checked_at,3 pg_is_in_recovery() AS recovering,4 pg_get_wal_replay_pause_state() AS pause_state,5 pg_last_wal_replay_lsn() AS replay_lsn,6 pg_last_xact_replay_timestamp() AS last_replayed_xact;命令能留下当时的重放状态,不能代替第 93—96 条的业务核对。演练结论应写清恢复了哪份备份、走过哪些 WAL、目标点是否真的到达,以及仍缺什么;否则“演练成功”四个字下次事故时没法复用。
PostgreSQL PITR 能否成功,取决于基础备份、WAL 归档和恢复目标三者是否完整对应。恢复演练不能只看到实例启动,还要核对时间线、最后重放位置以及目标业务数据。
建议定期在隔离环境完成一次完整恢复,并把备份 ID、WAL 范围、目标时间和验证 SQL 一起保存。真正发生事故时,这份记录比一条“备份成功”更有用。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100