performance30 分钟阅读
PostgreSQL 慢 SQL 与执行计划排查 100 条命令
PostgreSQL 的一条 SQL 突然慢下来,先要分清它是一直慢、偶尔慢,还是执行次数太多拖高了总耗时。找到了 SQL 以后,再看计划的估计行数、实际行数、块访问和临时文件;不能看到 `Seq Scan` 就直接补索引。
2026年9月16日阅读—点赞—收藏—
dba100postgresqlscenario
100 条命令系列文章专栏
PostgreSQL 的一条 SQL 突然慢下来,先要分清它是一直慢、偶尔慢,还是执行次数太多拖高了总耗时。找到了 SQL 以后,再看计划的估计行数、实际行数、块访问和临时文件;不能看到 `Seq Scan` 就直接补索引。
PostgreSQL 的一条 SQL 突然慢下来,先要分清它是一直慢、偶尔慢,还是执行次数太多拖高了总耗时。找到了 SQL 以后,再看计划的估计行数、实际行数、块访问和临时文件;不能看到 Seq Scan 就直接补索引。
这篇从当前会话和 pg_stat_statements 入手,往执行计划、统计信息和索引走。排查时按实际症状翻命令,建议收藏,也欢迎分享给负责这条 SQL 的开发同事。
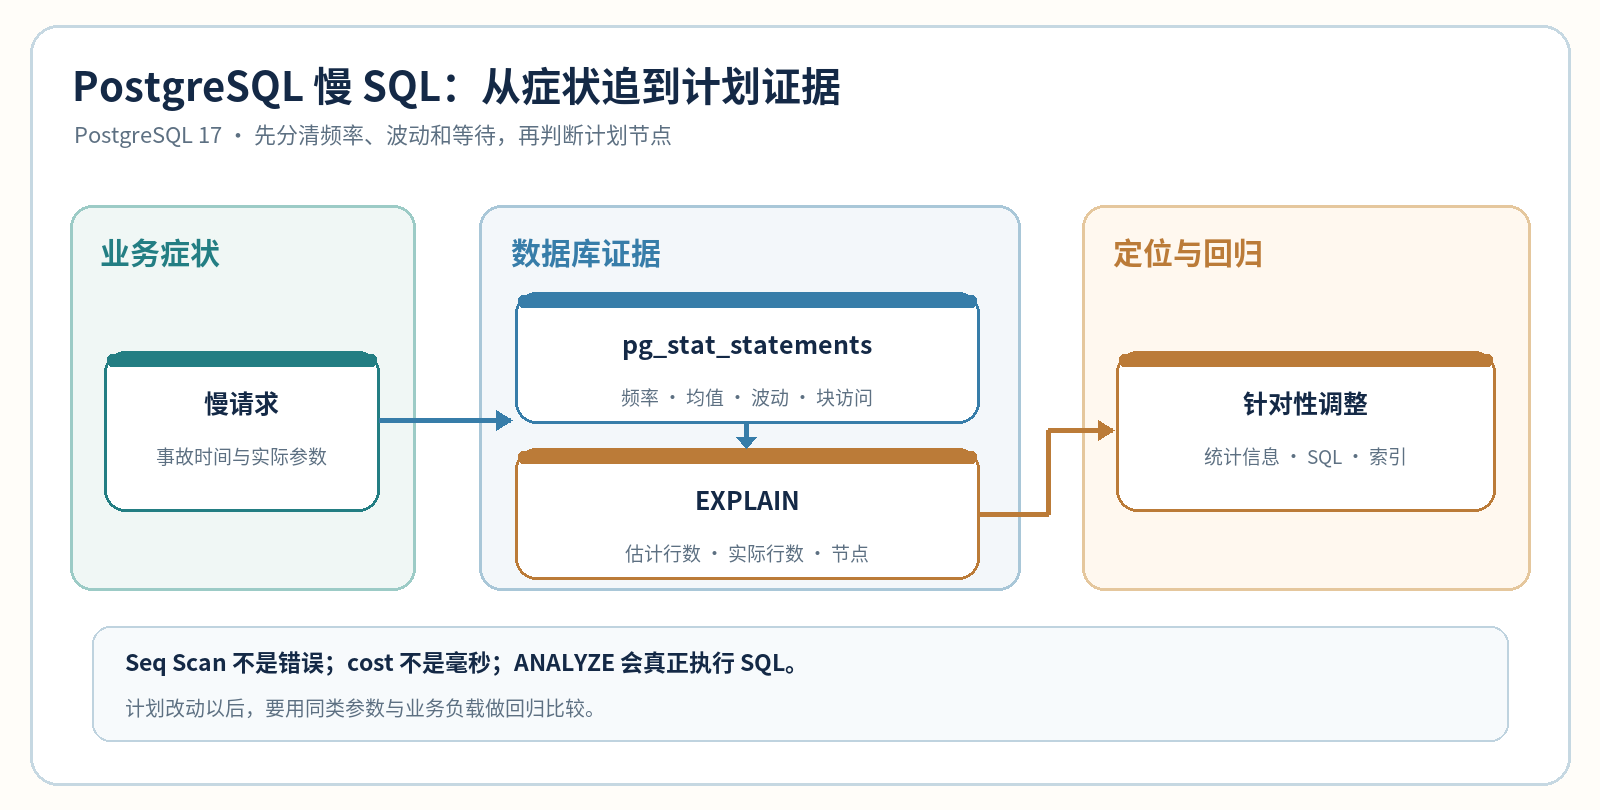 PostgreSQL 慢 SQL 到执行计划的排查路径
示例采用 PostgreSQL 17。pg_stat_statements 需要预加载和当前库安装扩展;EXPLAIN ANALYZE 会真正执行语句,涉及写入的 SQL 必须在可控环境评估后再运行。
1SELECT name, setting, source2FROM pg_settings3WHERE name IN ('shared_preload_libraries', 'compute_query_id',4 'pg_stat_statements.track',5 'pg_stat_statements.track_planning', 'track_io_timing')6ORDER BY name;pg_stat_statements 必须在 shared_preload_libraries 里预加载,新增时要重启实例;compute_query_id 要能产生 query ID。track_io_timing 关闭时相关读写耗时统计是零,不能解读成“没有 I/O”。
1SELECT extname, extversion, extnamespace::regnamespace AS extension_schema2FROM pg_extension3WHERE extname = 'pg_stat_statements';模块预加载负责全实例采集,扩展则让当前数据库能查询视图。没安装时不能直接运行后面的视图查询;安装是数据库变更,需要按现场流程处理。
1-- 当前库已安装 pg_stat_statements2SELECT dealloc, stats_reset3FROM pg_stat_statements_info;总耗时和调用次数都是从统计窗口开始累计的。dealloc 增长说明条目超过容量后有旧记录被淘汰,历史排名可能漏掉低频 SQL。
1SELECT queryid, calls, round(total_exec_time::numeric, 1) AS total_ms,2 round(mean_exec_time::numeric, 1) AS mean_ms,3 left(query, 180) AS query4FROM pg_stat_statements5WHERE calls > 06ORDER BY total_exec_time DESC7LIMIT 30;累计高的 SQL 可能单次很快、只是调用太频繁。query 是归一化后的代表文本,不一定包含事故发生时的具体参数值;要和业务请求或日志对上。
1SELECT queryid, calls, round(mean_exec_time::numeric, 1) AS mean_ms,2 round(max_exec_time::numeric, 1) AS max_ms,3 left(query, 180) AS query4FROM pg_stat_statements5WHERE calls >= 106ORDER BY mean_exec_time DESC7LIMIT 30;设置最低调用次数,避免一次性语句占满榜单。均值掩盖波动,后面还要看最大值、标准差和对应时段的系统状态。
1SELECT queryid, calls, mean_exec_time, max_exec_time,2 stddev_exec_time, left(query, 180) AS query3FROM pg_stat_statements4WHERE calls >= 205ORDER BY stddev_exec_time DESC6LIMIT 30;波动大可能是参数选择性、缓存冷热、锁等待或计划变化,不等于索引缺失。统计是累计值,先确认 stats_since 覆盖事故时段。
1SELECT queryid, calls, shared_blks_read, shared_blks_hit,2 shared_blk_read_time,3 left(query, 180) AS query4FROM pg_stat_statements5ORDER BY shared_blks_read DESC6LIMIT 30;shared_blks_read 记录缓存未命中的读取次数,但操作系统页缓存也可能满足读取。读耗时列需要 track_io_timing=on;块数多还要结合执行次数和返回行数看。
1SELECT queryid, calls, temp_blks_read, temp_blks_written,2 left(query, 180) AS query3FROM pg_stat_statements4WHERE temp_blks_read > 0 OR temp_blks_written > 05ORDER BY temp_blks_written DESC6LIMIT 30;排序、Hash 等操作可能落到临时文件。下一步应查看计划节点、输入行数与 work_mem,不要只提高参数而不核对并发内存压力。
1SELECT pid, datname, usename, query_start,2 now() - query_start AS run_age,3 wait_event_type, wait_event,4 left(query, 240) AS query5FROM pg_stat_activity6WHERE state = 'active'7 AND pid <> pg_backend_pid()8ORDER BY query_start9LIMIT 30;这是当前截面,不是历史慢 SQL。active 也可能正在等锁或 I/O;先看等待事件,避免把阻塞时间全算成计划自身的问题。
1-- 把表、条件和值换成现场 SQL;本条只生成计划2EXPLAIN (VERBOSE, SETTINGS)3SELECT order_id, created_at4FROM public.orders5WHERE customer_id = 1234;这里没有 ANALYZE,SQL 不会真正执行。先看过滤条件、估计行数、扫描和连接节点;估计代价不是毫秒,不能拿 cost 数字直接当实际耗时。
1-- 在可控的只读场景执行;ANALYZE 会实际运行查询2EXPLAIN (ANALYZE, BUFFERS)3SELECT order_id, created_at4FROM public.orders5WHERE customer_id = 1234;用第 10 条相同条件比较 rows 估计与 actual rows,再看 shared hit/read。节点显示的实际行数通常是每次循环的数,遇到 loops 大于 1 时要一起读;缓冲区读取也不等于每一页都真的从磁盘取回。
1-- ANALYZE 仍会运行 SELECT,TIMING OFF 只减少计时开销2EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)3SELECT order_id4FROM public.orders5WHERE customer_id = 1234;逐节点计时在很短、循环很多的查询上可能带来明显测量开销。TIMING OFF 仍提供实际行数、缓冲区信息和总执行时间;它不是把 SQL 变成只读计划,也不能用来安全测试写入语句。
1-- 在可控的只读场景执行2EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)3SELECT order_id, created_at4FROM public.orders5WHERE customer_id = 1234;JSON 更方便保留节点类型、估计/实际行数和缓冲区计数供前后对照。记录执行时的参数值与统计更新时间;同名 SQL 的不同参数计划可能不一样,不能只把两份 JSON 做文本差异。
1EXPLAIN2SELECT order_id3FROM public.orders4WHERE created_at >= timestamp '2026-09-01 00:00:00'5 AND created_at < timestamp '2026-09-02 00:00:00';看范围覆盖多少行、用的是 Index Scan、Bitmap Scan 还是 Seq Scan。日期跨度很大时顺序扫描可能合理;先对照真实业务时间段和表统计,再决定是否需要索引。
1EXPLAIN2SELECT order_id3FROM public.orders4WHERE created_at::date = date '2026-09-01';普通 created_at 索引未必能直接支持这个表达式;如果表有对应表达式索引,计划又可能完全不同。和第 14 条比较前先检查列类型与时区,尤其是 timestamptz 转日期时的会话时区,不能只为了走索引改坏查询语义。
1EXPLAIN2SELECT order_id, created_at3FROM public.orders4WHERE customer_id = 12345ORDER BY created_at DESC, order_id DESC6LIMIT 20 OFFSET 50000;深偏移分页可能先取并排序大量行,再丢掉前 5 万条。查看 Sort、扫描节点的估计行数和组合索引定义;LIMIT 20 并不保证只访问 20 行。实际代价要在可控环境用 ANALYZE 核实。
1EXPLAIN2SELECT order_id, created_at3FROM public.orders4WHERE customer_id = 12345 AND (created_at, order_id) <6 (timestamp '2026-09-01 12:00:00', 500001)7ORDER BY created_at DESC, order_id DESC8LIMIT 20;键值要来自上一页最后一条。与第 16 条比较时先验证排序方向、并列时间以及 NULL 值处理;键值分页可能减少深偏移扫描,但它改变了翻页接口,不能只看计划就直接替换业务代码。
1EXPLAIN (VERBOSE)2SELECT o.order_id, c.customer_name3FROM public.orders AS o4JOIN public.customers AS c5 ON c.customer_id = o.customer_id6WHERE c.customer_id = 1234;看连接是 Nested Loop、Hash Join 还是 Merge Join,两边各读多少估计行,以及过滤条件是否被下推。连接方式没有统一好坏;当估计行数差几个数量级时,先看统计和真实参数。
1-- 在可控的只读场景执行2EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)3SELECT o.order_id, c.customer_name4FROM public.orders AS o5JOIN public.customers AS c6 ON c.customer_id = o.customer_id7WHERE c.customer_id = 1234;把两边输入节点的估计行数与实际行数、loops 对照。若内侧反复扫描,Nested Loop 的总工作量可能远大于单次节点行数;还要看共享块读数,别凭连接节点名字下结论。
1SELECT schemaname, tablename, attname,2 null_frac, n_distinct, correlation,3 most_common_vals, most_common_freqs4FROM pg_stats5WHERE schemaname = 'public'6 AND tablename = 'orders'7 AND attname IN ('customer_id', 'created_at');n_distinct 和常见值频率是采样估计,不是实时精确分布。某个客户订单量远高于平均值时,均匀估计容易失真;先看 pg_stats 和第 11、19 条实际行数,之后再考虑刷新统计或调整 SQL。
1SELECT schemaname, relname, n_live_tup,2 n_mod_since_analyze, last_analyze,3 last_autoanalyze4FROM pg_stat_user_tables5WHERE schemaname = 'public'6 AND relname = 'orders';n_mod_since_analyze 是上次统计后修改行数的估计,不是精确变更日志。结合这张表最近是否批量导入、删除或更新,判断旧统计能否代表现在的数据;last_autoanalyze 为空也可能是统计被重置,不必立刻说自动维护失效。
1SELECT oid::regclass AS relation_name,2 reltuples, relpages3FROM pg_class4WHERE oid = 'public.orders'::regclass;reltuples、relpages 主要由 VACUUM/ANALYZE 更新,是规划器估算规模的基础,不是实时精确表行数。若它与现场实际数据量相差很大,再看第 21 条的统计时间和变更量;不要只凭估计值判断数据丢失。
1SELECT attname, attstattarget2FROM pg_attribute3WHERE attrelid = 'public.orders'::regclass4 AND attname IN ('customer_id', 'created_at')5 AND attnum > 06 AND NOT attisdropped;PostgreSQL 17 中 attstattarget 为空表示使用系统默认值,0 表示不采集该列统计。偏斜客户值很多时,过小的目标可能漏掉重要常见值;调高目标会增加 ANALYZE 的采样和统计体积,先确认估计误差确实来自这里。
1SELECT attname, histogram_bounds,2 most_common_vals, most_common_freqs3FROM pg_stats4WHERE schemaname = 'public'5 AND tablename = 'orders'6 AND attname = 'created_at';直方图用于估计范围条件,但常见值会从直方图计算中单独处理。若查询日期落在统计时没有覆盖的新数据段,范围行数可能估得很偏;把实际参数、业务导入时间和第 11 条实际行数一起对照。
1SELECT statistics_schemaname, statistics_name,2 attnames, kinds, inherited3FROM pg_stats_ext4WHERE schemaname = 'public'5 AND tablename = 'orders';单列统计不能完整表达 customer_id 与状态列等字段的相关性。kinds 可见已采集的 ndistinct、dependencies、MCV 类型;没有多列统计不等于一定需要创建,先找实际计划中错估的多条件节点。
1SELECT statistics_name, attnames,2 most_common_vals, most_common_freqs,3 most_common_base_freqs4FROM pg_stats_ext5WHERE schemaname = 'public'6 AND tablename = 'orders'7 AND most_common_vals IS NOT NULL;most_common_base_freqs 是按单列频率相乘得到的基线;实际组合频率如果偏离很多,独立性假设可能导致筛选行数误差。这里只能读到有权限查看的统计对象,结果为空还需确认对象、ANALYZE 和查询权限。
1ANALYZE VERBOSE public.orders;这是更新统计信息,会影响后续 SQL 的计划选择,并会读取样本行;不要当作无副作用的查询。先保存原计划、业务参数、表规模和统计时间,确认有维护权限及业务窗口,再执行并观察是否改善估计。
1SELECT relname, last_analyze, last_autoanalyze,2 n_mod_since_analyze, analyze_count3FROM pg_stat_user_tables4WHERE relid = 'public.orders'::regclass;手工 ANALYZE 后通常看 last_analyze 和计数变化;统计视图可能有刷新延迟,不能刚执行完查到旧时间就说失败。若第 27 条报告跳过、权限不足或采样报错,先处理原因,再比较新计划。
1EXPLAIN (VERBOSE, SETTINGS)2SELECT order_id, created_at3FROM public.orders4WHERE customer_id = 1234;与第 10 条保持相同的 SQL、参数和会话设置,重点比较估计行数及扫描路径。计划变化只说明规划器重新选择了路径,实际快慢还需可控的 EXPLAIN ANALYZE 与业务响应时间复核。
1-- 示例列名按现场表结构替换;先在测试环境比较前后计划2CREATE STATISTICS orders_customer_status_stat (dependencies, mcv)3ON customer_id, status4FROM public.orders;当两列条件高度相关、单列统计造成明显错估时,才考虑这条 DDL。创建对象后还要运行 ANALYZE public.orders 才会生成统计数据;它不会创建索引,也不能解决扫描路径本身缺少索引的问题。先测试、再评估生产变更窗口。
1SELECT indexname, indexdef2FROM pg_indexes3WHERE schemaname = 'public'4 AND tablename = 'orders'5ORDER BY indexname;先看列顺序、表达式和部分索引的条件,再讨论“为什么没有走索引”。同样包含 customer_id 的索引,首列不同或附带谓词不同,适用的查询就不同。
1SELECT i.indexrelid::regclass AS index_name,2 i.indisvalid, i.indisready3FROM pg_index AS i4WHERE i.indrelid = 'public.orders'::regclass5ORDER BY i.indexrelid::regclass::text;indisvalid = false 的索引不能按普通有效索引参与查询计划。并发建索引失败可能留下无效对象;不要只看到 pg_indexes 里有名字,就认定规划器能使用它。
1SELECT indexrelname, idx_scan, idx_tup_read,2 idx_tup_fetch, last_idx_scan3FROM pg_stat_user_indexes4WHERE relid = 'public.orders'::regclass5ORDER BY idx_scan DESC, indexrelname;这是统计重置以来的累计值,不是当前 SQL 是否使用索引的直接证据。Bitmap Scan、Index Only Scan 与普通索引扫描对 idx_tup_fetch 的计数不同,不能简单拿它除以 idx_scan 当成“每次读了多少行”。
1SELECT i.indexrelid::regclass AS index_name,2 pg_size_pretty(pg_relation_size(i.indexrelid)) AS index_size3FROM pg_index AS i4WHERE i.indrelid = 'public.orders'::regclass5ORDER BY pg_relation_size(i.indexrelid) DESC;索引大小能说明维护成本和缓存压力,但大索引未必没用。删索引前还要看第 33 条的统计窗口、业务查询计划以及唯一约束;这条本身只是盘点。
1SELECT indexrelname, idx_blks_read, idx_blks_hit2FROM pg_statio_user_indexes3WHERE relid = 'public.orders'::regclass4ORDER BY idx_blks_read DESC, indexrelname;这里读的是 PostgreSQL 缓冲区层的累计计数。idx_blks_read 不能直接当作物理磁盘 I/O:数据还可能从操作系统页缓存返回;判断一次慢 SQL 的实际块访问仍以第 11 条的 EXPLAIN (ANALYZE, BUFFERS) 为准。
1SELECT indexrelid::regclass AS index_name,2 pg_get_expr(indpred, indrelid) AS predicate3FROM pg_index4WHERE indrelid = 'public.orders'::regclass5 AND indpred IS NOT NULL6ORDER BY indexrelid::regclass::text;部分索引只覆盖满足谓词的行。查询条件若不能让规划器证明该谓词成立,即使索引列匹配,也可能不用它;参数化 SQL 尤其要拿实际计划检查,不能只看索引名称。
1SELECT relname, relpages, relallvisible,2 round(100.0 * relallvisible / NULLIF(relpages, 0), 1)3 AS all_visible_pct4FROM pg_class5WHERE oid = 'public.orders'::regclass;relallvisible 是规划器保存的可见页估计,不是实时精确计数。表更新频繁时,Index Only Scan 仍可能回表检查可见性;覆盖索引也未必省得下这部分访问。
1-- 只对可控的 SELECT 执行;索引列需按现场结构调整2EXPLAIN (ANALYZE, BUFFERS)3SELECT customer_id4FROM public.orders5WHERE customer_id = 1234;如果计划出现 Index Only Scan,再看 Heap Fetches。它很高时,索引里的列虽然够用,仍需要访问表页判断行是否可见;先看表变更和 VACUUM 情况,别急着再加一个覆盖索引。
1SELECT name, setting, source2FROM pg_settings3WHERE name IN ('plan_cache_mode', 'random_page_cost',4 'effective_cache_size', 'work_mem',5 'max_parallel_workers_per_gather')6ORDER BY name;保存这组设置,才能把两个计划放在同一条件下比较。work_mem 等参数可能由应用在会话中设置,单看实例配置文件容易漏掉它们;这里只读取当前会话的生效值。
1SELECT name, parameter_types, generic_plans,2 custom_plans, prepare_time3FROM pg_prepared_statements4ORDER BY prepare_time DESC;这个视图只展示当前连接的预备语句,不会列出其他应用连接。generic_plans 和 custom_plans 是本会话选择次数;如果这里没有涉事 SQL,先确认应用是否真的用预备语句,以及你是不是连到了同一会话。
1-- 仅在排查会话中使用;customer_id 类型按表结构调整2PREPARE orders_by_customer(bigint) AS3SELECT order_id, created_at4FROM public.orders5WHERE customer_id = $1;这条只在当前连接注册一个查询,不执行表扫描。后面的计划对照要沿用同一连接、同一 SQL 和统计信息;排查完按第 46 条释放,避免影响这个连接上同名语句的使用。
1EXPLAIN (VERBOSE, SETTINGS)2EXECUTE orders_by_customer(1234);把参数换成现场数据里确实常见的值。这里只规划 EXECUTE,不执行查询;对照估计行数和扫描方式,不能把这个计划的 cost 当成实际耗时。
1EXPLAIN (VERBOSE, SETTINGS)2EXECUTE orders_by_customer(987654);低频值也要由真实数据或统计信息确认,不能凭号码大小猜。两次计划若一样,可能是规划器判断同一路径更合适,也可能当前使用了通用计划;结合第 40 条的计数再判断。
1BEGIN;2SET LOCAL plan_cache_mode = force_generic_plan;3EXPLAIN (VERBOSE, SETTINGS)4EXECUTE orders_by_customer(1234);5ROLLBACK;SET LOCAL 只在这次事务中生效。通用计划不针对这次参数值优化,可能省规划时间,也可能在数据偏斜时走错路径;这条是诊断对照,不是建议给全实例长期设置 force_generic_plan。
1BEGIN;2SET LOCAL plan_cache_mode = force_custom_plan;3EXPLAIN (VERBOSE, SETTINGS)4EXECUTE orders_by_customer(1234);5ROLLBACK;与第 44 条保持参数相同。如果扫描路径或估计行数明显不同,就可以进一步用可控的实际执行对比;这里只展示计划,不能直接证明哪个更快。事务结束后自动回到原来的 plan_cache_mode。
1DEALLOCATE orders_by_customer;这是当前连接内的清理动作,不会影响其他连接的预备语句。第 41—45 条都要在同一会话执行,否则这条会报“预备语句不存在”。
1SELECT name, setting, unit, source2FROM pg_settings3WHERE name IN ('work_mem', 'hash_mem_multiplier',4 'temp_file_limit', 'track_io_timing')5ORDER BY name;work_mem 是单个排序或哈希操作的基础额度,不是整个 SQL 的总额度;哈希操作还会乘上 hash_mem_multiplier。多个节点、并行 worker 和并发连接一起算,不能因为一条 SQL 落盘就直接把全实例 work_mem 调大。
1SELECT datname, temp_files, temp_bytes,2 stats_reset3FROM pg_stat_database4WHERE datname = current_database();这里是统计重置以来的数据库累计值。它能说明临时文件压力,但不能单独归因到某条 SQL;归因要结合第 8 条的语句统计与实际计划里的 Temp Blocks。
1EXPLAIN (VERBOSE, SETTINGS)2SELECT customer_id, count(*) AS order_count3FROM public.orders4GROUP BY customer_id5ORDER BY order_count DESC6LIMIT 20;先看是否出现 HashAggregate、Sort 或并行聚合,再看估计的分组数。LIMIT 20 只限制结果,通常仍要处理参与分组的订单;不要把“只返回 20 行”当成“只读取 20 行”。
1-- 真实执行 SELECT;大表先评估运行时间和负载2EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)3SELECT customer_id, count(*) AS order_count4FROM public.orders5GROUP BY customer_id6ORDER BY order_count DESC7LIMIT 20;与第 49 条保持相同 SQL 和会话参数,重点读 HashAggregate 的批次数、磁盘用量,以及 Sort Method、Temp Blocks。顶层的缓冲区数字包含子节点,别把每层 Temp Blocks 相加当成总落盘量。
1-- 仅用于可控环境的前后对照,不能据此改全实例配置2BEGIN;3SET LOCAL work_mem = '64MB';4EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)5SELECT customer_id, count(*) AS order_count6FROM public.orders7GROUP BY customer_id8ORDER BY order_count DESC9LIMIT 20;10ROLLBACK;对照第 50 条的相同行数、计划节点、临时块和总时间。若落盘减少但并发时内存压力更高,也未必适合长期提高这个参数;SET LOCAL 随事务结束恢复,仅用于这次测试。
1SELECT name, setting, unit, source2FROM pg_settings3WHERE name IN ('max_parallel_workers_per_gather',4 'max_parallel_workers', 'parallel_setup_cost',5 'parallel_tuple_cost', 'min_parallel_table_scan_size')6ORDER BY name;并行计划受这些设置影响,也受表规模、函数的并行安全性和当时空闲 worker 限制。应用会话把 max_parallel_workers_per_gather 设为 0 时,只看实例文件也可能找错原因。
1EXPLAIN (VERBOSE, SETTINGS)2SELECT customer_id, count(*) AS order_count3FROM public.orders4GROUP BY customer_id;若有 Gather、Partial Aggregate,看计划安排了几个 worker、每个 worker 分担哪部分扫描。小表或预计工作量不大时,串行计划可能更便宜;“没有并行”本身不是故障。
1-- 可控环境执行;大表聚合先评估负载2EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)3SELECT customer_id, count(*) AS order_count4FROM public.orders5GROUP BY customer_id;对照 Workers Planned 与 Workers Launched。计划要两个 worker、实际只启动一个时,实际行数和运行时间可能与估计偏离;再看并发查询与系统的 worker 可用情况,不要把差异都归咎于统计信息。
1BEGIN;2SET LOCAL max_parallel_workers_per_gather = 0;3EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)4SELECT customer_id, count(*) AS order_count5FROM public.orders6GROUP BY customer_id;7ROLLBACK;与第 54 条对照时保持数据、参数和运行窗口尽量一致。串行快一点可能是并行启动及汇总成本,也可能只是缓存更热;一次测试不能作为全局关闭并行的依据。
1SELECT name, setting, source2FROM pg_settings3WHERE name IN ('jit', 'jit_above_cost',4 'jit_inline_above_cost',5 'jit_optimize_above_cost')6ORDER BY name;JIT 是否启用先由计划估计 cost 与这些阈值决定。短 SQL 的编译开销有时比执行时间还长;若服务器没有可用 JIT 实现,即使参数打开,实际计划也不会出现 JIT 阶段。
1-- 需要当前库已安装 pg_stat_statements2SELECT queryid, calls, jit_functions,3 round((jit_generation_time + jit_inlining_time +4 jit_optimization_time + jit_emission_time)::numeric, 1)5 AS jit_total_ms,6 left(query, 160) AS sample_sql7FROM pg_stat_statements8WHERE dbid = (SELECT oid FROM pg_database9 WHERE datname = current_database())10 AND jit_functions > 011ORDER BY jit_generation_time + jit_inlining_time +12 jit_optimization_time + jit_emission_time DESC13LIMIT 20;这里是统计窗口里的累计 JIT 时间;高调用量语句自然容易排在前面。先连同 calls 看每次编译开销,再确认它是否是业务慢 SQL,而不是看到总编译时间高就关闭 JIT。
1-- 在可控环境执行只读聚合2EXPLAIN (ANALYZE, BUFFERS)3SELECT customer_id, count(*) AS order_count4FROM public.orders5GROUP BY customer_id;计划若列出 JIT,看代码生成、Inlining、Optimization、Emission 的时间占了多少。没有 JIT 栏位说明这次未使用 JIT,不能拿第 57 条的累计数字推断这次执行也发生了编译。
1BEGIN;2SET LOCAL jit = off;3EXPLAIN (ANALYZE, BUFFERS)4SELECT customer_id, count(*) AS order_count5FROM public.orders6GROUP BY customer_id;7ROLLBACK;与第 58 条保持 SQL、参数和数据一致,比较总时间、块访问和计划节点。JIT 关闭后快一点也可能来自缓存或并发变化;先重复受控对照,再考虑是否需要调整单会话或工作负载的设置。
1SELECT name, setting, source2FROM pg_settings3WHERE name = 'pg_stat_statements.track_planning';值为 off 时,语句统计里的 plans、total_plan_time 等规划字段会是 0。若准备排查高频短 SQL 的规划开销,先确认扩展正常运行与采集设置;这条只是读配置,不修改实例。
1-- 需安装扩展,并开启 track_planning2SELECT queryid, calls, plans,3 round(mean_plan_time::numeric, 2) AS mean_plan_ms,4 round(mean_exec_time::numeric, 2) AS mean_exec_ms,5 left(query, 160) AS sample_sql6FROM pg_stat_statements7WHERE dbid = (SELECT oid FROM pg_database8 WHERE datname = current_database())9 AND plans > 010ORDER BY total_plan_time DESC11LIMIT 20;规划时间和执行时间单位都是毫秒,但 plans 与 calls 不必相等。高频短 SQL 如果每次都重新规划,累计规划开销值得看;接着核对应用是否使用预备语句和第 40 条的通用/自定义计划计数。
1SELECT backend_type, object, context,2 reads, read_time, hits, evictions,3 stats_reset4FROM pg_stat_io5WHERE backend_type = 'client backend'6ORDER BY reads DESC NULLS LAST, object, context;这是全实例按后端类型、对象和上下文分组的累计值,不针对当前库或当前 SQL。bulkread 可反映大范围扫描;时间列只有在 track_io_timing 开启期间才会采集,不能用它直接算某条语句的磁盘耗时。
1-- 需扩展和 track_io_timing;时间为累计毫秒2SELECT queryid, calls, shared_blks_read,3 round(shared_blk_read_time::numeric, 1) AS read_ms,4 left(query, 160) AS sample_sql5FROM pg_stat_statements6WHERE dbid = (SELECT oid FROM pg_database7 WHERE datname = current_database())8ORDER BY shared_blk_read_time DESC9LIMIT 20;块数多、读时间高的 SQL 值得看实际计划、索引选择和缓存。shared_blk_read_time = 0 也可能只是此前没有开启 I/O 计时,不能直接判为“没有读开销”。
1-- 需扩展和 track_io_timing2SELECT queryid, calls, temp_blks_written,3 round(temp_blk_write_time::numeric, 1) AS temp_write_ms,4 left(query, 160) AS sample_sql5FROM pg_stat_statements6WHERE dbid = (SELECT oid FROM pg_database7 WHERE datname = current_database())8ORDER BY temp_blk_write_time DESC9LIMIT 20;与第 8 条的临时块数量一起读,能区分“写了很多但耗时不高”和“写入本身很慢”。接下来到第 50 条的实际计划找 Sort、HashAggregate 或 Hash Join 的落盘节点。
1-- 可控环境执行只读查询;track_io_timing 开启时才有 I/O 时间2EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)3SELECT order_id, created_at4FROM public.orders5WHERE created_at >= timestamp '2026-09-01 00:00:00'6 AND created_at < timestamp '2026-09-02 00:00:00';看共享块 hit/read 及读耗时是否集中在扫描节点,再把第 14 条的估计计划和索引定义对上。节点的缓冲区数包含子节点,父子级不能相加;TIMING OFF 关的是逐节点 CPU 计时,不会让实际执行变成估计计划。
以下命令只适用于 public.orders 确实是分区表的现场。普通表没有分区剪枝;示例时间边界也要换成真实分区范围。
1SELECT p.partrelid::regclass AS parent_table,2 pg_get_partkeydef(p.partrelid) AS partition_key,3 p.partstrat AS strategy4FROM pg_partitioned_table AS p5WHERE p.partrelid = 'public.orders'::regclass;没有结果就先跳过这一节。r、l、h 分别代表范围、列表和哈希分区;不要只凭表名猜 created_at 就是分区键。
1SELECT child.oid::regclass AS partition_name,2 pg_get_expr(child.relpartbound, child.oid) AS partition_bound3FROM pg_inherits AS i4JOIN pg_class AS child ON child.oid = i.inhrelid5WHERE i.inhparent = 'public.orders'::regclass6ORDER BY child.oid::regclass::text;把查询条件与实际边界对照。若有默认分区,还要检查它是否接收了本应落入其他分区的数据;本条只列出直接子分区,多级分区继续看下一条。
1SELECT relid, parentrelid, isleaf, level2FROM pg_partition_tree('public.orders'::regclass)3ORDER BY level, relid::text;level=0 是父表,isleaf=true 才是叶分区。多级分区要看整棵树,否则只统计一级分区数,容易低估实际要扫描的关系数。
1SHOW enable_partition_pruning;如果为 off,先确认会话或应用是否主动修改过配置。本条只查看当前会话值,不修改实例参数。
1EXPLAIN (VERBOSE)2SELECT order_id, created_at3FROM public.orders4WHERE created_at >= timestamp '2026-09-01 00:00:00'5 AND created_at < timestamp '2026-09-02 00:00:00';范围必须对应第 66 条的分区键类型和第 67 条的实际边界。看 Append 下留下哪些分区;规划阶段被剪掉的分区不会出现在计划里。索引扫描与分区剪枝是两件事。
1EXPLAIN (VERBOSE)2SELECT order_id, created_at3FROM public.orders4WHERE customer_id = 1001;若 customer_id 不是分区键,这次可能保留大量分区。将计划中的分区数和第 70 条对比,判断慢在大量分区的规划、执行,还是各分区里的扫描;不能只看总 cost。
1PREPARE orders_by_time(timestamp, timestamp) AS2SELECT order_id, created_at3FROM public.orders4WHERE created_at >= $15 AND created_at < $2;预备语句仅存在于当前会话。它用于观察参数参与规划或执行时的剪枝,不是让生产会话长期保留这个示例语句。
1EXPLAIN (VERBOSE)2EXECUTE orders_by_time(3 timestamp '2026-09-01 00:00:00',4 timestamp '2026-09-02 00:00:00'5);如果计划里仍显示大量分区,先检查是否用了通用计划,再看分区键条件的写法。通用计划无法在规划时知道具体参数,但执行时仍可能剪枝。
1-- 在可控环境执行只读查询2EXPLAIN (ANALYZE, BUFFERS)3EXECUTE orders_by_time(4 timestamp '2026-09-01 00:00:00',5 timestamp '2026-09-02 00:00:00'6);看 Subplans Removed、分区节点的 loops 以及 never executed。这些信息能分辨初始化或执行过程中剪掉了哪些分区;实际计划会执行查询,数据量大的表应先在可控环境做。
1DEALLOCATE orders_by_time;第 72—74 条使用同一个会话后再执行。若执行中途换了连接,这条会提示找不到预备语句,也说明前面的计划对照不是在同一会话完成的。
1SELECT name, setting, unit, source2FROM pg_settings3WHERE name IN ('seq_page_cost', 'random_page_cost',4 'effective_cache_size', 'effective_io_concurrency')5ORDER BY name;这些是规划时使用的估算依据,不是现场磁盘的实时测量值。查询突然从 Index Scan 换到 Seq Scan,先对比参数来源、表大小和统计信息;不能只靠调低 random_page_cost 强迫它走索引。
1SELECT attname, correlation, null_frac, n_distinct2FROM pg_stats3WHERE schemaname = 'public'4 AND tablename = 'orders'5 AND attname = 'created_at';相关性接近正负 1 时,按时间范围读表可能较集中;接近 0 时,索引命中的行可能散在许多表页。这个值来自最近一次 ANALYZE 的样本,不是保证某次索引扫描会快的结论。
1SELECT ic.oid::regclass AS index_name, am.amname AS index_method,2 pi.indnkeyatts AS key_columns, pi.indnatts AS all_columns,3 pg_get_indexdef(ic.oid) AS definition4FROM pg_index AS pi5JOIN pg_class AS ic ON ic.oid = pi.indexrelid6JOIN pg_am AS am ON am.oid = ic.relam7WHERE pi.indrelid = 'public.orders'::regclass8ORDER BY ic.oid::regclass::text;key_columns 不含 INCLUDE 列;附带列能帮助覆盖查询,但不能直接承担索引定位条件。还要看 B-tree、BRIN 等访问方法,不能只用“有 created_at 索引”概括所有索引。
1EXPLAIN (VERBOSE)2SELECT order_id3FROM public.orders4WHERE customer_id = 10015 AND status = 'PAID';若有两个可用的单列索引,计划可能出现 BitmapAnd,也可能选复合索引或直接扫描表。结合第 78 条的定义和实际选择性看原因;没有位图节点并不等于某个索引失效。
1EXPLAIN (VERBOSE)2SELECT order_id3FROM public.orders4WHERE customer_id = 10015 OR customer_id = 1002;OR 条件可能多次使用同一索引,再合并位图;也可能使用别的路径。位图扫描按表页位置取行,原索引顺序不会保留,有 ORDER BY 时还要留意 Sort。
1-- 在可控环境执行只读查询2EXPLAIN (ANALYZE, BUFFERS)3SELECT order_id4FROM public.orders5WHERE customer_id BETWEEN 1000 AND 1099;如果用了 Bitmap Heap Scan,读 Heap Blocks: exact/lossy、Rows Removed by Index Recheck 和块访问。没有位图节点就按实际扫描路径判断;lossy 块和重检次数高时,不能把 Bitmap Index Scan 的耗时当成全部代价。
1SELECT pi.indexrelid::regclass AS index_name,2 pg_get_expr(pi.indexprs, pi.indrelid) AS expressions,3 pg_get_indexdef(pi.indexrelid) AS definition4FROM pg_index AS pi5WHERE pi.indrelid = 'public.orders'::regclass6 AND pi.indexprs IS NOT NULL;第 15 条把函数套在 created_at 上之后若仍选了索引,可以在这里确认是不是表达式索引。表达式、参数类型和操作符得对得上;不能拿普通 created_at 索引替代判断。
1SELECT relname, seq_scan, seq_tup_read,2 idx_scan, idx_tup_fetch, last_analyze, last_autoanalyze3FROM pg_stat_user_tables4WHERE relid = 'public.orders'::regclass;这是累计工作负载统计,不能归因到单条 SQL。顺序扫描多,可能有全表统计、批处理或低选择性查询;先看真实业务语句和第 81 条的实际计划,再决定是否要动索引。
1SELECT ic.oid::regclass AS index_name, ic.reloptions,2 pg_get_indexdef(ic.oid) AS definition3FROM pg_index AS pi4JOIN pg_class AS ic ON ic.oid = pi.indexrelid5JOIN pg_am AS am ON am.oid = ic.relam6WHERE pi.indrelid = 'public.orders'::regclass7 AND am.amname = 'brin';BRIN 更适合物理位置与列值有相关性的大表范围查询。它记录页范围摘要,命中后仍须回表重检;第 77 条相关性低或数据分布散乱时,别因为索引很小就默认它有效。
1BEGIN;2SET LOCAL enable_bitmapscan = off;3EXPLAIN4SELECT order_id5FROM public.orders6WHERE customer_id BETWEEN 1000 AND 1099;7ROLLBACK;只在当前事务里比较规划器的备选路径,再与第 81 条原计划对照。禁用位图后出现 Index Scan 或 Seq Scan,并不能证明新路径更快;估计成本不同还要检查实际行数、块读和统计偏差。
1-- 替换现场 query ID;需当前库安装扩展2SELECT d.datname, s.userid::regrole AS user_name, s.toplevel,3 s.queryid, s.calls,4 round(s.total_exec_time::numeric, 1) AS total_ms5FROM pg_stat_statements AS s6JOIN pg_database AS d ON d.oid = s.dbid7WHERE s.queryid = 12345678908ORDER BY total_exec_time DESC;同一个归一化 SQL 可能由不同账号执行,顶层语句与函数内语句也可分开采集。比较事故前后数字时要对齐数据库、账号和 toplevel,不能只拿 query ID 合计。
1SELECT queryid, calls, stats_since, minmax_stats_since2FROM pg_stat_statements3WHERE queryid = 12345678904ORDER BY stats_since;PostgreSQL 17 的 stats_since 是该条目开始采集的时间,minmax_stats_since 是最小/最大时间的起点。若后者晚于事故时段,当前最大值就无法代表当时的慢执行。
1SELECT queryid, calls,2 round(min_exec_time::numeric, 1) AS min_ms,3 round(mean_exec_time::numeric, 1) AS mean_ms,4 round(max_exec_time::numeric, 1) AS max_ms,5 round(stddev_exec_time::numeric, 1) AS stddev_ms6FROM pg_stat_statements7WHERE queryid = 1234567890;这是同一统计窗口内的分布概况,不是逐次执行记录。最大值升高但均值平稳时,先找业务请求的真实参数、等待事件和时间点;后面抓计划才知道慢的是哪一次。
1SELECT queryid, calls, rows,2 round(rows::numeric / NULLIF(calls, 0), 1) AS rows_per_call,3 round(total_exec_time::numeric / NULLIF(calls, 0), 1) AS ms_per_call4FROM pg_stat_statements5WHERE queryid = 1234567890;rows 是累计返回或影响的行数,不是计划里各节点扫描的行数。结果量突然放大,可能意味着筛选参数、分页范围或上游调用方式变了;还要拿真实请求核对。
1SELECT pid, usename, application_name, client_addr,2 query_start, wait_event_type, wait_event,3 query_id, left(query, 180) AS current_sql4FROM pg_stat_activity5WHERE state = 'active'6 AND query_id = 12345678907ORDER BY query_start;query_id 需要正常计算;排查账号还要有权限查看其他会话的 SQL 文本。wait_event_type='Lock' 说明此刻可能在等锁,不能把等待时间都归因于执行计划。
以下示例需要超级用户,并使用专门的排查会话。auto_explain 写入服务端日志,开启实际节点统计有额外开销;生产使用前要先约定阈值、采样、日志容量和关闭时间。
1SELECT name, setting, source2FROM pg_settings3WHERE name IN ('log_destination', 'logging_collector',4 'log_line_prefix', 'log_min_duration_statement')5ORDER BY name;先确定日志写到哪里、是否包含会话标识。auto_explain 的计划进入数据库服务端日志,不会作为这条 SQL 的结果返回客户端;logging_collector=off 也不等于日志完全没有去处。
1SELECT name, setting2FROM pg_settings3WHERE name IN ('shared_preload_libraries', 'session_preload_libraries')4ORDER BY name;若两个列表都没有 auto_explain,下面只在本排查会话用 LOAD。不要为了抓一条慢 SQL 就直接改全实例预加载配置。
1-- 超级用户;新建专用会话执行2LOAD 'auto_explain';LOAD 只作用于当前会话。模块加载后默认仍不记录计划;还要设置时长阈值。若现场限制使用超级用户,改用已批准的日志配置流程。
1SET auto_explain.log_min_duration = '500ms';只有达到阈值的语句才会被记录。500 毫秒只是示例,按目标 SQL 的正常耗时和日志容量设置;为了“保证抓到”而在生产把阈值改成 0,会把本会话所有语句计划都写进日志。
1SET auto_explain.sample_rate = 0.1;这里约抽取十分之一的语句,能压低频繁 SQL 的日志量,但也可能错过一次偶发慢执行。事故复现或低频 SQL 应按现场需求选比例,并记录当前设置。
1SET auto_explain.log_analyze = on;2SET auto_explain.log_timing = off;打开 log_analyze 才能看到执行行数和循环次数;关闭节点计时可减轻它对所有被监控语句的额外开销。即便 log_timing=off,采集实际计划仍有成本,要限定会话与观察时间。
1SET auto_explain.log_buffers = on;这依赖第 96 条的 log_analyze=on。后面将实际行数与 shared hit/read、临时块读写一起看,比只记录一个总时长更容易分出行数错估和 I/O 问题。
1SET auto_explain.log_parameter_max_length = 0;默认值可能记录完整参数,业务参数里可能有个人或敏感数据。设为 0 后不会从计划日志直接读到慢执行的参数,需要用已获授权的业务日志或测试输入完成计划对照。
1-- 换成事故时的真实只读 SQL 和参数;本例仅作路径演示2SELECT order_id, created_at3FROM public.orders4WHERE customer_id = 12345 AND created_at >= timestamp '2026-09-01 00:00:00'6 AND created_at < timestamp '2026-09-02 00:00:00';这条只有执行超过第 94 条阈值、且被第 95 条采样选中,计划才会进日志。复现时保持账号、参数和数据范围一致;示例 SQL 快速返回时,日志里没有计划是正常的。
1SET auto_explain.log_min_duration = -1;确认服务端日志中已有需要的计划后,先在本会话关闭采集,再结束专用连接。对照目标语句的估计/实际行数、块读和等待记录;不能用抓到的一份计划推断所有参数都走同一条路径。
排查慢 SQL,先把语句和统计窗口对上,再看实际计划。估计行数偏了就检查统计和参数;行数没偏但块读、临时文件或等待升高,再查对应节点。需要调索引或配置时,留一份变更前计划,用同一组参数做前后对照。
 ORA100 DBA100 命令系列海报
这套数据库运维专题还在更新。其他场景的命令可到 ORA100 · DBA100 查:https://ora100.com/dba100
微信小程序搜索 「三笠的百令册」,需要时也能直接翻到命令。