高可用 & 容灾30 分钟阅读
PostgreSQL 流复制与备库延迟排查 100 条命令
物理流复制是 PostgreSQL 主备架构里最常见的方案。主库生成 WAL,经 WAL sender 送到备库;备库刷盘后,再由恢复进程重放。告警说“备库延迟”,要先看 WAL 是没发出去、没收到,还是收到后没重放。只看一个延迟数字,很容易查错方向。
2026年9月16日阅读—点赞—收藏—
dba100postgresqlscenario
100 条命令系列文章专栏
物理流复制是 PostgreSQL 主备架构里最常见的方案。主库生成 WAL,经 WAL sender 送到备库;备库刷盘后,再由恢复进程重放。告警说“备库延迟”,要先看 WAL 是没发出去、没收到,还是收到后没重放。只看一个延迟数字,很容易查错方向。
物理流复制是 PostgreSQL 主备架构里最常见的方案。主库生成 WAL,经 WAL sender 送到备库;备库刷盘后,再由恢复进程重放。告警说“备库延迟”,要先看 WAL 是没发出去、没收到,还是收到后没重放。只看一个延迟数字,很容易查错方向。
这 100 条命令从主库 sender、备库 receiver 查起,再查复制槽、归档、恢复冲突和主备切换。遇到 WAL 堆积或备库追不上时,按故障所在环节往下找。建议先收藏;做过主备切换的朋友,也欢迎把踩过的坑分享给同行。
示例用 Linux、PostgreSQL 17,一主一备、异步复制。现场若有同步复制、级联备库或归档兜底,先按自己的拓扑确认上游节点。命令里写了执行位置;切换命令要在业务冻结、备库追平、原主库已停止或隔离后使用。
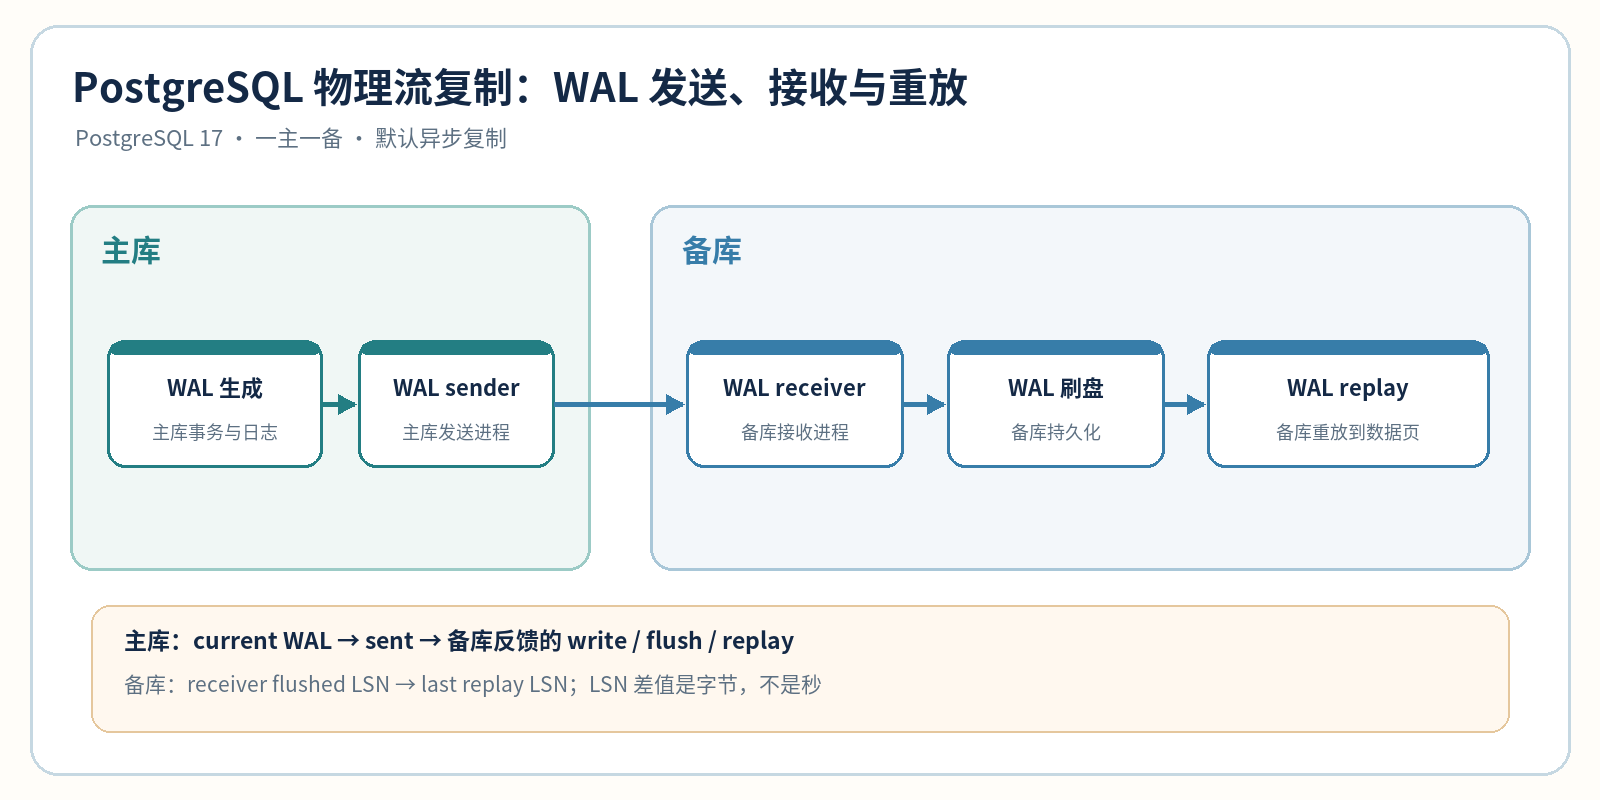 PostgreSQL 物理流复制 WAL 发送、接收与重放示意
主库视角看 WAL 产生与已发送位置,备库视角看已刷盘与已重放位置。排查延迟要把对应阶段的 LSN 放在一起,不能只拿一个时间字段判断。
1SELECT pg_is_in_recovery() AS is_standby;true 是备库,false 是主库。切换后先在两端各跑一次,确认自己确实连到了预期实例;不要只靠 DNS 名称或配置文件判断当前角色。
1SELECT current_setting('server_version') AS version,2 current_setting('data_directory') AS data_directory;目标版本是 17。数据目录用于对齐系统服务、日志和 standby.signal 所在位置;目录信息需要相应权限,普通业务账号查不到时让运维账号执行。
1-- 主库执行2SELECT pg_current_wal_lsn() AS current_wal_lsn;这个位置用于和 WAL sender 的已发送位置比较。单个 LSN 只代表取样时刻,主库正在写入时还要在同一时间窗口继续取其他阶段的数据。
1-- 主库执行2SELECT application_name, client_addr, state, sync_state3FROM pg_stat_replication4ORDER BY application_name, client_addr;视图每个 WAL sender 一行,不包括级联下游的备库。预期备库缺席时先查它的 receiver、连接串、pg_hba.conf 和主库日志,不能把“没行”解释为备库数据库进程一定停了。
1-- 主库执行2SELECT application_name, state,3 sent_lsn, write_lsn, flush_lsn, replay_lsn4FROM pg_stat_replication5ORDER BY application_name;sent_lsn 是主库已发送;后三列来自备库反馈。sent_lsn 往前走而 write_lsn 不动,先看网络与 receiver;flush_lsn 已前进而 replay_lsn 不动,检查备库重放过程和查询冲突。主库看到的反馈不是备库此刻的零延时实时状态。
1-- 主库执行2SELECT application_name,3 pg_wal_lsn_diff(pg_current_wal_lsn(), sent_lsn)4 AS not_yet_sent_bytes5FROM pg_stat_replication6WHERE sent_lsn IS NOT NULL7ORDER BY not_yet_sent_bytes DESC;数字持续增长,说明当前 WAL 产生得比发送得快,或者 sender 无法推进。单位是字节;这不是“延迟多少秒”,要结合生成速率、sender 状态和网络读数分析。
1-- 备库执行2SELECT status, sender_host, sender_port,3 slot_name, flushed_lsn, latest_end_lsn4FROM pg_stat_wal_receiver;能看到当前 streaming receiver 的上游地址和已刷盘位置。flushed_lsn 可用于确认接收进度;不要用尚未刷盘的 written_lsn 做数据完整性判断。没有行时,先判断备库是否仍在恢复、是否改从归档读取 WAL,或者连接上游失败;没有 receiver 不等于完全没有 WAL 在重放。
1-- 备库执行2SELECT pg_last_wal_receive_lsn() AS receive_lsn,3 pg_last_wal_replay_lsn() AS replay_lsn,4 pg_wal_lsn_diff(pg_last_wal_receive_lsn(),5 pg_last_wal_replay_lsn()) AS replay_backlog_bytes;差值变大,表示接收跟得上而重放落后。pg_last_wal_receive_lsn() 只反映通过流复制收到并同步到磁盘的位置;备库也可能从归档恢复 WAL,所以值为空或不动时还要看 receiver 和恢复日志。
1-- 备库执行2SELECT status, last_msg_send_time,3 last_msg_receipt_time, latest_end_time4FROM pg_stat_wal_receiver;长时间没有收到消息时,先看上游 sender、连接日志和网络。上游很久没有产生新 WAL 时,单独拿时间差也会夸大“复制延迟”;继续比较 LSN 是否推进。
1-- 备库执行2SELECT pg_last_xact_replay_timestamp() AS last_replayed_xact_time,3 now() - pg_last_xact_replay_timestamp() AS elapsed_since_last_replay;后一列在没有写入的时段也会持续增加,不能直接称为业务数据延迟。它是“最近一个已重放事务的源端提交时间距现在多久”;与主库最近写入、接收 LSN 和 replay LSN 对照后才有排障意义。
1-- 主库执行2SELECT slot_name, active, restart_lsn,3 wal_status, safe_wal_size4FROM pg_replication_slots5WHERE slot_type = 'physical'6ORDER BY slot_name;active=false 的槽可能只是备库短暂断连,也可能是废弃槽。restart_lsn 是该槽仍可能需要的最老 WAL 位置;wal_status=lost 表示槽已经无法使用,不要仅凭连接重新建立就期待它自动追上。
1-- 主库执行2SELECT slot_name, active,3 pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)4 AS retained_wal_bytes5FROM pg_replication_slots6WHERE slot_type = 'physical'7AND restart_lsn IS NOT NULL8ORDER BY retained_wal_bytes DESC;这给出当前位置与槽最老需求位置的字节差,不等同于磁盘上实际每个 WAL 文件的占用。槽长期不活跃而差值持续增长时,要确认对应备库是否仍需要它;不能直接删槽,否则备库可能失去续传所需 WAL。
1-- 主库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name IN ('max_slot_wal_keep_size', 'wal_keep_size',5 'max_replication_slots', 'max_wal_senders')6ORDER BY name;max_slot_wal_keep_size=-1 是默认的无限制槽保留,不代表磁盘空间无限。设置上限也不是“不会满盘”的承诺:到检查点时,槽可能失去所需 WAL。wal_keep_size 只是额外保留的最小量,不替代复制槽或归档完整性检查。
1-- 主库执行2SELECT slot_name, active, wal_status,3 safe_wal_size, invalidation_reason4FROM pg_replication_slots5WHERE slot_type = 'physical'6AND wal_status IN ('unreserved', 'lost')7ORDER BY slot_name;unreserved 说明所需 WAL 不再受该槽保留,可能在下次检查点删除;lost 表示槽已不可用。safe_wal_size 为 NULL 也可能只是配置没有槽保留上限,不能单独当成槽已经损坏。
1-- 主库执行2SELECT name, setting3FROM pg_settings4WHERE name IN ('archive_mode', 'archive_command',5 'archive_library', 'wal_level')6ORDER BY name;归档需要 wal_level=replica 或更高、archive_mode 打开,并有实际能成功写入目标的命令或库。配置存在不等于归档文件齐全;第 16 条还要看归档进度和失败记录。
1-- 主库执行2SELECT archived_count, last_archived_wal,3 last_archived_time, failed_count,4 last_failed_wal, last_failed_time,5 stats_reset6FROM pg_stat_archiver;计数要与 stats_reset 一起看;最近失败文件是否后来归档成功,还需到归档目标核对。官方文档也明确指出,最后成功归档的文件名不保证此前所有文件都完整,不能用一个最大文件名证明 WAL 链没有缺口。
1-- 备库执行;按数据库看累计次数2SELECT datname, confl_tablespace, confl_lock,3 confl_snapshot, confl_bufferpin, confl_deadlock,4 confl_active_logicalslot5FROM pg_stat_database_conflicts6ORDER BY datname;备库长查询与 WAL 重放冲突时,PostgreSQL 可能取消查询。各列是累计次数,要在同一个统计周期内隔几分钟取两次,比较增量;一次看到非零值不能证明眼下仍在冲突。
1-- 备库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name IN ('hot_standby', 'max_standby_streaming_delay',5 'max_standby_archive_delay', 'hot_standby_feedback')6ORDER BY name;max_standby_streaming_delay 和 max_standby_archive_delay 限制的是一段 WAL 可以等冲突查询多久,不是每条查询的最长运行时间。设为 -1 可无限等待,但备库重放延迟也可能一直增长;开启 hot_standby_feedback 能减少某些取消,却可能让主库表膨胀。先看第 17 条的冲突类型再改参数。
1-- 备库执行;阈值按业务查询正常耗时调整2SELECT pid, datname, usename, state,3 now() - query_start AS running_time,4 wait_event_type, wait_event, left(query, 160) AS sql_text5FROM pg_stat_activity6WHERE backend_type = 'client backend'7AND state = 'active'8AND query_start < now() - interval '5 minutes'9ORDER BY query_start;长查询不是恢复冲突的充分证据;把这些会话与第 17 条的冲突增量、备库的 receive/replay LSN 差一起看。特别是报表查询长期占着旧快照时,要和业务方协商查询窗口,不能只靠调大等待参数掩盖问题。
1-- 备库执行;仅在仍处于 recovery 时调用2SELECT pg_get_wal_replay_pause_state() AS replay_pause_state;结果为 not paused、pause requested 或 paused。有人要求暂停但尚未真正停下时,单看 pg_is_wal_replay_paused() 容易把“已请求”当成“已暂停”;确实暂停后 WAL 仍可能继续接收,磁盘占用会增长。
1-- 备库执行;receiver 未启动时接收 LSN 可能为 NULL2SELECT pg_last_wal_receive_lsn() AS received_lsn,3 pg_last_wal_replay_lsn() AS replayed_lsn,4 pg_wal_lsn_diff(pg_last_wal_receive_lsn(),5 pg_last_wal_replay_lsn()) AS replay_backlog_bytes;接收位置代表流复制收到并同步到磁盘的 WAL,重放位置代表已应用到数据库的 WAL。两者拉开而接收继续前进,重点查备库重放、恢复冲突和 I/O;接收值为 NULL 时,还要看归档恢复是否仍在推进。
1-- 备库执行2SELECT pg_last_xact_replay_timestamp() AS last_replayed_xact_at,3 now() - pg_last_xact_replay_timestamp() AS time_since_replay;主库几小时没写入时,这个时间差也会长,并不代表备库延迟了几小时。先与第 21 条的 LSN 和主库当前写入量对照;没有任何事务曾被重放时,函数会返回 NULL。
1-- 备库执行2SELECT sender_host, status,3 last_msg_send_time, last_msg_receipt_time,4 now() - last_msg_receipt_time AS since_last_message5FROM pg_stat_wal_receiver;最近收不到消息时,检查上游 sender、网络与连接日志。没有写入的主库也会有复制协议状态往来;但一个时间差不能独立定位故障,采样时还要看 receiver 状态和 LSN 是否移动。
1-- 主库执行2SELECT application_name, client_addr, state,3 reply_time, now() - reply_time AS since_reply4FROM pg_stat_replication5ORDER BY application_name;reply_time 是 sender 收到备库最近一次回复的时间。主库仍有 pg_stat_replication 行但反馈长期不更新时,继续到备库查第 23 条和网络链路;这不是重放速度的直接指标。
1-- 主库执行2SELECT application_name, state,3 write_lag, flush_lag, replay_lag,4 sent_lsn, replay_lsn5FROM pg_stat_replication6ORDER BY application_name;三个 lag 是最近 WAL 到各阶段并收到反馈所花的时间,不是“预计几分钟追平”。备库已追平且主库空闲时,它们可能转为 NULL;先看 LSN 差,再按实际同步提交级别解释这些间隔。
1-- 备库执行;startup 进程负责恢复2SELECT pid, backend_type, wait_event_type,3 wait_event, backend_start4FROM pg_stat_activity5WHERE backend_type IN ('startup', 'walreceiver');这能把恢复进程和 receiver 进程对上。wait_event 为空不一定有故障;要连续取样,并结合第 21 条的接收、重放位置判断是否真的卡住。
1-- 备库执行;配置值可能包含现场路径,不要随意对外转发2SELECT name, setting, source3FROM pg_settings4WHERE name IN ('restore_command', 'recovery_target_timeline')5ORDER BY name;流复制断开时,备库可能从归档目标继续读取 WAL。restore_command 有值也不证明文件齐全或命令能正常取回;缺失段要到归档目录和备库日志里核对。
1-- 备库运维账号执行;连接串属于敏感配置2SELECT name, setting, source3FROM pg_settings4WHERE name IN ('primary_conninfo', 'primary_slot_name')5ORDER BY name;预期走复制槽却没有 primary_slot_name 时,主库第 11—14 条的槽读数不能代表这台备库。连接串改动后,还要看 receiver 实际连到哪台上游;配置文件值和运行中连接未必同步。
1-- 主库执行;直接连接的备库每个 WAL sender 一行2SELECT pid, usename, application_name,3 client_addr, client_port, backend_start4FROM pg_stat_replication5ORDER BY application_name;usename 是当前 WAL sender 的登录账号。备库连不进来时,这里可能根本没有行;此时要对照备库 primary_conninfo、主库 pg_hba.conf 和双方日志,而不是假设某个账号已经成功认证。
1-- 主库超级用户执行;规则顺序决定首先匹配哪一条2SELECT rule_number, file_name, line_number,3 type, database, user_name, address,4 auth_method, error5FROM pg_hba_file_rules6WHERE 'replication' = ANY(database)7ORDER BY rule_number NULLS LAST, file_name, line_number;物理复制连接需要匹配 replication 规则,账号和备库源地址也要匹配。这个视图读的是当前文件内容,未必是服务最后加载的版本;改完 HBA 后要重新加载配置并用新连接验证。
1-- 主库超级用户执行2SELECT file_name, line_number, error3FROM pg_hba_file_rules4WHERE error IS NOT NULL5ORDER BY file_name, line_number;如果新增复制规则写错,服务可能仍用旧规则,备库连接继续失败。先处理具体报错行,再核对规则顺序和新连接;空结果只证明当前文件可解析,不证明备库能认证。
1-- 主库或备库超级用户执行;查看当前文件,非运行中最终值2SELECT sourcefile, sourceline, name,3 applied, error4FROM pg_file_settings5WHERE error IS NOT NULL6 OR name IN ('primary_conninfo', 'primary_slot_name',7 'synchronous_standby_names', 'restore_command')8ORDER BY sourcefile, sourceline;applied=false 可能是参数错误,也可能只是被后面的同名参数覆盖;要看 error 和处理顺序。此视图读当前配置文件,不证明服务器运行值已经更新;运行值回到 pg_settings 查。
1-- 主库执行;按 WAL sender PID 对应 TLS 状态2SELECT r.application_name, r.client_addr,3 s.ssl, s.version, s.cipher4FROM pg_stat_replication AS r5JOIN pg_stat_ssl AS s ON s.pid = r.pid6ORDER BY r.application_name;ssl=false 表示该连接没有使用 TLS,不等于复制数据没有经过其他网络层保护。若备库要求 TLS 却连不上,还要对照 primary_conninfo 的 sslmode 和主库 HBA 的 hostssl 规则。
1-- 主库执行;一条槽与使用它的 sender PID 对应2SELECT s.slot_name, s.active, s.restart_lsn,3 r.application_name, r.client_addr, r.state4FROM pg_replication_slots AS s5LEFT JOIN pg_stat_replication AS r6 ON r.pid = s.active_pid7WHERE s.slot_type = 'physical'8ORDER BY s.slot_name;槽名不能只靠命名猜对应哪台备库。active_pid 为 NULL 时通常没有会话在用;如果槽长期不活跃且 restart_lsn 不前进,再按第 12—14 条看 WAL 保留风险。
1-- 主库、备库分别执行2SELECT name, setting, source,3 pending_restart4FROM pg_settings5WHERE name IN ('max_wal_senders', 'max_replication_slots',6 'wal_level', 'archive_mode',7 'hot_standby')8ORDER BY name;这些参数中有些需要重启。pending_restart=true 时,文件里的新值还不能当成运行中生效的值;排查 sender 数量或备库查询能力,要以 setting 为准并安排合适的重启窗口。
1-- 主库查 sender;备库查 receiver2SELECT name, setting, unit, source3FROM pg_settings4WHERE name IN ('wal_sender_timeout', 'wal_receiver_timeout')5ORDER BY name;上游 sender 和下游 receiver 各自会判断对端是否失联。链路抖动时查看超时与日志中的断开、重连时间;一味调大超时会延长故障发现时间,不会解决网络或认证错误。
1-- 备库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name = 'recovery_min_apply_delay';这项不为零时,提交记录会按设定推迟重放;接收 WAL 正常而应用位置落后,可能是预期的延迟备库。它不能等同于当前实际延迟,网络或级联传输本身就慢时,额外等待可能少于设定值。
1-- 备库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name = 'wal_retrieve_retry_interval';流复制、本地 pg_wal 和归档都拿不到下一段 WAL 时,备库按这个间隔重试。日志里周期性出现“找不到 WAL”时,先确认文件缺口和上游连接;调小重试间隔不能补回已经丢失的段。
1-- 备库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name = 'wal_receiver_status_interval';主库 pg_stat_replication 的写入、刷盘、重放位置来自备库反馈;这个参数决定常规状态报告的最长间隔,某些状态变化也会提前发送。主库的 apply 位置可能略落后于备库实际值,切换前应两端都查。
1-- 主库执行;示例原本异步,若现场启用同步复制必须查2SELECT application_name, sync_state, sync_priority,3 state, flush_lsn, replay_lsn4FROM pg_stat_replication5ORDER BY sync_priority, application_name;sync、quorum 和 potential 含义不同。当前备库显示 async 时,不要因为配置里写过 synchronous_standby_names 就认定它已经承担同步确认;故障切换前仍需对比最新刷盘和重放位置。
1-- 主库执行2SELECT pg_current_wal_lsn() AS current_lsn,3 pg_walfile_name(pg_current_wal_lsn()) AS current_segment;段名用于与主库 pg_wal、归档目标和备库所需位置对照。当前段尚未关闭时,不必期待它已经归档;判断归档断档要看已完成的段和实际归档文件。
1-- 主库 pg_monitor 或相应 EXECUTE 权限2SELECT name, modification3FROM pg_ls_archive_statusdir()4WHERE name LIKE '%.ready'5ORDER BY modification;.ready 是等待归档处理的状态文件。队列持续增加时,结合第 16 条的失败次数、归档进程日志和目标存储排查;状态文件存在本身不能证明目标目录有没有完整文件。
1-- 主库 pg_monitor 或相应 EXECUTE 权限2SELECT name, size, modification3FROM pg_ls_waldir()4ORDER BY name;这是主库当前 pg_wal 目录的文件盘点。旧段还在,可能受槽、归档或正常保留策略影响;光看文件数不能定位是哪台备库挡住删除,要回到第 11—14 条看槽需求。
1-- 主库执行;隔几分钟再取一次计算增量2SELECT wal_records, wal_bytes,3 wal_buffers_full, stats_reset4FROM pg_stat_wal;主库 WAL 生成速度突然升高时,备库可能暂时追不上。wal_bytes 是自 stats_reset 起的累计值,不能当成每秒速率;两次采样要确认期间没有重置统计,再用增量解释发送队列。
1-- 主库执行;archive_library 启用时 archive_command 未必是实际归档入口2SELECT name, setting, source, pending_restart3FROM pg_settings4WHERE name IN ('archive_mode', 'archive_command', 'archive_library')5ORDER BY name;archive_mode 开了,还要看实际使用命令还是归档模块。命令写了 cp 不等于文件已经送到目标端;第 16、42 条和归档目标目录要一起核对。归档命令返回成功但目标文件不完整,比显式报错更危险。
1-- 主库 pg_monitor 或相应 EXECUTE 权限2SELECT count(*) AS ready_segments,3 min(modification) AS oldest_ready_time4FROM pg_ls_archive_statusdir()5WHERE name LIKE '%.ready';这是第 42 条文件清单的汇总,适合看积压有没有扩大。它不包含当前尚未关闭的 WAL 段,也不能单凭最老时间估算备库延迟;归档进程是否失败仍要看第 16 条和日志。
1# 在归档目标主机执行;目录按现场 archive_command 或 archive_library 配置替换2ls -lh /var/lib/postgresql/wal-archive/0000000100000000000000A1文件名从第 16 条 last_archived_wal 取,不要照抄示例。主库报归档成功只说明归档程序返回了成功状态;到目标端看大小与文件内容,才能发现路径写错或程序错误地返回零。目标目录若在对象存储,此处改用对应存储的正常查询方式。
1# 在仍保留该 WAL 段的主库、归档目标分别执行,再比较输出2sha256sum /var/lib/postgresql/17/main/pg_wal/0000000100000000000000A13sha256sum /var/lib/postgresql/wal-archive/0000000100000000000000A1只对两端都存在的同一个完整 WAL 段比较,文件名和路径要先核对。主库已回收该段时不能从当前 pg_wal 硬找;应拿可信的其他副本或归档程序自己的校验记录比对。
1-- 主库执行;与第 4 条的 pid、客户端地址对照2SELECT pid, backend_type, application_name,3 client_addr, state, wait_event_type, wait_event4FROM pg_stat_activity5WHERE backend_type = 'walsender'6ORDER BY pid;备库连接显示为 WAL sender。进程存在但复制位点不前进时,看它在等什么,再结合第 5 条的发送位置和备库第 7 条的 receiver 状态。没有进程时,先查连接、认证和主库日志。
1-- 备库执行;状态会随采样时刻变化2SELECT pid, backend_type, wait_event_type, wait_event3FROM pg_stat_activity4WHERE backend_type IN ('startup', 'walreceiver')5ORDER BY backend_type;startup 负责恢复重放,walreceiver 负责接收。这里只是瞬时等待:采样一次看到 I/O 等待不能断定磁盘故障;结合接收与重放 LSN 的多次采样、备库日志和存储指标才有判断价值。
1-- 主库执行;保留量为估算字节数2SELECT slot_name, inactive_since, wal_status,3 pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) AS retained_bytes4FROM pg_replication_slots5WHERE slot_type = 'physical' AND NOT active6ORDER BY retained_bytes DESC NULLS LAST;槽不活跃可能是备库停机,也可能是已退役的备库留下了槽。先确认它归属谁,不能看见积压就直接删除;若备库还会回来,删除槽可能让它失去追赶所需的 WAL。
1-- 主库执行;PostgreSQL 17 字段2SELECT slot_name, active, active_pid, inactive_since3FROM pg_replication_slots4WHERE slot_type = 'physical'5ORDER BY inactive_since NULLS LAST;inactive_since 能帮助区分刚断线和长期无人使用的槽。空值并不代表槽一定正常,活跃槽和从未同步过的槽也可能为空;还要与第 34 条的 sender 进程对上。
1-- 主库执行;只有设置了有限的 max_slot_wal_keep_size 才有意义2SELECT slot_name, wal_status, safe_wal_size,3 pg_size_pretty(safe_wal_size) AS safe_wal_text4FROM pg_replication_slots5WHERE slot_type = 'physical'6ORDER BY safe_wal_size NULLS LAST;safe_wal_size 是距离槽可能失效尚可写入的 WAL 字节数,不是当前磁盘空闲量。无限制保留或已失效的槽会返回空值;此时更该看 wal_status、实际磁盘空间和第 13 条的配置。
1-- 主库执行2SELECT slot_name, wal_status, invalidation_reason, restart_lsn3FROM pg_replication_slots4WHERE slot_type = 'physical'5 AND (wal_status = 'lost' OR invalidation_reason IS NOT NULL);lost 槽已不能继续使用;wal_removed 说明所需 WAL 被移走。先查备库能否从完整归档补齐,不能补时才考虑重新初始化。修改槽名或重连账号,都不会把已丢的 WAL 变回来。
1-- 主库执行2SELECT name, setting, unit, source3FROM pg_settings4WHERE name IN ('wal_keep_size', 'max_slot_wal_keep_size')5ORDER BY name;wal_keep_size 是最低保留量,不能保证一台长期离线的备库一定能追上;槽保留也受 max_slot_wal_keep_size 约束。现场若有可靠且完整的归档,备库还可能通过归档补缺,别只看这两个参数下结论。
1# 备库执行;路径按现场 PostgreSQL 日志目录替换2grep -E 'requested WAL segment|could not restore file|replication terminated' /var/log/postgresql/postgresql-17-main.log | tail -n 30找不到所需 WAL 时,先记下段名和时间线,再到上游 pg_wal 与归档目标找。日志里一次 restore_command 未找到当前段,可能只是备库随后改走流复制;持续重试同一个已丢段才值得按断档处理。
1-- 备库执行;高可用备库通常使用 latest2SELECT name, setting, source3FROM pg_settings4WHERE name = 'recovery_target_timeline';主备切换会产生新时间线。latest 允许备库跟随最新时间线,但它仍要拿到对应 .history 和 WAL;参数正确不能代替归档链验证。
1-- 备库执行2SELECT name, setting, source3FROM pg_settings4WHERE name = 'archive_cleanup_command';共享归档既给备库补 WAL,又服务备份恢复时,清理策略要单独核对。某台备库不再需要一个段,并不表示 PITR 或其他备库也不需要它;不要直接照搬单备库示例清理共享目录。
1-- 主库执行;只显示直接连接到本节点的备库2SELECT application_name, client_addr, backend_xmin,3 state, reply_time4FROM pg_stat_replication5ORDER BY application_name;启用 hot_standby_feedback 后,备库可能把读查询需要的 xmin 报给主库,减少因清理旧版本而取消查询的情况。backend_xmin 长期不前进时要找备库上的长事务;它也可能让主库无法及时清理旧版本。空值先核对备库配置和连接状态。
1-- 备库执行;只看持有 xmin 的普通会话2SELECT pid, datname, usename, state, backend_xmin,3 now() - xact_start AS transaction_age,4 left(query, 160) AS sql_text5FROM pg_stat_activity6WHERE backend_type = 'client backend'7 AND backend_xmin IS NOT NULL8ORDER BY xact_start NULLS LAST;这比只按 query_start 找慢 SQL 更适合排查旧快照:一条查询结束后,事务还没提交,也可能继续占着 xmin。先联系会话所属业务,再评估结束事务的影响;不能看到旧快照就直接终止会话。
1-- 备库执行;统计是累计值2SELECT prefetch, hit, skip_fpw, wal_distance,3 block_distance, io_depth, stats_reset4FROM pg_stat_recovery_prefetch;备库接收 WAL 很快、重放却慢时,可以看看恢复预读是否发生,以及当前预读深度。这里的计数不能单独证明瓶颈在磁盘;还需多次采样接收和重放位置,再看存储延迟、CPU 和恢复进程等待。
1-- 备库执行;无活跃 WAL receiver 时可能查不到行2SELECT status, received_tli, flushed_lsn,3 sender_host, sender_port4FROM pg_stat_wal_receiver;计划切换或已经切换后,received_tli 能说明 receiver 正在接收哪条时间线。查不到行可能正在从归档恢复或上游连接中断;要继续看第 57 条配置、备库日志和实际 .history 文件。
1-- 备库执行;控制文件信息不能代替当前 replay LSN2SELECT min_recovery_end_lsn,3 min_recovery_end_timeline,4 end_of_backup_record_required5FROM pg_control_recovery();从基础备份启动的备库,要先完成控制文件要求的最低恢复位置,才谈得上可用。这里读的是控制文件记录,不能拿 min_recovery_end_lsn 当成当前重放位置;当前接收与重放位置仍看第 8、21 条。
1-- 主库、备库分别执行;需有控制信息函数的 EXECUTE 权限2SELECT system_identifier, pg_control_last_modified3FROM pg_control_system();两端 system_identifier 应一致。误把另一套备库接进来时,这个值能直接暴露集群身份不符。它不证明备库已经追平,也不能代替版本、时间线和应用连接检查。
1-- 主库、备库分别执行;结果是最近检查点状态2SELECT checkpoint_lsn, redo_lsn, redo_wal_file,3 timeline_id, prev_timeline_id, checkpoint_time4FROM pg_control_checkpoint();切换前保留这份基线,有助于回头确认节点原来在哪条时间线。检查点记录不等于实时复制位置;判断数据差距,仍要比较主库当前 WAL 与备库已刷盘、已重放的 LSN。
1-- 主库、备库分别执行2SELECT bytes_per_wal_segment,3 database_block_size, data_page_checksum_version4FROM pg_control_init();WAL 段大小和初始化参数属于集群基础信息。看段文件大小、规划归档容量时先核对,不要默认每个环境都是 16 MB。若主备来自同一基础备份,这些值应匹配;异常时先核对数据目录是否找对。
1-- 备库执行;正在从归档恢复时可能没有 receiver 行2SELECT slot_name, sender_host, sender_port,3 status, latest_end_lsn, latest_end_time4FROM pg_stat_wal_receiver;级联复制环境尤其要看这里:备库连接的是上游级联备库还是原主库,决定后续到哪个节点查 sender、复制槽和缺失 WAL。latest_end_lsn 是 receiver 报告的位置,不等于这台备库已经重放的终点。
1-- 当前主库执行;逐个记录直接连接的备库2SELECT application_name, client_addr, state,3 sync_state, sent_lsn, flush_lsn, replay_lsn4FROM pg_stat_replication5ORDER BY application_name;切换后不只要业务连接改向,还要让其他备库找到新上游。这里的 pg_stat_replication 不含级联下游;有级联拓扑时,需在每个中间节点另外查询,免得漏了一台。
1-- 拟提升的备库执行2SELECT name, setting, pending_restart3FROM pg_settings4WHERE name IN ('max_wal_senders', 'max_replication_slots',5 'wal_level', 'max_connections')6ORDER BY name;被提升后它要给下游发送 WAL,容量不能只按当前只读业务算。pending_restart=true 表示改了配置却尚未生效;切换当场才发现 sender 或槽不够,会让下游连接失败。
1-- 拟提升的备库执行;核对目标存储是否仍可写2SELECT name, setting, pending_restart3FROM pg_settings4WHERE name IN ('archive_mode', 'archive_command', 'archive_library')5ORDER BY name;备库提升成主库后,归档链也要继续。参数看着完整,还得查提升后的归档目标是否允许该节点写入,并避免与旧主库向同一归档路径写入不同内容。归档命令返回零,只有在目标文件确实完整时才算成功。
1-- 主库执行;先由业务和代理层确认写入已停止2SELECT pg_current_wal_flush_lsn() AS stop_lsn,3 clock_timestamp() AS sampled_at;stop_lsn 是主库当时已刷到持久存储的 WAL 位置。必须在确认业务不再写入后取样,否则刚记完位置又产生新事务,这个值就不是切换终点。记录取样时间和应用冻结证据,后面才能解释备库差多少。
1-- 拟提升的备库执行;在第 71 条之后连续采样2SELECT pg_last_wal_receive_lsn() AS received_lsn,3 pg_last_wal_replay_lsn() AS replayed_lsn,4 clock_timestamp() AS sampled_at;接收位置达到主库 stop_lsn,只说明流复制 WAL 已收到并同步到磁盘;业务可见的终点还要看重放位置。备库也可能通过归档拿 WAL,此时流复制接收位置为空或停住,不能凭它一项判定已断档。
1-- 拟提升的备库执行;示例 LSN 换成第 71 条记录的 stop_lsn2SELECT pg_wal_lsn_diff('0/16B6C50'::pg_lsn,3 pg_last_wal_replay_lsn()) AS bytes_to_replay;正数表示备库尚未重放到预定终点,零表示到达;负数表示它已经超过该位置。LSN 差是字节数,不是秒数。主库若还在产生 WAL,就不能把零差距当成“切换不会丢数据”。
1-- 拟提升的备库执行;从业务连接入口也要做一次连接检查2SELECT pg_is_in_recovery() AS standby,3 current_setting('transaction_read_only') AS transaction_read_only,4 inet_server_addr() AS server_addr,5 inet_server_port() AS server_port;切换前应仍在恢复模式,业务读连接也应落到预期节点。inet_server_addr() 通过 Unix socket 登录时可能为空;这条只核对当前连接,不能证明代理或 DNS 上所有业务连接都已切好。
1-- 原主库执行;application_name 换成这台备库实际名称2SELECT application_name, state, sent_lsn,3 write_lsn, flush_lsn, replay_lsn, reply_time4FROM pg_stat_replication5WHERE application_name = 'standby1';对照第 71 条终点与四段位置,可看出 WAL 卡在发送、写入、刷盘还是重放。原主库不可达时这条无法执行;要按备库本地日志、归档和最后记录的位置评估可能的数据损失,不能声称零丢失。
1# 拟提升的备库执行;数据目录按现场替换2df -h /var/lib/postgresql/17/main/pg_wal待重放 WAL、延迟应用和下游槽都可能占空间。提升前看的是备库 pg_wal 所在文件系统,而不只是数据目录;如果 pg_wal 是单独挂载或符号链接,要确认路径解析到实际卷。
1-- 拟提升的备库执行;只在 recovery 期间调用2SELECT pg_get_wal_replay_pause_state() AS pause_state,3 pg_last_wal_replay_lsn() AS replayed_lsn;结果为 pause requested 或 paused 时,先查清谁要求暂停、原因是什么。直接提升会结束暂停并继续处理 WAL,但不代表业务已经同意把该备库作为新主库;切换终点仍须重新核对。
1# 原主库执行;数据目录按现场替换2pg_ctl -D /var/lib/postgresql/17/main status这条适用于原主库仍可操作的计划切换。故障切换时若主库不可达,必须由集群管理、主机或网络层确认它不能继续承接写入;备库提升后让旧主库带着原角色重新上线,会形成双主。
1# 原主库软件属主执行;已冻结写入、备库追平并确认切换窗口2pg_ctl -D /var/lib/postgresql/17/main stop -m fast -wfast 会回滚活跃事务并断开客户端。停库完成还要验证代理或业务入口不再把写请求送向原主库;故障切换若原主库不可操作,不能把“命令没执行”误写成“它已经停止”。
1-- 拟提升的备库执行;原主库已停止或隔离后再执行2SELECT pg_promote(true, 60) AS promoted;true 表示等待提升完成,最多等 60 秒;返回 false 要查日志和当前恢复状态,不能继续默认提升成功。提升后要立即核对新主库角色、业务入口和归档,而不是只看函数返回值。
1-- 新主库执行2SELECT pg_is_in_recovery() AS still_standby,3 current_setting('transaction_read_only') AS transaction_read_only;still_standby=false 才说明该连接所在实例不再是备库。若 transaction_read_only 仍为 on,还要检查会话、数据库或角色的只读设置;不应直接把所有业务写流量切过来。
1-- 新主库执行;最近检查点信息可能略晚于提升时刻2SELECT timeline_id, prev_timeline_id,3 checkpoint_lsn, redo_wal_file, checkpoint_time4FROM pg_control_checkpoint();提升会产生新的 WAL 时间线,后续备库要跟上这条新分支。检查点时间线是控制文件记录;现场还应查看提升日志与 .history 文件,并保留原主库第 65 条基线作对照。
1-- 新主库执行;业务写入恢复后隔一段时间再采样2SELECT pg_current_wal_lsn() AS written_lsn,3 pg_current_wal_flush_lsn() AS flushed_lsn,4 clock_timestamp() AS sampled_at;没有新业务写入时,两个位置不变化是正常的。写入恢复后若持续没有进展,先核对业务是否真的连到新主库,再查事务错误、存储和 WAL 日志。单看 LSN 前进也不能证明业务功能正常。
1-- 新主库执行;与切换前第 70 条归档配置对照2SELECT archived_count, last_archived_wal,3 last_archived_time, failed_count,4 last_failed_wal, last_failed_time5FROM pg_stat_archiver;归档统计是累计值,提升后连续采样才知道是否继续成功。当前 WAL 段还没关闭时,last_archived_time 不更新不一定是故障;若 .ready 积压或失败计数增长,立即到归档目标查路径、权限和文件完整性。
1# 在业务应用主机执行;连接串使用现场代理或数据库服务地址2psql 'host=db-writer.internal port=5432 dbname=appdb user=app_readonly' \3 -c "SELECT inet_server_addr(), inet_server_port(), pg_is_in_recovery();"这里用只读账号核对入口落点,不需要为了检查路由就执行写操作。代理可能保留旧连接,应用还要确认连接池完成重连;一条新连接成功,不等于所有旧会话都已经迁走。
1-- 新主库执行;按现场业务角色筛选2SELECT pid, usename, client_addr, backend_start,3 state, wait_event_type, wait_event4FROM pg_stat_activity5WHERE backend_type = 'client backend'6 AND usename = 'app_user'7ORDER BY backend_start;看客户端地址、连接开始时间,可以判断切换后新连接是否真的进来了。结果为空时,先查代理、DNS 和应用连接池;结果有行,也不能仅凭会话存在证明读写业务都正常。
1-- 新主库执行;将清单与第 68 条记录的下游备库逐一对照2SELECT slot_name, slot_type, active, wal_status,3 restart_lsn, inactive_since4FROM pg_replication_slots5WHERE slot_type = 'physical'6ORDER BY slot_name;原主库上的物理槽不会因为备库提升就自动迁到新主库。下游备库若仍指定旧槽名,要在新拓扑中明确谁创建和维护该槽;不能看到下游暂时连上就忽略其后续 WAL 保留风险。
1-- 新主库执行;下游上游地址改好后再查2SELECT application_name, client_addr, state,3 sent_lsn, flush_lsn, replay_lsn, reply_time4FROM pg_stat_replication5ORDER BY application_name;切换后逐台核对下游备库的连接地址和四段 LSN。state=streaming 只说明 WAL sender 在发送,备库是否追平还要看它自己接收、重放的位置。级联下游仍需到其直接上游查询。
1-- 旧主库仍可连接时执行;若已停止,读取停库前留存的配置和控制信息2SELECT current_setting('wal_log_hints') AS wal_log_hints,3 current_setting('full_page_writes') AS full_page_writes,4 data_page_checksum_version5FROM pg_control_init();pg_rewind 要求旧主库启用 wal_log_hints 或初始化时开启数据校验和,并保持 full_page_writes=on。这条只核对基本条件;旧主库还要能干净停机,并有分叉点之后所需 WAL。旧主库不可达时不能声称这些条件已满足。
1# 旧主库主机执行;数据目录按现场替换2pg_controldata /var/lib/postgresql/17/main | grep 'Database cluster state'输出 shut down 才是控制文件记录的干净停机状态;in production 或异常关机状态要先查明。控制文件读数不证明网络、代理已经隔离旧写入口,仍需按高可用系统的隔离记录核对。
1# 旧主库软件属主执行;旧主库已停,新主库正在运行2pg_rewind --dry-run \3 --target-pgdata=/var/lib/postgresql/17/main \4 --source-server='host=new-primary.internal port=5432 dbname=postgres user=rewind_user'--dry-run 不修改旧主库数据目录,可先发现权限、时间线和 WAL 缺口。预演通过不等于实际回归一定成功;还要留好旧主库数据目录备份,并核对连接账号的授权与归档可用性。
1# 旧主库软件属主执行;已完成第 89—91 条检查和数据目录留存2pg_rewind --target-pgdata=/var/lib/postgresql/17/main \3 --source-server='host=new-primary.internal port=5432 dbname=postgres user=rewind_user' \4 --write-recovery-conf --progress这是实际修改旧主库数据目录的命令。--write-recovery-conf 会写入备库启动标记和连接设置;完成后仍须核对上游地址、账号和本地特有配置。中途失败时目标目录可能不可恢复,应改走新基础备份,不能对半成品反复启动。
1# 旧主库主机执行;pg_rewind -R 成功后检查2test -f /var/lib/postgresql/17/main/standby.signal && echo 'standby.signal present'文件存在说明启动时会进入备库模式,但它不能证明 primary_conninfo 指向新主库,也不能证明所需 WAL 已齐。启动前还要检查被 pg_rewind 从新主库复制过来的配置和本地证书、挂载路径。
1# 旧主库软件属主执行;连接配置、归档、数据目录和业务隔离已核对2pg_ctl -D /var/lib/postgresql/17/main start -w启动前必须确保旧写入口仍被隔离。pg_ctl 返回成功只说明实例启动,不能证明它正确连接新主库;接着要看恢复角色和 receiver。若现场由 systemd 管理,以该实例的正常服务管理方式启动。
1-- 原主库回归后的备库执行2SELECT pg_is_in_recovery() AS now_standby,3 pg_last_wal_replay_lsn() AS replayed_lsn;now_standby=true 是回归后的第一项角色验收。重放位置可能还在追赶,不能看到备库角色就立即宣布高可用恢复;还要检查 receiver、归档和新主库 sender。
1-- 原主库回归后的备库执行2SELECT status, sender_host, sender_port,3 slot_name, flushed_lsn, latest_end_lsn4FROM pg_stat_wal_receiver;上游应是新主库或规划中的级联节点。没有 receiver 行时可能正在从归档恢复,也可能连接配置错误;看备库日志和 primary_conninfo,不能只靠这条输出判断。
1-- 新主库执行;application_name 按回归备库实际名称核对2SELECT application_name, client_addr, state,3 sent_lsn, flush_lsn, replay_lsn, reply_time4FROM pg_stat_replication5WHERE application_name = 'former-primary';备库在新主库上出现,说明复制连接建立;四段 LSN 还需继续推进。名称如果与现场配置不符,查询为空不能直接认定没有连接,应先列出 sender 清单核对地址。
1-- 新主库执行;只对这台直接连接的回归备库估算2SELECT application_name,3 pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_gap_bytes4FROM pg_stat_replication5WHERE application_name = 'former-primary';差值是字节量。业务持续写入时它未必降到零,要多次取样,看备库是否能稳定追上;若 gap 增大,还要分清发送、接收和重放哪一段变慢。
1-- 新主库执行;slot_name 以第 96 条 receiver 回读为准2SELECT slot_name, active, active_pid,3 wal_status, restart_lsn4FROM pg_replication_slots5WHERE slot_name = 'former_primary_slot';使用物理槽的拓扑要看槽是否活跃,以及仍保留哪段 WAL。备库没用槽时这条可以为空,但必须确认现场采取什么 WAL 保留和归档方案;槽长期不活跃又无限保留,会把新主库磁盘占满。
1-- 原主库回归后的备库执行;连续采样观察进展2SELECT pg_last_wal_receive_lsn() AS received_lsn,3 pg_last_wal_replay_lsn() AS replayed_lsn,4 pg_wal_lsn_diff(pg_last_wal_receive_lsn(),5 pg_last_wal_replay_lsn()) AS apply_gap_bytes;接收与重放都在推进,才说明这台新备库在追赶。若它主要从归档取 WAL,接收 LSN 可能为空或滞后,此时须结合恢复日志和实际重放位置判断;回归验收还包括归档、业务连接和后续备份演练。
流复制出问题,先看主库 WAL 写到哪儿、sender 送到哪儿,再看备库收到了多少、重放了多少。复制槽和归档决定备库断线后还能不能追上;切换前必须记下写入终点,提升后还要查业务连接、归档和旧主库回归。只看到 streaming,离验收还差好几步。
需要其他数据库场景的 100 条命令,可以到 ORA100 · DBA100 查:
微信小程序里搜索 「三笠的百令册」,临时排障时也方便翻。