高可用 & 容灾29 分钟阅读
Oracle RAC 日常运维与故障排查 100 条命令
Oracle RAC(Real Application Clusters)是 Oracle 数据库常用的高可用集群架构。多个数据库实例运行在不同节点上,共同访问一套数据库存储。单个节点或实例发生故障时,业务服务可以转移到其他实例继续运行。
2026年9月15日阅读—点赞—收藏—
dba100oraclescenario
100 条命令系列文章专栏
Oracle RAC(Real Application Clusters)是 Oracle 数据库常用的高可用集群架构。多个数据库实例运行在不同节点上,共同访问一套数据库存储。单个节点或实例发生故障时,业务服务可以转移到其他实例继续运行。
Oracle RAC(Real Application Clusters)是 Oracle 数据库常用的高可用集群架构。多个数据库实例运行在不同节点上,共同访问一套数据库存储。单个节点或实例发生故障时,业务服务可以转移到其他实例继续运行。
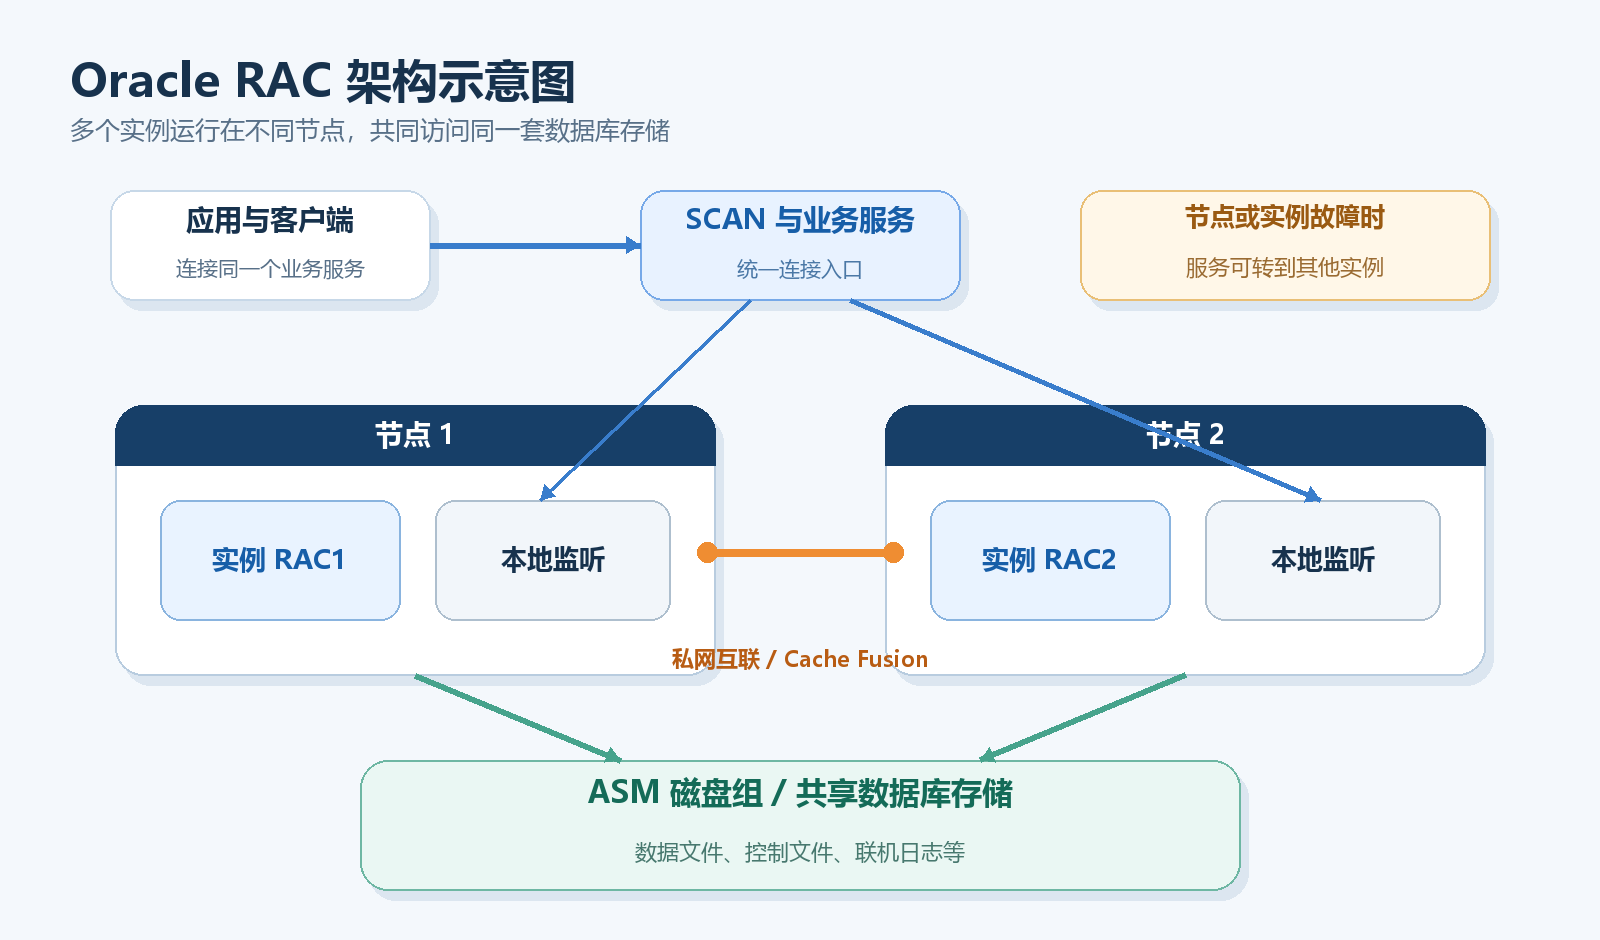 Oracle RAC 架构示意图
RAC 运维不能只看数据库实例是否 OPEN。Clusterware 资源、ASM、节点互联、SCAN 监听和数据库服务都有各自的状态;实例正常而服务没有注册,应用照样连不上。跨实例阻塞和 gc 等待过高,则要到数据库内部继续查。
本文整理了 RAC 日常巡检和故障排查常用的 100 条命令,覆盖集群资源、ASM、网络监听、数据库服务、跨实例会话和 Cache Fusion,建议收藏备用。
文中以 Linux、Oracle Database 19c 和 Grid Infrastructure 19c 为例,集群采用 administrator-managed 模式。$GRID_HOME、$DB_HOME、数据库名、实例名及服务名请根据实际环境修改。
1# grid;当前集群2# -s 查看节点是否活动;-t 查看是否 pinned3$GRID_HOME/bin/olsnodes -n -s -tolsnodes 读取集群节点清单。节点不在列表中时,先检查 Grid Infrastructure 配置和本节点集群栈。
1# grid;当前节点2$GRID_HOME/bin/olsnodes -l1# grid;当前集群2$GRID_HOME/bin/olsnodes -c1# grid;当前节点2$GRID_HOME/bin/crsctl check crs本节点的 OHAS、CRS、CSS 和 EVM 都应处于正常状态。某个组件离线时,再查看对应日志,不要直接重启整套集群。
1# grid;当前集群2$GRID_HOME/bin/crsctl check cluster -all该命令会检查所有节点。单个节点失败时,先确认主机是否可达,再到故障节点执行上一条命令。
1# grid;当前集群2# 滚动升级、补丁操作期间,活动版本可能尚未推进3$GRID_HOME/bin/crsctl query crs activeversion -f滚动升级或补丁期间,各节点软件版本可能不同,但集群活动版本只会在升级完成后推进。
1# grid;指定节点2$GRID_HOME/bin/crsctl query crs softwareversion "$NODE_NAME"1# grid;指定节点2$GRID_HOME/bin/crsctl query crs softwarepatch "$NODE_NAME"1# grid;当前节点2$GRID_HOME/bin/crsctl query crs releaseversion1# grid;当前节点2$GRID_HOME/bin/crsctl config crs这里查看的是节点重启后 Clusterware 是否自动启动,不是当前运行状态。
1# grid;当前集群2$GRID_HOME/bin/crsctl status resource -t资源显示为 OFFLINE,不一定就是故障。先看资源的 TARGET、所在节点和依赖关系,再判断是否需要处理。
1# grid;指定资源2$GRID_HOME/bin/crsctl status resource "$RESOURCE_NAME" -p配置属性包括资源类型、启动策略、放置规则和依赖关系。修改资源前,先保存这份输出。
1# grid;指定资源2$GRID_HOME/bin/crsctl status resource "$RESOURCE_NAME" -v1# grid;指定资源2$GRID_HOME/bin/crsctl status resource "$RESOURCE_NAME" -dependency资源本身没有报错时,也可能因为依赖资源未启动而保持 OFFLINE。依赖关系要和第 11 条一起看。
1# grid;指定节点2$GRID_HOME/bin/crsctl status server "$NODE_NAME" -f1# grid;当前集群2$GRID_HOME/bin/crsctl status serverpool1# oracle;当前集群2$DB_HOME/bin/srvctl config database1# oracle;指定数据库2$DB_HOME/bin/srvctl config database -db "$DB_UNIQUE_NAME"重点检查数据库唯一名、Oracle Home、SPFILE、管理策略和实例列表是否与实际环境一致。
1# oracle;指定数据库的所有实例2$DB_HOME/bin/srvctl status database -db "$DB_UNIQUE_NAME" -detail该命令显示实例运行节点和打开状态。-detail 还会给出 ASM 连接等附加信息。
1# grid;当前集群2$GRID_HOME/bin/srvctl status asm -detail1# root;集群 OCR;离线维护检查2# 按官方要求,在所有节点 CRS 栈离线的维护条件下检查3# 在线更新 OCR 时可能出现误报;root 才执行逻辑一致性检查4$GRID_HOME/bin/ocrcheckocrcheck 用于检查 OCR 状态。生产集群在线时不要把短暂的访问异常直接判断为 OCR 损坏。
1# root;集群 OCR;只列记录,不验证可恢复性2$GRID_HOME/bin/ocrconfig -showbackup这里列出的是 OCR 备份记录。恢复前还要确认备份文件实际存在,并且可以从计划恢复的节点访问。
1# root;当前节点;离线维护检查2# 本节点 CRS、OHAS 栈均离线后执行3$GRID_HOME/bin/ocrcheck -localOLR 位于各节点本地,检查结果只代表当前节点,不能替代其他节点的检查。
1# root;当前节点 OLR2# -local 只能与 manual 配合;其他节点需分别检查3$GRID_HOME/bin/ocrconfig -local -showbackup manual1# grid;当前集群2$GRID_HOME/bin/crsctl query css votediskVoting Disk 应显示为 ONLINE。位置在 ASM 磁盘组时,继续检查对应磁盘组和磁盘状态。
1# grid;当前连接的 ASM 实例2# ORACLE_HOME 指向 GRID_HOME,ORACLE_SID 指向本节点 ASM 实例3$GRID_HOME/bin/asmcmd lsdg除了可用空间,还要看磁盘组是否在预期实例上挂载。空间接近满时,再查文件类型和增长来源。
1# grid;当前连接的 ASM 实例2$GRID_HOME/bin/asmcmd lsdsk -p同一块磁盘在不同节点上应能被一致识别。路径或 HEADER_STATUS 异常时,先检查存储和多路径。
1# grid;指定磁盘组;查询 GV$ASM_CLIENT2$GRID_HOME/bin/asmcmd lsct -g "$DISKGROUP"1# grid;本地 ASM 客户端打开的文件2$GRID_HOME/bin/asmcmd lsof -G "$DISKGROUP"1# grid;当前 ASM 实例的 rebalance 等操作2$GRID_HOME/bin/asmcmd lsopASM rebalance、resize 等操作会出现在这里。SOFAR 和 EST_WORK 可以用来观察进度。
1-- 以下 SQL 默认在 CDB$ROOT 执行;非 CDB 直接在本库执行2SELECT inst_id, instance_name, host_name,3 version, status, database_status, startup_time4FROM gv$instance5ORDER BY inst_id;启动时间不同不一定异常,可能是节点或实例刚做过维护。需要结合告警日志确认原因。
1SELECT name, db_unique_name, database_role,2 open_mode, log_mode, cdb3FROM v$database;1SELECT inst_id, name, value2FROM gv$parameter3WHERE name IN ('cluster_database', 'cluster_database_instances')4ORDER BY name, inst_id;cluster_database 在 RAC 实例中应为 TRUE。参数不一致时,还要区分内存值和 SPFILE 中的持久化值。
1SELECT inst_id, name, value2FROM gv$parameter3WHERE name IN ('instance_number', 'thread', 'undo_tablespace')4ORDER BY inst_id, name;INSTANCE_NUMBER、THREAD 和 UNDO_TABLESPACE 应与实例一一对应。配置串位时,实例可能无法正常启动。
1SELECT inst_id, name, value2FROM gv$parameter3WHERE name IN ('local_listener', 'remote_listener')4ORDER BY name, inst_id;LOCAL_LISTENER 和 REMOTE_LISTENER 决定实例向哪里注册服务。RAC 通常通过 REMOTE_LISTENER 指向 SCAN。
1-- 参数值单位:字节;0 需结合所用内存管理方式判断2SELECT inst_id, name, value3FROM gv$parameter4WHERE name IN ('sga_target', 'sga_max_size',5 'pga_aggregate_target', 'pga_aggregate_limit',6 'memory_target', 'memory_max_target')7ORDER BY name, inst_id;SGA、PGA 可以按实例设置。差异是否合理,要结合节点规格和实例负载判断。
1-- MAX_UTILIZATION 为实例启动后的峰值2SELECT inst_id, resource_name,3 current_utilization, max_utilization, limit_value4FROM gv$resource_limit5WHERE resource_name IN ('processes', 'sessions')6ORDER BY resource_name, inst_id;当前值要和 LIMIT_VALUE 一起看。接近上限时,继续检查连接来源,不能只调大参数。
1-- 在 CDB$ROOT 查询;同一 PDB 在不同实例上的状态可能不同2SELECT inst_id, con_id, name, open_mode, restricted, open_time3FROM gv$pdbs4ORDER BY con_id, inst_id;同一个 PDB 在不同实例上的打开状态可能不同。使用保存状态后,也要确认各实例是否按预期打开。
1-- 这里是持久化配置,当前生效值需与 GV$PARAMETER 对照2SELECT sid, name, value, ordinal3FROM v$spparameter4WHERE isspecified = 'TRUE'5 AND sid <> '*'6ORDER BY name, sid, ordinal;V$SPPARAMETER 显示 SPFILE 中保存的值。这里查到的是持久化配置,还要与当前内存参数对照。
1-- SERVICE_NAMES 不等于完整业务服务清单;业务服务见第 51、53 条2SELECT inst_id, name, value3FROM gv$parameter4WHERE name IN ('db_name', 'db_unique_name',5 'instance_name', 'service_names')6ORDER BY name, inst_id;SERVICE_NAMES 不能代替完整的数据库服务清单。业务服务仍应使用 srvctl config service 查看。
1# grid;当前集群2$GRID_HOME/bin/srvctl config scanSCAN 名称通常解析出多个地址。客户端连接串应使用 SCAN,不应固定写某个节点 VIP。
1# grid;当前集群2$GRID_HOME/bin/srvctl status scanSCAN VIP 会分布在集群节点上,节点故障后可以漂移。当前所在节点以命令输出为准。
1# grid;当前集群2$GRID_HOME/bin/srvctl config scan_listener1# grid;当前集群2$GRID_HOME/bin/srvctl status scan_listener这里看到的是 Clusterware 中 SCAN Listener 的状态。还要确认监听端口是否存在,以及服务有没有正常注册。
1# grid;指定节点2$GRID_HOME/bin/srvctl config vip -node "$NODE_NAME"节点 VIP 用于客户端连接故障快速返回。VIP 异常时,同时检查公网网卡和对应网络资源。
1# grid;指定节点的 VIP;实际运行位置见输出2$GRID_HOME/bin/srvctl status vip -node "$NODE_NAME"1# grid;当前集群2$GRID_HOME/bin/srvctl config network1# grid;指定节点监听资源2$GRID_HOME/bin/srvctl config listener -listener "$LISTENER_NAME"1# grid;指定节点、指定监听器2$GRID_HOME/bin/srvctl status listener \3 -listener "$LISTENER_NAME" -node "$NODE_NAME"srvctl 用来查看监听资源状态。需要确认监听里注册了哪些服务时,在监听所在节点执行 lsnrctl status。
1# grid;当前集群2$GRID_HOME/bin/oifcfg getifoifcfg 标记网卡的 public 或 cluster_interconnect 用途。网卡名称应在所有节点保持一致。
1# oracle;指定数据库2$DB_HOME/bin/srvctl config service -db "$DB_UNIQUE_NAME"首选实例和可用实例决定服务正常运行及故障转移位置。修改前先和应用负责人确认连接策略。
1# oracle;指定数据库2$DB_HOME/bin/srvctl status service -db "$DB_UNIQUE_NAME" -verbose配置正确不代表服务已经运行,这条命令用来确认服务当前实际落在哪个实例。
1SELECT inst_id, con_id, name, network_name,2 goal, clb_goal, blocked3FROM gv$active_services4ORDER BY name, inst_id;GV$ACTIVE_SERVICES 显示各实例当前活动的服务。BLOCKED=YES 时,新连接不会再分配到该服务。
1-- ACTIVE 表示会话活跃,不能据此认定正在占用 CPU2SELECT inst_id, con_id, service_name, status,3 COUNT(*) AS sessions4FROM gv$session5WHERE type = 'USER'6GROUP BY inst_id, con_id, service_name, status7ORDER BY service_name, inst_id, status;连接分布不用追求每个实例完全一样。重点看新连接是否长期只落在一个实例,以及服务配置是否符合预期。
1SELECT inst_id, con_id, service_name, machine, program,2 COUNT(*) AS sessions3FROM gv$session4WHERE type = 'USER'5GROUP BY inst_id, con_id, service_name, machine, program6ORDER BY sessions DESC;按程序统计可以发现连接池是否集中在某个实例。程序名不规范时,还要结合 MACHINE、MODULE 和 SERVICE_NAME。
1-- 原值单位:微秒;按服务统计的可见范围取决于统计聚合配置2-- 累计值需两次采样取差值,不能当作当前 CPU 使用率3SELECT inst_id, con_id, service_name,4 ROUND(value / 1000000, 2) AS db_cpu_seconds5FROM gv$service_stats6WHERE stat_name = 'DB CPU'7ORDER BY db_cpu_seconds DESC;CPU 数值为累计统计,适合比较服务之间的消耗。判断短时问题需要结合采样区间。
1-- DBTIMEPERCALL、CPUPERCALL 原值为微秒;以下换算为毫秒2SELECT inst_id, con_id, service_name, begin_time, end_time,3 ROUND(intsize_csec / 100, 1) AS interval_seconds,4 ROUND(dbtimepercall / 1000, 3) AS db_time_per_call_ms,5 ROUND(cpupercall / 1000, 3) AS cpu_per_call_ms,6 ROUND(callspersec, 2) AS calls_per_sec7FROM gv$servicemetric8WHERE intsize_csec BETWEEN 5000 AND 70009ORDER BY service_name, inst_id;服务指标按实例返回。比较每次调用耗时和调用次数,可以看出问题集中在哪个服务和实例。
1# oracle;指定服务2# 只做预测,不触发服务故障,也不验证客户端重连3$DB_HOME/bin/srvctl predict service \4 -db "$DB_UNIQUE_NAME" -service "$SERVICE_NAME" -verboseDBMS_SERVICE.GET_SERVICE_RCB_GOAL 返回服务故障对连接的影响评估,不能替代真实的切换演练。
1# oracle;指定数据库2# 此处显示资源配置中的环境变量,不是当前 shell 的环境3$DB_HOME/bin/srvctl getenv database -db "$DB_UNIQUE_NAME"1# grid;当前节点的指定监听器2$GRID_HOME/bin/lsnrctl services "$LISTENER_NAME"1-- LAST_CALL_ET 为会话进入 ACTIVE 状态后的秒数,不是当前 SQL 的精确耗时2SELECT inst_id, con_id, sid, serial#, username,3 service_name, sql_id, event, state, last_call_et4FROM gv$session5WHERE type = 'USER'6 AND status = 'ACTIVE'7ORDER BY inst_id, last_call_et DESC;RAC 环境使用 GV$SESSION 才能看到全部实例。保留 INST_ID,后续处理会话时需要用到。
1-- SID 需要与 INST_ID 一起定位;只使用有效阻塞标识2SELECT inst_id, con_id, sid, serial#, sql_id, event,3 blocking_instance, blocking_session4FROM gv$session5WHERE blocking_session_status = 'VALID'6ORDER BY blocking_instance, blocking_session, inst_id, sid;BLOCKING_INSTANCE 和 BLOCKING_SESSION 要一起使用,才能定位另一个实例上的阻塞会话。
1-- 阻塞会话可能已空闲,其 SQL_ID 不一定是持锁语句2SELECT w.inst_id AS wait_inst, w.con_id AS wait_con,3 w.sid AS wait_sid, w.serial# AS wait_serial,4 w.sql_id AS wait_sql_id, w.event,5 b.inst_id AS block_inst, b.con_id AS block_con,6 b.sid AS block_sid, b.serial# AS block_serial,7 b.username, b.status, b.sql_id AS block_sql_id,8 b.prev_sql_id AS block_prev_sql_id9FROM gv$session w10LEFT JOIN gv$session b11 ON b.inst_id = w.blocking_instance12 AND b.sid = w.blocking_session13WHERE w.blocking_session_status = 'VALID'14ORDER BY block_inst, block_sid, wait_inst, wait_sid;RAC 阻塞可能跨实例。只查本地 V$SESSION,容易漏掉另一实例上的阻塞源。
1-- USED_UBLK 是 UNDO 块数,不是字节;START_TIME 为事务开始时间2SELECT s.inst_id, s.con_id, s.sid, s.serial#, s.username,3 s.status, s.sql_id, t.start_time,4 t.used_ublk, t.used_urec5FROM gv$transaction t6JOIN gv$session s7 ON s.inst_id = t.inst_id8 AND s.saddr = t.ses_addr9 AND s.con_id = t.con_id10ORDER BY t.used_ublk DESC;长事务会占用 UNDO,也可能阻止清理旧版本。结合开始时间、使用块数和对应会话继续排查。
1-- REQUEST > 0 表示锁请求;不能仅凭 ID1、ID2 认定阻塞者2SELECT inst_id, con_id, sid, type, id1, id2,3 lmode, request, block, ctime4FROM gv$lock5WHERE request > 06ORDER BY type, id1, id2, inst_id;这里显示的是正在等待的锁请求。拿到会话编号后,再查对应事务和 SQL,避免直接终止会话。
1-- 先连接目标业务 PDB;非 CDB 可在本库执行2-- LOCKED_MODE 为对象上的 TM 锁模式,不是行锁数量3SELECT l.inst_id, l.con_id, l.session_id AS sid,4 l.oracle_username, o.owner, o.object_name,5 o.object_type, l.locked_mode6FROM gv$locked_object l7JOIN dba_objects o ON o.object_id = l.object_id8WHERE l.con_id = TO_NUMBER(SYS_CONTEXT('USERENV', 'CON_ID'))9ORDER BY o.owner, o.object_name, l.inst_id;GV$LOCKED_OBJECT 只反映当前锁定对象。行级锁具体阻塞关系仍要结合会话和事务视图。
1-- :sql_id 为目标 SQL;:con_id 为目标容器,非 CDB 为 02-- ELAPSED_TIME 为游标累计微秒,含并行进程累计时间3SELECT inst_id, con_id, sql_id, child_number,4 plan_hash_value, executions,5 ROUND(elapsed_time / 1000000, 2) AS elapsed_seconds,6 buffer_gets, disk_reads, last_active_time7FROM gv$sql8WHERE sql_id = :sql_id9 AND con_id = :con_id10ORDER BY inst_id, child_number;同一个 SQL 在不同实例上可能产生不同 child cursor。计划不一致时,重点比较环境、绑定和优化器参数。
1SELECT inst_id, con_id, sid, serial#, service_name,2 sql_id, sql_child_number, sql_exec_start,3 sql_exec_id, event, state4FROM gv$session5WHERE sql_id = :sql_id6 AND con_id = :con_id7 AND status = 'ACTIVE'8ORDER BY inst_id, sid;结果为空,只能说明采样时没有发现该 SQL 正在执行,不代表 SQL 从未在这些实例运行。
1-- 连接第 67 条查到的实例和容器后执行;此函数不跨实例取计划2-- ALLSTATS LAST 仅在已收集执行统计时显示实际行数等信息3SELECT *4FROM TABLE(DBMS_XPLAN.DISPLAY_CURSOR(5 :sql_id, :child_number, 'ALLSTATS LAST'));执行计划来自指定实例的游标缓存。SQL 在多个实例运行时,应分别检查各实例的 child cursor。
1SELECT inst_id AS worker_inst, con_id,2 sid AS worker_sid, serial# AS worker_serial,3 qcinst_id, qcsid, qcserial#,4 server_group, server_set, server#, degree, req_degree5FROM gv$px_session6ORDER BY qcinst_id, qcsid, inst_id, server_set, server#;PX 协调进程和并行从属进程可能分布在不同实例。排查并行 SQL 时要保留 QC 实例和会话编号。
1SELECT inst_id, name, ip_address, is_public, source2FROM gv$cluster_interconnects3ORDER BY inst_id, name;数据库实际采用的私网地址以这条查询为准,不能只根据主机网卡配置猜测。
1-- 累计值:排查当前问题应取两次采样的差值2-- TIME_WAITED_MICRO 原值为微秒,以下换算为秒3SELECT inst_id, con_id, event, total_waits,4 ROUND(time_waited_micro / 1000000, 2) AS waited_seconds,5 ROUND(time_waited_micro / NULLIF(total_waits, 0) / 1000, 3)6 AS avg_wait_ms7FROM gv$system_event8WHERE event LIKE 'gc %'9ORDER BY waited_seconds DESC;gc 等待是启动以来的累计值。判断当前是否异常,最好间隔一段时间取两次结果再比较。
1-- STATE = WAITING 才表示当前正在等待2SELECT inst_id, con_id, sid, serial#, sql_id, event,3 p1text, p1, p2text, p2, p3text, p3,4 wait_time_micro AS current_wait_us5FROM gv$session6WHERE state = 'WAITING'7 AND event LIKE 'gc %'8ORDER BY wait_time_micro DESC;这条查询只显示当前正在等待 gc 事件的会话,适合抓现场。瞬时问题需要连续采样或结合 ASH。
1-- INST_ID 是接收实例,INSTANCE 是发送实例2-- CR_BLOCK、CURRENT_BLOCK 不含 busy、congested 类别,勿当作总数3SELECT inst_id AS receiver_inst, instance AS sender_inst,4 con_id, class, cr_block, cr_busy, cr_congested,5 current_block, current_busy, current_congested, lost6FROM gv$instance_cache_transfer7ORDER BY receiver_inst, sender_inst, class;块传输量本身不是故障。重点关注同一对象是否持续产生大量跨实例访问。
1-- 段统计为累计值;当前热点需两次采样比较增量2SELECT inst_id, con_id, owner, object_name, subobject_name,3 object_type, statistic_name, value4FROM gv$segment_statistics5WHERE statistic_name = 'gc buffer busy'6 AND value > 07ORDER BY value DESC8FETCH FIRST 30 ROWS ONLY;热点对象通常和业务访问模式、服务分布有关,不一定通过增加节点就能解决。
1-- 实例启动以来累计块数;传输速率需按采样间隔取差值2SELECT inst_id, con_id, name, value3FROM gv$sysstat4WHERE name IN ('gc cr blocks received', 'gc current blocks received')5ORDER BY name, inst_id;接收块数较高说明该实例从其他实例取得了较多缓存块,要结合服务位置和对象访问判断是否合理。
1-- 累计块数;与接收端统计结合观察读写访问分布2SELECT inst_id, con_id, name, value3FROM gv$sysstat4WHERE name IN ('gc cr blocks served', 'gc current blocks served')5ORDER BY name, inst_id;发送块数较高说明该实例频繁向其他实例提供缓存块。与上一条对照,可以看出块传输方向。
1SELECT inst_id, pname, spid, program, tracefile2FROM gv$process3WHERE pname IN ('LMON', 'LMD0', 'LCK0', 'LMHB')4 OR pname LIKE 'LMS%'5ORDER BY inst_id, pname;LMS、LMON、LMD 等进程负责全局缓存和锁管理。进程异常时应立即检查实例告警日志。
1-- 保留 METRIC_UNIT,避免把速率、百分比和会话数混为一谈2SELECT inst_id, con_id, begin_time, end_time,3 metric_name, ROUND(value, 2) AS metric_value, metric_unit4FROM gv$sysmetric5WHERE intsize_csec BETWEEN 5000 AND 70006 AND (metric_name LIKE '%CPU%'7 OR metric_name = 'Average Active Sessions')8ORDER BY metric_name, inst_id;一分钟指标适合看短时负载差异。不同实例规格不一致时,不要只比较绝对值。
1-- 实例启动以来累计值;REMASTER_TIME 原值单位为百分之一秒2SELECT inst_id, con_id, remaster_type, remaster_ops,3 ROUND(remaster_time / 100, 2) AS remaster_seconds,4 remastered_objects, current_objects5FROM gv$dynamic_remaster_stats6ORDER BY inst_id, remaster_type;DRM 会根据访问情况调整资源主节点。频繁重主时,需要结合对象访问和 gc 等待继续判断。
1-- 在主库查询;V$THREAD 在物理备库上不返回有意义的线程信息2SELECT thread#, instance, status, enabled,3 groups, current_group#, sequence#, open_time4FROM v$thread5ORDER BY thread#;每个 RAC 实例应使用独立的 Redo 线程。线程启用状态和实例配置不一致时,启动可能失败。
1SELECT thread#, group#, sequence#,2 ROUND(bytes / 1024 / 1024) AS size_mb,3 members, status, archived, first_time4FROM v$log5ORDER BY thread#, group#;检查每个线程是否都有 CURRENT 日志组,并确认 INACTIVE 日志组数量能够满足切换和归档。
1-- STATUS 为空通常表示该成员处于使用状态,不能当作缺失2SELECT group#, type, member, status, is_recovery_dest_file3FROM v$logfile4ORDER BY group#, member;成员状态异常时,先确认文件是否存在以及存储是否可用,不要直接删除日志成员。
1SELECT inst_id, dest_id, dest_name, status, type,2 destination, archived_thread#, archived_seq#, error3FROM gv$archive_dest_status4WHERE status <> 'INACTIVE'5ORDER BY inst_id, dest_id;归档目的地出现 ERROR 时,先记录 DEST_ID 和错误信息,再检查空间、网络或远端状态。
1-- 只看当前 incarnation 的本地归档记录;不证明文件仍可读2SELECT dest_id, thread#, MAX(sequence#) AS last_archived_sequence3FROM v$archived_log4WHERE standby_dest = 'NO'5 AND archived = 'YES'6 AND name IS NOT NULL7 AND resetlogs_change# = (SELECT resetlogs_change# FROM v$database)8GROUP BY dest_id, thread#9ORDER BY dest_id, thread#;归档序列必须按线程分别查看。只比较最大序列号,容易把不同线程混在一起。
1-- 按 FIRST_TIME 归属小时,估算切换频率;受控制文件历史保留影响2-- 使用 V$,避免 GV$ 在各实例上重复返回同一控制文件记录3SELECT thread#, TO_CHAR(first_time, 'YYYY-MM-DD HH24') AS log_hour,4 COUNT(*) AS log_count5FROM v$log_history6WHERE first_time >= SYSDATE - 17 AND resetlogs_change# = (SELECT resetlogs_change# FROM v$database)8GROUP BY thread#, TO_CHAR(first_time, 'YYYY-MM-DD HH24')9ORDER BY log_hour, thread#;日志切换突然增多,常见原因是业务写入增加或日志组偏小。要结合业务时段判断。
1SELECT inst_id, name, value2FROM gv$diag_info3WHERE name IN ('ADR Base', 'ADR Home', 'Diag Trace', 'Diag Alert')4ORDER BY inst_id, name;每个实例都有自己的 ADR 目录。排查集群问题时,不要只收集当前节点的数据库日志。
1# oracle;当前节点、当前 ADR base2$DB_HOME/bin/adrci exec="show homes"1# oracle;本节点的指定数据库 ADR Home2# DB_ADR_HOME 使用第 88 条输出的相对 homepath3$DB_HOME/bin/adrci exec="set homepath $DB_ADR_HOME; show alert -tail 100 -term"这里直接读取 ADR 中的告警日志,不需要到文件系统里猜 alert 日志路径。
1# root;当前节点;诊断收集2# 会写诊断包并消耗磁盘空间;先确认可用空间3cd "$GRID_HOME/bin" || exit 14./diagcollection.pl --collect --crs诊断包可能较大,收集前先确认时间范围和输出目录空间。
1# root;当前节点2# 维护操作:影响本节点 GI 栈及其管理的资源,可能触发其他节点接管3# 先迁移业务并确认承载能力;无 -f 时资源无法停止会报错4$GRID_HOME/bin/crsctl stop crs该操作会停止本节点的 Clusterware 及其管理资源。执行前先迁移业务,并确认其他节点可以承载负载。
1# root;当前节点2# 资源会按配置的启动策略拉起;完成后检查第 4、11、19、52 条3$GRID_HOME/bin/crsctl start crs启动完成后重新执行 crsctl check crs 和资源状态检查,确认组件与资源都已恢复。
1# oracle;指定实例及其服务2# IMMEDIATE 会断开该实例连接并回滚未提交事务;先处理业务服务3$DB_HOME/bin/srvctl stop instance \4 -db "$DB_UNIQUE_NAME" -instance "$INSTANCE_NAME" -stopoption IMMEDIATEIMMEDIATE 会断开该实例上的连接并回滚未提交事务。停止前应先处理运行在该实例上的服务。
1# oracle;指定实例2$DB_HOME/bin/srvctl start instance \3 -db "$DB_UNIQUE_NAME" -instance "$INSTANCE_NAME"实例启动后继续检查数据库打开状态、PDB 和业务服务,不能只确认 PMON 进程存在。
1# oracle;指定实例上的指定服务2# 维护操作:停止该实例上的服务入口;排空超时为 300 秒3# 不使用 -force,已有会话可能继续保留;完成后检查连接分布4$DB_HOME/bin/srvctl stop service \5 -db "$DB_UNIQUE_NAME" -service "$SERVICE_NAME" \6 -instance "$INSTANCE_NAME" -drain_timeout 300drain_timeout 用于给连接排空留时间。不使用 -force 时,已有会话可能继续保留。
1# oracle;指定实例上的指定服务2# 目标实例需符合该服务的配置;启动后检查注册和应用连接3$DB_HOME/bin/srvctl start service \4 -db "$DB_UNIQUE_NAME" -service "$SERVICE_NAME" -instance "$INSTANCE_NAME"服务启动后要检查监听注册和实际连接分布,确认应用能够通过服务名连接。
1# oracle;指定服务;源实例到目标实例2# 适用于 administrator-managed RAC;目标需在首选或可用实例列表3# 不使用 -force;现有会话未必随服务迁走,客户端需支持相应排空机制4$DB_HOME/bin/srvctl relocate service \5 -db "$DB_UNIQUE_NAME" -service "$SERVICE_NAME" \6 -oldinst "$OLD_INSTANCE" -newinst "$NEW_INSTANCE" -drain_timeout 300服务迁移完成后,再检查服务运行位置、监听注册和新连接分布。已有连接是否迁移,取决于应用连接池和排空配置。
1# oracle;指定数据库的所有实例2# 高影响维护操作:停止该数据库所有实例及服务,造成整库业务中断3# IMMEDIATE 会断开连接并回滚未提交事务4$DB_HOME/bin/srvctl stop database -db "$DB_UNIQUE_NAME" -stopoption IMMEDIATE该命令会停止数据库的全部实例和服务,属于整库停机操作。
1# oracle;指定数据库2# 启动已启用的实例;完成后检查实例、PDB、服务及应用连接3$DB_HOME/bin/srvctl start database -db "$DB_UNIQUE_NAME"数据库启动完成后,应逐项检查实例、PDB、监听、服务和应用连接。
1# grid;当前集群2# 只做连通性验证;不能代替持续丢包、带宽与时延测试3$GRID_HOME/bin/cluvfy comp nodecon -n all -verbosecluvfy comp nodecon 用于验证节点网络连通性,不能替代持续的丢包、时延和带宽测试。
RAC 出现故障时,可以先执行 crsctl status resource -t,确认节点、实例、监听和服务的状态。数据库可以连接后,再检查跨实例会话、阻塞和 gc 等待。服务迁移完成后,继续使用 srvctl status service 和 lsnrctl status 核对运行位置与监听注册,不能只看迁移命令是否返回成功。
RAC 之外的常用 DBA 命令,也整理在 ORA100 · DBA100:
微信端搜索小程序 「三笠的百令册」,手机上也能查。