performance30 分钟阅读
SQL Server Always On 可用性组运维与故障排查 100 条命令
Always On 可用性组把数据库的日志从主副本送到辅助副本,辅助副本先硬化日志,再执行 redo。业务看到“同步异常”时,不能只看仪表盘总状态:副本是否连接、哪一个库积压、日志卡在发送还是 redo,处理方法并不一样。
2026年9月16日阅读—点赞—收藏—
dba100sqlserverscenario
100 条命令系列文章专栏
Always On 可用性组把数据库的日志从主副本送到辅助副本,辅助副本先硬化日志,再执行 redo。业务看到“同步异常”时,不能只看仪表盘总状态:副本是否连接、哪一个库积压、日志卡在发送还是 redo,处理方法并不一样。
Always On 可用性组把数据库的日志从主副本送到辅助副本,辅助副本先硬化日志,再执行 redo。业务看到“同步异常”时,不能只看仪表盘总状态:副本是否连接、哪一个库积压、日志卡在发送还是 redo,处理方法并不一样。
这篇把 AG 副本、数据库同步、侦听器和故障转移前检查放到一条排查线上。故障时先找具体数据库和具体队列,再判断是连接、日志还是辅助副本的 redo 问题。可先收藏,日常巡检和切换窗口都用得上。
示例基于 Windows WSFC 与 SQL Server 2022。默认在主副本查询,辅助副本上的命令单独注明;实例、AG 和数据库名按现场替换。SQL Server 2022 的相关 DMV 需要 VIEW SERVER PERFORMANCE STATE 或相应管理员权限。故障转移与修改副本配置的命令会在只读诊断之后写。
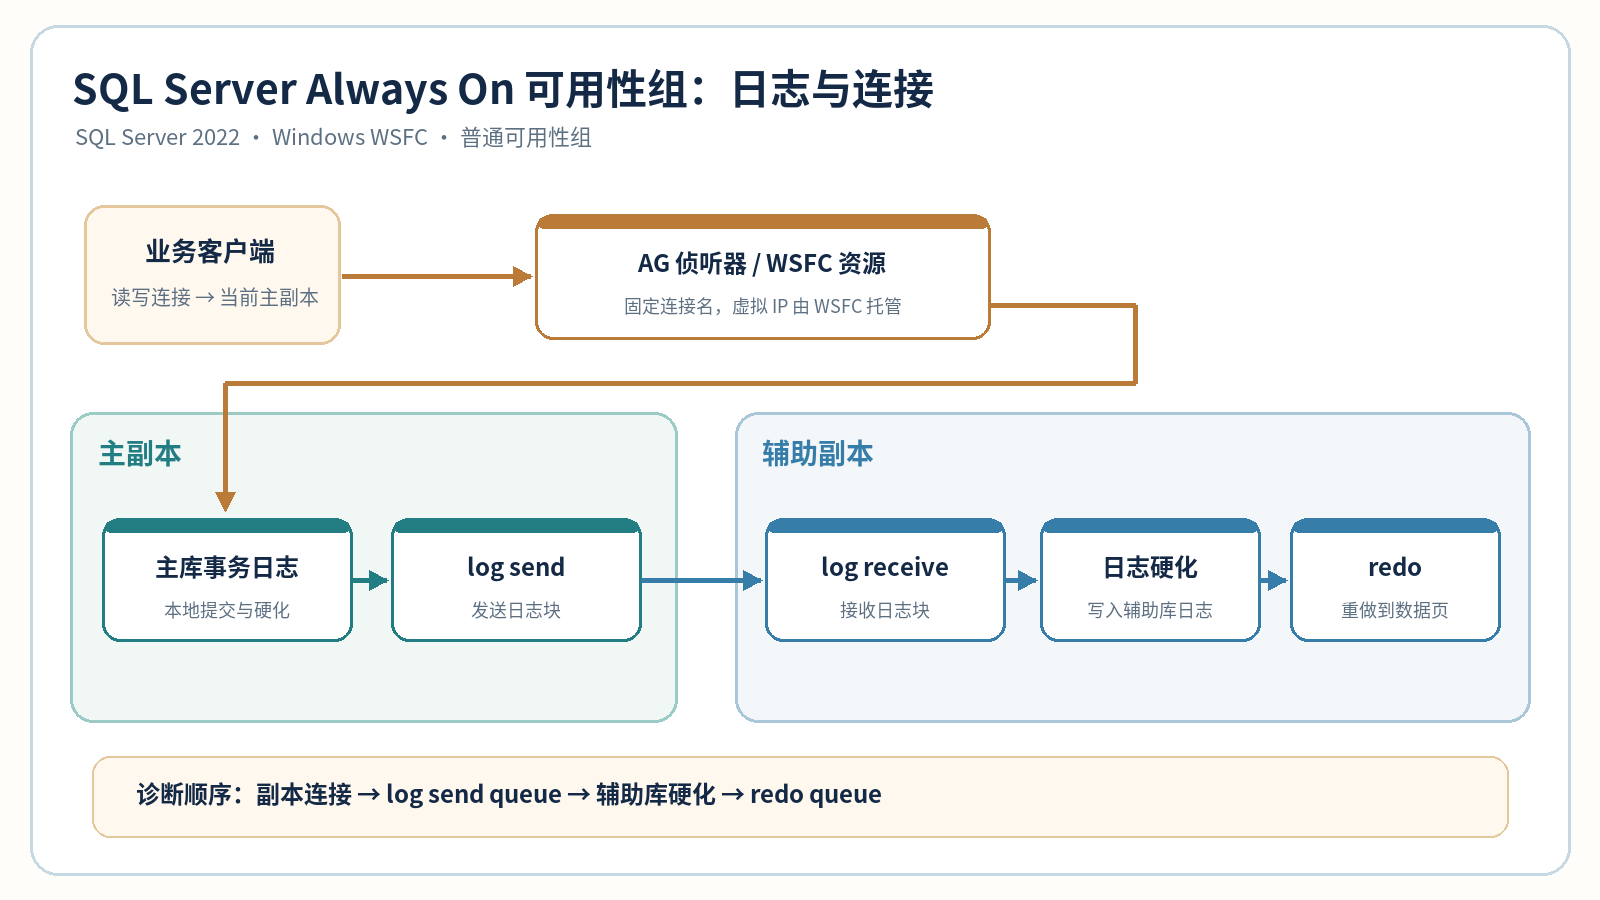 SQL Server Always On 可用性组日志传输与业务连接示意
图中上方是业务经侦听器连接当前主副本,下方是日志从主库发送到辅助副本并完成硬化、redo 的路径。读写入口和日志复制不是同一条链路。
1SELECT @@SERVERNAME AS server_name,2 SERVERPROPERTY('ProductVersion') AS product_version,3 SERVERPROPERTY('Edition') AS edition;切换之后,客户端连接名可能仍是原来的侦听器。先记下实际执行查询的实例名,再把它和 AG 当前主副本对照;版本和版本类型也决定后续某些功能能否使用。
1SELECT SERVERPROPERTY('IsHadrEnabled') AS hadr_enabled;结果为 1 表示实例启用了 Always On AG 能力,不代表这个实例一定已加入某个 AG。继续查 AG 清单;结果为 0 时,先核对实例配置和 SQL Server 服务状态。
1SELECT name, group_id2FROM sys.availability_groups3ORDER BY name;这张目录视图用于确认实例里有哪些 AG。查不到预期名称时,先核对实例和权限;不能把“没有行”直接写成整个集群不存在该 AG。
1SELECT ag.name AS ag_name,2 gs.primary_replica,3 gs.synchronization_health_desc4FROM sys.availability_groups AS ag5LEFT JOIN sys.dm_hadr_availability_group_states AS gs6 ON gs.group_id = ag.group_id7ORDER BY ag.name;PRIMARY_REPLICA 为空时要查集群通信与本实例角色;汇总 HEALTHY 也只是一层结论,下一步仍要逐库看发送队列和 redo 队列。
1SELECT ag.name AS ag_name,2 ar.replica_server_name,3 ar.availability_mode_desc,4 ar.failover_mode_desc5FROM sys.availability_replicas AS ar6JOIN sys.availability_groups AS ag7 ON ag.group_id = ar.group_id8ORDER BY ag.name, ar.replica_server_name;同步提交与异步提交的“健康”目标不同。FAILOVER_MODE=AUTOMATIC 也不能保证此刻一定可无损切换,仍要看目标辅助副本是否已同步、数据库是否全部加入 AG。
1-- 在当前主副本运行,才能看到该 AG 的所有副本状态2SELECT ag.name AS ag_name,3 ar.replica_server_name,4 rs.role_desc, rs.connected_state_desc,5 rs.synchronization_health_desc6FROM sys.dm_hadr_availability_replica_states AS rs7JOIN sys.availability_replicas AS ar8 ON ar.replica_id = rs.replica_id9JOIN sys.availability_groups AS ag10 ON ag.group_id = rs.group_id11ORDER BY ag.name, ar.replica_server_name;辅助副本断连时,先看最近连接错误、端点和集群网络。这个 DMV 在辅助副本只提供本地信息;若误在辅助副本运行,少几行不能解释为其他副本都已经离开 AG。
1-- 主副本执行;辅助副本查询只返回本地辅助数据库2SELECT adc.database_name, ar.replica_server_name,3 drs.is_local, drs.synchronization_state_desc,4 drs.synchronization_health_desc5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8JOIN sys.availability_replicas AS ar9 ON ar.replica_id = drs.replica_id10ORDER BY adc.database_name, ar.replica_server_name;AG 汇总正常时,仍应逐库确认有无 NOT SYNCHRONIZING 或初始化状态。若当前在辅助副本,少掉主库和其他辅助库的行是 DMV 可见范围使然,不是它们已退出 AG。
1-- 当前主副本;is_local=0 对应远端辅助数据库2SELECT adc.database_name, ar.replica_server_name,3 drs.log_send_queue_size AS log_send_queue_kb,4 drs.log_send_rate AS log_send_rate_kb_sec5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8JOIN sys.availability_replicas AS ar9 ON ar.replica_id = drs.replica_id10WHERE drs.is_local = 011ORDER BY drs.log_send_queue_size DESC;发送队列大,问题先看主库产生日志的速度、发送速率与网络;它不是辅助副本的 redo 积压。log_send_rate 是最近活跃时段的平均值,不能拿一张快照简单除出“还需几分钟”。
1-- 当前辅助副本;只看本地辅助数据库2SELECT adc.database_name,3 drs.redo_queue_size AS redo_queue_kb,4 drs.redo_rate AS redo_rate_kb_sec,5 drs.last_redone_time6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 110AND drs.is_primary_replica = 011ORDER BY drs.redo_queue_size DESC;日志已硬化但 redo 队列上涨,才进一步查辅助副本 CPU、I/O 和只读查询负载。last_redone_time 需与源端日志产生时间一起看,不能单独当成业务可读数据的精确延迟。
1SELECT adc.database_name, ar.replica_server_name,2 drs.is_suspended, drs.suspend_reason_desc3FROM sys.dm_hadr_database_replica_states AS drs4JOIN sys.availability_databases_cluster AS adc5 ON adc.group_database_id = drs.group_database_id6JOIN sys.availability_replicas AS ar7 ON ar.replica_id = drs.replica_id8WHERE drs.is_suspended = 19ORDER BY adc.database_name, ar.replica_server_name;暂停原因若是 redo、apply 或日志捕获错误,要先读 SQL Server 错误日志;直接 RESUME 只会再次遇到同一个问题。用户主动暂停与故障后的伙伴暂停也要分清,再决定恢复顺序。
1-- 在辅助副本运行,只看本地辅助数据库2SELECT adc.database_name, drs.last_received_time,3 drs.last_hardened_time, drs.last_redone_time4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7WHERE drs.is_local = 1 AND drs.is_primary_replica = 08ORDER BY adc.database_name;三列分别看收到、写入日志文件和完成 redo 的进度。时间戳属于各自阶段,不能简单相减当成准确的复制延迟;把队列大小和最近的业务提交一起看,才知道是日志未送到,还是已硬化却没赶上 redo。
1-- 在主副本运行2SELECT ag.name, ar.replica_server_name,3 rs.connected_state_desc, rs.last_connect_error_number,4 rs.last_connect_error_description,5 rs.last_connect_error_timestamp6FROM sys.dm_hadr_availability_replica_states AS rs7JOIN sys.availability_replicas AS ar8 ON ar.replica_id = rs.replica_id9JOIN sys.availability_groups AS ag10 ON ag.group_id = rs.group_id11WHERE rs.is_local = 012ORDER BY ag.name, ar.replica_server_name;错误号和时间用来对齐双方错误日志,确认是端点、认证还是网络问题。last_connect_error 是最近一次连接错误,副本当前已经 CONNECTED 时,旧错误不应被误写成正在发生的故障。
1SELECT ag.name AS ag_name, l.dns_name, l.port2FROM sys.availability_groups AS ag3LEFT JOIN sys.availability_group_listeners AS l4 ON l.group_id = ag.group_id5ORDER BY ag.name, l.dns_name;没有侦听器的 AG 会显示空名称;应用可能直连实例,先查连接串,不能只凭这里的配置判断流量已经走侦听器。端口为空时还要核对 WSFC 侧建立的资源配置。
1SELECT l.dns_name, ip.ip_address,2 ip.network_subnet_ip, ip.state_desc3FROM sys.availability_group_listeners AS l4JOIN sys.availability_group_listener_ip_addresses AS ip5 ON ip.listener_id = l.listener_id6ORDER BY l.dns_name, ip.ip_address;多子网 AG 可配置多个 IP,只有相应子网中的资源在线并不表示所有地址都必须同时在线。结合当前主副本所在子网、DNS 解析及客户端 MultiSubnetFailover 设置判断。
1-- 使用应用同一侦听器、端口与认证方式连接,再执行2SELECT @@SERVERNAME AS connected_instance,3 SERVERPROPERTY('ComputerNamePhysicalNetBIOS') AS physical_node,4 sys.fn_hadr_is_primary_replica('SalesDB') AS is_primary;最后一列为 1 才说明 SalesDB 在当前连接的实例上是主副本;为 0 是辅助副本,为 NULL 则要查数据库是否存在或是否加入 AG。切换验证要用业务的连接方式测一次,不能只看 AG 角色 DMV。
1SELECT ag.name AS ag_name, ar.replica_server_name,2 ar.secondary_role_allow_connections_desc,3 ar.read_only_routing_url4FROM sys.availability_replicas AS ar5JOIN sys.availability_groups AS ag6 ON ag.group_id = ar.group_id7ORDER BY ag.name, ar.replica_server_name;允许辅助副本连接与设置 read_only_routing_url 是两项配置。只读路由还取决于当前主副本的路由列表,以及客户端连接串是否带 ApplicationIntent=ReadOnly。没有路由 URL 时,不要把“辅助库可读”解释为经侦听器能自动分流。
1SELECT owner.replica_server_name AS current_primary_name,2 rl.routing_priority,3 target.replica_server_name AS read_only_target,4 target.read_only_routing_url5FROM sys.availability_read_only_routing_lists AS rl6JOIN sys.availability_replicas AS owner7 ON owner.replica_id = rl.replica_id8JOIN sys.availability_replicas AS target9 ON target.replica_id = rl.read_only_replica_id10ORDER BY owner.replica_server_name, rl.routing_priority;列表按“哪台副本是当前主副本”分别维护;切换主副本后要查看新主副本对应的列表。优先级 1 是先尝试的目标,但配置本身不证明目标库已经同步、可读或业务连接已经路由成功。
1-- 先用侦听器连接 SalesDB,连接串设置 ApplicationIntent=ReadOnly2SELECT @@SERVERNAME AS connected_instance,3 DB_NAME() AS current_database,4 sys.fn_hadr_is_primary_replica(DB_NAME()) AS is_primary;这条必须在实际只读连接中执行;is_primary=0 才说明本次连接落在辅助副本。返回 1 时,核对客户端驱动、连接串、路由列表与目标辅助库的连接许可;为 NULL 时先查当前数据库是否属于 AG。
1SELECT cluster_name, quorum_type_desc, quorum_state_desc2FROM sys.dm_hadr_cluster;没有仲裁时,AG 角色与侦听器都可能受影响。这个视图在本节点失去仲裁后可能不返回行;空结果要结合 WSFC 事件和其他节点状态判断,不能简单写成“集群不存在”。
1SELECT member_name, member_type_desc,2 member_state_desc, number_of_current_votes3FROM sys.dm_hadr_cluster_members4ORDER BY member_type_desc, member_name;见证资源和节点都在列表中。number_of_current_votes 会受动态仲裁影响,不应拿初始配置的票数估计当前还能失去几个节点;切换窗口先把当前在线成员与见证状态记下来。
1SELECT cs.database_name, ar.replica_server_name,2 cs.is_database_joined3FROM sys.dm_hadr_database_replica_cluster_states AS cs4JOIN sys.availability_replicas AS ar5 ON ar.replica_id = cs.replica_id6ORDER BY cs.database_name, ar.replica_server_name;目标副本上少加入一个业务库,AG 汇总看起来正常也不能保证应用切换后所有库都可用。NULL 可表示集群失去仲裁、状态未知;必须先恢复对副本和数据库的可见性。
1SELECT cs.database_name, ar.replica_server_name,2 cs.is_database_joined, cs.is_failover_ready3FROM sys.dm_hadr_database_replica_cluster_states AS cs4JOIN sys.availability_replicas AS ar5 ON ar.replica_id = cs.replica_id6WHERE ar.replica_server_name = 'SQLNODE02'7ORDER BY cs.database_name;is_failover_ready=1 是 WSFC 记录的数据库同步就绪状态;还要确认目标副本是同步提交、数据库未暂停、连接正常。这里用来筛查目标副本的每个库,不能把一库就绪误当成整个 AG 已可无损切换。
1-- 在当前主副本运行,观察每个辅助数据库2SELECT adc.database_name, ar.replica_server_name,3 drs.log_send_queue_size, drs.log_send_rate,4 drs.redo_queue_size, drs.redo_rate5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8JOIN sys.availability_replicas AS ar9 ON ar.replica_id = drs.replica_id10WHERE drs.is_local = 011ORDER BY adc.database_name, ar.replica_server_name;队列单位是 KB,速率是 KB/s。发送速率是上次活跃期的平均值;redo 速率也不是按整段墙钟时间算的。不能用单次 queue / rate 给出准确追平时间,最好隔几分钟取第二个样本,看队列在增还是在减。
1-- 在当前主副本执行;数据库名按现场替换2SELECT name, recovery_model_desc, log_reuse_wait_desc3FROM sys.databases4WHERE name = N'SalesDB';AVAILABILITY_REPLICA 表示 AG 副本可能拖住日志截断,再查各辅助副本的队列和截断点。LOG_BACKUP、ACTIVE_TRANSACTION 等则是另一类原因;不要看到日志文件增长就直接认定 AG 故障,更不要用缩日志代替找原因。
1-- 在当前主副本执行;结合第 24 条的 AVAILABILITY_REPLICA 判断2SELECT cs.database_name, ar.replica_server_name,3 cs.truncation_lsn, cs.is_database_joined4FROM sys.dm_hadr_database_replica_cluster_states AS cs5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = cs.replica_id7WHERE cs.database_name = N'SalesDB'8ORDER BY cs.truncation_lsn, ar.replica_server_name;截断点落后的副本是重点排查对象,随后核对连接、数据移动暂停状态与发送队列。这里的 truncation_lsn 是按日志块标识表示的截断位置,不能当成字节数相减;本地还可能因备份等原因进一步阻止日志复用。
1-- 在当前主副本执行2SELECT adc.database_name, ar.replica_server_name,3 drs.is_suspended, drs.synchronization_state_desc,4 drs.secondary_lag_seconds,5 drs.log_send_queue_size6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9JOIN sys.availability_replicas AS ar10 ON ar.replica_id = drs.replica_id11WHERE drs.is_local = 012ORDER BY adc.database_name, ar.replica_server_name;secondary_lag_seconds 是日志硬化的滞后指标;数据移动已暂停时它可能显示 0,不能把这个 0 读成“副本追平”。同时看 is_suspended、同步状态与发送队列,再决定是否需要查辅助节点的 redo。
1-- 在当前主副本或目标辅助副本分别核对2SELECT adc.database_name, ar.replica_server_name,3 drs.is_suspended, drs.suspend_reason_desc4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7JOIN sys.availability_replicas AS ar8 ON ar.replica_id = drs.replica_id9WHERE drs.is_suspended = 110ORDER BY adc.database_name, ar.replica_server_name;暂停可能是人工执行,也可能由副本故障触发。先记下 suspend_reason_desc、受影响的库和节点,查 SQL Server 错误日志;直接恢复数据移动,旧错误没有解决时很快又会暂停。
1-- 在主副本查询每个辅助数据库2SELECT adc.database_name, ar.replica_server_name,3 drs.last_sent_time, drs.last_hardened_time,4 drs.last_redone_time5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8JOIN sys.availability_replicas AS ar9 ON ar.replica_id = drs.replica_id10WHERE drs.is_local = 011ORDER BY adc.database_name, ar.replica_server_name;发送停在前面,优先查主副本到辅助副本的链路;已硬化但 redo 时间不推进,再看辅助库 redo 队列和资源。时间字段是最近处理记录的时间,不是准确的端到端业务延迟,也要结合队列的连续样本。
1-- 在当前主副本查询所有可见副本2SELECT ar.replica_server_name, ars.role_desc,3 ars.connected_state_desc,4 ars.recovery_health_desc,5 ars.synchronization_health_desc6FROM sys.dm_hadr_availability_replica_states AS ars7JOIN sys.availability_replicas AS ar8 ON ar.replica_id = ars.replica_id9ORDER BY ar.replica_server_name;这是副本级汇总,不是每库状态。远端副本的 recovery_health_desc 可能为 NULL,不能读成恢复失败;同步健康度及各业务库状态仍需分别看。某个库未加入、暂停或未同步时,不能凭汇总状态切换。
1SELECT replica_server_name, endpoint_url,2 session_timeout, availability_mode_desc3FROM sys.availability_replicas4ORDER BY replica_server_name;session_timeout 是副本多久收不到对端消息后认为连接故障的阈值。参数太小容易把短时网络波动放大成掉线;改值前先查实际丢包、端点地址和连接事件,不能靠提高阈值掩盖问题。
1-- 在每台副本实例分别执行2SELECT name, state_desc, role_desc,3 connection_auth_desc, encryption_algorithm_desc4FROM sys.database_mirroring_endpoints;AG 使用数据库镜像端点通信。端点不是 STARTED 时,辅助副本连接和日志发送会受影响;每台节点要分别核对,主副本看到的远端连接状态不能替代远端端点检查。
1-- 在每台副本实例分别执行2SELECT e.name, e.state_desc, t.port3FROM sys.database_mirroring_endpoints AS e4JOIN sys.tcp_endpoints AS t5 ON t.endpoint_id = e.endpoint_id;这里是 AG 副本通信端口,不是给应用连接的侦听器 SQL 端口。防火墙、DNS 和端点 URL 排查要用正确端口;端点已启动也不能单独证明网络双方可互通。
1SELECT name, automated_backup_preference_desc2FROM sys.availability_groups3ORDER BY name;备份偏好只是给备份脚本选择节点的配置,SQL Server 不会因为这里设了“辅助副本优先”就自动搬迁 SQL Agent 作业。各副本的作业仍要部署、启用并验证执行结果。
1SELECT replica_server_name, backup_priority2FROM sys.availability_replicas3ORDER BY backup_priority DESC, replica_server_name;同一 AG 多个辅助副本可参与备份选择;优先级是选择偏好,不代表节点现在在线或备份存储可用。不要把“偏好已设置”当成“备份已完成”。
1-- 在每台 AG 副本执行;数据库名按现场替换2SELECT @@SERVERNAME AS instance_name,3 sys.fn_hadr_backup_is_preferred_replica(N'SalesDB')4 AS is_preferred_backup_replica;返回 1 时本节点是首选备份位置,0 则不应由本节点的同类作业抢跑。非 AG 数据库也会返回 1;SQL Server 2019 早期 CU 对“不存在的数据库”甚至可能返回 1,所以先确认库名、AG 归属和版本,再把函数结果用于备份作业判断。
1-- 在各副本的 msdb 分别核对;msdb 备份历史不随 AG 数据库同步2SELECT TOP (10) database_name, server_name,3 backup_start_date, backup_finish_date,4 is_copy_only5FROM msdb.dbo.backupset6WHERE database_name = N'SalesDB'7 AND type = 'D'8ORDER BY backup_finish_date DESC;server_name 是执行备份时的实例,能确认作业究竟在哪台跑。这里只看本实例的 msdb 历史;切换到新主后,不能拿新主节点没有旧记录就断言过去没备份。再去备份存储核对文件是否还在。
1-- 各副本分别执行,避免漏掉在其他节点完成的日志备份2SELECT TOP (20) server_name, backup_start_date,3 backup_finish_date, first_lsn, last_lsn4FROM msdb.dbo.backupset5WHERE database_name = N'SalesDB'6 AND type = 'L'7ORDER BY backup_finish_date DESC;AG 可以在合格辅助副本上备份日志。记录分散在各节点的 msdb;只看当前主库容易误报“日志备份中断”。检查恢复链时还要汇总备份文件和 LSN,备份历史有记录不等于文件可恢复。
1-- 在实际运行备份的节点执行;作业名按现场替换2SELECT TOP (10) j.name, h.run_date, h.run_time,3 h.run_status, h.message4FROM msdb.dbo.sysjobs AS j5JOIN msdb.dbo.sysjobhistory AS h6 ON h.job_id = j.job_id7WHERE j.name = N'AG_SalesDB_LogBackup'8 AND h.step_id = 09ORDER BY h.instance_id DESC;step_id=0 是一次作业的汇总,run_status=0 表示失败。新主角色变化后,两边 SQL Agent 作业可能一边没接管、一边同时执行;还要核对作业的角色判断逻辑和最近备份文件。
1SELECT replica_server_name, availability_mode_desc,2 failover_mode_desc, endpoint_url3FROM sys.availability_replicas4WHERE replica_server_name = N'SQLNODE02';计划无损切换要求目标为同步提交;手动切换不要求配置成自动故障转移。目标名和端点地址要与现场实例核对,尤其是跨子网、别名或命名实例部署。模式正确只是前提,还要检查实时同步状态。
1-- 连接到计划切换目标 SQLNODE02,切勿在旧主实例上执行切换命令2SELECT ag.name, ars.role_desc,3 ars.connected_state_desc,4 ars.synchronization_health_desc5FROM sys.dm_hadr_availability_replica_states AS ars6JOIN sys.availability_groups AS ag7 ON ag.group_id = ars.group_id8WHERE ars.is_local = 19 AND ag.name = N'SalesAG';切换前本地角色应是 SECONDARY,与主副本保持连接。这个查询在目标实例执行,避免连接串经过侦听器后又落回旧主;同步健康是汇总值,下一条要逐库核对。
1-- 在计划目标辅助副本执行2SELECT adc.database_name, drs.database_state_desc,3 drs.synchronization_state_desc,4 drs.synchronization_health_desc,5 drs.is_suspended6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 110ORDER BY adc.database_name;计划切换必须确认目标上的所有业务库已加入、未暂停且处于 SYNCHRONIZED。若清单比 AG 实际数据库少,先查第 21 条的加入状态,不能只凭这条查询返回的几行全绿就执行切换。
1-- 在计划目标辅助副本执行;目标实例名按现场替换2SELECT COUNT(*) AS database_count,3 SUM(CASE WHEN cs.is_database_joined = 14 AND cs.is_failover_ready = 15 THEN 0 ELSE 1 END) AS not_ready_count6FROM sys.dm_hadr_database_replica_cluster_states AS cs7JOIN sys.availability_replicas AS ar8 ON ar.replica_id = cs.replica_id9WHERE ar.replica_server_name = N'SQLNODE02';not_ready_count 应为 0,database_count 还要与 AG 实际数据库数一致;如果目标根本没有加入数据库,结果也可能看起来“没有未就绪项”。第 22 条可定位具体未就绪库,汇总结果不能替代逐库同步检查。
1-- 在目标辅助副本执行2SELECT adc.database_name, drs.suspend_reason_desc3FROM sys.dm_hadr_database_replica_states AS drs4JOIN sys.availability_databases_cluster AS adc5 ON adc.group_database_id = drs.group_database_id6WHERE drs.is_local = 17 AND drs.is_suspended = 1;正常应无结果。只要有库暂停,就先查错误日志和原因,恢复同步并重新检查;“其他库都同步”不能抵消这一库的风险。这里与第 27 条的全局故障调查不同,只限定目标本地库。
1-- 仅在同步提交、每库 SYNCHRONIZED、WSFC 仲裁正常且切换审批完成后2ALTER AVAILABILITY GROUP SalesAG FAILOVER;命令必须在目标辅助副本实例运行。它发起无损的计划切换;命令返回时,新主数据库的恢复可能仍在继续。随后要核对角色、每库联机状态、侦听器与真实业务连接,不要把命令成功当成业务恢复完成。
1-- 在原目标 SQLNODE02 执行2SELECT @@SERVERNAME AS instance_name, ag.name,3 ars.role_desc, ars.operational_state_desc4FROM sys.dm_hadr_availability_replica_states AS ars5JOIN sys.availability_groups AS ag6 ON ag.group_id = ars.group_id7WHERE ars.is_local = 18 AND ag.name = N'SalesAG';角色应是 PRIMARY,操作状态也应正常。再从侦听器使用应用同样的连接参数测试读写;旧主恢复成辅助后,继续检查它能否重新追平。角色变化和客户端已完成切换是两项不同验收。
1-- 在新主副本 SQLNODE02 执行2SELECT adc.database_name, drs.database_state_desc,3 drs.synchronization_state_desc, drs.is_suspended4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7WHERE drs.is_local = 18 AND drs.is_primary_replica = 19ORDER BY adc.database_name;每个业务库都应为 ONLINE,清单数也要与 AG 配置一致。刚完成切换时如果个别库还在恢复,不要仅凭 AG 角色已是 PRIMARY 就放行应用连接;先确认这些库实际可用。
1-- 用应用的连接串经 AG 侦听器连接 SalesDB 后执行2SELECT @@SERVERNAME AS connected_instance,3 DB_NAME() AS database_name,4 sys.fn_hadr_is_primary_replica(DB_NAME()) AS is_primary;返回 1 才说明这次连接落在业务库的主副本;0 是辅助副本,NULL 要检查当前库是否加入 AG。此查询只验证当前连接,不能代替应用端连接池刷新、DNS 缓存和写入测试。
1-- 在新主副本执行;旧主实例名按现场替换2SELECT ar.replica_server_name, ars.role_desc,3 ars.connected_state_desc, ars.operational_state_desc,4 ars.synchronization_health_desc5FROM sys.dm_hadr_availability_replica_states AS ars6JOIN sys.availability_replicas AS ar7 ON ar.replica_id = ars.replica_id8WHERE ar.replica_server_name = N'SQLNODE01';旧主应转为 SECONDARY 并重新连接。汇总健康度为 HEALTHY 仍需逐库看日志发送、硬化和 redo;旧主掉线时,新主业务虽然能写,后续切换能力已经下降。
1-- 直接连接旧主 SQLNODE01;不要通过侦听器2SELECT adc.database_name, drs.database_state_desc,3 drs.synchronization_state_desc,4 drs.is_suspended, drs.redo_queue_size,5 drs.redo_rate6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 110ORDER BY adc.database_name;切换后旧主需要作为辅助副本重新追上。同步提交的库应回到 SYNCHRONIZED;redo 队列短时增长不一定是故障,要结合 redo_rate 和连续两次采样看它是否在缩小。
1-- 在新主副本执行2SELECT ag.name, ags.primary_replica,3 ags.primary_recovery_health_desc,4 ags.secondary_recovery_health_desc,5 ags.synchronization_health_desc6FROM sys.dm_hadr_availability_group_states AS ags7JOIN sys.availability_groups AS ag8 ON ag.group_id = ags.group_id9WHERE ag.name = N'SalesAG';这里看的是 AG 汇总状态,适合做切换后的一次总览。若 secondary_recovery_health_desc 或同步健康不正常,再回到副本和数据库两层查具体对象;汇总全绿也不说明应用连接已经恢复。
1-- 在新主 SQLNODE02 的 msdb 执行;作业名前缀按现场改2SELECT name, enabled, date_modified3FROM msdb.dbo.sysjobs4WHERE name LIKE N'SalesDB%'5ORDER BY name;普通 AG 切换数据库角色,并不会自动把实例级 SQL Agent 作业搬到新主。作业缺失、禁用或版本不一致,要按现场发布流程处理;名字匹配只是初筛,还应检查步骤和调度。
1-- 在新主 SQLNODE02 执行2SELECT j.name, j.enabled, js.last_run_outcome,3 js.last_run_date, js.last_run_time,4 js.last_outcome_message5FROM msdb.dbo.sysjobs AS j6JOIN msdb.dbo.sysjobservers AS js7 ON js.job_id = j.job_id8WHERE j.name LIKE N'SalesDB%'9ORDER BY j.name;last_run_outcome=1 是最近一次成功,5 是未知;切换刚完成时,旧执行记录不能证明新主上的下一轮作业也会跑。先确认作业存在、启用和下一次调度,再看新的执行记录。
1-- 直接连接旧主 SQLNODE01 的 msdb2SELECT j.name, j.enabled,3 sys.fn_hadr_is_primary_replica(N'SalesDB') AS is_primary_here4FROM msdb.dbo.sysjobs AS j5WHERE j.name LIKE N'SalesDB%';旧主变成辅助后,这些作业若仍启用,必须确认作业步骤有角色判断或已按切换方案停用。is_primary_here=0 只说明当前实例承载的是辅助库,不能单凭它认定作业会自动跳过。
1-- 在新主副本执行;路由列表属于当前 PRIMARY 角色配置2SELECT owner.replica_server_name AS routing_owner,3 rl.routing_priority,4 target.replica_server_name AS read_only_target5FROM sys.availability_read_only_routing_lists AS rl6JOIN sys.availability_replicas AS owner7 ON owner.replica_id = rl.replica_id8JOIN sys.availability_replicas AS target9 ON target.replica_id = rl.read_only_replica_id10WHERE owner.replica_server_name = N'SQLNODE02'11ORDER BY rl.routing_priority;切换到 SQLNODE02 后,读取的是它作为主副本时的路由列表。旧主的路由配置不能代替新主配置;列表存在也还要检查目标副本允许只读连接、路由 URL 和客户端 ApplicationIntent=ReadOnly。
1-- 使用侦听器、SalesDB、ApplicationIntent=ReadOnly 建立新连接后执行2SELECT @@SERVERNAME AS connected_instance,3 DB_NAME() AS database_name,4 sys.fn_hadr_is_primary_replica(DB_NAME()) AS is_primary;返回的实例名才是这次只读请求真正落到的节点。只读连接落在主副本并不一定是故障,可能是路由目标不可用或配置允许回退;要与第 54 条、应用连接参数及目标辅助库状态对照。
1SELECT name, failure_condition_level,2 health_check_timeout, db_failover3FROM sys.availability_groups4WHERE name = N'SalesAG';FAILURE_CONDITION_LEVEL 控制实例健康故障触发范围,HEALTH_CHECK_TIMEOUT 单位是毫秒。DB_FAILOVER=1 才启用数据库级健康检测;这三项是检测配置,不代表目标副本一定满足自动切换条件。
1SELECT replica_server_name, availability_mode_desc,2 failover_mode_desc3FROM sys.availability_replicas4WHERE group_id =5 (SELECT group_id FROM sys.availability_groups6 WHERE name = N'SalesAG')7ORDER BY replica_server_name;自动切换要求主、副本都配置同步提交和自动故障转移,目标数据库还须同步。若一个副本是 ASYNCHRONOUS_COMMIT,它只能作为受控的灾备切换目标,不能期待实例故障后自动接管。
1-- 在仍可连接的原主实例执行一次,不指定重复间隔2EXEC sys.sp_server_diagnostics;看 system、resource、query_processing、io_subsystem 和 AG 组件的 state_desc。这是调用当刻的健康快照,不能倒推出故障发生时 WSFC 收到的检测结果;自动切换没发生时,还要查 SQL 错误日志和集群日志中的实际时间线。
1-- 在可连接的 AG 实例上执行2SELECT cluster_name, quorum_type_desc, quorum_state_desc3FROM sys.dm_hadr_cluster;正常有仲裁才会返回集群信息;无行时不能把它读成“配置为空”。先在 Windows 集群侧核实节点与见证,禁止只因 SQL 查询无行就贸然强制故障转移。
1-- 直接连接故障现场仍可访问的实例2SELECT ag.name, ars.role_desc,3 ars.operational_state_desc, ars.connected_state_desc4FROM sys.dm_hadr_availability_replica_states AS ars5JOIN sys.availability_groups AS ag6 ON ag.group_id = ars.group_id7WHERE ars.is_local = 18 AND ag.name = N'SalesAG';RESOLVING 或 FAILED_NO_QUORUM 时,先查 WSFC 和 SQL Server 错误日志。客户端报数据库不可访问不等于库文件损坏;角色尚未确定时不应对同一业务库再启动第二套写入口。
1-- 在候选副本所在实例执行;名称换成现场目标2SELECT adc.database_name, ar.replica_server_name,3 cs.is_database_joined, cs.is_failover_ready4FROM sys.dm_hadr_database_replica_cluster_states AS cs5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = cs.replica_id7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = cs.group_database_id9WHERE ar.replica_server_name = N'SQLNODE02'10ORDER BY adc.database_name;所有库 is_failover_ready=1 是强制切换时估计无数据损失的重要依据,但前提是候选节点在故障当时在线且 WSFC 状态可信。若刚做过强制仲裁,标记可能无法反映旧主失联前的真实状态;还要记录不确定性。
1-- 在候选副本直接执行2SELECT adc.database_name, drs.database_state_desc,3 drs.synchronization_state_desc, drs.is_suspended4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7WHERE drs.is_local = 18 AND (drs.synchronization_state_desc IN (N'REVERTING', N'INITIALIZING')9 OR drs.is_suspended = 1)10ORDER BY adc.database_name;REVERTING 或 INITIALIZING 的辅助库强制切换后可能无法作为主库启动。查询非空时先保留状态和日志;是否重建该库、换目标或接受部分不可用,需要事故恢复方案决定。
1-- 在候选副本执行;作为故障前后取证,不作精确损失量承诺2SELECT adc.database_name, drs.last_commit_lsn,3 drs.last_commit_time, drs.last_hardened_time,4 drs.last_redone_time5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8WHERE drs.is_local = 19ORDER BY adc.database_name;last_commit_lsn 在辅助库对应最后重放的提交记录。旧主失联时拿不到它最新的提交位置,就无法仅凭目标库这一行精确算出将损失几笔事务;保留候选值,后续与旧主日志和业务流水核对。
1-- 在候选 SQLNODE02 执行2SELECT cluster_name, quorum_state_desc3FROM sys.dm_hadr_cluster;这条是灾备节点上的仲裁观察,和第 59 条从事故现场的观察分开。无行或状态异常,应先按 WSFC 恢复流程处理;SQL Server 命令不能替代集群仲裁。
1-- 只在确认旧主无法服务、WSFC 有仲裁、目标风险已评估后,于候选副本执行2ALTER AVAILABILITY GROUP SalesAG FORCE_FAILOVER_ALLOW_DATA_LOSS;这不是第 44 条的计划无损切换。目标若未同步,可能丢失旧主上未到达目标的事务;命令被接受后数据库恢复仍是异步的。先隔离旧主写入口,切换后逐库确认联机、侦听器、应用写入,并保留旧主数据供损失核对。
1-- 在执行第 65 条的目标 SQLNODE02 上运行2SELECT @@SERVERNAME AS instance_name, ag.name,3 ars.role_desc, ars.operational_state_desc4FROM sys.dm_hadr_availability_replica_states AS ars5JOIN sys.availability_groups AS ag6 ON ag.group_id = ars.group_id7WHERE ars.is_local = 18 AND ag.name = N'SalesAG';角色成为 PRIMARY 只是第一步。若操作状态还在切换或失败,业务库可能尚未恢复完成;旧主写入口仍要隔离,避免两端各自接受连接。
1-- 在新主 SQLNODE02 执行2SELECT adc.database_name, drs.database_state_desc,3 drs.synchronization_state_desc4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7WHERE drs.is_local = 18 AND drs.is_primary_replica = 19 AND drs.database_state_desc <> N'ONLINE';强制切换命令返回时,数据库恢复可能还在继续。查询结果非空时先看具体库状态和 SQL 错误日志;尤其是切换前处于 REVERTING 或 INITIALIZING 的库,可能需要单独的备份恢复方案。
1-- 在新主执行,查看它知道的各辅助副本状态2SELECT ar.replica_server_name, adc.database_name,3 drs.is_suspended, drs.suspend_reason_desc4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = drs.replica_id7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 010 AND drs.is_suspended = 111ORDER BY ar.replica_server_name, adc.database_name;强制切换后辅助库通常会暂停数据移动。旧主若仍离线,这个主节点视图可能看不到它的完整本地状态;每个可访问的辅助实例还要直接核对,再逐库决定何时恢复。
1-- 直接连接可用的辅助副本 SQLNODE032SELECT adc.database_name, drs.is_suspended,3 drs.suspend_reason_desc, drs.synchronization_state_desc4FROM sys.dm_hadr_database_replica_states AS drs5JOIN sys.availability_databases_cluster AS adc6 ON adc.group_database_id = drs.group_database_id7WHERE drs.is_local = 18ORDER BY adc.database_name;SUSPEND_FROM_PARTNER 常见于强制切换后。恢复数据移动前,先保存可能需要取证的旧主事务或辅助库快照;重新同步可能会回退那些没有进入新主日志链的记录。
1-- 在承载 SalesDB 辅助库的 SQLNODE03 执行,逐库处理2ALTER DATABASE SalesDB SET HADR RESUME;不能在新主上对所有辅助库一条命令批量“解锁”。先确认旧数据取证已完成、该辅助库与新主日志链可重新同步,再在该库的辅助实例执行;命令返回后还要看同步状态与队列是否推进。
1-- 在 SQLNODE03 执行2SELECT adc.database_name, drs.is_suspended,3 drs.synchronization_state_desc,4 drs.last_received_time, drs.last_hardened_time,5 drs.redo_queue_size6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 110 AND adc.database_name = N'SalesDB';is_suspended=0 只是恢复数据移动的起点;隔几分钟再采样,看收到、硬化和 redo 是否持续推进。再次切换前,目标辅助库至少须走出异常状态,计划无损切换则还要等每库 SYNCHRONIZED。
1-- 在新主 SQLNODE02 执行2SELECT name, log_reuse_wait_desc3FROM sys.databases4WHERE name = N'SalesDB';强制切换后,辅助库暂停可能拖住新主日志截断。AVAILABILITY_REPLICA 是线索,还要结合备份、活动事务和第 68—71 条;不要因为日志文件变大就直接删除失败副本或改恢复模式。
1-- 在新主 SQLNODE02 执行;数据库名按现场替换2SELECT TOP (10) bs.database_name, bs.backup_start_date,3 bs.backup_finish_date, bs.server_name,4 bs.first_lsn, bs.last_lsn5FROM msdb.dbo.backupset AS bs6WHERE bs.database_name = N'SalesDB'7 AND bs.type = 'L'8ORDER BY bs.backup_finish_date DESC;第 37 条查的是常规最新日志备份,这里着重核对灾备切换之后新主是否按计划继续备份。若又发生一次强制切换,微软建议每次之后做日志备份;历史行存在不说明文件仍可读取,恢复链还要在备份存储回读。
1-- 用业务连接串经侦听器连 SalesDB 后执行2SELECT @@SERVERNAME AS connected_instance,3 sys.fn_hadr_is_primary_replica(N'SalesDB') AS is_primary;应落到新主且返回 1。与第 47 条的计划切换验收相比,这里还要排除旧主未被隔离、DNS 或代理仍指向旧中心的风险;一条新连接成功不能证明全部连接池已换目标。
1-- 旧主 SQLNODE01 恢复后,先保持业务入口隔离并直连实例2SELECT ag.name, ars.role_desc,3 ars.operational_state_desc,4 drs.database_state_desc, drs.is_suspended5FROM sys.dm_hadr_availability_replica_states AS ars6JOIN sys.availability_groups AS ag7 ON ag.group_id = ars.group_id8LEFT JOIN sys.dm_hadr_database_replica_states AS drs9 ON drs.replica_id = ars.replica_id10 AND drs.is_local = 111WHERE ars.is_local = 112 AND ag.name = N'SalesAG';旧主回来的数据可能含新主没有的事务。别一开机就让它接业务,更不能未取证便恢复数据移动;先确认 WSFC 中只有一套主角色,按事故方案保全旧数据,再决定重新同步或重建。
1-- 旧主仍隔离、SalesDB 未恢复数据移动时执行2SELECT name, type_desc, physical_name3FROM sys.master_files4WHERE database_id = DB_ID(N'SalesDB')5ORDER BY file_id;若要给旧主的静止副本做快照,需要为每一个数据文件指定快照文件,日志文件不指定。文件列表也便于核对备份路径和剩余空间;不能假设所有库都只有一个 MDF。
1-- 仅适用于经第 76 条确认只有一个数据文件的 SalesDB;旧主保持业务隔离2CREATE DATABASE SalesDB_before_rejoin3ON (NAME = N'SalesDB',4 FILENAME = N'D:\AGEvidence\SalesDB_before_rejoin.ss')5AS SNAPSHOT OF SalesDB;快照保留创建当刻的只读视图,适合在重新同步旧主前核对可能丢失的业务行。多数据文件库必须在 ON 中列出全部数据文件;快照有写时复制的空间和 I/O 开销,不是完整备份,证据保存仍要有独立备份方案。
1-- 在旧主实例执行2SELECT snap.name AS snapshot_name,3 src.name AS source_database,4 snap.create_date5FROM sys.databases AS snap6JOIN sys.databases AS src7 ON src.database_id = snap.source_database_id8WHERE snap.name = N'SalesDB_before_rejoin';结果能证明快照已登记,并说明源库是哪一份;并不能证明快照目录有足够空间保存后续写时复制数据。快照必须在恢复数据移动前完成,否则未进入新主的记录可能已被回退。
1-- 表和键按事故记录替换;只读快照2SELECT order_id, status, updated_at3FROM SalesDB_before_rejoin.dbo.Orders4WHERE order_id = 20260915001;把旧主快照的业务键与新主同一键、应用流水和交易日志对照,才可判断损失范围。示例表结构不是 AG 内置对象;现场若没有这张表,应换成真实的关键业务记录。
1-- 在可访问的 AG 实例执行2SELECT ar.replica_server_name, cs.database_name,3 cs.is_pending_secondary_suspend4FROM sys.dm_hadr_database_replica_cluster_states AS cs5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = cs.replica_id7WHERE cs.is_pending_secondary_suspend = 18ORDER BY ar.replica_server_name, cs.database_name;这是 WSFC 记录的强制切换后辅助库暂停确认状态。若旧主刚回归而此处仍有行,应直接到对应辅助节点查本地库状态;集群标记不能替代业务记录保全。
1-- 旧主保持隔离;记录原值,不直接按数字大小推断数据损失2SELECT adc.database_name, drs.end_of_log_lsn,3 drs.last_commit_lsn, drs.recovery_lsn,4 drs.truncation_lsn5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8WHERE drs.is_local = 19ORDER BY adc.database_name;这里的 last_commit_lsn 是真实提交 LSN,end_of_log_lsn、recovery_lsn 和截断值有各自的 AG 语义,不能混作同一种 LSN 相减。保存这些值用于与新主日志链和备份记录核对,最终损失仍以业务记录与日志取证为准。
1-- 旧主 SQLNODE01 直连2SELECT adc.database_name, drs.is_suspended,3 drs.suspend_reason_desc,4 drs.synchronization_state_desc5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8WHERE drs.is_local = 19ORDER BY adc.database_name;此时旧主若已认出 SQLNODE02 为新主,数据库应按辅助副本处理。SUSPEND_FROM_PARTNER 不应被当成“清一下状态即可”的告警;先把第 77—81 条的证据留住,再决定能否重新同步。
1-- 在旧主 SQLNODE01 的 msdb 执行2SELECT TOP (10) bs.backup_finish_date, bs.first_lsn,3 bs.last_lsn, bs.server_name, bmf.physical_device_name4FROM msdb.dbo.backupset AS bs5JOIN msdb.dbo.backupmediafamily AS bmf6 ON bmf.media_set_id = bs.media_set_id7WHERE bs.database_name = N'SalesDB'8 AND bs.type = 'L'9ORDER BY bs.backup_finish_date DESC;旧主上的日志备份也可能包含需要取证的事务。physical_device_name 是登记的介质路径,不证明文件如今可读;先保全原介质,再与新主切换后的日志备份链分开核对。
1-- 在新主 SQLNODE02 执行;切换时间按事故记录替换2SELECT TOP (10) backup_start_date, backup_finish_date,3 server_name, is_copy_only4FROM msdb.dbo.backupset5WHERE database_name = N'SalesDB'6 AND type = 'D'7 AND backup_start_date >= '2026-09-15T18:00:00'8ORDER BY backup_finish_date DESC;灾备切换后要建立新主可用的恢复基线。完整备份历史行只是作业记录,仍需确认备份文件、日志链和隔离恢复;也不要把辅助库上的 copy-only 全备误写成改变差异备份基线的常规全备。
1-- 在当前新主 SQLNODE02 执行2SELECT replica_server_name, availability_mode_desc,3 failover_mode_desc, backup_priority,4 secondary_role_allow_connections_desc5FROM sys.availability_replicas6WHERE group_id =7 (SELECT group_id FROM sys.availability_groups8 WHERE name = N'SalesAG')9ORDER BY replica_server_name;旧主回归后要决定它先按什么提交模式追日志、是否承接只读流量,以及备份作业在哪里跑。这是现有配置快照,不是恢复操作;强制切换可能已经改变实际容灾能力,下一节再检查是否可以计划回切。
1-- 直连旧主 SQLNODE012SELECT ar.replica_server_name, ars.role_desc,3 ars.connected_state_desc, ars.recovery_health_desc4FROM sys.dm_hadr_availability_replica_states AS ars5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = ars.replica_id7WHERE ars.is_local = 1;旧主重新开机不等于重新成为主副本。先确认它已接受新集群角色;如果仍是 RESOLVING 或无法连接当前主副本,不要急着恢复数据移动。
1-- 直连旧主 SQLNODE012SELECT d.name, d.state_desc,3 d.group_database_id,4 drs.synchronization_state_desc,5 drs.is_suspended6FROM sys.databases AS d7LEFT JOIN sys.dm_hadr_database_replica_states AS drs8 ON drs.group_database_id = d.group_database_id9 AND drs.is_local = 110WHERE d.name = N'SalesDB';没有 group_database_id 的库并不在 AG 数据移动链上。遇到这种情况,先查数据库是否被移出 AG、是否需要重新初始化,不能对它直接执行 HADR RESUME。
1-- 旧主已是辅助副本;第 76—83 条证据已留存并经业务确认2ALTER DATABASE SalesDB SET HADR RESUME;强制故障转移后,旧主上未进入新主的事务可能在重新同步时被回退。这条命令只解决暂停的数据移动;是否接受可能的数据损失,应在执行前定下来。
1-- 在旧主 SQLNODE01 执行;按数据库分别观察2SELECT adc.database_name, drs.synchronization_state_desc,3 drs.is_suspended, drs.redo_queue_size,4 drs.last_commit_time5FROM sys.dm_hadr_database_replica_states AS drs6JOIN sys.availability_databases_cluster AS adc7 ON adc.group_database_id = drs.group_database_id8WHERE drs.is_local = 19ORDER BY adc.database_name;redo 队列大小单位为 KB。恢复数据移动后先确认不再暂停,再连续取样看队列是否下降;日志发送队列应到当前主副本查对应辅助副本,不能读取旧主本地行代替。
1-- 在当前主副本 SQLNODE02 执行2SELECT ar.replica_server_name, adc.database_name,3 cs.is_failover_ready, cs.is_database_joined4FROM sys.dm_hadr_database_replica_cluster_states AS cs5JOIN sys.availability_replicas AS ar6 ON ar.replica_id = cs.replica_id7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = cs.group_database_id9WHERE ar.replica_server_name = N'SQLNODE01'10ORDER BY adc.database_name;这里看 WSFC 记录的逐库准备状态。计划回切仍需在目标副本上核对同步提交、SYNCHRONIZED 与业务连接;不要凭某一库的 is_failover_ready = 1 就切整个 AG。
1-- 在当前主副本 SQLNODE02 执行2SELECT ar.replica_server_name, ar.availability_mode_desc,3 ar.failover_mode_desc, ars.synchronization_health_desc4FROM sys.availability_replicas AS ar5LEFT JOIN sys.dm_hadr_availability_replica_states AS ars6 ON ars.replica_id = ar.replica_id7WHERE ar.replica_server_name = N'SQLNODE01';计划手动回切要求目标辅助副本采用同步提交,并且所有 AG 数据库都已经同步。故障转移模式是否为 AUTOMATIC 是另一个配置项,不能代替同步提交检查。
1-- 当前主副本执行;先评估跨机房时延和提交延迟2ALTER AVAILABILITY GROUP SalesAG3MODIFY REPLICA ON N'SQLNODE01'4WITH (AVAILABILITY_MODE = SYNCHRONOUS_COMMIT);旧主若按异步提交运行,计划回切前需要调整提交模式并等待逐库同步。跨机房链路慢时,同步提交会影响主库事务延迟;这一步应配合业务窗口。
1-- 在旧主 SQLNODE01 执行2SELECT COUNT(*) AS database_count,3 SUM(CASE WHEN drs.synchronization_state_desc = 'SYNCHRONIZED'4 AND drs.is_suspended = 0 THEN 1 ELSE 0 END)5 AS synchronized_count6FROM sys.dm_hadr_database_replica_states AS drs7JOIN sys.availability_databases_cluster AS adc8 ON adc.group_database_id = drs.group_database_id9WHERE drs.is_local = 1;两个数量必须相等,再用第 90 条看 WSFC 准备状态。这里的聚合仅给出进度,不替代逐库排查;特别注意新加入或尚未初始化的数据库。
1-- 当前主副本 SQLNODE02;业务冻结前后各取一次2SELECT DB_NAME(database_id) AS database_name,3 COUNT(*) AS active_requests4FROM sys.dm_exec_requests5WHERE database_id IN6 (SELECT database_id FROM sys.databases7 WHERE group_database_id IS NOT NULL)8 AND session_id <> @@SPID9GROUP BY database_id;这里查正在执行的请求,并不统计空闲连接,也不证明应用已经停止写入。计划回切时应用写入冻结、连接池切换和回退路径仍需单独确认。
1-- 当前主副本 SQLNODE02 的 msdb;备份策略可能偏好辅助副本2SELECT bs.database_name, MAX(bs.backup_finish_date) AS last_log_backup3FROM msdb.dbo.backupset AS bs4WHERE bs.type = 'L'5 AND bs.database_name IN6 (SELECT name FROM sys.databases7 WHERE group_database_id IS NOT NULL)8GROUP BY bs.database_name;这是当前实例的备份历史。若 AG 把备份分配到辅助副本,需要到实际执行备份的节点核对;没有记录不必然表示全组没有日志备份。
1-- 只在目标辅助副本 SQLNODE01 执行;所有库 SYNCHRONIZED2ALTER AVAILABILITY GROUP SalesAG FAILOVER;这是计划手动故障转移,与前面的强制故障转移不同,不带允许数据丢失参数。第 44 条已给过相同语法;这里保留回切场景,提醒操作位置是将成为主副本的 SQLNODE01。
1-- 分别直连 SQLNODE01、SQLNODE02 执行2SELECT @@SERVERNAME AS instance_name,3 ar.replica_server_name, ars.role_desc,4 ars.connected_state_desc5FROM sys.dm_hadr_availability_replica_states AS ars6JOIN sys.availability_replicas AS ar7 ON ar.replica_id = ars.replica_id8WHERE ars.is_local = 1;命令返回成功后,仍要分别查两边角色。若旧站点经历过强制仲裁或网络分区,先核对 WSFC 投票与集群状态,避免把两边各自的“主”误当成一次正常回切。
1-- 两个节点分别执行2SELECT d.name, d.state_desc,3 drs.synchronization_state_desc,4 drs.synchronization_health_desc,5 drs.is_suspended6FROM sys.databases AS d7JOIN sys.dm_hadr_database_replica_states AS drs8 ON drs.group_database_id = d.group_database_id9 AND drs.is_local = 110WHERE d.group_database_id IS NOT NULL11ORDER BY d.name;新主应在线,辅助库应继续同步。不能把角色回切成功当成数据库就绪;逐库查看状态,尤其留意切换后被暂停的库。
1-- 使用与应用相同的侦听器和连接参数,成功连接后执行2SELECT @@SERVERNAME AS connected_instance,3 DB_NAME() AS database_name,4 sys.fn_hadr_is_primary_replica(DB_NAME()) AS is_primary;这条 SQL 必须通过业务使用的侦听器连接,不能先直连节点再执行。主业务连接应落到新主;只读意图连接还要按实际只读路由单独验证。
1-- 分别在承担备份作业的节点执行2SELECT @@SERVERNAME AS instance_name,3 sys.fn_hadr_backup_is_preferred_replica(N'SalesDB')4 AS is_preferred_backup_replica;回切会改变角色,备份作业可能随之换节点。这个函数反映 AG 的备份偏好,不证明作业已经成功;还要核对下一次实际备份、文件可读性和恢复演练。
SQL Server Always On 排障要把副本连接、同步状态、发送队列、重做队列和 Listener 分开检查。计划故障转移要求目标副本具备切换条件,强制故障转移则必须先评估数据损失和双主风险。
把 AG 名称、副本名、Listener、同步模式和故障转移策略整理成现场版本。平时保留队列与延迟基线,切换时才能判断当前状态是否真的异常。
更多数据库运维内容可在 ORA100 · DBA100 查看:
微信里搜索小程序 「三笠的百令册」,也可以继续查看这个系列。
 ORA100 DBA100