performance30 分钟阅读
SQL Server Query Store 性能回归排查 100 条命令
同一条 SQL 昨天还快,今天突然变慢,先别急着改索引。SQL Server 的 Query Store 能把语句、执行计划和分时段的运行数据留在库里,适合对比“什么时候变慢”“是不是换了计划”。如果 Query Store 已经只读或采集范围不对,查不到记录也要先解释清楚。
2026年9月16日阅读—点赞—收藏—
dba100sqlserverscenario
100 条命令系列文章专栏
同一条 SQL 昨天还快,今天突然变慢,先别急着改索引。SQL Server 的 Query Store 能把语句、执行计划和分时段的运行数据留在库里,适合对比“什么时候变慢”“是不是换了计划”。如果 Query Store 已经只读或采集范围不对,查不到记录也要先解释清楚。
同一条 SQL 昨天还快,今天突然变慢,先别急着改索引。SQL Server 的 Query Store 能把语句、执行计划和分时段的运行数据留在库里,适合对比“什么时候变慢”“是不是换了计划”。如果 Query Store 已经只读或采集范围不对,查不到记录也要先解释清楚。
这篇从采集状态、耗时排行、计划变化开始整理常用命令。遇到性能回归时按时间窗口查;建议收藏,也方便把计划证据转给开发同事。
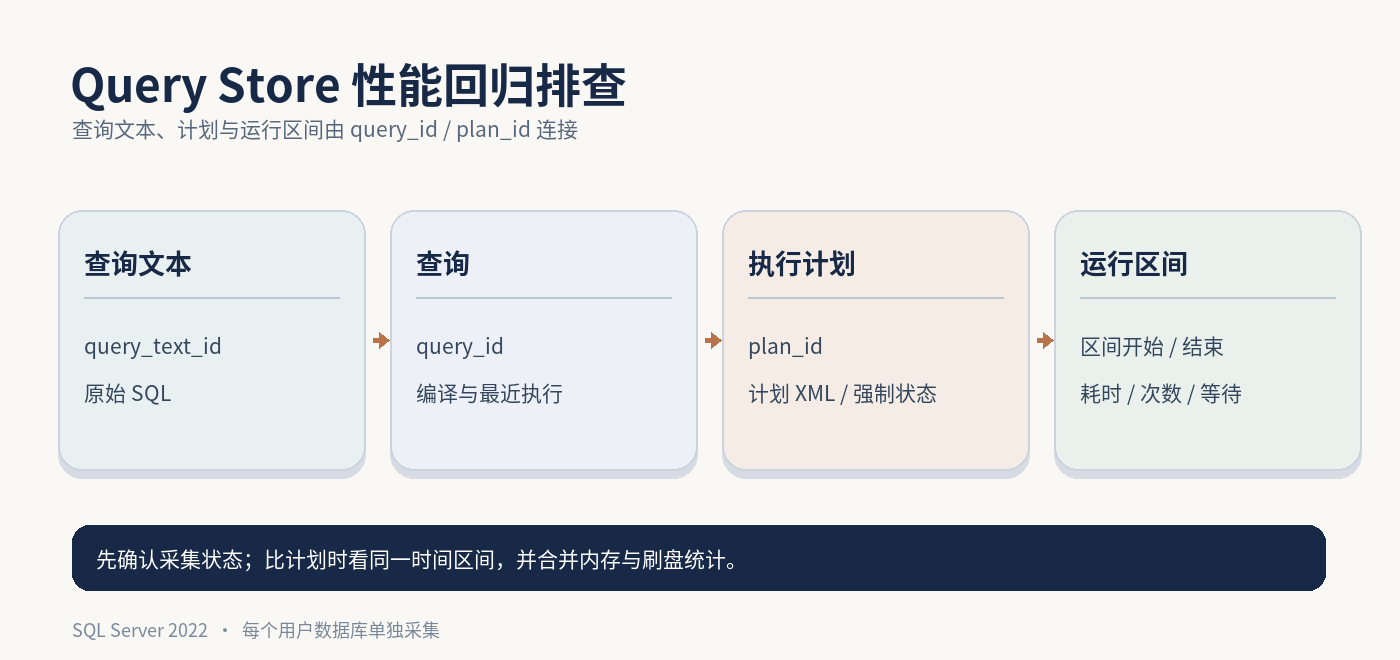 SQL Server Query Store 数据关系示意图
示例采用 SQL Server 2022,在目标用户数据库执行。运行时统计按区间聚合,微秒与毫秒要换算。后半部分涉及强制计划、调整采集策略;动手前先留存旧设置和故障窗口的数据。
SQL Server 2022 的参数敏感计划会把运行数据记在查询变体上;父查询的 query_id 查不到完整成本时,接着看第 81 条之后的变体命令。
1SELECT desired_state_desc, actual_state_desc, readonly_reason,2 current_storage_size_mb, max_storage_size_mb3FROM sys.database_query_store_options;重点比较期望状态与实际状态。配置为 READ_WRITE、实际却是 READ_ONLY 时,看 readonly_reason;容量到上限只是一种可能,不能只看开关说它正常。
1SELECT query_capture_mode_desc, interval_length_minutes,2 flush_interval_seconds, stale_query_threshold_days3FROM sys.database_query_store_options;采集模式会影响短时或低频 SQL 是否被收录。时间区间长度决定后面能比较到多细;它不是逐次执行的完整审计日志。
1SELECT TOP (20) q.query_id, q.query_text_id,2 q.last_execution_time, t.query_sql_text3FROM sys.query_store_query AS q4JOIN sys.query_store_query_text AS t5 ON t.query_text_id = q.query_text_id6ORDER BY q.last_execution_time DESC;query_id 对应查询,query_text_id 对应文本。文本可能含业务参数或敏感内容,导出排查材料时注意权限。
1SELECT plan_id, query_id, is_forced_plan,2 last_compile_start_time, last_execution_time,3 force_failure_count, last_force_failure_reason_desc4FROM sys.query_store_plan5WHERE query_id = 123456ORDER BY last_execution_time DESC;把 12345 换成现场 query_id。一条查询可能有多个计划;is_forced_plan=1 也不保证每次实际执行的计划都完全相同,失败原因要一起看。
1SELECT plan_id, TRY_CONVERT(xml, query_plan) AS plan_xml2FROM sys.query_store_plan3WHERE plan_id = 67890;把计划 ID 换成现场值。先保存计划,再与变慢前的计划比较访问路径、连接方式和估计行数;单看 XML 不能证明实际执行耗时。
1SELECT rs.plan_id, rs.runtime_stats_interval_id,2 SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_duration * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)5 AS avg_duration_ms6FROM sys.query_store_runtime_stats AS rs7WHERE rs.plan_id = 67890 AND rs.execution_type = 08GROUP BY rs.plan_id, rs.runtime_stats_interval_id9ORDER BY rs.runtime_stats_interval_id DESC;avg_duration 单位是微秒,除以 1000 才是毫秒。同一计划、区间可能有已刷盘和内存中的多行,所以先按区间合并,平均值用执行次数加权,不能直接平均两个 avg_duration。
1SELECT rs.plan_id, i.start_time, i.end_time,2 SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_duration * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)5 AS avg_duration_ms6FROM sys.query_store_runtime_stats AS rs7JOIN sys.query_store_runtime_stats_interval AS i8 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id9WHERE rs.plan_id = 67890 AND rs.execution_type = 010GROUP BY rs.plan_id, i.start_time, i.end_time11ORDER BY i.start_time DESC;把慢的时间段和业务发布、统计信息维护、数据量突变对齐。区间平均可能掩盖少量尖峰,还应检查最大耗时和执行次数。
1SELECT q.query_id, p.plan_id, p.is_forced_plan,2 p.last_execution_time, p.last_compile_start_time,3 p.last_force_failure_reason_desc4FROM sys.query_store_query AS q5JOIN sys.query_store_plan AS p6 ON p.query_id = q.query_id7WHERE q.query_id = 123458ORDER BY p.last_execution_time DESC;先确认计划有没有在故障时段切换,再比较第 7 条的区间耗时。即使计划 ID 没变,参数选择性、资源等待也可能让这条 SQL 变慢。
1-- 替换 plan_id;同一区间的多行统计先合并2SELECT i.start_time, i.end_time,3 SUM(rs.count_executions) AS executions,4 ROUND(MAX(rs.max_duration) / 1000.0, 2) AS max_duration_ms,5 ROUND(SUM(rs.avg_duration * rs.count_executions)6 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)7 AS avg_duration_ms8FROM sys.query_store_runtime_stats AS rs9JOIN sys.query_store_runtime_stats_interval AS i10 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id11WHERE rs.plan_id = 67890 AND rs.execution_type = 012GROUP BY i.start_time, i.end_time13ORDER BY i.start_time DESC;平均 30 毫秒、最大 30 秒,往往是少数执行被阻塞或遇到异常参数。把最大值、平均值和执行次数一起看,不要拿区间平均值代替单次故障证据。Query Store 仍是聚合统计,无法还原每次执行的完整参数。
1-- 替换 plan_id;avg_cpu_time 和 avg_duration 都是微秒2SELECT i.start_time,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_duration * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)6 AS avg_duration_ms,7 ROUND(SUM(rs.avg_cpu_time * rs.count_executions)8 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)9 AS avg_cpu_ms10FROM sys.query_store_runtime_stats AS rs11JOIN sys.query_store_runtime_stats_interval AS i12 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id13WHERE rs.plan_id = 67890 AND rs.execution_type = 014GROUP BY i.start_time15ORDER BY i.start_time DESC;耗时涨而 CPU 时间基本不变,优先查等待、锁和 I/O;两者一起涨,再核对计划、估计行数和扫描量。并行查询的 CPU 时间可以累计多个 worker,不宜简单与墙钟耗时做一比一比较。
1-- 同一 query_id 的多个计划按区间汇总,替换现场 query_id2SELECT p.plan_id, i.start_time,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_read_pages6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE p.query_id = 12345 AND rs.execution_type = 011GROUP BY p.plan_id, i.start_time12ORDER BY i.start_time DESC, p.plan_id;这里的单位是 8 KB 页,不是读取行数。新计划逻辑读数明显增加,常见原因是访问路径变成扫描、连接顺序变化或谓词选择性不同;还要对照同一时段的执行参数和数据量,不能只凭页数判定索引失效。
1-- 替换 plan_id;当前区间可能有内存和已刷盘多行2SELECT i.start_time, ws.wait_category_desc,3 SUM(ws.total_query_wait_time_ms) AS total_wait_ms4FROM sys.query_store_wait_stats AS ws5JOIN sys.query_store_runtime_stats_interval AS i6 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id7WHERE ws.plan_id = 67890 AND ws.execution_type = 08GROUP BY i.start_time, ws.wait_category_desc9ORDER BY i.start_time DESC, total_wait_ms DESC;Query Store 把等待类型归到类别,不是逐条等待明细。Lock 类别高,接着查阻塞链;Buffer IO 高,再查实际 I/O 与计划。统计若没采集到等待,不等于这条 SQL 从未等待。
1-- 替换 plan_id;按执行类型汇总,避免异常样本被正常均值吞掉2SELECT i.start_time, rs.execution_type_desc,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_duration * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)6 AS avg_duration_ms7FROM sys.query_store_runtime_stats AS rs8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE rs.plan_id = 6789011GROUP BY i.start_time, rs.execution_type_desc12ORDER BY i.start_time DESC, rs.execution_type_desc;Aborted 是客户端发起中止,Exception 是异常中止。慢 SQL 造成应用超时后,正常执行的均值可能仍不高;先把这两类样本单独看,再结合应用超时日志和当时的等待。
1-- 替换 query_id 和时间窗;时间值要与 Query Store 的 datetimeoffset 对齐2SELECT p.plan_id, i.start_time, i.end_time,3 MIN(rs.first_execution_time) AS first_execution_time,4 MAX(rs.last_execution_time) AS last_execution_time,5 SUM(rs.count_executions) AS executions6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE p.query_id = 12345 AND rs.execution_type = 011 AND i.start_time < '2026-09-16T11:00:00+08:00'12 AND i.end_time > '2026-09-16T10:00:00+08:00'13GROUP BY p.plan_id, i.start_time, i.end_time14ORDER BY i.start_time, p.plan_id;先确认新旧计划在故障时间段是否都真的执行过。区间与窗口相交,并不代表每次执行都发生在窗口内;首次、末次执行时间能帮助收窄判断。把例子中的时间改成现场故障窗口,注意时区。
1-- 替换 query_id 和窗口;当前区间的多行统计按计划合并2SELECT p.plan_id, p.is_forced_plan,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_duration * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)6 AS avg_duration_ms7FROM sys.query_store_plan AS p8JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id9JOIN sys.query_store_runtime_stats_interval AS i10 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id11WHERE p.query_id = 12345 AND rs.execution_type = 012 AND i.start_time < '2026-09-16T11:00:00+08:00'13 AND i.end_time > '2026-09-16T10:00:00+08:00'14GROUP BY p.plan_id, p.is_forced_plan15ORDER BY avg_duration_ms DESC;同一 query_id 的计划有足够执行量,平均耗时比较才比较稳。若慢计划只执行一次,先看第 9 条最大值和实际等待;若新旧计划同时变慢,就别把问题简单归咎于计划切换。
1-- 目标用户数据库执行;先只读检查,不改强制计划2SELECT query_id, plan_id, plan_forcing_type_desc,3 force_failure_count, last_force_failure_reason_desc,4 last_compile_start_time, last_execution_time5FROM sys.query_store_plan6WHERE is_forced_plan = 1 AND force_failure_count > 07ORDER BY force_failure_count DESC, last_compile_start_time DESC;“已经强制”不等于“强制始终生效”。失败次数增加时看原因:索引被删、数据库对象变化、计划不合法等都可能让 SQL Server 重新编译。先确认失败发生的时间和实际运行计划,再考虑解除或重新强制,不能仅凭 is_forced_plan=1 宣告回退成功。
1-- 用现场查到的 query_hash 替换示例值;只在目标用户数据库查询2SELECT q.query_id, q.context_settings_id,3 q.query_parameterization_type_desc,4 q.last_execution_time, q.query_text_id5FROM sys.query_store_query AS q6WHERE q.query_hash = 0x0123456789ABCDEF7ORDER BY q.last_execution_time DESC;同一 query_hash 下有多个 query_id,不要只取其中一个就断言“这条 SQL 没有计划变化”。编译上下文、参数化和文本都可能不同;先看各项是否可比,再确定实际业务请求落在哪个 query_id。哈希只是查找线索,不是语义相同的证明。
1-- 替换 query_hash;不同 SET 选项可能让同一文本生成不同查询记录2SELECT q.query_id, q.context_settings_id,3 c.set_options, c.language_id, c.date_format, c.date_first4FROM sys.query_store_query AS q5JOIN sys.query_context_settings AS c6 ON c.context_settings_id = q.context_settings_id7WHERE q.query_hash = 0x0123456789ABCDEF8ORDER BY q.query_id;set_options 是位掩码,不能直接把十六进制值读成某一个 SET 参数。若应用连接和管理工具的上下文不同,直接拿各自的计划比较可能误判回归;先核对业务连接的设置,再查计划。
1-- 替换现场 query_id;object_id=0 通常表示不是模块内的查询2SELECT q.query_id, q.object_id,3 OBJECT_SCHEMA_NAME(NULLIF(q.object_id, 0)) AS schema_name,4 OBJECT_NAME(NULLIF(q.object_id, 0)) AS object_name,5 q.query_parameterization_type_desc6FROM sys.query_store_query AS q7WHERE q.query_id = 12345;从存储过程编译出的语句会带模块 object_id;临时拼出的 SQL 通常没有。这个判断有助于找到负责代码和对应发布版本,但不能只凭 object_id=0 判定它一定来自某个应用。
1-- 替换 query_id;计划哈希相同也要看运行时统计2SELECT plan_id, query_plan_hash, compatibility_level,3 count_compiles, last_compile_start_time,4 is_forced_plan, last_force_failure_reason_desc5FROM sys.query_store_plan6WHERE query_id = 123457ORDER BY last_compile_start_time DESC;新旧 plan_id 的计划哈希不同,说明计划形状值得细看;哈希相同也不能证明耗时必然相同。编译次数或兼容级别变化后,接着看 XML、执行量和等待。计划 ID、计划哈希都只是索引证据,最终还得落到故障时间窗的实际运行数据。
1SELECT TOP (30) p.query_id,2 COUNT(*) AS plan_rows,3 COUNT(DISTINCT p.query_plan_hash) AS distinct_plan_shapes,4 MAX(p.last_execution_time) AS last_execution_time5FROM sys.query_store_plan AS p6GROUP BY p.query_id7HAVING COUNT(DISTINCT p.query_plan_hash) > 18ORDER BY distinct_plan_shapes DESC, last_execution_time DESC;先看最近仍在执行、确实有多种计划形状的查询。多个计划不等于性能回归:参数值不同、索引变化或正常优化都会让计划不同。筛出候选后,再用第 14、15 条对齐故障窗口和运行量。
1-- 按现场故障起点替换时间;避免把多年未执行的计划拿来解释今天的故障2SELECT TOP (30) query_id, plan_id, query_plan_hash,3 initial_compile_start_time, last_execution_time,4 count_compiles5FROM sys.query_store_plan6WHERE initial_compile_start_time >= '2026-09-16T10:00:00+08:00'7ORDER BY initial_compile_start_time DESC;新计划出现时间与业务发布、统计信息更新或兼容级别变更相近,值得追查。initial_compile_start_time 只是首次编译的时间,不证明业务慢请求一定使用了它;继续看对应区间的执行次数。
1SELECT TOP (30) query_id, plan_id,2 count_compiles, last_compile_start_time,3 last_execution_time,4 ROUND(avg_compile_duration / 1000.0, 2) AS avg_compile_ms5FROM sys.query_store_plan6WHERE count_compiles > 17ORDER BY count_compiles DESC, last_compile_start_time DESC;count_compiles 是累计次数,avg_compile_duration 的原始单位是微秒。次数高时核对计划是否频繁失效、统计信息是否反复改变、查询是否大量临时生成。累计次数不能说明今天才发生编译风暴;还要看时间窗里的编译和业务 CPU 读数。
1SELECT query_id, plan_id,2 plan_forcing_type_desc, is_forced_plan,3 force_failure_count, last_force_failure_reason_desc,4 last_execution_time5FROM sys.query_store_plan6WHERE plan_forcing_type_desc IN ('MANUAL', 'AUTO')7ORDER BY last_execution_time DESC;MANUAL 是人工强制,AUTO 是自动调优强制。发现回归时先弄清谁在控制计划,再看强制失败次数和实际运行统计;不要把自动动作当成人工变更,也不要在未核对回退方案前直接解除强制。
1SELECT actual_state_desc, wait_stats_capture_mode_desc,2 interval_length_minutes3FROM sys.database_query_store_options;第 12 条查不到等待类别时,先看 wait_stats_capture_mode_desc。设为 OFF 就没有对应采集;设为 ON 也只是按区间汇总,不能还原每次执行的等待细节。若 Query Store 整体只读,近期数据同样可能缺失。
1SELECT current_storage_size_mb, max_storage_size_mb,2 ROUND(current_storage_size_mb * 100.03 / NULLIF(max_storage_size_mb, 0), 1) AS used_percent,4 actual_state_desc5FROM sys.database_query_store_options;容量接近上限时要留意自动清理和实际采集状态。used_percent 只是磁盘存储比例;Query Store 还可能因为内存或数据库空间原因转只读,所以不能只靠这个值解释 READ_ONLY。
1-- readonly_reason 是位图,可能同时命中多个原因2SELECT readonly_reason,3 CASE WHEN (readonly_reason & 65536) <> 0 THEN 1 ELSE 0 END AS storage_quota_hit,4 CASE WHEN (readonly_reason & 131072) <> 0 THEN 1 ELSE 0 END AS statement_memory_limit_hit,5 CASE WHEN (readonly_reason & 262144) <> 0 THEN 1 ELSE 0 END AS pending_flush_memory_hit,6 CASE WHEN (readonly_reason & 524288) <> 0 THEN 1 ELSE 0 END AS database_disk_limit_hit7FROM sys.database_query_store_options8WHERE actual_state_desc = 'READ_ONLY';65536 是 Query Store 自身容量上限,524288 是用户数据库磁盘空间限制,两者处置不同。内存待刷盘达到限制可能是暂时的。读出原因后先判断存储、清理和数据库空间,再制定恢复采集方案;不要一上来就清空 Query Store 历史。
1SELECT size_based_cleanup_mode_desc,2 stale_query_threshold_days,3 current_storage_size_mb, max_storage_size_mb4FROM sys.database_query_store_options;容量自动清理通常接近 90% 上限时启动,优先淘汰成本低且较旧的查询;保留天数也会影响能否追到上月的旧计划。遇到“以前明明有这个计划”的情况,先核对清理策略,不要立刻认定 SQL 从未使用过该计划。
1-- 替换 query_id;max_plans_per_query=0 表示不限制2SELECT o.max_plans_per_query,3 COUNT(p.plan_id) AS captured_plans4FROM sys.database_query_store_options AS o5CROSS JOIN sys.query_store_query AS q6LEFT JOIN sys.query_store_plan AS p ON p.query_id = q.query_id7WHERE q.query_id = 123458GROUP BY o.max_plans_per_query;达到单查询计划数上限后,Query Store 不再为这条查询存新计划。计划多并不一定都代表不同形状,仍需对照哈希。碰到上限时,故障当天的“新计划查不到”不能被当成“没有换计划”。
1-- CUSTOM 模式才按这些门槛判定是否收录新查询2SELECT query_capture_mode_desc,3 capture_policy_execution_count,4 capture_policy_total_compile_cpu_time_ms,5 capture_policy_total_execution_cpu_time_ms,6 capture_policy_stale_threshold_hours7FROM sys.database_query_store_options;低频但重要的业务 SQL 查不到时,看看采集模式是不是 CUSTOM,以及评估窗口和执行次数、CPU 门槛。如果是 NONE,新查询会停止收录,但已收录查询仍继续积累统计;不能用“Query Store 开着”来保证所有新 SQL 都有记录。
1-- 窗口按现场替换;此查询按 query_id 汇总所有计划2SELECT TOP (20) p.query_id,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_duration * rs.count_executions) / 1000.0, 1)5 AS total_duration_ms6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE rs.execution_type = 011 AND i.start_time < '2026-09-16T11:00:00+08:00'12 AND i.end_time > '2026-09-16T10:00:00+08:00'13GROUP BY p.query_id14ORDER BY total_duration_ms DESC;总耗时高可能是单次极慢,也可能是大量中等耗时的执行。先看执行次数,再对照平均和最大耗时。这里按统计区间与窗口相交筛选,边界区间会包含窗口外的执行,故障窗口很短时要注明这个误差。
1-- 同一时间窗按 query_id 汇总所有计划2SELECT TOP (20) p.query_id,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_cpu_time * rs.count_executions) / 1000.0, 1)5 AS total_cpu_ms6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE rs.execution_type = 011 AND i.start_time < '2026-09-16T11:00:00+08:00'12 AND i.end_time > '2026-09-16T10:00:00+08:00'13GROUP BY p.query_id14ORDER BY total_cpu_ms DESC;CPU 排名与耗时排名不同,说明有些 SQL 慢在等待而不是计算。并行执行的 CPU 会累计 worker 时间;用它衡量数据库 CPU 负担有价值,但不能与单次墙钟耗时直接相减求等待时间。
1-- 逻辑读取的单位是 8 KB 页;按 query_id 汇总所有计划2SELECT TOP (20) p.query_id,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions), 0)5 AS total_read_pages6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE rs.execution_type = 011 AND i.start_time < '2026-09-16T11:00:00+08:00'12 AND i.end_time > '2026-09-16T10:00:00+08:00'13GROUP BY p.query_id14ORDER BY total_read_pages DESC;高逻辑读取可能是某个计划突然扫描,也可能只是调用次数多。回到第 11 条按计划比较每次平均读取量,再看 SQL 文本和业务请求。总页数不能直接换成物理磁盘读数。
1-- 示例窗口按现场替换;区间与窗口相交时会计入整个区间2SELECT TOP (20) p.query_id,3 SUM(rs.count_executions) AS executions,4 COUNT(DISTINCT p.plan_id) AS plans_used5FROM sys.query_store_plan AS p6JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id7JOIN sys.query_store_runtime_stats_interval AS i8 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id9WHERE rs.execution_type = 010 AND i.start_time < '2026-09-16T11:00:00+08:00'11 AND i.end_time > '2026-09-16T10:00:00+08:00'12GROUP BY p.query_id13ORDER BY executions DESC;执行次数高的查询即使每次只多几毫秒,也可能把整库拖慢。拿同长度的正常窗口做对照;如果次数变了而计划没变,先查应用流量、重试和定时任务,别急着强制计划。
1-- 示例只查最近一天;多行统计按计划和区间合并2SELECT TOP (20) p.query_id, rs.plan_id, i.start_time,3 SUM(rs.count_executions) AS executions,4 ROUND(MAX(rs.max_duration) / 1000.0, 1) AS max_ms,5 ROUND(SUM(rs.avg_duration * rs.count_executions)6 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 1)7 AS avg_ms8FROM sys.query_store_plan AS p9JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id10JOIN sys.query_store_runtime_stats_interval AS i11 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id12WHERE rs.execution_type = 013 AND i.end_time > DATEADD(DAY, -1, SYSDATETIMEOFFSET())14GROUP BY p.query_id, rs.plan_id, i.start_time15HAVING SUM(rs.count_executions) >= 1016ORDER BY max_ms DESC;这里先要求至少 10 次执行,避免把单个样本的最大值与均值比得太认真。高尖峰可能是锁等待、I/O 或极端参数;再查当时等待类别和应用日志。Query Store 的区间粒度仍可能比故障持续时间粗。
1-- 按计划和区间看行数范围;当前区间多行记录取各行极值2SELECT TOP (20) p.query_id, rs.plan_id, i.start_time,3 SUM(rs.count_executions) AS executions,4 MIN(rs.min_rowcount) AS min_rows,5 MAX(rs.max_rowcount) AS max_rows6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id10WHERE rs.execution_type = 011 AND i.end_time > DATEADD(DAY, -1, SYSDATETIMEOFFSET())12GROUP BY p.query_id, rs.plan_id, i.start_time13HAVING SUM(rs.count_executions) >= 1014ORDER BY max_rows DESC;同一计划有的执行返回几行、有的返回百万行,说明请求范围或参数可能差别很大。返回行数不是扫描行数,不能据此直接判断索引好坏;要把业务参数、计划估计和逻辑读数一起看。
1-- 先确认第 25 条等待采集为 ON;最近一天按区间和类别汇总2SELECT TOP (20) p.query_id, ws.plan_id, i.start_time,3 ws.wait_category_desc,4 SUM(ws.total_query_wait_time_ms) AS total_wait_ms,5 MAX(ws.max_query_wait_time_ms) AS max_wait_ms6FROM sys.query_store_plan AS p7JOIN sys.query_store_wait_stats AS ws ON ws.plan_id = p.plan_id8JOIN sys.query_store_runtime_stats_interval AS i9 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id10WHERE ws.execution_type = 011 AND i.end_time > DATEADD(DAY, -1, SYSDATETIMEOFFSET())12GROUP BY p.query_id, ws.plan_id, i.start_time, ws.wait_category_desc13ORDER BY max_wait_ms DESC;max_wait_ms 能把少数突发等待从平均值里挑出来。类别只能给方向:锁类继续查阻塞链,I/O 类继续核对文件延迟和计划。当前区间可能同时有内存、已刷盘多行,累计值先求和,最大值取最大;别直接把行数当成执行次数。
1-- 两个等长窗口与 query_id 都按现场替换2WITH windows AS (3 SELECT 'normal' AS period,4 CAST('2026-09-15T10:00:00+08:00' AS datetimeoffset) AS from_time,5 CAST('2026-09-15T11:00:00+08:00' AS datetimeoffset) AS to_time6 UNION ALL7 SELECT 'incident',8 CAST('2026-09-16T10:00:00+08:00' AS datetimeoffset),9 CAST('2026-09-16T11:00:00+08:00' AS datetimeoffset)10)11SELECT w.period, SUM(rs.count_executions) AS executions,12 ROUND(SUM(rs.avg_duration * rs.count_executions)13 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)14 AS avg_duration_ms15FROM windows AS w16JOIN sys.query_store_runtime_stats_interval AS i17 ON i.start_time < w.to_time AND i.end_time > w.from_time18JOIN sys.query_store_runtime_stats AS rs19 ON rs.runtime_stats_interval_id = i.runtime_stats_interval_id20JOIN sys.query_store_plan AS p ON p.plan_id = rs.plan_id21WHERE p.query_id = 12345 AND rs.execution_type = 022GROUP BY w.period;比较要选业务负载接近的两个时段,并把执行次数一起带上。平均耗时涨了而次数也暴增,先查流量与资源竞争;次数接近、计划却换了,再继续比较计划。窗口边界仍按整个统计区间计入,不是逐次精确截取。
1-- 与上一条使用相同的窗口;替换 query_id2WITH windows AS (3 SELECT 'normal' AS period,4 CAST('2026-09-15T10:00:00+08:00' AS datetimeoffset) AS from_time,5 CAST('2026-09-15T11:00:00+08:00' AS datetimeoffset) AS to_time6 UNION ALL7 SELECT 'incident',8 CAST('2026-09-16T10:00:00+08:00' AS datetimeoffset),9 CAST('2026-09-16T11:00:00+08:00' AS datetimeoffset)10)11SELECT w.period, p.plan_id, p.query_plan_hash,12 SUM(rs.count_executions) AS executions13FROM windows AS w14JOIN sys.query_store_runtime_stats_interval AS i15 ON i.start_time < w.to_time AND i.end_time > w.from_time16JOIN sys.query_store_runtime_stats AS rs17 ON rs.runtime_stats_interval_id = i.runtime_stats_interval_id18JOIN sys.query_store_plan AS p ON p.plan_id = rs.plan_id19WHERE p.query_id = 12345 AND rs.execution_type = 020GROUP BY w.period, p.plan_id, p.query_plan_hash21ORDER BY w.period, executions DESC;若故障窗口开始使用另一计划,要看它占了多少执行量。只执行一次的新计划解释不了几千次请求都变慢;老计划也慢时,优先查负载、等待与数据量。计划哈希相同的多个 ID 也不要直接当成多个访问路径。
1-- 时间与 query_id 按现场替换;先比较计划再考虑回退2WITH windows AS (3 SELECT 'normal' AS period,4 CAST('2026-09-15T10:00:00+08:00' AS datetimeoffset) AS from_time,5 CAST('2026-09-15T11:00:00+08:00' AS datetimeoffset) AS to_time6 UNION ALL7 SELECT 'incident',8 CAST('2026-09-16T10:00:00+08:00' AS datetimeoffset),9 CAST('2026-09-16T11:00:00+08:00' AS datetimeoffset)10)11SELECT w.period, p.plan_id,12 SUM(rs.count_executions) AS executions,13 ROUND(SUM(rs.avg_duration * rs.count_executions)14 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)15 AS avg_duration_ms,16 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions)17 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_read_pages18FROM windows AS w19JOIN sys.query_store_runtime_stats_interval AS i20 ON i.start_time < w.to_time AND i.end_time > w.from_time21JOIN sys.query_store_runtime_stats AS rs22 ON rs.runtime_stats_interval_id = i.runtime_stats_interval_id23JOIN sys.query_store_plan AS p ON p.plan_id = rs.plan_id24WHERE p.query_id = 12345 AND rs.execution_type = 025GROUP BY w.period, p.plan_id26ORDER BY w.period, p.plan_id;新计划耗时和每次逻辑读数都明显涨,才更像访问路径回归;只涨耗时、不涨读取,则把等待与并发条件一起看。执行次数太少时不要凭均值决定强制计划,先找可重复的业务请求验证。
1-- 时间窗按现场替换;当前区间的多行等待记录先合并2SELECT ws.wait_category_desc,3 SUM(ws.total_query_wait_time_ms) AS total_wait_ms,4 COUNT(DISTINCT ws.plan_id) AS affected_plans5FROM sys.query_store_wait_stats AS ws6JOIN sys.query_store_runtime_stats_interval AS i7 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id8WHERE ws.execution_type = 09 AND i.start_time < '2026-09-16T11:00:00+08:00'10 AND i.end_time > '2026-09-16T10:00:00+08:00'11GROUP BY ws.wait_category_desc12ORDER BY total_wait_ms DESC;先看整个用户库的等待方向,再钻到单条 SQL。Lock 指向阻塞,Memory 可能指向内存授予,Buffer IO 值得查读取路径和磁盘延迟。类别是多种等待事件的归并,不等于某一条具体等待事件。
1-- Lock 类别映射到 LCK_M_%;按故障窗口替换时间2SELECT TOP (20) p.query_id, ws.plan_id,3 SUM(ws.total_query_wait_time_ms) AS lock_wait_ms,4 MAX(ws.max_query_wait_time_ms) AS max_lock_wait_ms5FROM sys.query_store_plan AS p6JOIN sys.query_store_wait_stats AS ws ON ws.plan_id = p.plan_id7JOIN sys.query_store_runtime_stats_interval AS i8 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id9WHERE ws.execution_type = 0 AND ws.wait_category_desc = 'Lock'10 AND i.start_time < '2026-09-16T11:00:00+08:00'11 AND i.end_time > '2026-09-16T10:00:00+08:00'12GROUP BY p.query_id, ws.plan_id13ORDER BY lock_wait_ms DESC;锁等待高,计划可能没有变化,真正的问题可能是长事务挡住它。Query Store 保留的是历史等待类别,不能从这里直接找出阻塞它的会话 ID;事故仍在发生时要结合当前请求和锁 DMV。
1-- Memory 类别含 RESOURCE_SEMAPHORE 等;看同一计划在哪些区间被拖住2SELECT TOP (20) p.query_id, ws.plan_id, i.start_time,3 SUM(ws.total_query_wait_time_ms) AS memory_wait_ms,4 MAX(ws.max_query_wait_time_ms) AS max_memory_wait_ms5FROM sys.query_store_plan AS p6JOIN sys.query_store_wait_stats AS ws ON ws.plan_id = p.plan_id7JOIN sys.query_store_runtime_stats_interval AS i8 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id9WHERE ws.execution_type = 0 AND ws.wait_category_desc = 'Memory'10 AND i.end_time > DATEADD(DAY, -1, SYSDATETIMEOFFSET())11GROUP BY p.query_id, ws.plan_id, i.start_time12ORDER BY memory_wait_ms DESC;Memory 类别高时,先核对该计划是否有大的 Sort、Hash 和估计行数,再看并发请求的授予压力。Query Store 这条查询只给出受影响的计划,不直接给出每次请求的授予量;不能凭类别判定服务器物理内存不足。
1-- Buffer IO 对应 PAGEIOLATCH_%;针对已锁定的 query_id 比较各计划2SELECT p.plan_id, p.query_plan_hash,3 SUM(ws.total_query_wait_time_ms) AS buffer_io_wait_ms,4 MAX(ws.max_query_wait_time_ms) AS max_buffer_io_wait_ms5FROM sys.query_store_plan AS p6JOIN sys.query_store_wait_stats AS ws ON ws.plan_id = p.plan_id7JOIN sys.query_store_runtime_stats_interval AS i8 ON i.runtime_stats_interval_id = ws.runtime_stats_interval_id9WHERE p.query_id = 12345 AND ws.execution_type = 010 AND ws.wait_category_desc = 'Buffer IO'11 AND i.end_time > DATEADD(DAY, -1, SYSDATETIMEOFFSET())12GROUP BY p.plan_id, p.query_plan_hash13ORDER BY buffer_io_wait_ms DESC;Buffer IO 高,可能是 SQL 读了更多页,也可能是底层读取变慢。先比较同一计划在正常窗口的逻辑与物理读取、文件 I/O 延迟,再考虑索引或存储调整。等待高并不自动证明“磁盘坏了”。
1-- query_id、plan_id 按现场替换;先保存计划 XML 与正常窗口统计2SELECT q.query_id, p.plan_id, q.query_hash,3 p.query_plan_hash, p.is_forced_plan,4 p.last_execution_time, p.force_failure_count5FROM sys.query_store_query AS q6JOIN sys.query_store_plan AS p ON p.query_id = q.query_id7WHERE q.query_id = 12345 AND p.plan_id = 67890;query_id 和 plan_id 不能从不同 SQL 的截图拼到一起。确认旧计划在可比负载下表现更好,再保存第 5 条的 XML、正常窗口统计和回退预案。旧计划很久未执行时,索引或表结构可能已变化,不宜直接强制。
1-- 替换 query_id;不要覆盖已有的人工或自动强制而不留记录2SELECT plan_id, plan_forcing_type_desc,3 is_forced_plan, force_failure_count,4 last_force_failure_reason_desc5FROM sys.query_store_plan6WHERE query_id = 12345 AND is_forced_plan = 1;这里若已有 MANUAL 或 AUTO 强制,先查它是谁、何时设置、是否失败。一个临时回退动作会改变后续编译选择;执行前要记录原设置,才能在验收不达标时准确恢复。
1-- SQL Server 2022;只读检查候选计划的优化强制信息2SELECT plan_id, has_compile_replay_script,3 is_optimized_plan_forcing_disabled,4 force_failure_count5FROM sys.query_store_plan6WHERE query_id = 12345 AND plan_id = 67890;SQL Server 2022 的优化计划强制可复用编译过程信息。字段值不能保证计划强制一定成功,也不能保证执行一定更快;如果后续强制出现失败或明显回归,再核对是否要禁用优化强制,而不是默认改这个选项。
1-- 改变后续编译选择;仅在已验证旧计划、记录原设置和回退窗口后执行2EXEC sys.sp_query_store_force_plan3 @query_id = 12345,4 @plan_id = 67890;这个存储过程尝试让优化器使用指定计划,但生成的实际计划可能只是相同或相近,不保证完全一致。返回成功后还要观察失败计数、实际计划和业务耗时;若强制失败,优化器会正常重新优化,不能把调用成功当成业务回退成功。
1-- 在目标用户数据库执行;与第 46 条强制前结果对照2SELECT plan_id, is_forced_plan, plan_forcing_type_desc,3 force_failure_count, last_force_failure_reason_desc,4 last_compile_start_time, last_execution_time5FROM sys.query_store_plan6WHERE query_id = 123457ORDER BY is_forced_plan DESC, last_execution_time DESC;先看候选旧计划是否标为强制、失败计数是否增加,再看变更后的执行窗口是否真的走了预期计划。Query Store 统计有刷盘和区间延迟;验收还要用业务侧耗时与当前请求取证。
1-- 修改计划控制;确认 query_id、plan_id 是本次强制记录后执行2EXEC sys.sp_query_store_unforce_plan3 @query_id = 12345,4 @plan_id = 67890;解除强制后优化器重新选择计划,不意味着自动回到变更前状态。若之前已有别的人工或自动强制,要按第 46 条留存的原设置恢复,并继续观察实际计划与耗时。不要把解除强制写成“性能已恢复”。
1-- 时间按强制完成后的窗口替换;先看候选旧计划有没有实际执行2SELECT p.plan_id, p.is_forced_plan,3 SUM(rs.count_executions) AS executions,4 ROUND(SUM(rs.avg_duration * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)6 AS avg_duration_ms,7 MAX(rs.last_execution_time) AS last_execution_time8FROM sys.query_store_plan AS p9JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id10JOIN sys.query_store_runtime_stats_interval AS i11 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id12WHERE p.query_id = 12345 AND rs.execution_type = 013 AND i.start_time < '2026-09-16T12:00:00+08:00'14 AND i.end_time > '2026-09-16T11:00:00+08:00'15GROUP BY p.plan_id, p.is_forced_plan16ORDER BY executions DESC;强制计划后要查新的执行窗口,不能拿变更前的 Query Store 平均值验收。旧计划实际执行量要足够,平均耗时才可比;强制失败计数、应用侧延迟和新旧连接都要一起看。区间边界仍可能包含变更前的一部分执行。
1-- SQL Server 2022;先保存现有 hint 文本,后续设置会覆盖它2SELECT query_hint_id, query_id, query_hint_text,3 source_desc, query_hint_failure_count,4 last_query_hint_failure_reason_desc5FROM sys.query_store_query_hints6WHERE query_id = 12345;Query Store hint 用来给 SQL 加查询选项,不是指定一个旧计划。若已存在 hint,set_hints 会把原文本替换掉;先保存内容和来源,尤其别把系统生成的 hint 当成值班人员手工设置。
1-- 改变 query_id 后续编译;只在已验证并行度是问题、留存原 hint 后执行2EXEC sys.sp_query_store_set_hints3 @query_id = 12345,4 @query_hints = N'OPTION (MAXDOP 2)';这是 SQL Server 2022 的 Query Store hint 示例。限制并行度可能减轻 CPU 或线程压力,也可能让单次查询更慢;要在可回退窗口里用同类业务请求比较。它不会固定访问路径,不能代替第 48 条的旧计划回退。
1-- 目标用户数据库;与设置前的第 52 条留存对照2SELECT query_hint_text, query_hint_failure_count,3 last_query_hint_failure_reason,4 last_query_hint_failure_reason_desc,5 source_desc6FROM sys.query_store_query_hints7WHERE query_id = 12345;文本写进目录视图,只证明 hint 已配置。若它阻止生成合法计划,SQL Server 会忽略 hint,并记下失败原因;还要在后续执行的实际计划和耗时中核对 MAXDOP 效果。
1-- 修改 query_id 的控制设置;确认原 hint 已留存并能恢复2EXEC sys.sp_query_store_clear_hints @query_id = 12345;清除会移除该 query_id 的所有 Query Store hints,不只是本次加的一项。若原来有系统或人工 hint,应根据第 52 条留存恢复原设置;随后再看实际计划和业务耗时,不能把“已清除”当成“性能已恢复”。
1SELECT (SELECT COUNT(*) FROM sys.query_store_query_text) AS text_rows,2 (SELECT COUNT(*) FROM sys.query_store_query) AS query_rows,3 (SELECT COUNT(DISTINCT query_hash)4 FROM sys.query_store_query) AS distinct_query_shapes,5 (SELECT COUNT(*) FROM sys.query_store_plan) AS plan_rows,6 (SELECT COUNT(DISTINCT query_plan_hash)7 FROM sys.query_store_plan) AS distinct_plan_shapes;文本和查询行数远大于形状数,常见于应用把字面量拼进 SQL,生成大量相似语句。这个比例只是线索,还要看第 57 条具体形状及 SQL 文本。若 Query Store 使用 AUTO 或 CUSTOM 采集模式,低频临时 SQL 可能被过滤,不能把本结果当成全库完整流量。
1SELECT TOP (20) q.query_hash,2 COUNT(*) AS query_rows,3 COUNT(DISTINCT q.query_text_id) AS distinct_texts,4 MAX(q.last_execution_time) AS last_execution_time5FROM sys.query_store_query AS q6GROUP BY q.query_hash7HAVING COUNT(DISTINCT q.query_text_id) > 18ORDER BY distinct_texts DESC, last_execution_time DESC;同一形状出现成百上千种文本时,再抽样看它们是否只差常量。若只是参数值不同,优先推动应用参数化;若 SET 选项或业务语义不同,不能简单合并。query_hash 的相等不能代替逐条语义核对。
1-- 用第 57 条的 query_hash 替换示例值;文本可能含业务参数2SELECT TOP (30) q.query_id, q.query_text_id,3 q.query_parameterization_type_desc,4 q.last_execution_time, t.query_sql_text5FROM sys.query_store_query AS q6JOIN sys.query_store_query_text AS t7 ON t.query_text_id = q.query_text_id8WHERE q.query_hash = 0x0123456789ABCDEF9ORDER BY q.last_execution_time DESC;这一条用来证实“只是字面量变了”的猜想。None、Simple、Forced 等参数化类型能帮助判断 SQL Server 当时怎么处理,但是否改应用或数据库参数化仍要看计划稳定性与业务语义。导出文本时注意敏感参数。
1-- 对当前 Query Store 历史汇总;先确认采集模式是否为 ALL2WITH execution_counts AS (3 SELECT p.query_id, SUM(rs.count_executions) AS executions4 FROM sys.query_store_plan AS p5 JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id6 GROUP BY p.query_id7)8SELECT COUNT(*) AS captured_queries,9 SUM(CASE WHEN executions = 1 THEN 1 ELSE 0 END) AS one_time_queries,10 ROUND(SUM(CASE WHEN executions = 1 THEN 1.0 ELSE 0 END)11 * 100.0 / NULLIF(COUNT(*), 0), 1) AS one_time_percent12FROM execution_counts;一次性查询很多,说明 Query Store 容量可能被临时 SQL 消耗。但 AUTO、CUSTOM 本来就可能不收低频语句,这时占比会偏低;历史清理也会改变分母。排查前先确认第 2、30 条的采集策略。
1SELECT TOP (20) q.query_hash,2 COUNT(*) AS query_rows,3 SUM(q.count_compiles) AS total_compiles,4 COUNT(DISTINCT q.query_text_id) AS distinct_texts5FROM sys.query_store_query AS q6GROUP BY q.query_hash7ORDER BY total_compiles DESC;如果同一形状既有很多文本、又反复编译,就要看是否存在字面量拼接和计划复用不足。count_compiles 是累计值,不能直接证明故障那小时发生编译风暴;要同应用发布窗口、CPU 与编译等待证据对齐。
1SELECT CASE WHEN q.object_id = 0 THEN N'临时 SQL'2 ELSE N'数据库模块' END AS query_source,3 COUNT(*) AS query_rows,4 COUNT(DISTINCT q.query_text_id) AS text_rows,5 COUNT(DISTINCT q.query_hash) AS query_shapes6FROM sys.query_store_query AS q7WHERE q.is_internal_query = 08GROUP BY CASE WHEN q.object_id = 0 THEN N'临时 SQL'9 ELSE N'数据库模块' END;object_id = 0 表示语句不属于存储过程等数据库对象。临时 SQL 数量多并不等于有问题;结合上一组的“一次性查询”比例、文本差异和实际容量,才能判断它是否占用了本该留给重要语句的历史空间。
1SELECT q.query_parameterization_type_desc,2 COUNT(*) AS query_rows,3 COUNT(DISTINCT q.query_hash) AS query_shapes,4 COUNT(DISTINCT q.query_text_id) AS distinct_texts5FROM sys.query_store_query AS q6WHERE q.object_id = 0 AND q.is_internal_query = 07GROUP BY q.query_parameterization_type_desc8ORDER BY query_rows DESC;如果 None 的文本数明显多于查询形状数,可以继续抽样核对字面量拼接;Simple 或 Forced 也不能证明计划已经稳定。这里统计的是 Query Store 采集到的查询,不能据此推算服务器上所有临时 SQL 的比例。
1WITH execution_counts AS (2 SELECT p.query_id, SUM(rs.count_executions) AS executions3 FROM sys.query_store_plan AS p4 JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id5 GROUP BY p.query_id6)7SELECT TOP (20) q.query_id, q.query_hash,8 q.count_compiles, e.executions,9 CAST(1.0 * q.count_compiles / NULLIF(e.executions, 0)10 AS decimal(10, 3)) AS compiles_per_execution,11 q.last_compile_start_time, q.last_execution_time12FROM sys.query_store_query AS q13JOIN execution_counts AS e ON e.query_id = q.query_id14WHERE q.object_id = 0 AND q.is_internal_query = 015 AND e.executions >= 1016ORDER BY compiles_per_execution DESC, q.count_compiles DESC;比值高时再看文本、执行计划缓存和应用发版记录。Query Store 的编译与执行计数是保留期内的累计数据,历史清理和采集策略会影响比较;它只能筛候选语句,不能单凭这个比值认定“每次执行都重编译”。
1SELECT TOP (20) start_time, end_time,2 runtime_stats_interval_id3FROM sys.query_store_runtime_stats_interval4ORDER BY end_time DESC;先把最后一个区间与故障时间对上。区间存在只说明曾形成统计窗口,不能证明那段时间每条业务 SQL 都被采集;结合第 1、2 条的实际状态和采集模式看。
1-- 时间按现场故障窗口替换;这里统计正常完成的执行2SELECT i.start_time, i.end_time,3 COUNT(DISTINCT p.query_id) AS queries_with_runtime,4 SUM(rs.count_executions) AS captured_executions5FROM sys.query_store_runtime_stats AS rs6JOIN sys.query_store_runtime_stats_interval AS i7 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id8JOIN sys.query_store_plan AS p ON p.plan_id = rs.plan_id9WHERE i.start_time < '2026-09-15T11:00:00+08:00'10 AND i.end_time > '2026-09-15T10:00:00+08:00'11 AND rs.execution_type = 012GROUP BY i.start_time, i.end_time13ORDER BY i.start_time;没有统计行时,先排除 Query Store 只读、采集策略过滤和 SQL 本身没有执行。运行统计有刷盘延迟,还可能有同计划、同区间的多行记录,所以按区间汇总;这里不是完整的服务器执行量。
1-- 只在 readonly_reason 命中 65536、并确认文件组空间后执行2ALTER DATABASE [YourDB]3SET QUERY_STORE (MAX_STORAGE_SIZE_MB = 2048);先保存当前 MAX_STORAGE_SIZE_MB、数据库文件组余量和清理策略。扩大上限只是给 Query Store 留出空间;数据库本身的磁盘空间不足(524288)时不能靠它解决。2048 是示例,不应原样照搬。
1SELECT desired_state_desc, actual_state_desc, readonly_reason,2 current_storage_size_mb, max_storage_size_mb,3 size_based_cleanup_mode_desc4FROM sys.database_query_store_options;期待看到 actual_state_desc = READ_WRITE,还要留意 readonly_reason 是否清除。若仍只读,按原因位继续查;不要因为 ALTER DATABASE 返回成功,就认定缺失的故障数据会自动补回来。
1-- 已抽样确认大量一次性临时 SQL、并评估低频重要语句的留存需求2ALTER DATABASE [YourDB]3SET QUERY_STORE (QUERY_CAPTURE_MODE = AUTO);AUTO 会过滤一部分低频临时 SQL,减少无用记录,但也可能让需要回看的一次性关键语句缺席。先留存旧模式、重要业务语句的 query_id 和排障需求;改完用第 2 条回读配置,再观察新的统计区间,不能拿旧记录判断新策略是否有效。
1-- 先留存当前策略与历史计划;清理可能淘汰旧查询2ALTER DATABASE [YourDB]3SET QUERY_STORE (SIZE_BASED_CLEANUP_MODE = AUTO);容量接近上限时,自动清理会优先移除较旧、成本较低的记录。它不是“保证永不只读”的开关;写入过快时清理仍可能追不上。先确认哪些旧计划还要留作回归对比,再调整策略。
1-- 14 天只是示例;先确认业务需要回溯多久2ALTER DATABASE [YourDB]3SET QUERY_STORE (CLEANUP_POLICY = (STALE_QUERY_THRESHOLD_DAYS = 14));保留期由排障习惯决定:经常要追上月发布的计划,就别设成 14 天。调整后旧记录可能被后台清理;先导出要保留的 SQL、计划与运行统计,再回读第 28 条的策略。
1-- 在目标用户数据库执行;需要数据库 ALTER 权限2EXEC sys.sp_query_store_flush_db;Query Store 的运行统计平时异步刷盘。计划切换、重启或做故障取证前,主动刷盘可以减少尚在内存中的证据丢失;它不等于备份,也不会让已经漏采的执行补进历史。
1-- 换成待检查的 query_id;先确认不是关键业务语句2SELECT q.query_id, q.query_hash, q.last_execution_time,3 q.object_id, t.query_sql_text,4 (SELECT COUNT(*) FROM sys.query_store_plan AS p5 WHERE p.query_id = q.query_id) AS captured_plans6FROM sys.query_store_query AS q7JOIN sys.query_store_query_text AS t8 ON t.query_text_id = q.query_text_id9WHERE q.query_id = 12345;不要只凭“执行次数少”就删:它可能正是要追的失败语句。保存文本、计划 XML 和故障窗口统计后,再确认这个 query_id 只有无价值的测试或临时记录。
1-- 移除该 query_id 及关联历史;需要数据库 ALTER 权限2EXEC sys.sp_query_store_remove_query @query_id = 12345;移除的是 Query Store 留存记录,不会删除业务 SQL 或应用代码。它会使该查询的旧计划和运行历史无法再用于回归对比;执行前先核对第 72 条并留存证据,不要批量删一组相似 query_hash。
1SELECT q.query_id, COUNT(p.plan_id) AS remaining_plans2FROM sys.query_store_query AS q3LEFT JOIN sys.query_store_plan AS p ON p.query_id = q.query_id4WHERE q.query_id = 123455GROUP BY q.query_id;没有返回行才表示该旧 query_id 已被移除。若业务继续执行,Query Store 可能重新捕获相同文本并分配新的 ID;清理历史不能解决应用持续生成临时 SQL 的根因。
1SELECT p.plan_id, p.is_parallel_plan,2 SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_dop * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0), 2) AS weighted_avg_dop,5 MAX(rs.max_dop) AS observed_max_dop6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8WHERE p.query_id = 12345 AND rs.execution_type = 09GROUP BY p.plan_id, p.is_parallel_plan10ORDER BY p.plan_id;计划 XML 标记并行,不代表每次运行都用了相同 DOP。若新计划并行度明显变高,连同 CPU、耗时和并行等待一起看;这里是保留期内的加权均值,比较故障前后还需按时间窗口拆开。
1SELECT p.plan_id, SUM(rs.count_executions) AS executions,2 ROUND(SUM(rs.avg_query_max_used_memory * rs.count_executions)3 / NULLIF(SUM(rs.count_executions), 0) / 128.0, 2)4 AS weighted_avg_memory_mb,5 ROUND(MAX(rs.max_query_max_used_memory) / 128.0, 2)6 AS observed_max_memory_mb7FROM sys.query_store_plan AS p8JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id9WHERE p.query_id = 12345 AND rs.execution_type = 010GROUP BY p.plan_id11ORDER BY weighted_avg_memory_mb DESC;目录里这个指标以 8 KB 页计,除以 128 才是 MB。新计划的内存指标上升时,还要查 MEMORY 类等待和实际计划的授予信息;高内存使用本身不等于内存授予不足。
1SELECT p.plan_id, SUM(rs.count_executions) AS executions,2 ROUND(SUM(rs.avg_tempdb_space_used * rs.count_executions)3 / NULLIF(SUM(rs.count_executions), 0) / 128.0, 2)4 AS weighted_avg_tempdb_mb,5 ROUND(MAX(rs.max_tempdb_space_used) / 128.0, 2)6 AS observed_max_tempdb_mb7FROM sys.query_store_plan AS p8JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id9WHERE p.query_id = 12345 AND rs.execution_type = 010GROUP BY p.plan_id11ORDER BY weighted_avg_tempdb_mb DESC;同一语句换计划后,tempdb 使用从很小变到很大,值得回看排序、哈希连接和实际计划中的溢写。这里只表示计划运行消耗的 tempdb 页数,不等于整个 tempdb 文件占用,也不能单凭它证明发生溢写。
1SELECT p.plan_id, SUM(rs.count_executions) AS executions,2 ROUND(SUM(rs.avg_rowcount * rs.count_executions)3 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_rows,4 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_read_pages6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8WHERE p.query_id = 12345 AND rs.execution_type = 09GROUP BY p.plan_id10ORDER BY avg_read_pages DESC;新计划读取更多页,先看是不是返回行数也变多了。两者同时上升时,参数或业务数据范围可能变了;返回行数接近、读取量却大幅上升,才更像访问路径出了问题。它仍是不同执行的聚合,必要时按窗口和参数再拆。
1SELECT p.plan_id, SUM(rs.count_executions) AS executions,2 ROUND(SUM(rs.avg_log_bytes_used * rs.count_executions)3 / NULLIF(SUM(rs.count_executions), 0) / 1048576.0, 3)4 AS weighted_avg_log_mb5FROM sys.query_store_plan AS p6JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id7WHERE p.query_id = 12345 AND rs.execution_type = 08GROUP BY p.plan_id9ORDER BY weighted_avg_log_mb DESC;这条更适合 UPDATE、DELETE、INSERT 等写入语句。单次日志字节量明显变大时,核对影响行数、索引维护和写入范围;如果只是执行次数涨了,要另看第 34 条。日志字节量不能代替 WRITELOG 等等待证据。
1SELECT p.plan_id, SUM(rs.count_executions) AS executions,2 ROUND(SUM(rs.avg_physical_io_reads * rs.count_executions)3 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_physical_pages,4 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions)5 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_logical_pages6FROM sys.query_store_plan AS p7JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id8WHERE p.query_id = 12345 AND rs.execution_type = 09GROUP BY p.plan_id10ORDER BY avg_physical_pages DESC;物理读取高可能和缓存冷热有关,不能直接归咎于计划;逻辑读取也一起升高,才更值得追访问路径。对比时要选接近的负载窗口,别拿重启后的冷缓存与平时的热缓存直接比。
1SELECT d.compatibility_level,2 c.name, c.value3FROM sys.databases AS d4CROSS JOIN sys.database_scoped_configurations AS c5WHERE d.database_id = DB_ID()6 AND c.name = 'PARAMETER_SENSITIVE_PLAN_OPTIMIZATION';SQL Server 2022 的 PSP 优化默认随兼容级别 160 启用,但数据库级配置也可能被关掉。这里仅核对当前设置;一条查询是否真生成了多种变体,还得看第 82、83 条。
1SELECT TOP (30) p.query_id, p.plan_id,2 p.plan_type_desc, p.query_plan_hash,3 p.last_compile_start_time, p.last_execution_time4FROM sys.query_store_plan AS p5WHERE p.plan_type_desc IN ('Dispatcher Plan', 'Query Variant Plan')6ORDER BY p.last_execution_time DESC;看到 Dispatcher Plan 和 Query Variant Plan,说明这不是一条普通查询只换了几个计划。分派计划负责按参数选择变体,本身不产生常规运行统计;直接拿父查询的 query_id 查耗时可能查少。
1-- 用业务父查询的 query_id 替换2SELECT parent_query_id, dispatcher_plan_id,3 query_variant_query_id4FROM sys.query_store_query_variant5WHERE parent_query_id = 123456ORDER BY dispatcher_plan_id, query_variant_query_id;一条父查询可以关联多个变体。先留存这组 ID,再查每个变体对应的运行计划;变体的 query_hash 与父查询共享,单靠哈希分组会把不同参数范围的成本揉在一起。
1SELECT v.parent_query_id, v.query_variant_query_id,2 p.plan_id, SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_duration * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)5 AS weighted_avg_ms6FROM sys.query_store_query_variant AS v7JOIN sys.query_store_plan AS p8 ON p.query_id = v.query_variant_query_id9JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id10WHERE v.parent_query_id = 12345 AND rs.execution_type = 011GROUP BY v.parent_query_id, v.query_variant_query_id, p.plan_id12ORDER BY weighted_avg_ms DESC;一个变体慢、另一个快时,要核对实际参数范围和返回行数,别直接断言父 SQL 整体回归。这里跨保留期汇总,确认故障发生在哪个变体后,再按第 38、39 条的办法拆时间窗口。
1SELECT v.parent_query_id,2 SUM(rs.count_executions) AS all_variant_executions,3 ROUND(SUM(rs.avg_duration * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)5 AS all_variant_avg_ms,6 ROUND(SUM(rs.avg_cpu_time * rs.count_executions)7 / 1000000.0, 2) AS all_variant_cpu_seconds8FROM sys.query_store_query_variant AS v9JOIN sys.query_store_plan AS p10 ON p.query_id = v.query_variant_query_id11JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id12WHERE v.parent_query_id = 12345 AND rs.execution_type = 013GROUP BY v.parent_query_id;分派计划通常没有运行统计,父查询总成本要把其子变体加起来。若只查父 query_id 下的计划,容易漏掉真正执行的变体;汇总后仍要分变体看,避免一个高频快变体掩盖低频慢变体。
1-- 替换变体 query_id 和故障时间;只看正常完成的执行2SELECT p.query_id AS variant_query_id, p.plan_id,3 i.start_time, i.end_time,4 SUM(rs.count_executions) AS executions,5 ROUND(SUM(rs.avg_duration * rs.count_executions)6 / NULLIF(SUM(rs.count_executions), 0) / 1000.0, 2)7 AS weighted_avg_ms8FROM sys.query_store_plan AS p9JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id10JOIN sys.query_store_runtime_stats_interval AS i11 ON i.runtime_stats_interval_id = rs.runtime_stats_interval_id12WHERE p.query_id = 6789013 AND i.start_time < '2026-09-16T11:00:00+08:00'14 AND i.end_time > '2026-09-16T10:00:00+08:00'15 AND rs.execution_type = 016GROUP BY p.query_id, p.plan_id, i.start_time, i.end_time17ORDER BY i.start_time, p.plan_id;父查询有多个变体时,先用第 83 条确认 67890 确实是目标变体。某个变体在故障窗口新编译了计划,才继续比较该变体前后的耗时与读取;不要把其他变体的计划变化当成这次故障原因。
1SELECT v.query_variant_query_id,2 SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_rowcount * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_rows,5 ROUND(SUM(rs.avg_logical_io_reads * rs.count_executions)6 / NULLIF(SUM(rs.count_executions), 0), 1) AS avg_read_pages7FROM sys.query_store_query_variant AS v8JOIN sys.query_store_plan AS p9 ON p.query_id = v.query_variant_query_id10JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id11WHERE v.parent_query_id = 12345 AND rs.execution_type = 012GROUP BY v.query_variant_query_id13ORDER BY avg_read_pages DESC;PSP 变体本来就是为了不同参数范围选不同计划,返回行数差异很大不一定是异常。更值得追的是:某个变体在相似返回行数下读取量突然增大;此时再按第 86 条拆故障窗口。
1SELECT v.query_variant_query_id,2 SUM(rs.count_executions) AS executions,3 ROUND(SUM(rs.avg_query_max_used_memory * rs.count_executions)4 / NULLIF(SUM(rs.count_executions), 0) / 128.0, 2)5 AS avg_memory_mb,6 ROUND(SUM(rs.avg_tempdb_space_used * rs.count_executions)7 / NULLIF(SUM(rs.count_executions), 0) / 128.0, 2)8 AS avg_tempdb_mb9FROM sys.query_store_query_variant AS v10JOIN sys.query_store_plan AS p11 ON p.query_id = v.query_variant_query_id12JOIN sys.query_store_runtime_stats AS rs ON rs.plan_id = p.plan_id13WHERE v.parent_query_id = 12345 AND rs.execution_type = 014GROUP BY v.query_variant_query_id15ORDER BY avg_tempdb_mb DESC;这些指标以 8 KB 页计,换算成 MB 后才便于比较。一个变体的 tempdb 使用显著高于其他变体,结合实际计划看排序、哈希算子;不能仅凭不同变体之间的绝对值判断计划好坏,它们处理的参数范围可能完全不同。
1SELECT v.query_variant_query_id,2 ws.wait_category_desc,3 SUM(ws.total_query_wait_time_ms) AS wait_ms4FROM sys.query_store_query_variant AS v5JOIN sys.query_store_plan AS p6 ON p.query_id = v.query_variant_query_id7JOIN sys.query_store_wait_stats AS ws ON ws.plan_id = p.plan_id8WHERE v.parent_query_id = 12345 AND ws.execution_type = 09GROUP BY v.query_variant_query_id, ws.wait_category_desc10ORDER BY wait_ms DESC;PSP 父查询的等待也要跟着变体查。Lock、Memory、Buffer IO 等类别指向不同排查方向;这是保留期内按类别累计的等待,执行量多的变体自然可能排前面。先核对执行次数和故障窗口,别直接把等待总量最大的变体判为最慢。
1SELECT plan_id, engine_version, compatibility_level,2 initial_compile_start_time, last_compile_start_time,3 last_execution_time, query_plan_hash4FROM sys.query_store_plan5WHERE query_id = 123456ORDER BY initial_compile_start_time;升级前后留在 Query Store 的计划可能由不同引擎版本编译。先对齐补丁安装、数据库切换和计划首次编译时间,再按故障窗口比较真正执行过的计划;版本不同只是线索,不等于升级就是性能问题的原因。
1SELECT DB_NAME() AS database_name,2 d.compatibility_level AS current_compatibility_level,3 p.plan_id, p.compatibility_level AS plan_compatibility_level,4 p.initial_compile_start_time, p.last_execution_time5FROM sys.databases AS d6JOIN sys.query_store_plan AS p ON p.query_id = 123457WHERE d.database_id = DB_ID()8ORDER BY p.initial_compile_start_time;服务器升级和数据库兼容级别变更是两件事。旧计划保留原编译时的兼容级别,新计划若级别不同,才进一步看基数估计、访问路径和耗时;不要看到 SQL Server 版本更新,就默认兼容级别也变了。
1SELECT name, value, value_for_secondary2FROM sys.database_scoped_configurations3WHERE name IN ('LEGACY_CARDINALITY_ESTIMATION',4 'PARAMETER_SNIFFING', 'MAXDOP',5 'PARAMETER_SENSITIVE_PLAN_OPTIMIZATION')6ORDER BY name;兼容级别相同,数据库级设置仍可能使新编译的计划与旧计划不同。把当前值与变更记录对上;这些设置影响整个数据库,不能为了救一条 SQL 就直接全库改回去。优先确认业务语句、参数范围和计划证据。
1SELECT name, desired_state_desc, actual_state_desc,2 reason_desc3FROM sys.database_automatic_tuning_options4WHERE name = 'FORCE_LAST_GOOD_PLAN';期望状态和实际状态可能不同。QUERY_STORE_READ_ONLY、版本或版本授权限制,都可能使自动修正没有实际运行;不要只看数据库里曾有自动强制计划,就认为当前仍在自动修正。
1SELECT name, type, score, reason,2 JSON_VALUE(state, '$.currentValue') AS current_state,3 JSON_VALUE(state, '$.reason') AS state_reason,4 valid_since, last_refresh5FROM sys.dm_db_tuning_recommendations6WHERE type = 'FORCE_LAST_GOOD_PLAN'7ORDER BY last_refresh DESC;Active 是尚未应用,Verifying 是正在验证,Reverted 表示修正后来被撤回。建议来自引擎检测,不是最终处置意见;回到 Query Store 核对故障时间、计划执行量和实际业务耗时。
1SELECT name, score,2 TRY_CONVERT(bigint, JSON_VALUE(details,3 '$.planForceDetails.queryId')) AS query_id,4 TRY_CONVERT(bigint, JSON_VALUE(details,5 '$.planForceDetails.regressedPlanId')) AS regressed_plan_id,6 TRY_CONVERT(bigint, JSON_VALUE(details,7 '$.planForceDetails.recommendedPlanId')) AS recommended_plan_id8FROM sys.dm_db_tuning_recommendations9WHERE type = 'FORCE_LAST_GOOD_PLAN';这些 ID 可接着查第 4、14、15 条。建议里估算的收益是在发现回归时计算的,不等于当前业务收益;即便建议状态为 Success,也要验证新窗口中的执行量、错误和延迟。
1SELECT p.query_id, p.plan_id,2 p.is_forced_plan, p.plan_forcing_type_desc,3 p.force_failure_count, p.last_force_failure_reason_desc,4 p.last_execution_time5FROM sys.query_store_plan AS p6WHERE p.plan_forcing_type_desc = 'AUTO'7 AND (p.force_failure_count > 0 OR p.is_forced_plan = 1)8ORDER BY p.force_failure_count DESC, p.last_execution_time DESC;自动强制并不是永久有效。发现失败原因后,对照对象变更、索引和计划 XML;若人工也强制了同一查询的其他计划,先厘清谁在控制计划选择,不要叠加操作。
1SELECT sqlserver_start_time2FROM sys.dm_os_sys_info;sys.dm_db_tuning_recommendations 的内容只留在内存里,实例重启后不保留。事故后查不到建议,先核对启动时间,再看 Query Store 留下的计划和运行记录;空结果不能证明系统从未生成过回归建议。
1-- 仅在 actual_state_desc = ERROR,且已留存故障现场后执行2EXEC sys.sp_query_store_consistency_check;SQL Server 2017 起可用这一步恢复内部错误状态。先确认第 1 条的实际状态确实是 ERROR,别把容量导致的 READ_ONLY 当成内部损坏。若检查失败,需要进一步排障;清空 Query Store 会抹掉计划历史,不能当成日常修复命令。
1-- 一致性检查成功、且数据库空间与容量原因已排除后执行2ALTER DATABASE [YourDB]3SET QUERY_STORE (OPERATION_MODE = READ_WRITE);这条改变的是期望状态,不保证实际状态已经恢复。若仍只读或报错,继续查状态与原因;此前漏掉的运行数据不会自动补齐。
1SELECT o.desired_state_desc, o.actual_state_desc,2 o.readonly_reason, o.query_capture_mode_desc,3 o.current_storage_size_mb, o.max_storage_size_mb,4 (SELECT MAX(last_execution_time)5 FROM sys.query_store_query) AS latest_captured_execution6FROM sys.database_query_store_options AS o;actual_state_desc = READ_WRITE 是第一步;还要在业务继续执行后,看最近采集时间有没有推进。AUTO、CUSTOM 模式下,某条低频语句仍可能不被收录;最后用目标 SQL 的 query_id、计划和新窗口耗时确认排查或处置结果。
查性能回归,先确认 Query Store 有没有在采集,再用故障时间圈出执行过的计划。平均耗时变高时,顺手比 CPU、读取、返回行数和等待;这些读数一起变,才比较容易判断是计划、参数还是负载的问题。强制旧计划后继续看新窗口,不要把“强制成功”当成业务已经恢复。
 DBA100 系列海报
SQL Server 的其他运维命令也整理在 ORA100 · DBA100:
微信里搜索小程序 「三笠的百令册」,需要时按专题查。