performance30 分钟阅读
SQL Server tempdb 与行版本存储排查 100 条命令
tempdb 空间告警不能只问“哪个 SQL 用了临时表”。排序、哈希、临时对象、行版本都可能占空间;如果用户库启用了 ADR,持久化行版本又放在用户库本身。先把空间分成几类,才能判断该追会话、执行计划,还是长时间不结束的快照事务。
2026年9月16日阅读—点赞—收藏—
dba100sqlserverscenario
100 条命令系列文章专栏
tempdb 空间告警不能只问“哪个 SQL 用了临时表”。排序、哈希、临时对象、行版本都可能占空间;如果用户库启用了 ADR,持久化行版本又放在用户库本身。先把空间分成几类,才能判断该追会话、执行计划,还是长时间不结束的快照事务。
tempdb 空间告警不能只问“哪个 SQL 用了临时表”。排序、哈希、临时对象、行版本都可能占空间;如果用户库启用了 ADR,持久化行版本又放在用户库本身。先把空间分成几类,才能判断该追会话、执行计划,还是长时间不结束的快照事务。
这篇从文件和空间分类开始,逐步查会话占用与版本存储。故障时可以直接按对象类型翻查;建议收藏,排查时也方便和开发同事对照事务用法。
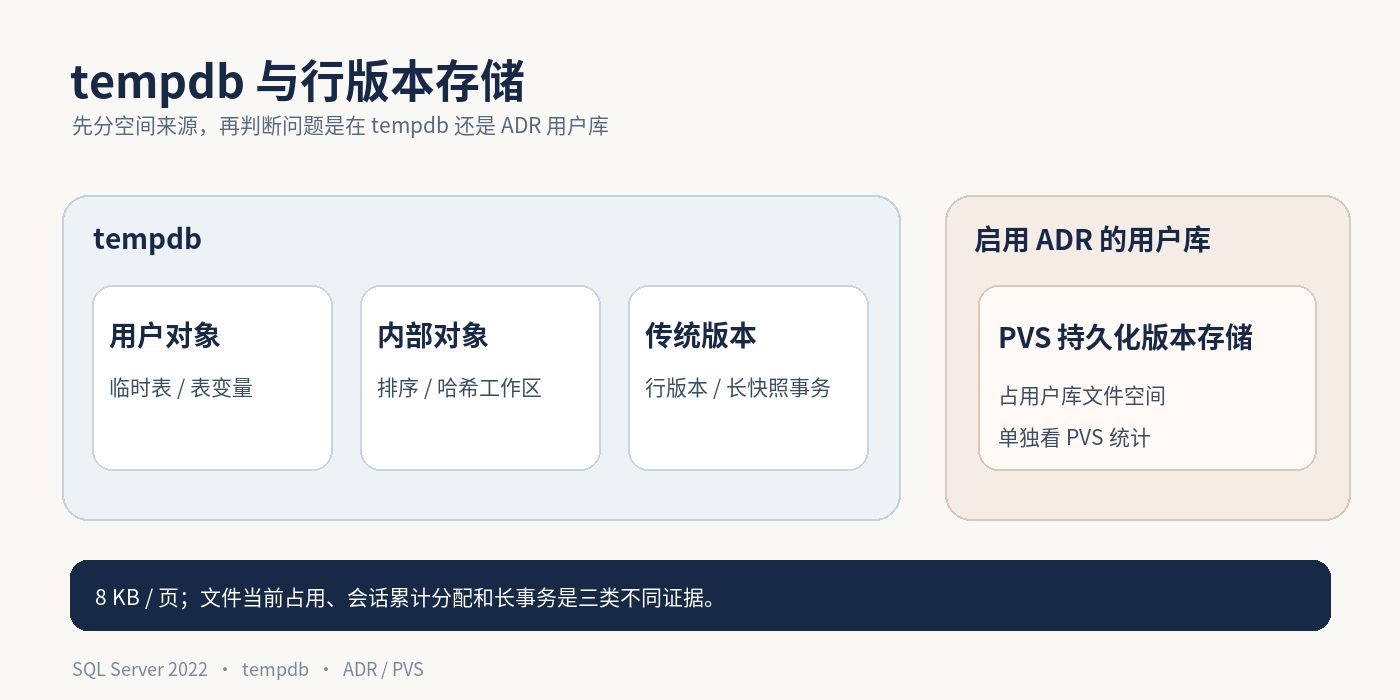 SQL Server tempdb 与版本存储分布示意图
示例采用 SQL Server 2022。页数换算:一页 8 KB,128 页约 1 MB。DMV 是现场截面;当前空间、累计分配量和已释放量不能混为一谈。
1SELECT name, type_desc, size * 8.0 / 1024 AS size_mb,2 growth, is_percent_growth, physical_name3FROM tempdb.sys.database_files;文件大小是已分配给文件的空间,不等于正在使用量。先核对文件数量、路径和增长设置,再看实际页分布。
1USE tempdb;2SELECT file_id,3 total_page_count / 128.0 AS total_mb,4 unallocated_extent_page_count / 128.0 AS free_mb,5 user_object_reserved_page_count / 128.0 AS user_object_mb,6 internal_object_reserved_page_count / 128.0 AS internal_object_mb,7 version_store_reserved_page_count / 128.0 AS version_store_mb8FROM sys.dm_db_file_space_usage;这张视图在 tempdb 上看分文件占用。user_object 常见于临时表,internal_object 常见于排序、哈希等内部工作区;版本存储另列。三个数不是文件大小的完整拆分,别机械相加求“已用”。
1SELECT DB_NAME(database_id) AS database_name,2 reserved_space_kb / 1024.0 AS version_store_mb3FROM sys.dm_tran_version_store_space_usage4ORDER BY reserved_space_kb DESC;这是传统 tempdb 行版本的按库汇总。某个用户库占用高,下一步才去看该库的隔离设置和长事务;ADR 的 PVS 另存于用户库,不要从这里寻找它。
1SELECT name, is_read_committed_snapshot_on,2 snapshot_isolation_state_desc,3 is_accelerated_database_recovery_on4FROM sys.databases5WHERE database_id > 4;RCSI、快照隔离与 ADR 影响行版本的生成和存放位置。ADR 启用时,还需要看用户库内的持久化版本存储;配置为开并不代表当前一定有大量占用。
1SELECT DB_NAME(database_id) AS database_name,2 persistent_version_store_size_kb / 1024.0 AS pvs_mb3FROM sys.dm_tran_persistent_version_store_stats4ORDER BY persistent_version_store_size_kb DESC;PVS 放在启用 ADR 的数据库里,不算进第 3 条的传统 tempdb 版本存储。这个字段只统计页外版本,不含数据页内的版本;若用户库数据文件增长而 tempdb 的版本存储不高,要把 ADR 状态和这条一起看。
1SELECT TOP (20) session_id,2 user_objects_alloc_page_count / 128.0 AS user_alloc_mb,3 user_objects_dealloc_page_count / 128.0 AS user_dealloc_mb,4 internal_objects_alloc_page_count / 128.0 AS internal_alloc_mb,5 internal_objects_dealloc_page_count / 128.0 AS internal_dealloc_mb6FROM sys.dm_db_session_space_usage7WHERE database_id = 28ORDER BY internal_objects_alloc_page_count DESC;这些是会话累计分配和释放计数,不能单看 alloc 就断言目前仍占这么多。还要结合第 2 条的当前文件占用、任务级占用和会话活动。
1SELECT TOP (20) s.session_id, s.login_name,2 s.host_name, s.program_name,3 u.internal_objects_alloc_page_count,4 u.internal_objects_dealloc_page_count5FROM sys.dm_db_session_space_usage AS u6JOIN sys.dm_exec_sessions AS s7 ON s.session_id = u.session_id8WHERE u.database_id = 29ORDER BY u.internal_objects_alloc_page_count DESC;这是会话维度的线索。一个连接可能反复执行许多 SQL;要定位具体正在跑的请求,再看执行计划中的排序、哈希或溢出。
1SELECT session_id, transaction_id,2 is_snapshot, elapsed_time_seconds,3 transaction_sequence_num,4 max_version_chain_traversed5FROM sys.dm_tran_active_snapshot_database_transactions6WHERE elapsed_time_seconds > 3007ORDER BY elapsed_time_seconds DESC;这里的耗时从事务取得序列号开始算。长快照事务可能影响旧版本清理,但它是否导致本次空间增长还要和第 3、5 条的版本存储趋势对齐。
1SELECT a.session_id, a.elapsed_time_seconds,2 s.login_name, s.host_name,3 s.program_name, s.status,4 s.open_transaction_count5FROM sys.dm_tran_active_snapshot_database_transactions AS a6LEFT JOIN sys.dm_exec_sessions AS s7 ON s.session_id = a.session_id8WHERE a.elapsed_time_seconds > 3009ORDER BY a.elapsed_time_seconds DESC;把会话归到具体应用或作业。空闲连接仍可能有未结束事务;先核对业务提交点,不能仅凭版本存储高就结束它。
1SELECT name, size * 8.0 / 1024 AS size_mb,2 CASE WHEN is_percent_growth = 1 THEN 'percent'3 ELSE 'pages' END AS growth_unit,4 growth, max_size5FROM tempdb.sys.database_files6WHERE type_desc = 'ROWS';增长单位必须结合 is_percent_growth 解释,growth 不能直接当 MB。空间排查要同时看磁盘剩余量和文件已用页,不能把加大自动增长当成清理方案。
1SELECT TOP (20) session_id, request_id,2 SUM(internal_objects_alloc_page_count) / 128.03 AS internal_alloc_mb,4 SUM(internal_objects_dealloc_page_count) / 128.05 AS internal_dealloc_mb6FROM sys.dm_db_task_space_usage7WHERE database_id = 28GROUP BY session_id, request_id9ORDER BY internal_alloc_mb DESC;并行计划的一次请求可能有多个任务,先按 session_id + request_id 汇总,别把每个执行线程误当成不同 SQL。这里仍是任务分配/释放计数,不是文件当前占用;第 2 条的实际页数要一起看。
1SELECT TOP (20) session_id, request_id,2 exec_context_id,3 (internal_objects_alloc_page_count4 - internal_objects_dealloc_page_count) / 128.05 AS internal_net_mb,6 (user_objects_alloc_page_count7 - user_objects_dealloc_page_count) / 128.08 AS user_net_mb9FROM sys.dm_db_task_space_usage10WHERE database_id = 211ORDER BY internal_net_mb DESC;净分配高的任务值得追到请求和计划,但负值或零值也可能是分配已转移到会话统计、任务已经结束。不能把这里的 internal_net_mb 与第 11 条累计分配、或第 2 条文件占用机械对账。
1SELECT TOP (20) r.session_id, r.request_id,2 r.status, r.command,3 r.total_elapsed_time / 1000.0 AS elapsed_seconds,4 SUM(t.internal_objects_alloc_page_count5 - t.internal_objects_dealloc_page_count) / 128.06 AS internal_net_mb7FROM sys.dm_exec_requests AS r8JOIN sys.dm_db_task_space_usage AS t9 ON t.session_id = r.session_id10 AND t.request_id = r.request_id11 AND t.database_id = 212GROUP BY r.session_id, r.request_id,13 r.status, r.command, r.total_elapsed_time14ORDER BY internal_net_mb DESC;先锁定仍在跑的请求,再看它是排序、哈希、索引维护还是其他操作。sys.dm_exec_requests 没有已结束的任务;如果高分配任务刚好结束,这条可能查不到,回到第 6 条看会话累计并结合 Query Store、作业记录找历史 SQL。
1SELECT TOP (20) r.session_id, r.request_id,2 x.internal_net_mb, st.text AS sql_text3FROM sys.dm_exec_requests AS r4CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS st5CROSS APPLY (6 SELECT SUM(t.internal_objects_alloc_page_count7 - t.internal_objects_dealloc_page_count) / 128.08 AS internal_net_mb9 FROM sys.dm_db_task_space_usage AS t10 WHERE t.database_id = 211 AND t.session_id = r.session_id12 AND t.request_id = r.request_id13) AS x14WHERE x.internal_net_mb > 015ORDER BY x.internal_net_mb DESC;这给出请求所属批次的 SQL 文本;一个批次可能有多条语句,不能见到 text 就认定每一句都导致 tempdb 增长。按请求的语句偏移截取当前语句,必要时再看计划里的 Sort、Hash 或 Spill 线索。权限不足时也可能看不到其他会话文本。
1SELECT TOP (10) r.session_id, r.request_id,2 t.internal_objects_alloc_page_count / 128.03 AS internal_alloc_mb,4 qp.query_plan5FROM sys.dm_exec_requests AS r6JOIN sys.dm_db_task_space_usage AS t7 ON t.session_id = r.session_id8 AND t.request_id = r.request_id9 AND t.database_id = 210CROSS APPLY sys.dm_exec_query_plan(r.plan_handle) AS qp11ORDER BY t.internal_objects_alloc_page_count DESC;计划帮助判断大额内部对象分配是否来自排序、哈希连接、窗口计算等操作。并行请求会有多条任务记录,因此同一计划可能重复出现;先按第 11 条汇总,再打开一个代表性计划。当前估计计划不保证显示已经发生的 Spill,实际执行信息还要另查。
1SELECT session_id, request_id,2 requested_memory_kb, granted_memory_kb,3 wait_time_ms, grant_time4FROM sys.dm_exec_query_memory_grants5WHERE grant_time IS NULL6ORDER BY wait_time_ms DESC;查询在等内存授予时,未必已经大量写 tempdb;这条主要排除“只有磁盘空间问题”的单一判断。内存不足、低估行数和并发过高都可能与 Sort/Hash Spill 一起出现。要把具体请求与第 13 条、计划和等待类型对上。
1SELECT TOP (20) session_id, request_id,2 requested_memory_kb, granted_memory_kb,3 used_memory_kb, max_used_memory_kb,4 grant_time5FROM sys.dm_exec_query_memory_grants6WHERE grant_time IS NOT NULL7ORDER BY granted_memory_kb DESC;授予量大不等于 tempdb 一定大;它也可能挤压其他请求的可用内存。实际使用远低于授予量,或授予不足而计划产生 Spill,是不同方向的问题。需要对照当前请求计划与用户库统计,不能拿单次 used_memory_kb 直接下调整授予的结论。
1USE tempdb;2SELECT total_log_size_in_bytes / 1024.0 / 10243 AS total_log_mb,4 used_log_space_in_bytes / 1024.0 / 10245 AS used_log_mb,6 used_log_space_in_percent7FROM sys.dm_db_log_space_usage;数据文件和日志文件分别增长。第 2 条看数据页;这里看日志占用,避免把 tempdb “磁盘满”全算到内部对象或版本存储头上。日志值是当前数据库所有日志文件的汇总,不能按日志文件逐个拆分。
1SELECT TOP (20) transaction_id,2 database_transaction_begin_time,3 database_transaction_state,4 database_transaction_log_bytes_used / 1024.0 / 10245 AS log_used_mb6FROM sys.dm_tran_database_transactions7WHERE database_id = 28ORDER BY database_transaction_log_bytes_used DESC;日志使用量高时,先找正在运行、尚未结束的事务;临时表批量写入和索引维护都可能在 tempdb 产生日志。这个 DMV 看事务的数据库维度,transaction_id 需要映射到会话,才能找到应用或作业。不能只靠事务已用字节预测文件还能多久填满。
1SELECT TOP (20) st.session_id,2 dt.transaction_id,3 dt.database_transaction_log_bytes_used / 1024.0 / 10244 AS log_used_mb,5 s.login_name, s.host_name,6 s.program_name, s.status7FROM sys.dm_tran_database_transactions AS dt8JOIN sys.dm_tran_session_transactions AS st9 ON st.transaction_id = dt.transaction_id10LEFT JOIN sys.dm_exec_sessions AS s11 ON s.session_id = st.session_id12WHERE dt.database_id = 213ORDER BY dt.database_transaction_log_bytes_used DESC;一个事务可涉及多个数据库,也可能有多个会话关联;输出按映射关系看,别把重复的日志字节再加总一遍。确认会话所属作业和提交边界后,再讨论能否结束事务;直接重启 SQL Server 或收缩日志都不是默认处理。
1SELECT session_id, request_id,2 wait_type, wait_time,3 wait_resource, command4FROM sys.dm_exec_requests5WHERE wait_type LIKE 'PAGELATCH%'6 AND wait_resource LIKE '2:%'7ORDER BY wait_time DESC;2:file:page 的第一段是 tempdb 数据库 ID。PAGELATCH 是内存页闩锁,不是磁盘 I/O 等待;看热点页前先确认请求确实在 tempdb 等,不能用全实例 PAGELATCH 总量直接判 tempdb 故障。请求很快变化,最好连取几份快照。
1SELECT wait_resource,2 wait_type, COUNT(*) AS waiting_requests,3 MAX(wait_time) AS longest_wait_ms4FROM sys.dm_exec_requests5WHERE wait_type LIKE 'PAGELATCH%'6 AND wait_resource LIKE '2:%'7GROUP BY wait_resource, wait_type8ORDER BY waiting_requests DESC,9 longest_wait_ms DESC;多个请求持续等同一页,再解码该页是 PFS/GAM/SGAM 分配页还是普通数据页。若每次快照热点都换页,先别按某一个页号制定方案;wait_time 是当前等待毫秒数,不是请求累计总耗时。
1-- 第 22 条得到 2:1:1 时:file_id=1,page_id=12SELECT page_type_desc, object_id,3 pfs_status_desc4FROM sys.dm_db_page_info(2, 1, 1, 'DETAILED');SQL Server 2019 起可用 sys.dm_db_page_info。把文件号、页号换成现场等待资源;别把 2:1:1 当成永远的热点。分配页争用与 tempdb 元数据页争用处理方向不同,普通数据页也可能有闩锁;先看类型,再看同页等待是否反复出现。
1SELECT SERVERPROPERTY('IsTempDbMetadataMemoryOptimized')2 AS tempdb_metadata_memory_optimized;返回 1 表示 tempdb 系统对象元数据使用内存优化,0 表示未启用。它针对元数据争用,不会自动消除 PFS/GAM 等分配页争用,也不会给磁盘扩容。若第 23 条热点页是元数据页,再看此配置与版本;改变配置需要单独评估和维护安排。
1SELECT wait_type, waiting_tasks_count,2 wait_time_ms, max_wait_time_ms3FROM sys.dm_os_wait_stats4WHERE wait_type LIKE 'PAGELATCH%'5ORDER BY wait_time_ms DESC;这是全实例、累计计数。它适合用两次取样的差值看争用是否在增长,却无法告诉你热点页属于哪座数据库。判断 tempdb 要回到第 21—23 条的当前资源页;统计被重置时也不能和重置前直接相减。
1SELECT f.file_id, d.name,2 f.num_of_reads, f.num_of_writes,3 f.num_of_bytes_read / 1024.0 / 10244 AS read_mb,5 f.num_of_bytes_written / 1024.0 / 10246 AS written_mb7FROM sys.dm_io_virtual_file_stats(2, NULL) AS f8JOIN tempdb.sys.database_files AS d9 ON d.file_id = f.file_id10ORDER BY f.num_of_bytes_written DESC;这一组是从实例启动以来的文件 I/O 计数,不能把写入总量大的文件直接叫作“当前磁盘瓶颈”。记下两个时间点,再算每秒读写量;数据文件与日志文件要分开比较。文件分配不均也要对照第 28 条已用页。
1SELECT d.name, d.type_desc,2 f.num_of_reads, f.num_of_writes,3 f.io_stall_read_ms / NULLIF(f.num_of_reads, 0)4 AS avg_read_ms,5 f.io_stall_write_ms / NULLIF(f.num_of_writes, 0)6 AS avg_write_ms7FROM sys.dm_io_virtual_file_stats(2, NULL) AS f8JOIN tempdb.sys.database_files AS d9 ON d.file_id = f.file_id10ORDER BY avg_write_ms DESC;读写等待高可能是存储压力,和第 21 条页闩锁是不同层面。这里的平均值跨实例运行期;单次高峰需要两份快照计算区间等待/次数,不能拿生命周期平均值否定刚发生的 I/O 故障。
1USE tempdb;2SELECT file_id,3 total_page_count / 128.0 AS total_mb,4 (total_page_count - unallocated_extent_page_count)5 / 128.0 AS allocated_mb,6 unallocated_extent_page_count / 128.0 AS free_mb7FROM sys.dm_db_file_space_usage8ORDER BY allocated_mb DESC;第 2 条拆了用户对象、内部对象和版本存储;这一条先比较文件之间的已分配量与空闲量。多个数据文件若尺寸差很多或已用量明显不均,自动增长行为也要一起看;allocated_mb 仍不是 SQL Server 进程对文件系统的精确实时写入速率。
1SELECT d.name, d.physical_name,2 v.volume_mount_point,3 v.total_bytes / 1024.0 / 1024 / 10244 AS volume_total_gb,5 v.available_bytes / 1024.0 / 1024 / 10246 AS volume_free_gb7FROM tempdb.sys.database_files AS d8CROSS APPLY sys.dm_os_volume_stats(2, d.file_id) AS v9ORDER BY volume_free_gb;文件内部有空闲页,不等于卷上还有增长空间;反过来卷空间够,也不表示文件目前没有分配页闩锁争用。多个文件在同一卷上时,volume_free_gb 会重复显示,不能按行求和当全机空闲容量。
1SELECT d.name, d.size * 8.0 / 10242 AS current_size_mb,3 d.growth, d.is_percent_growth,4 d.max_size,5 v.available_bytes / 1024.0 / 10246 AS volume_free_mb7FROM tempdb.sys.database_files AS d8CROSS APPLY sys.dm_os_volume_stats(2, d.file_id) AS v9WHERE d.type_desc = 'ROWS'10ORDER BY volume_free_mb;第 10 条看增长设置,第 29 条看卷空闲;这里把两者对在同一份快照里。growth 按页数还是百分比,要看 is_percent_growth;max_size 是文件上限,不是卷容量。紧急扩容前还要估算同卷其他文件增长,不能只给 tempdb 改一个更大的自动增长值。
1SELECT d.name AS database_name,2 COALESCE(v.reserved_space_kb, 0) / 1024.03 AS tempdb_version_mb,4 COALESCE(p.persistent_version_store_size_kb, 0)5 / 1024.0 AS pvs_off_row_mb,6 d.is_accelerated_database_recovery_on7FROM sys.databases AS d8LEFT JOIN sys.dm_tran_version_store_space_usage AS v9 ON v.database_id = d.database_id10LEFT JOIN sys.dm_tran_persistent_version_store_stats AS p11 ON p.database_id = d.database_id12WHERE d.database_id > 413ORDER BY tempdb_version_mb DESC,14 pvs_off_row_mb DESC;第 3、5 条分别查两套版本存储;这条把它们并列,避免看到用户库 PVS 增长却去收缩 tempdb。PVS 字段只统计页外版本,两列不能简单相加当成“数据库所有旧版本总量”。先找到真正增长的库,再看事务和清理边界。
1-- 版本存储很大时此 DMV 扫描代价高;先评估运行窗口2SELECT TOP (20) DB_NAME(database_id)3 AS database_name,4 rowset_id,5 aggregated_record_length_in_bytes6FROM sys.dm_tran_top_version_generators7ORDER BY aggregated_record_length_in_bytes DESC;它按数据库和 rowset 汇总版本记录长度,可用来缩小生成对象范围,但会读取版本存储,微软文档明确提示大版本存储上执行效率低。不适合每分钟巡检,更不能把输出字节数直接当用户表当前占用;只有第 31 条确认传统存储异常且排障窗口允许时才运行。
1SELECT DB_NAME(dt.database_id) AS database_name,2 COUNT(DISTINCT a.transaction_id)3 AS snapshot_transactions,4 MAX(a.elapsed_time_seconds)5 AS longest_seconds6FROM sys.dm_tran_active_snapshot_database_transactions AS a7JOIN sys.dm_tran_database_transactions AS dt8 ON dt.transaction_id = a.transaction_id9WHERE dt.database_id > 410GROUP BY dt.database_id11ORDER BY longest_seconds DESC;第 8 条列每笔快照事务;这里先看哪个用户库的事务多、最老事务持续多久。一笔事务可能涉及多个数据库,所以跨库汇总后不能把各库计数求和当实例唯一事务数。长事务是否挡住版本清理,还要看版本存储趋势。
1SELECT TOP (20) a.session_id,2 a.elapsed_time_seconds,3 r.status, r.command,4 st.text AS current_batch5FROM sys.dm_tran_active_snapshot_database_transactions AS a6LEFT JOIN sys.dm_exec_requests AS r7 ON r.session_id = a.session_id8OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS st9WHERE a.elapsed_time_seconds > 30010ORDER BY a.elapsed_time_seconds DESC;会话当前若是 Sleep,请求和 SQL 文本可为空,却仍可能保持旧快照。先用第 9 条确认应用与事务状态,再找它为何不提交;一条当前批次文本不能还原这笔事务过去全部语句,别据此随意结束连接。
1SELECT TOP (20) session_id,2 transaction_id,3 elapsed_time_seconds,4 max_version_chain_traversed5FROM sys.dm_tran_active_snapshot_database_transactions6WHERE max_version_chain_traversed > 07ORDER BY max_version_chain_traversed DESC;版本链遍历深,说明该事务读到旧版本的成本可能增加;它不是整个 tempdb 版本存储的大小,也不直接指出哪张表生成了版本。配合第 31、33 条确认数据库和持续时间,再去看业务 SQL 与更新热点。
1SELECT DB_NAME(database_id) AS database_name,2 persistent_version_store_size_kb / 1024.03 AS pvs_off_row_mb,4 oldest_active_transaction_id5FROM sys.dm_tran_persistent_version_store_stats6ORDER BY persistent_version_store_size_kb DESC;PVS 空间在用户库里;oldest_active_transaction_id 给出 ADR 清理边界线索。不能见到 PVS 大就直接认定最老事务是唯一原因;先看数据库文件增长、事务状态和后续取样。第 5 条的页外统计限制在这里仍适用。
1SELECT DB_NAME(database_id) AS database_name,2 current_aborted_transaction_count,3 oldest_aborted_transaction_id,4 persistent_version_store_size_kb / 1024.05 AS pvs_off_row_mb6FROM sys.dm_tran_persistent_version_store_stats7WHERE current_aborted_transaction_count > 08ORDER BY current_aborted_transaction_count DESC;ADR 通过版本存储支持快速回滚,已中止事务的版本也可能等待后台清理。数量高时看 PVS 大小是否持续增长以及清理是否推进;这个计数不是待回滚业务请求数,不能据此直接重启实例或关闭 ADR。
1SELECT DB_NAME(p.database_id) AS database_name,2 p.oldest_active_transaction_id,3 st.session_id,4 s.login_name, s.host_name,5 s.program_name, s.status6FROM sys.dm_tran_persistent_version_store_stats AS p7LEFT JOIN sys.dm_tran_session_transactions AS st8 ON st.transaction_id = p.oldest_active_transaction_id9LEFT JOIN sys.dm_exec_sessions AS s10 ON s.session_id = st.session_id11WHERE p.oldest_active_transaction_id IS NOT NULL;映射到了会话,先找应用事务的提交点;没有映射可能是事务状态变了,也可能最老边界并非当前用户会话。session_id 为空不能证明 PVS 清理健康。连同第 36 条大小和第 9 条快照事务一起留时间戳快照。
1SELECT SYSDATETIME() AS sampled_at,2 DB_NAME(database_id) AS database_name,3 persistent_version_store_size_kb / 1024.04 AS pvs_off_row_mb,5 oldest_active_transaction_id,6 current_aborted_transaction_count7FROM sys.dm_tran_persistent_version_store_stats8WHERE database_id = DB_ID('appdb');连续保存两到三份,才能看 PVS 是否正在增长、清理边界是否推进。一次“大”或“小”都不能说明清理速度;若版本生成速率同时很高,空间暂时不降也不等于清理停了。库名换现场值,并留意 DMV 计数重置。
1USE tempdb;2SELECT file_id,3 version_store_reserved_page_count / 128.04 AS version_store_mb,5 total_page_count / 128.0 AS file_mb,6 100.0 * version_store_reserved_page_count7 / NULLIF(total_page_count, 0)8 AS version_store_pct9FROM sys.dm_db_file_space_usage10ORDER BY version_store_mb DESC;第 31 条按来源数据库看传统版本量,这条看它在 tempdb 数据文件里的分布。PVS 不在这些文件中;文件之间占比不均时还要看文件大小、增长记录和其他对象占用,不能只因某文件百分比高就收缩它。
1USE tempdb;2SELECT TOP (30) t.object_id, t.name,3 t.create_date,4 SUM(p.reserved_page_count) / 128.05 AS reserved_mb,6 SUM(p.used_page_count) / 128.07 AS used_mb8FROM sys.tables AS t9JOIN sys.dm_db_partition_stats AS p10 ON p.object_id = t.object_id11GROUP BY t.object_id, t.name, t.create_date12ORDER BY reserved_mb DESC;第 2 条的 user_object 很高时,这里找可见的临时表对象。临时表可能创建后自动删除,列表也会变化;内部排序/哈希工作表不一定作为普通 sys.tables 行出现。因此这不是 tempdb 所有用户/内部空间的完整账本。
1USE tempdb;2SELECT TOP (20) t.name, t.create_date,3 SUM(p.reserved_page_count) / 128.04 AS reserved_mb5FROM sys.tables AS t6JOIN sys.dm_db_partition_stats AS p7 ON p.object_id = t.object_id8WHERE t.name LIKE '##%'9GROUP BY t.name, t.create_date10ORDER BY reserved_mb DESC;全局临时表以 ## 开头,可被多个会话访问;它的生命周期与本地 # 表不同。看到空间高,要查哪个作业创建它、是否仍有会话引用。名字本身不证明哪个连接正在占用,不能按名字随手 DROP 线上共用对象。
1USE tempdb;2SELECT TOP (30) t.name AS temp_table,3 i.name AS index_name, i.index_id,4 SUM(p.reserved_page_count) / 128.05 AS reserved_mb,6 SUM(p.used_page_count) / 128.07 AS used_mb8FROM sys.tables AS t9JOIN sys.indexes AS i ON i.object_id = t.object_id10JOIN sys.dm_db_partition_stats AS p11 ON p.object_id = i.object_id12 AND p.index_id = i.index_id13WHERE t.name LIKE '#%'14GROUP BY t.name, i.name, i.index_id15ORDER BY reserved_mb DESC;一个临时表的索引可能比数据更占空间,尤其是批量加载后又建多个辅助索引。index_id=0/1 是 heap/聚集索引,不能把它们一律算“额外索引成本”。先理解临时表用于哪段 SQL,再讨论删索引或改流程。
1USE tempdb;2SELECT TOP (30) t.object_id, t.name,3 SUM(CASE WHEN p.index_id IN (0, 1)4 THEN p.row_count ELSE 0 END)5 AS table_rows,6 SUM(p.reserved_page_count) / 128.07 AS reserved_mb8FROM sys.tables AS t9JOIN sys.dm_db_partition_stats AS p10 ON p.object_id = t.object_id11WHERE t.name LIKE '#%'12GROUP BY t.object_id, t.name13ORDER BY reserved_mb DESC;记录数主要从 heap/聚集索引取,避免非聚集索引把行数重复加上。保留页则跨表的索引一起算;“行数不多、空间很大”可能来自宽列、LOB 或索引。row_count 是 DMV 统计,不是严格实时 COUNT(*)。
1USE tempdb;2SELECT TOP (30) name, object_id,3 create_date,4 DATEDIFF(MINUTE, create_date, SYSDATETIME())5 AS age_minutes6FROM sys.tables7WHERE name LIKE '#%'8 AND name NOT LIKE '##%'9ORDER BY create_date;本地临时表的内部名称带系统后缀,可以同时存在同名业务临时表的多个实例;不能从 name 后缀直接猜会话 ID。旧对象只是调查线索,可能是正常长作业。先找对应 SQL 与会话状态,别按创建时间批量删除。
1SELECT TOP (20) session_id, request_id,2 SUM(user_objects_alloc_page_count3 - user_objects_dealloc_page_count) / 128.04 AS user_net_mb,5 SUM(internal_objects_alloc_page_count6 - internal_objects_dealloc_page_count) / 128.07 AS internal_net_mb8FROM sys.dm_db_task_space_usage9WHERE database_id = 210GROUP BY session_id, request_id11ORDER BY internal_net_mb DESC;大临时表通常推高用户对象分配,Sort/Hash 工作区常推高内部对象分配。这里的“净”仍是任务计数,不等于文件已用页;任务结束时还可能汇到会话层。用第 41、13 条把对象和请求对上,再看 SQL 计划。
1SELECT TOP (30) execution_count,2 total_spills, total_spills / 128.03 AS spilled_mb,4 last_execution_time,5 plan_handle6FROM sys.dm_exec_query_stats7WHERE total_spills > 08ORDER BY total_spills DESC;total_spills 是该缓存查询自编译以来溢出的页数,不是当前仍占的 tempdb MB。计划被逐出或重编译后统计会消失/重置;排名能找反复溢出的候选,不能直接证明本次磁盘填满就是它造成的。
1SELECT TOP (30) execution_count,2 last_spills, max_spills,3 last_execution_time,4 last_elapsed_time / 1000.05 AS last_elapsed_ms6FROM sys.dm_exec_query_stats7WHERE last_spills > 08ORDER BY last_execution_time DESC,9 last_spills DESC;最近一次溢出比历史累计更贴近故障窗口;last_elapsed_time 的计时单位为微秒,除以 1000 才是毫秒。last_spills 高仍要看 SQL、参数和计划,不能凭计数单独决定加内存;计划缓存不保留所有历史执行。
1SELECT TOP (20) qs.total_spills,2 qs.last_spills,3 qs.execution_count,4 qs.last_execution_time,5 st.text AS sql_batch6FROM sys.dm_exec_query_stats AS qs7CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS st8WHERE qs.total_spills > 09ORDER BY qs.total_spills DESC;sql_batch 可能包含多条语句,真正溢出的是 query_stats 对应的语句区间;继续用语句偏移或计划定位,别把整段存储过程都判为元凶。再看它是否有排序/哈希、估计行数偏差或内存授予不足。
1SELECT TOP (10) qs.total_spills,2 qs.last_spills,3 qs.last_execution_time,4 qp.query_plan5FROM sys.dm_exec_query_stats AS qs6CROSS APPLY sys.dm_exec_query_plan(qs.plan_handle) AS qp7WHERE qs.total_spills > 08ORDER BY qs.total_spills DESC;检查 Sort、Hash Join、聚合和内存授予相关节点,再按实际执行信息确认是哪一步溢出。缓存计划可能已被逐出,估计 XML 也未必包含每次运行的实际 Spill 警告;Query Store、实际计划和业务参数是后续复核材料。
1USE tempdb;2SELECT total_log_size_in_bytes / 1048576.03 AS total_log_mb,4 used_log_space_in_bytes / 1048576.05 AS used_log_mb,6 used_log_space_in_percent AS used_pct7FROM sys.dm_db_log_space_usage;这是日志文件,不是前面看的数据文件或版本存储空间。日志占用升高时,先把取样时间与长事务、批量写入对上;一次读数无法说明增长速度,也不能靠清理临时表直接保证日志复用。
1USE tempdb;2SELECT (total_log_size_in_bytes3 - used_log_space_in_bytes) / 1048576.04 AS free_log_mb5FROM sys.dm_db_log_space_usage;这是日志文件已分配容量内的剩余量。自动增长还能否成功,要另看日志文件的增长设置和所在卷余量;别把这个数字当磁盘剩余空间。与第 51 条一起留时间戳,才能看消耗趋势。
1SELECT database_id, total_log_size_mb,2 active_log_size_mb, total_vlf_count,3 active_vlf_count, log_truncation_holdup_reason4FROM sys.dm_db_log_stats(DB_ID(N'tempdb'));活跃日志量与第 51 条的“已用百分比”不是同一个统计口径。log_truncation_holdup_reason 提示复用受什么限制;如果是活跃事务,接着看相关事务,而不是先缩文件。VLF 数也要放在文件历史增长方式里判断,不能仅凭一个阈值定故障。
1USE tempdb;2SELECT name, physical_name,3 size / 128.0 AS current_mb,4 max_size, growth, is_percent_growth5FROM sys.database_files6WHERE type_desc = 'LOG';size 和固定增长量 growth 的单位是 8 KB 页;is_percent_growth=1 时,growth 才表示百分数。看清当前大小、上限和卷余量后再讨论扩容。tempdb 重启会重新创建,运行中临时调整的效果还要和实例启动配置对照。
1SELECT TOP (20) dt.database_transaction_begin_time,2 dt.database_transaction_log_bytes_used / 1048576.03 AS log_used_mb,4 st.session_id, at.transaction_begin_time,5 at.name AS transaction_name6FROM sys.dm_tran_database_transactions AS dt7JOIN sys.dm_tran_session_transactions AS st8 ON st.transaction_id = dt.transaction_id9JOIN sys.dm_tran_active_transactions AS at10 ON at.transaction_id = dt.transaction_id11WHERE dt.database_id = 212ORDER BY dt.database_transaction_log_bytes_used DESC;这里找与 tempdb 相关、当前仍活跃的事务及其日志用量,再回查会话正在执行的 SQL。事务可能跨多个数据库,这个数字只是它在 tempdb 的日志记录量;系统事务或没有可见会话映射的事务不一定出现在结果里。
1SELECT TOP (20) st.session_id,2 dt.database_transaction_log_bytes_used / 1048576.03 AS log_used_mb,4 dt.database_transaction_log_bytes_reserved / 1048576.05 AS log_reserved_mb,6 dt.database_transaction_log_record_count7FROM sys.dm_tran_database_transactions AS dt8JOIN sys.dm_tran_session_transactions AS st9 ON st.transaction_id = dt.transaction_id10WHERE dt.database_id = 211ORDER BY dt.database_transaction_log_bytes_reserved DESC;used 是已经写入的日志字节,reserved 是事务为后续记录预留的字节,不要把两列相加。预留量大的事务未必就是当前日志文件已用量最大的事务;结合第 51 条的总量和取样时间判断。
1SELECT TOP (20) dt.database_transaction_begin_time,2 st.session_id, st.is_user_transaction,3 dt.database_transaction_log_bytes_used / 1048576.04 AS log_used_mb5FROM sys.dm_tran_database_transactions AS dt6LEFT JOIN sys.dm_tran_session_transactions AS st7 ON st.transaction_id = dt.transaction_id8WHERE dt.database_id = 29 AND dt.database_transaction_begin_time IS NOT NULL10ORDER BY dt.database_transaction_begin_time;database_transaction_begin_time 是该事务首次在 tempdb 产生日志记录的时间,不一定等于用户打开事务的时间。若日志复用原因指向活跃事务,把最早的一批会话、系统事务和日志用量对上再决定怎么处理。
1SELECT TOP (20) dt.database_transaction_begin_time,2 s.session_id, s.status, s.login_name,3 s.host_name, s.program_name,4 s.open_transaction_count,5 s.last_request_end_time6FROM sys.dm_tran_database_transactions AS dt7JOIN sys.dm_tran_session_transactions AS st8 ON st.transaction_id = dt.transaction_id9JOIN sys.dm_exec_sessions AS s10 ON s.session_id = st.session_id11WHERE dt.database_id = 212 AND dt.database_transaction_begin_time IS NOT NULL13ORDER BY dt.database_transaction_begin_time;会话显示 sleeping、最近请求已结束,但事务仍未提交时,需要联系应用核对事务边界。open_transaction_count 不能替代事务 DMV 的明细;MARS、绑定会话等场景下计数口径可能不同。直接结束会话会触发回滚,先确认业务影响。
1SELECT TOP (20) dt.database_transaction_begin_time,2 st.session_id, r.status, r.command,3 r.wait_type, r.wait_time,4 sql_text.text AS sql_batch5FROM sys.dm_tran_database_transactions AS dt6JOIN sys.dm_tran_session_transactions AS st7 ON st.transaction_id = dt.transaction_id8LEFT JOIN sys.dm_exec_requests AS r9 ON r.session_id = st.session_id10OUTER APPLY sys.dm_exec_sql_text(r.sql_handle) AS sql_text11WHERE dt.database_id = 212ORDER BY dt.database_transaction_begin_time;请求为空不代表事务结束,可能只是会话当前空闲。sql_batch 也可能有多条语句;对正在执行的请求,仍要用语句偏移找出具体语句。慢请求和日志复用受阻可能同时出现,但不能仅凭同一 session 就认定慢 SQL 是根因。
1SELECT dt.database_transaction_type,2 COUNT(*) AS transaction_count,3 SUM(dt.database_transaction_log_bytes_used) / 1048576.04 AS log_used_mb5FROM sys.dm_tran_database_transactions AS dt6WHERE dt.database_id = 27GROUP BY dt.database_transaction_type8ORDER BY log_used_mb DESC;类型 1 是读写事务,2 是只读事务,3 是系统事务。这里按当前 DMV 可见事务汇总,并不是日志文件内所有已占空间;若系统事务占比高,不能按普通业务连接的处理方式去清理。先结合实例任务和日志复用原因排查。
1SELECT o.name AS event_name, p.name AS package_name,2 o.description3FROM sys.dm_xe_objects AS o4JOIN sys.dm_xe_packages AS p5 ON p.guid = o.package_guid6WHERE o.object_type = N'event'7 AND o.name = N'database_file_size_change';先确认事件在当前 SQL Server 实例存在,再创建采集会话。查不到时不要照抄后面的 CREATE EVENT SESSION;版本、权限和实例环境都要先核对。
1SELECT c.name, c.type_name, c.description2FROM sys.dm_xe_object_columns AS c3JOIN sys.dm_xe_objects AS o4 ON o.name = c.object_name5 AND o.package_guid = c.object_package_guid6WHERE o.name = N'database_file_size_change'7 AND c.column_type = N'data'8ORDER BY c.name;字段名称以当前实例返回为准。先看事件是否给数据库、文件、增长量和持续时间,再决定怎样解析 XEL;不要把网上另一个版本的 XML 路径直接套在自己的实例上。
1-- 先建 D:\XE 目录,并确认 SQL Server 服务账号可写2CREATE EVENT SESSION [tempdb_file_growth]3ON SERVER4ADD EVENT sqlserver.database_file_size_change5ADD TARGET package0.event_file6 (SET filename = N'D:\XE\tempdb_file_growth.xel',7 max_file_size = 10,8 max_rollover_files = 2)9WITH (EVENT_RETENTION_MODE = ALLOW_SINGLE_EVENT_LOSS,10 MAX_DISPATCH_LATENCY = 5 SECONDS,11 STARTUP_STATE = OFF);这个事件会记录实例内的文件大小变更,读回时再挑 tempdb;它不会补回创建会话以前的增长历史。示例保留有限的 XEL 文件,容量与目录权限都要按现场调整。
1ALTER EVENT SESSION [tempdb_file_growth]2ON SERVER STATE = START;启动后才会产生新事件。要把开始时间与第 1、2、51 条的文件和日志空间读数一起留存,才能判断文件增长前后发生了什么。
1SELECT s.name, s.create_time, s.total_buffer_size,2 s.dropped_event_count3FROM sys.dm_xe_sessions AS s4WHERE s.name = N'tempdb_file_growth';有运行中的会话行,才说明采集已经启动;dropped_event_count 不为零时,XEL 可能漏掉部分事件。这里不能证明目标文件已经产生,还要检查目标目录和读回结果。
1-- 路径换成当前 XE 会话的目标路径2SELECT TOP (100) timestamp_utc, object_name,3 CAST(event_data AS xml) AS event_xml4FROM sys.fn_xe_file_target_read_file5 (N'D:\XE\tempdb_file_growth*.xel', NULL, NULL, NULL)6WHERE object_name = N'database_file_size_change'7ORDER BY timestamp_utc DESC;先读原始 XML,再按照第 62 条现场字段筛 tempdb、数据或日志文件。XEL 只覆盖采集窗口,而且目标有文件轮转上限;没有事件时,要确认观察期间是否真的发生过增长。
1ALTER EVENT SESSION [tempdb_file_growth]2ON SERVER STATE = STOP;停止后保留 XEL 和起止时间,复核增长事件与业务请求、版本存储和日志事务是否在同一时段。事件时间是 UTC,和本地监控时间对照时要换算时区。
1-- 确认采集文件已留存、会话不再需要2DROP EVENT SESSION [tempdb_file_growth] ON SERVER;这只删会话定义,不会自动清除已经生成的 XEL。若现场要长期监控,应按监控规范另建持久会话并设置轮转、告警和权限,而不是把这个短时示例长期放着。
1SELECT file_id, name, type_desc, physical_name,2 size / 128.0 AS startup_size_mb,3 growth, is_percent_growth4FROM sys.master_files5WHERE database_id = DB_ID(N'tempdb')6ORDER BY type_desc, file_id;sys.master_files 对 tempdb 保存的是启动时创建文件的模板大小,不反映运行中自动增长。运行中已长到几十 GB,却只有很小的启动大小,重启后可能又经历一轮增长。
1SELECT m.file_id, m.name, m.type_desc,2 m.size / 128.0 AS startup_mb,3 c.size / 128.0 AS current_mb,4 (c.size - m.size) / 128.0 AS grown_since_start_mb5FROM sys.master_files AS m6JOIN tempdb.sys.database_files AS c7 ON c.file_id = m.file_id8WHERE m.database_id = 29ORDER BY grown_since_start_mb DESC;这个差值说明本次实例运行期间文件比启动模板大了多少,不等于精确增长事件次数;文件也可能被人工调整。要找增长时间仍读第 66 条 XEL。
1SELECT sqlserver_start_time2FROM sys.dm_os_sys_info;第 70 条的“本次运行期间”从这个时间开始。把它与业务告警、版本存储增长、自动增长事件的 UTC 时间对齐,避免把重启前留下的监控曲线接到新的 tempdb 文件上。
1SELECT COUNT(*) AS data_file_count,2 MIN(size) / 128.0 AS min_startup_mb,3 MAX(size) / 128.0 AS max_startup_mb,4 SUM(size) / 128.0 AS total_startup_mb5FROM sys.master_files6WHERE database_id = 27 AND type_desc = N'ROWS';数据文件的初始大小若差很多,先查它们是否曾按不同容量规划。总启动大小才是重启后可预期的初始数据文件容量,不是当前空闲空间;还要看磁盘是否放得下这些文件。
1SELECT file_id, name, size / 128.0 AS startup_mb,2 growth, is_percent_growth, max_size3FROM sys.master_files4WHERE database_id = 25 AND type_desc = N'ROWS'6ORDER BY is_percent_growth, growth, file_id;固定增长量的 growth 单位是 8 KB 页,百分比增长则是百分数。SQL Server 2022 的 tempdb 数据文件增长可能同时发生;不同文件的增长设置会影响一次增长的总量和各卷压力。先读配置,不要仅凭文件数多就建议再加文件。
1SELECT m.name, m.physical_name,2 m.size / 128.0 AS startup_log_mb,3 c.size / 128.0 AS current_log_mb,4 m.growth, m.is_percent_growth,5 m.max_size6FROM sys.master_files AS m7JOIN tempdb.sys.database_files AS c8 ON c.file_id = m.file_id9WHERE m.database_id = 210 AND m.type_desc = N'LOG';日志重启后也会按模板重新创建。若每次运行都要从很小的启动值长到很大,结合第 51—60 条找稳定的日志需求和实际增长窗口;不要把一次异常事务撑大的容量直接设为长期启动大小。
1SELECT object_name, counter_name, instance_name,2 cntr_value, cntr_type3FROM sys.dm_os_performance_counters4WHERE counter_name IN5 (N'Temp Tables Creation Rate',6 N'Temp Tables For Destruction',7 N'Version Store Size (KB)',8 N'Version Generation rate (KB/s)',9 N'Version Cleanup rate (KB/s)',10 N'Free Space in tempdb (KB)')11ORDER BY object_name, counter_name, instance_name;先看现场计数器名称和实例项,再做采样。速率类计数器不能把一次 cntr_value 直接当“每秒”;SQL Server 重启或清空计数后也不能把前后两次读数硬相减。
1DECLARE @start_value bigint, @start_time datetime2;2SELECT @start_value = cntr_value,3 @start_time = SYSDATETIME()4FROM sys.dm_os_performance_counters5WHERE object_name LIKE N'%:General Statistics%'6 AND counter_name = N'Temp Tables Creation Rate';78WAITFOR DELAY '00:00:10';910SELECT (cntr_value - @start_value) * 1.0 /11 NULLIF(DATEDIFF_BIG(millisecond, @start_time,12 SYSDATETIME()) / 1000.0, 0)13 AS temp_tables_per_second14FROM sys.dm_os_performance_counters15WHERE object_name LIKE N'%:General Statistics%'16 AND counter_name = N'Temp Tables Creation Rate';把十秒窗口与业务并发、临时对象创建量一起看。它统计临时表和表变量创建,不等于正在占用的临时表数量;窗口内若实例重启或计数器复位,差值失效。
1SELECT object_name, cntr_value AS waiting_to_destroy2FROM sys.dm_os_performance_counters3WHERE object_name LIKE N'%:General Statistics%'4 AND counter_name = N'Temp Tables For Destruction';这是等待清理线程销毁的临时表、表变量个数。高创建速度伴随该值持续堆积时,才值得进一步看清理节奏和 tempdb 元数据等待;一个瞬时读数不能证明后台清理卡死。
1DECLARE @samples table (counter_name nvarchar(128) PRIMARY KEY,2 first_value bigint);3DECLARE @sample_time datetime2 = SYSDATETIME();45INSERT INTO @samples(counter_name, first_value)6SELECT counter_name, cntr_value7FROM sys.dm_os_performance_counters8WHERE object_name LIKE N'%:Transactions%'9 AND counter_name IN (N'Version Generation rate (KB/s)',10 N'Version Cleanup rate (KB/s)');1112WAITFOR DELAY '00:00:10';1314SELECT p.counter_name,15 (p.cntr_value - s.first_value) * 1.0 /16 NULLIF(DATEDIFF_BIG(millisecond, @sample_time,17 SYSDATETIME()) / 1000.0, 0)18 AS kb_per_second19FROM sys.dm_os_performance_counters AS p20JOIN @samples AS s ON s.counter_name = p.counter_name21WHERE p.object_name LIKE N'%:Transactions%';这两项针对 tempdb 的传统版本存储,不能直接解释 ADR 的用户库 PVS。生成长期高于清理时,再回第 8、33—39 条看长快照事务和 PVS;不能只凭十秒速率估算准确的磁盘耗尽时间。
1SELECT object_name, cntr_value / 1024.02 AS traditional_version_store_mb3FROM sys.dm_os_performance_counters4WHERE object_name LIKE N'%:Transactions%'5 AND counter_name = N'Version Store Size (KB)';计数器给的是 tempdb 传统版本存储大小,和第 3 条按用户库拆分的 DMV 对照。ADR PVS 在用户库里,不应把它加到这个数里再称作 tempdb 使用量。
1SELECT object_name, cntr_value / 1024.02 AS free_tempdb_mb3FROM sys.dm_os_performance_counters4WHERE object_name LIKE N'%:Transactions%'5 AND counter_name = N'Free Space in tempdb (KB)';这项读数可以和第 2、28 条的数据文件空闲页互相核对。它不是文件所在卷还能扩多少,也不包含日志文件可用空间;真正的增长余量仍需第 29、30 条查卷和文件上限。
1SELECT counter_name, cntr_value2FROM sys.dm_os_performance_counters3WHERE object_name LIKE N'%:Transactions%'4 AND counter_name IN (N'Snapshot Transactions',5 N'Update Snapshot Transactions');这个读数用于看规模,不显示哪个事务拖住版本清理。快照事务计数通常在首次数据访问后才变化,而不是单凭 BEGIN TRANSACTION;找具体会话仍用第 8、9 条。
1USE tempdb;2SELECT SUM(unallocated_extent_page_count) / 128.0 AS free_mb,3 SUM(version_store_reserved_page_count) / 128.04 AS traditional_version_store_mb,5 SUM(user_object_reserved_page_count) / 128.06 AS user_objects_mb,7 SUM(internal_object_reserved_page_count) / 128.08 AS internal_objects_mb9FROM sys.dm_db_file_space_usage;把第 79、80 条的全实例计数器与 tempdb 文件页数放到同一时间窗口看。两种口径和刷新时点不一定完全相同;本条仍只覆盖 tempdb 数据文件,不包含日志或用户库 ADR PVS。
1SELECT object_name, counter_name, cntr_value, cntr_type2FROM sys.dm_os_performance_counters3WHERE object_name LIKE N'%:Access Methods%'4 AND counter_name IN (N'Worktables Created/sec',5 N'Workfiles Created/sec',6 N'Worktables From Cache Ratio')7ORDER BY counter_name;工作表常见于 spool、游标等操作,工作文件常见于哈希连接或聚合。计数器是实例级线索,不能据此指认某条 SQL;缓存比例也不能拿 cntr_value 不经类型转换就当作百分比。
1DECLARE @first table (counter_name nvarchar(128) PRIMARY KEY,2 cntr_value bigint);3DECLARE @at datetime2 = SYSDATETIME();45INSERT INTO @first(counter_name, cntr_value)6SELECT counter_name, cntr_value7FROM sys.dm_os_performance_counters8WHERE object_name LIKE N'%:Access Methods%'9 AND counter_name IN (N'Worktables Created/sec',10 N'Workfiles Created/sec');1112WAITFOR DELAY '00:00:10';1314SELECT p.counter_name,15 (p.cntr_value - f.cntr_value) * 1.0 /16 NULLIF(DATEDIFF_BIG(millisecond, @at,17 SYSDATETIME()) / 1000.0, 0)18 AS created_per_second19FROM sys.dm_os_performance_counters AS p20JOIN @first AS f ON f.counter_name = p.counter_name21WHERE p.object_name LIKE N'%:Access Methods%';对照第 76 条的临时表创建速率:如果工作文件更明显,优先查 Sort/Hash 计划和内部对象分配;如果临时表更明显,再查用户对象和元数据页闩锁。两次读数要在同一次实例运行中取得。
1WITH task_pages AS (2 SELECT session_id, request_id, exec_context_id,3 internal_objects_alloc_page_count4 - internal_objects_dealloc_page_count AS net_pages5 FROM sys.dm_db_task_space_usage6 WHERE database_id = 27), ranked AS (8 SELECT *, SUM(net_pages) OVER9 (PARTITION BY session_id, request_id)10 AS request_net_pages11 FROM task_pages12)13SELECT TOP (30) session_id, request_id, exec_context_id,14 net_pages / 128.0 AS task_net_mb,15 request_net_pages / 128.0 AS request_net_mb16FROM ranked17WHERE net_pages > 018ORDER BY request_net_pages DESC, net_pages DESC;同一请求可能有多个执行上下文,单个任务很高时要看并行计划、Sort/Hash 节点和分布偏斜。这里是任务级净分配,不等于仍留在文件里的页;第 11—15 条用来把它对到请求和计划。
1WITH usage AS (2 SELECT session_id, request_id,3 SUM(internal_objects_alloc_page_count4 - internal_objects_dealloc_page_count) / 128.05 AS internal_net_mb6 FROM sys.dm_db_task_space_usage7 WHERE database_id = 28 GROUP BY session_id, request_id9)10SELECT TOP (20) r.session_id, r.request_id,11 u.internal_net_mb, r.wait_type,12 g.requested_memory_kb, g.granted_memory_kb,13 g.used_memory_kb, g.max_used_memory_kb14FROM usage AS u15JOIN sys.dm_exec_requests AS r16 ON r.session_id = u.session_id17 AND r.request_id = u.request_id18LEFT JOIN sys.dm_exec_query_memory_grants AS g19 ON g.session_id = u.session_id20 AND g.request_id = u.request_id21WHERE u.internal_net_mb > 022ORDER BY u.internal_net_mb DESC;内部对象分配高且授予紧张时,再看执行计划是否发生 Spill。没有授予记录不代表 tempdb 没压力:某些请求不需要查询内存授予,内部对象也可能由 spool 或游标产生。
1WITH usage AS (2 SELECT session_id, request_id,3 SUM(internal_objects_alloc_page_count4 - internal_objects_dealloc_page_count) / 128.05 AS internal_net_mb6 FROM sys.dm_db_task_space_usage7 WHERE database_id = 28 GROUP BY session_id, request_id9)10SELECT TOP (20) r.session_id, r.request_id,11 u.internal_net_mb,12 SUBSTRING(st.text, r.statement_start_offset / 2 + 1,13 (CASE WHEN r.statement_end_offset = -114 THEN DATALENGTH(st.text)15 ELSE r.statement_end_offset END16 - r.statement_start_offset) / 2 + 1)17 AS current_statement18FROM usage AS u19JOIN sys.dm_exec_requests AS r20 ON r.session_id = u.session_id21 AND r.request_id = u.request_id22CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS st23WHERE u.internal_net_mb > 024 AND r.statement_start_offset IS NOT NULL25ORDER BY u.internal_net_mb DESC;第 14 条给完整批次,本条按字节偏移截取当前语句,适合一个存储过程里有多段 SQL 的情况。请求在采样时可能已经切换语句;把这条与计划、实时任务页数一起看,不能把历史累计 Spill 全算到当前这一句。
1WITH usage AS (2 SELECT session_id, request_id,3 SUM(internal_objects_alloc_page_count4 - internal_objects_dealloc_page_count) / 128.05 AS internal_net_mb6 FROM sys.dm_db_task_space_usage7 WHERE database_id = 28 GROUP BY session_id, request_id9)10SELECT TOP (20) r.session_id, r.request_id,11 u.internal_net_mb, r.status,12 r.wait_type, r.last_wait_type, r.wait_resource,13 r.granted_query_memory14FROM usage AS u15JOIN sys.dm_exec_requests AS r16 ON r.session_id = u.session_id17 AND r.request_id = u.request_id18WHERE u.internal_net_mb > 019ORDER BY u.internal_net_mb DESC;当前等待只能说明请求此刻停在哪儿,不一定就是 tempdb 消耗的原因。granted_query_memory 单位是 8 KB 页;PAGELATCH 要对上 tempdb 页号,RESOURCE_SEMAPHORE 要看授予队列,I/O 等待还须和文件读写延迟对照。
1SELECT name, is_autogrow_all_files2FROM tempdb.sys.filegroups3WHERE name = N'PRIMARY';SQL Server 2022 的 tempdb 默认让同文件组的数据文件一起增长。若这里为 1,一次自动增长可能同时占用多个卷的空间;不能拿某一个文件的增长量判断整次增长需要多少磁盘。
1SELECT servicename, instant_file_initialization_enabled2FROM sys.dm_server_services3WHERE servicename LIKE N'SQL Server (%';Y 表示数据库引擎服务已启用即时文件初始化,N 表示没有;SQL Server 2022 查该视图需要相应服务器安全状态权限。即时初始化对数据文件增长的作用还受 TDE 等条件影响;日志增长小于等于 64 MB 有自己的版本特性,不能直接套用这个读数。
1SELECT c.file_id, c.name, c.type_desc,2 c.size / 128.0 AS current_mb,3 CASE WHEN m.max_size = -1 THEN NULL4 ELSE m.max_size / 128.0 END AS configured_max_mb,5 CASE WHEN m.max_size = -1 THEN NULL6 ELSE (m.max_size - c.size) / 128.0 END7 AS remaining_to_max_mb,8 m.growth, m.is_percent_growth9FROM tempdb.sys.database_files AS c10JOIN sys.master_files AS m11 ON m.database_id = 2 AND m.file_id = c.file_id12ORDER BY c.type_desc, c.file_id;max_size = -1 代表不按配置文件大小封顶,真正上限仍受磁盘容量限制;growth = 0 则无法自动增长。sys.master_files.size 是 tempdb 启动模板,所以当前大小必须从 tempdb.sys.database_files 取。
1WITH file_volume AS (2 SELECT f.file_id, f.type_desc, f.size,3 v.volume_mount_point, v.available_bytes4 FROM tempdb.sys.database_files AS f5 CROSS APPLY sys.dm_os_volume_stats(2, f.file_id) AS v6)7SELECT volume_mount_point,8 COUNT(*) AS tempdb_file_count,9 SUM(size) / 128.0 AS tempdb_current_mb,10 MAX(available_bytes) / 1048576.0 AS volume_free_mb11FROM file_volume12GROUP BY volume_mount_point13ORDER BY volume_mount_point;同一个卷的 available_bytes 在每个文件行都会出现,所以用 MAX 而不是 SUM。卷上的空闲空间还可能被其他数据库或进程使用;这条是当前快照,不是 tempdb 独占配额。
1WITH growth AS (2 SELECT f.file_id, f.size, m.growth, m.is_percent_growth,3 v.volume_mount_point, v.available_bytes,4 CASE WHEN m.growth = 0 THEN 0.05 WHEN m.is_percent_growth = 16 THEN f.size * m.growth / 100.0 / 128.07 ELSE m.growth / 128.0 END AS next_growth_mb8 FROM tempdb.sys.database_files AS f9 JOIN sys.master_files AS m10 ON m.database_id = 2 AND m.file_id = f.file_id11 CROSS APPLY sys.dm_os_volume_stats(2, f.file_id) AS v12 WHERE f.type_desc = N'ROWS'13)14SELECT volume_mount_point,15 SUM(next_growth_mb) AS approximate_growth_mb,16 MAX(available_bytes) / 1048576.0 AS volume_free_mb17FROM growth18GROUP BY volume_mount_point;第 89 条为 1 时,这个合计帮助估算一次全文件增长的卷压力;为 0 时则是各文件“若都增长”的总预算。百分比增长和 64 KB 取整使实际量略有差异,配置上限、卷上其他负载也要一起看。
1SELECT c.file_id, c.name, c.type_desc,2 c.size / 128.0 AS current_mb,3 m.max_size, m.growth4FROM tempdb.sys.database_files AS c5JOIN sys.master_files AS m6 ON m.database_id = 2 AND m.file_id = c.file_id7WHERE m.growth = 08 OR (m.max_size <> -1 AND c.size >= m.max_size)9ORDER BY c.file_id;结果中的文件无法靠既有自动增长设置继续扩容。空结果也不能证明安全:卷空间不足仍会失败,日志和数据文件还要分开评估;先查第 29、51、52、92 条再决定变更。
1-- tempdev 与 4096MB 仅为示例;SIZE 必须大于该文件当前大小2ALTER DATABASE tempdb3 MODIFY FILE (NAME = N'tempdev', SIZE = 4096MB);先查第 91—93 条,确认目标卷能容纳新尺寸。MODIFY FILE SIZE 用于增大文件,不能靠它缩小;对 tempdb 的显式大小设置也会影响下次启动时的模板。多个数据文件应按同样规划保持初始大小一致。
1-- 按现场负载和卷空间定值,其余数据文件也要核对一致2ALTER DATABASE tempdb3 MODIFY FILE (NAME = N'tempdev', FILEGROWTH = 256MB);固定增长比百分比更容易算磁盘预算,但不能把一次异常峰值当成长期增长要求。tempdb 默认全文件一起增长时,改一个文件而留下其他文件不同的增长量,会让实际增长和第 93 条预算不一致;变更后回读第 73、89 条。
1-- templog 为示例逻辑名;先确认第 54、74 条的现场值2ALTER DATABASE tempdb3 MODIFY FILE (NAME = N'templog', FILEGROWTH = 64MB);SQL Server 2022 的日志自动增长量不超过 64 MB 时,可以受益于日志即时文件初始化;更大的增长量不能享受这项特性。64 MB 只是示例,不是所有负载的统一建议。日志事务积压时仍要先查第 55—60 条,不能靠改增长量解决复用问题。
1-- Windows 路径、文件名、大小和增长量均按现场替换2ALTER DATABASE tempdb3 ADD FILE4 (NAME = N'tempdb_extra',5 FILENAME = N'E:\MSSQL\DATA\tempdb_extra.ndf',6 SIZE = 4096MB,7 FILEGROWTH = 256MB)8 TO FILEGROUP [PRIMARY];只有已确认数据文件数、页闩锁热点或卷容量规划后才加文件;路径须存在且 SQL Server 服务账号可写。新增文件的初始大小和增长量应与其他数据文件一致。临时对象创建太多、长快照事务或查询 Spill 仍需回头治理业务负载。
1SELECT c.file_id, c.name, c.type_desc,2 c.physical_name,3 c.size / 128.0 AS current_mb,4 m.size / 128.0 AS next_startup_mb,5 m.growth, m.is_percent_growth, m.max_size6FROM tempdb.sys.database_files AS c7JOIN sys.master_files AS m8 ON m.database_id = 2 AND m.file_id = c.file_id9ORDER BY c.type_desc, c.file_id;文件改了以后不能只看 ALTER DATABASE 返回成功。对照现有文件是否保持相同的增长配置,也要核对下次重启时的模板大小;再用第 92 条确认文件确实落在计划的卷上。
1USE tempdb;2-- 2048MB 为示例目标;先确认已用空间和正常峰值3DBCC SHRINKFILE (N'tempdev', 2048)4 WITH WAIT_AT_LOW_PRIORITY (ABORT_AFTER_WAIT = SELF);只在一次性异常占用已消失、需要立即收回卷空间时考虑收缩。SQL Server 2022 的低优先级等待拿不到所需锁会让收缩自行退出,不会替你清除业务阻塞;收缩后文件若很快又长回来,说明容量本来就需要。操作前看第 2、28、92 条,操作后回读第 99 条。
tempdb 告警先分清数据文件、日志、传统版本存储和用户库 ADR PVS,再找对应的会话或计划。文件已经长大也别急着缩:看持续负载、启动模板、自动增长和卷余量,才能决定是补容量还是改 SQL、事务和版本清理。
 ORA100 DBA100 命令系列海报
更多数据库运维专题,见 ORA100 · DBA100:https://ora100.com/dba100
微信小程序搜索 「三笠的百令册」,可以接着查其他专题。