运维管理11 分钟阅读
Oracle 慢 SQL 怎么查?这一套组合拳够用了
2026年9月26日阅读—点赞—收藏—
OracleSQL
在知识库中专注阅读,并随时返回相关工具与课程
做 DBA 应该经常碰到这种事情,业务突然发过来一条消息:
这条 SQL 最近很慢,帮忙看一下。
这种问题处理多了以后,我现在拿到 SQL 已经很少第一时间去想“是不是缺索引”了。一条 SQL 慢,可能是 Physical Reads 突然上来了,也可能是 Buffer Gets 本身就很高;还有些 SQL 读的数据并不多,时间其实耗在锁等待、RAC 或其他 Wait Event 上。
所以我现在拿到 SQL_ID,我一般先看几个最直接的指标:
1Physical Reads2 ↓3Buffer Gets(逻辑读)4 ↓5Rows Processed6 ↓7Elapsed Time先把 SQL 慢在哪里定下来,再去翻 AWR、看执行计划、查 Stats、索引、选择性和 Bind。下面这套查询基本就是我现在常用的完整路径,拿到 SQL_ID 后可以一路往下查。
如果业务已经给了 SQL_ID,这一步直接跳过。如果只有 SQL Text,或者只知道涉及某张表,可以先从 Shared Pool 找。RAC 环境建议直接查 GV$SQL:
1SET LINES 3002SET PAGES 2003SET LONG 10000004SET LONGCHUNKSIZE 100000056SELECT inst_id,7 sql_id,8 child_number,9 plan_hash_value,10 executions,11 buffer_gets,12 disk_reads,13 rows_processed,14 ROUND(elapsed_time/1e6,2) elapsed_s,15 TO_CHAR(last_active_time,'YYYY-MM-DD HH24:MI:SS') last_active16FROM gv$sql17WHERE UPPER(sql_fulltext) LIKE '%PE_BATCH_PROCESS%'18ORDER BY last_active_time DESC;找到 SQL_ID 后,把完整 SQL 拿出来:
1SELECT sql_fulltext2FROM gv$sql3WHERE sql_id='&sql_id'4 AND ROWNUM=1;如果 SQL 已经不在 Shared Pool,可以继续从 AWR 找:
1SELECT sql_id,2 sql_text3FROM dba_hist_sqltext4WHERE UPPER(sql_text) LIKE '%PE_BATCH_PROCESS%';先把 SQL_ID 确定下来,后面的当前执行情况、历史表现、执行计划和 Bind 才能串到一起。
我一般先把单次执行的几个核心指标一次查出来:
1SET LINES 3002SET PAGES 20034SELECT inst_id,5 sql_id,6 child_number,7 plan_hash_value,8 executions,9 buffer_gets,10 disk_reads,11 rows_processed,12 ROUND(disk_reads/NULLIF(executions,0)) reads_per_exec,13 ROUND(buffer_gets/NULLIF(executions,0)) gets_per_exec,14 ROUND(rows_processed/NULLIF(executions,0)) rows_per_exec,15 ROUND(elapsed_time/1e6/NULLIF(executions,0),2) elapsed_per_exec_s,16 ROUND(cpu_time/1e6/NULLIF(executions,0),2) cpu_per_exec_s,17 TO_CHAR(last_active_time,'YYYY-MM-DD HH24:MI:SS') last_active18FROM gv$sql19WHERE sql_id='&sql_id'20ORDER BY inst_id,child_number;第一眼先看 Reads/Exec。Physical Reads 明显升高,SQL 很容易从几秒变成几十秒;如果 Physical Reads 不高,再看 Gets/Exec,判断 SQL 本身是不是做了大量逻辑访问。Buffer Gets 很高时还要结合 Rows/Exec,因为“为了返回几十行访问几百万个块”和“本身就要处理几百万行”不是一回事。
大致可以先按下面的方式定方向:
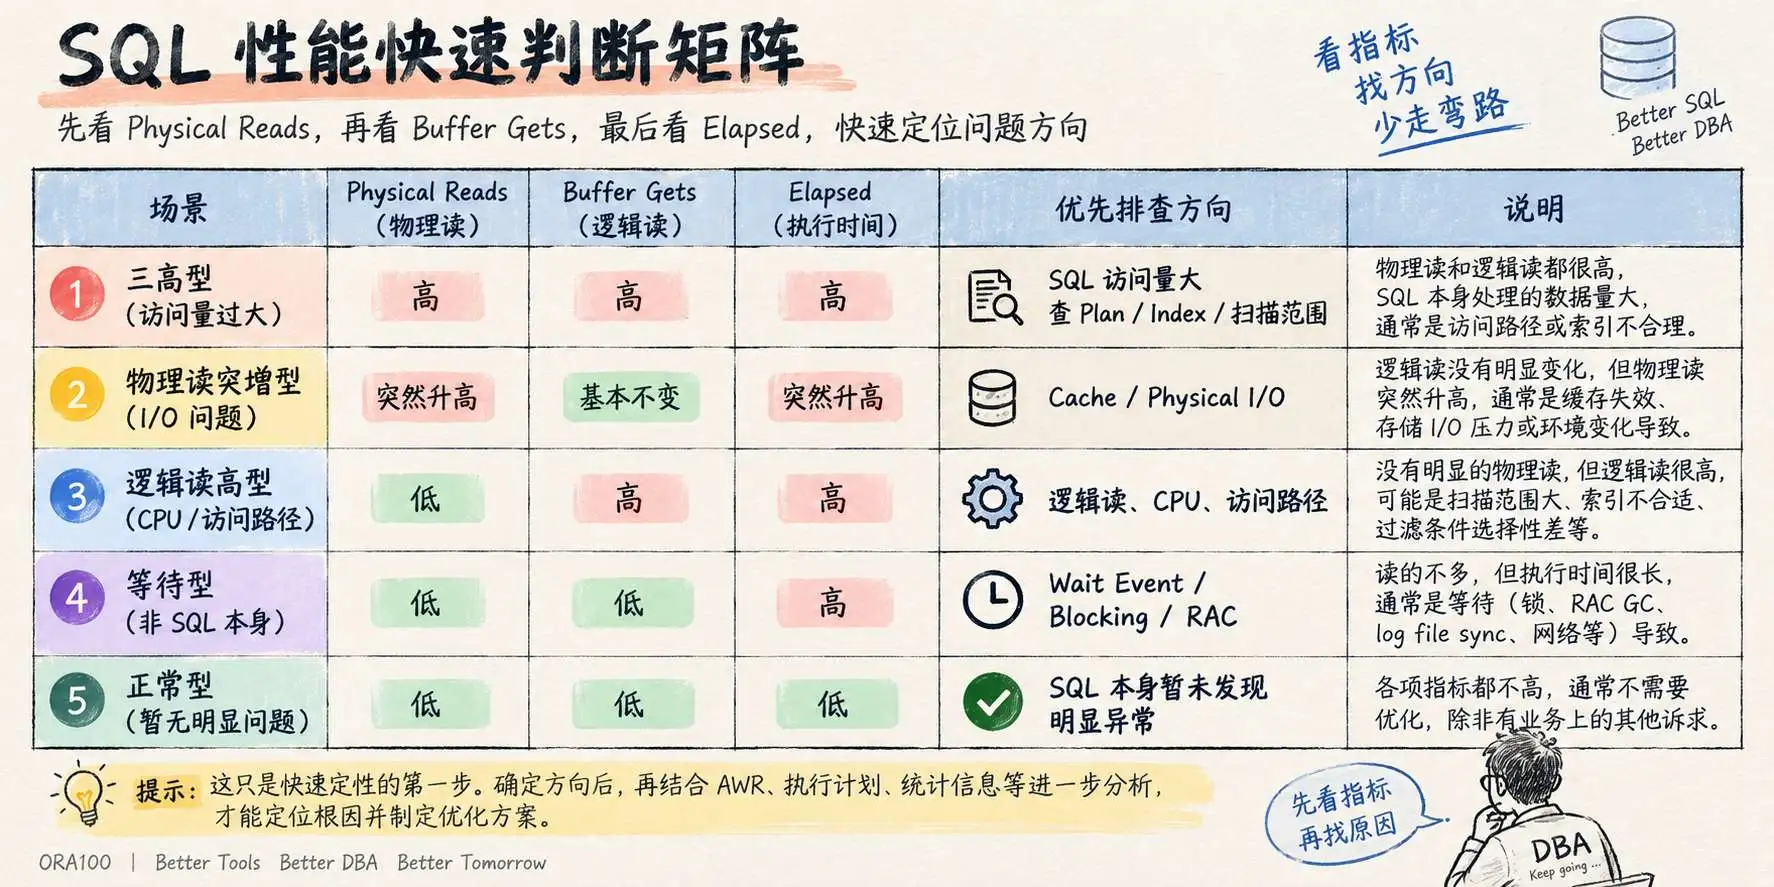
这里先做初步定性,不急着改 SQL。
如果 Physical Reads 和 Buffer Gets 都不高,但 Elapsed/Exec 仍然很高,就应该先确认时间到底花在哪里。
SQL 正在执行时:
1SET LINES 3002SET PAGES 20034SELECT inst_id,5 sid,6 serial#,7 username,8 sql_id,9 status,10 event,11 wait_class,12 seconds_in_wait,13 blocking_instance,14 blocking_session,15 module,16 program17FROM gv$session18WHERE sql_id='&sql_id'19ORDER BY inst_id,sid;如果 SQL 已经执行结束,可以从 ASH 看历史状态:
1SELECT NVL(event,'ON CPU') event,2 NVL(wait_class,'CPU') wait_class,3 COUNT(*) samples,4 ROUND(COUNT(*) * 10 / 60,2) active_minutes5FROM dba_hist_active_sess_history6WHERE sql_id='&sql_id'7GROUP BY NVL(event,'ON CPU'),8 NVL(wait_class,'CPU')9ORDER BY samples DESC;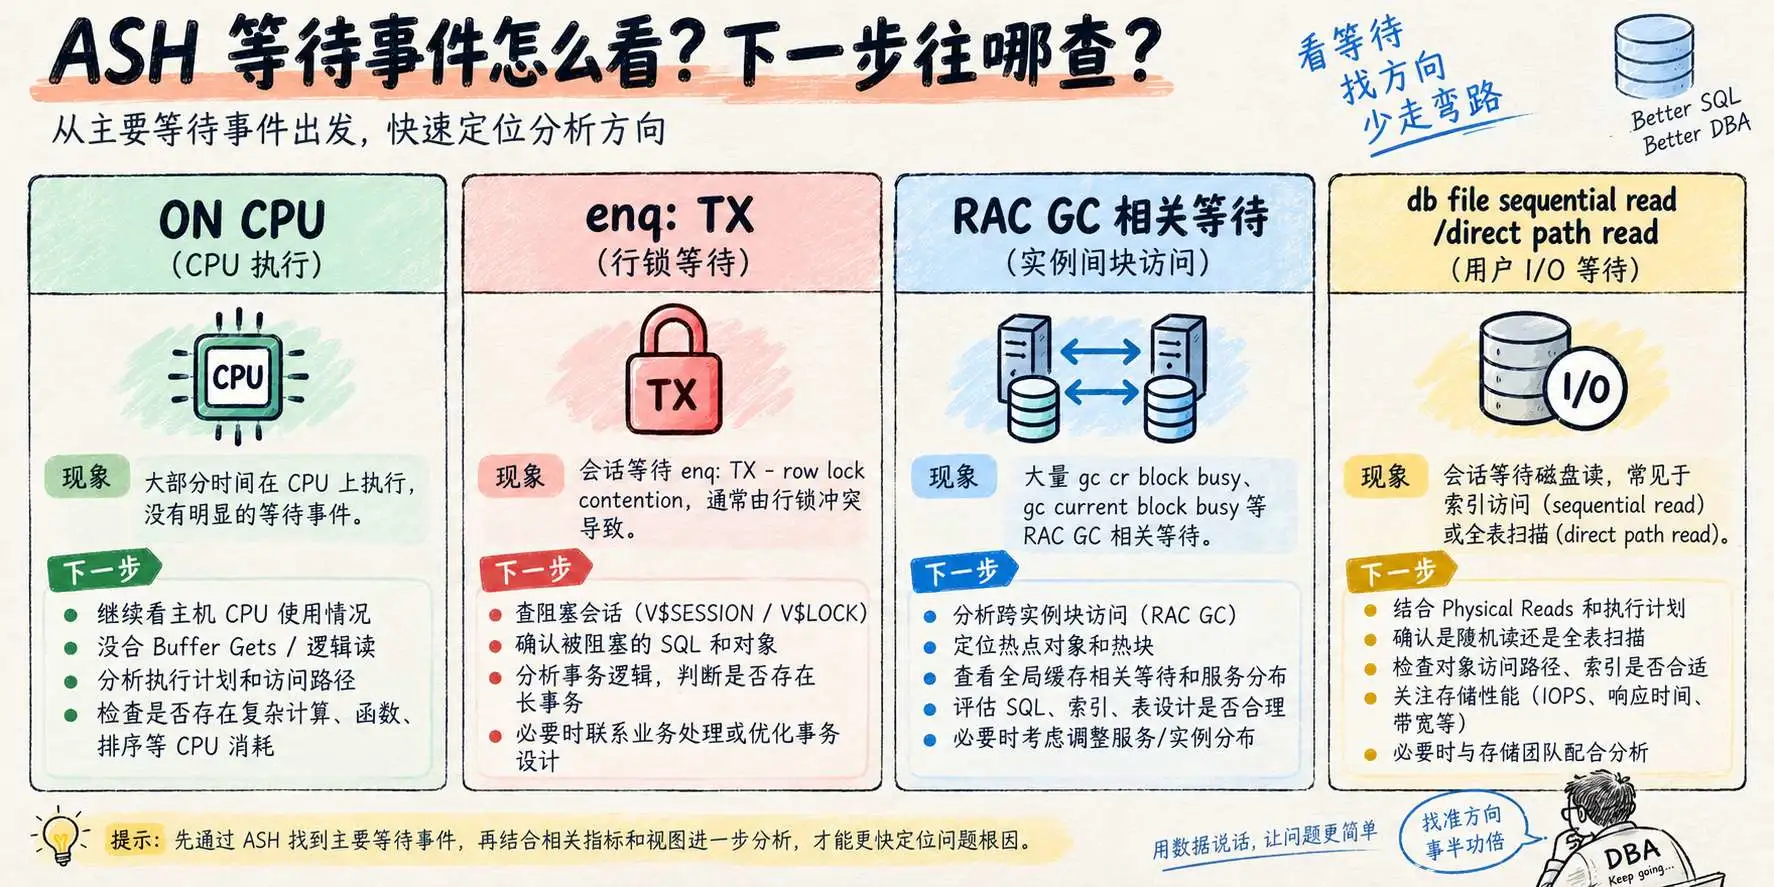
这一步主要解决一个问题:Elapsed 很高,到底是 SQL 自己在做事,还是大部分时间其实在等。
当前数据只能说明这一刻,业务反馈“以前几秒,现在几十秒”可以作为参考,但是建议最好从 AWR 看真实历史:
1SET LINES 3002SET PAGES 30034SELECT s.instance_number,5 s.snap_id,6 TO_CHAR(s.begin_interval_time,'YYYY-MM-DD HH24:MI') begin_time,7 st.plan_hash_value,8 st.executions_delta executions,9 st.buffer_gets_delta buffer_gets,10 st.disk_reads_delta disk_reads,11 st.rows_processed_delta rows_processed,12 ROUND(st.disk_reads_delta/13 NULLIF(st.executions_delta,0)) reads_per_exec,14 ROUND(st.buffer_gets_delta/15 NULLIF(st.executions_delta,0)) gets_per_exec,16 ROUND(st.rows_processed_delta/17 NULLIF(st.executions_delta,0)) rows_per_exec,18 ROUND(st.elapsed_time_delta/1e6/19 NULLIF(st.executions_delta,0),2) elapsed_per_exec_s,20 ROUND(st.cpu_time_delta/1e6/21 NULLIF(st.executions_delta,0),2) cpu_per_exec_s22FROM dba_hist_sqlstat st23JOIN dba_hist_snapshot s24 ON s.dbid=st.dbid25 AND s.instance_number=st.instance_number26 AND s.snap_id=st.snap_id27WHERE st.sql_id='&sql_id'28ORDER BY s.begin_interval_time DESC,29 s.instance_number;这里主要比较 Plan Hash、Reads/Exec、Gets/Exec、Rows/Exec、Elapsed/Exec 和 Executions。
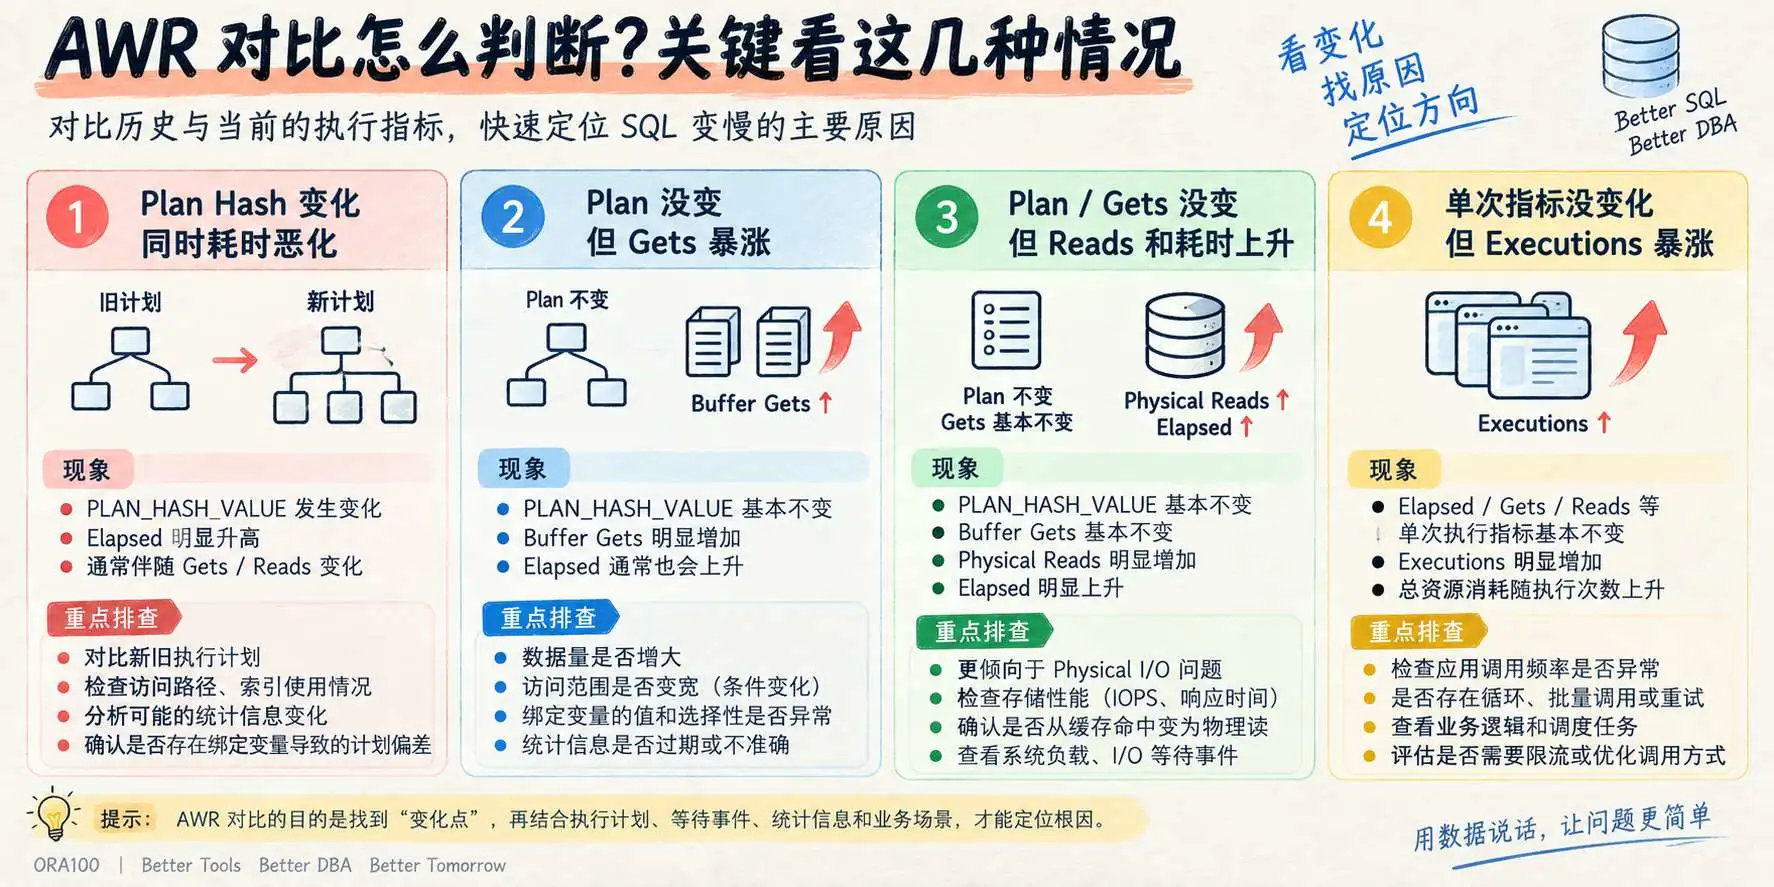
AWR 这一层最重要的是找到:到底哪个指标从什么时候开始发生变化。
如果前面的证据已经指向 SQL 自身访问量或访问路径,再看执行计划:
1SET LINES 3002SET PAGES 5003SET LONG 10000004SET LONGCHUNKSIZE 100000056SELECT *7FROM TABLE(8 DBMS_XPLAN.DISPLAY_CURSOR(9 '&sql_id',10 NULL,11 'ALLSTATS LAST +PEEKED_BINDS +PREDICATE +ALIAS'12 )13);我主要看:
1Access Predicate2Filter Predicate3E-Rows / A-Rows4Starts5Buffers / Reads6Peeked Binds表面上出现 INDEX RANGE SCAN 不代表访问路径一定合理。真正要看的是 Oracle 用什么条件进入索引,又有哪些条件被留到回表以后才过滤。
E-Rows / A-Rows 也很重要。如果 CBO 估算几十行,实际却返回几十万行,说明基数估算已经明显失真,这时候下一步应该先查 Stats、Histogram、Bind 或列相关性,而不是直接开始建索引。
ALLSTATS LAST只有在实际执行统计被采集时才能看到完整的 A-Rows、Buffers 等信息。如果没有采集到,不要把缺失值当成 0,先利用现有的 E-Rows、Predicate、Peeked Binds 和其他运行数据继续分析。
如果执行计划估算明显不对,先查表统计信息:
1SET LINES 3002SET PAGES 20034SELECT owner,5 table_name,6 num_rows,7 blocks,8 avg_row_len,9 stale_stats,10 stattype_locked,11 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI:SS') last_analyzed12FROM dba_tab_statistics13WHERE owner='&owner'14 AND table_name='&table_name'15 AND object_type='TABLE';重点看 NUM_ROWS、BLOCKS、LAST_ANALYZED、STALE_STATS 和 STATTYPE_LOCKED。如果 CBO 仍然拿着明显过期的数据规模和分布做成本估算,计划出现偏差并不奇怪。
Stats 没明显问题,再把现有索引摊开:
1SET LINES 3002SET PAGES 30034SELECT i.index_name,5 i.uniqueness,6 i.status,7 i.degree,8 ic.column_position,9 ic.column_name10FROM dba_indexes i11JOIN dba_ind_columns ic12 ON ic.index_owner=i.owner13 AND ic.index_name=i.index_name14WHERE i.table_owner='&owner'15 AND i.table_name='&table_name'16ORDER BY i.index_name,17 ic.column_position;再看真正参与过滤的字段:
1SELECT column_name,2 num_distinct,3 num_nulls,4 density,5 histogram,6 num_buckets,7 sample_size,8 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI') last_analyzed9FROM dba_tab_col_statistics10WHERE owner='&owner'11 AND table_name='&table_name'12ORDER BY column_name;这里真正要回答的不是“有没有索引”,而是索引列顺序是否匹配 SQL 的过滤方式,当前 Access Predicate 的选择性到底怎么样。
如果 SQL 使用 Bind Variable,还要把实际捕获到的 Bind 一起看:
1SET LINES 3002SET PAGES 30034SELECT inst_id,5 sql_id,6 child_number,7 name,8 position,9 datatype_string,10 value_string,11 TO_CHAR(last_captured,'YYYY-MM-DD HH24:MI:SS') last_captured12FROM gv$sql_bind_capture13WHERE sql_id='&sql_id'14ORDER BY inst_id,15 child_number,16 position;同一条时间范围 SQL,查一天和查三个月,SQL_ID 可以完全一样,实际扫描量却不是一回事。自己构造测试 SQL 时,Bind 尽量还原业务现场。
到这里,优化方向通常已经比较清楚:Stats 失真就处理统计信息;访问路径不合理再考虑索引;扫描范围本身太大就考虑 SQL 改写、分区裁剪或者业务侧缩小范围;如果 SQL 本身读得不多,真正耗时来自 Blocking、RAC 或 I/O 等待,就应该处理对应等待,而不是继续加索引。
真正实施变更以后,不需要重新发明一套验收方法,直接回到文章最开始那几个指标:
1SELECT inst_id,2 sql_id,3 child_number,4 plan_hash_value,5 executions,6 ROUND(disk_reads/NULLIF(executions,0)) reads_per_exec,7 ROUND(buffer_gets/NULLIF(executions,0)) gets_per_exec,8 ROUND(rows_processed/NULLIF(executions,0)) rows_per_exec,9 ROUND(elapsed_time/1e6/NULLIF(executions,0),2) elapsed_per_exec_s,10 ROUND(cpu_time/1e6/NULLIF(executions,0),2) cpu_per_exec_s,11 TO_CHAR(last_active_time,'YYYY-MM-DD HH24:MI:SS') last_active12FROM gv$sql13WHERE sql_id='&sql_id'14ORDER BY inst_id,child_number;前后至少对比:
1Plan Hash2Reads/Exec3Gets/Exec4Rows/Exec5Elapsed/Exec例如:
Explain Plan 变好了不算结束,手工测试变快也不能完全代表业务现场。条件允许的话,等真实业务再次执行以后,再从 GV$SQL 或 AWR 验证一次,结果才更有说服力。
如果把整套过程压成一条线,就是:
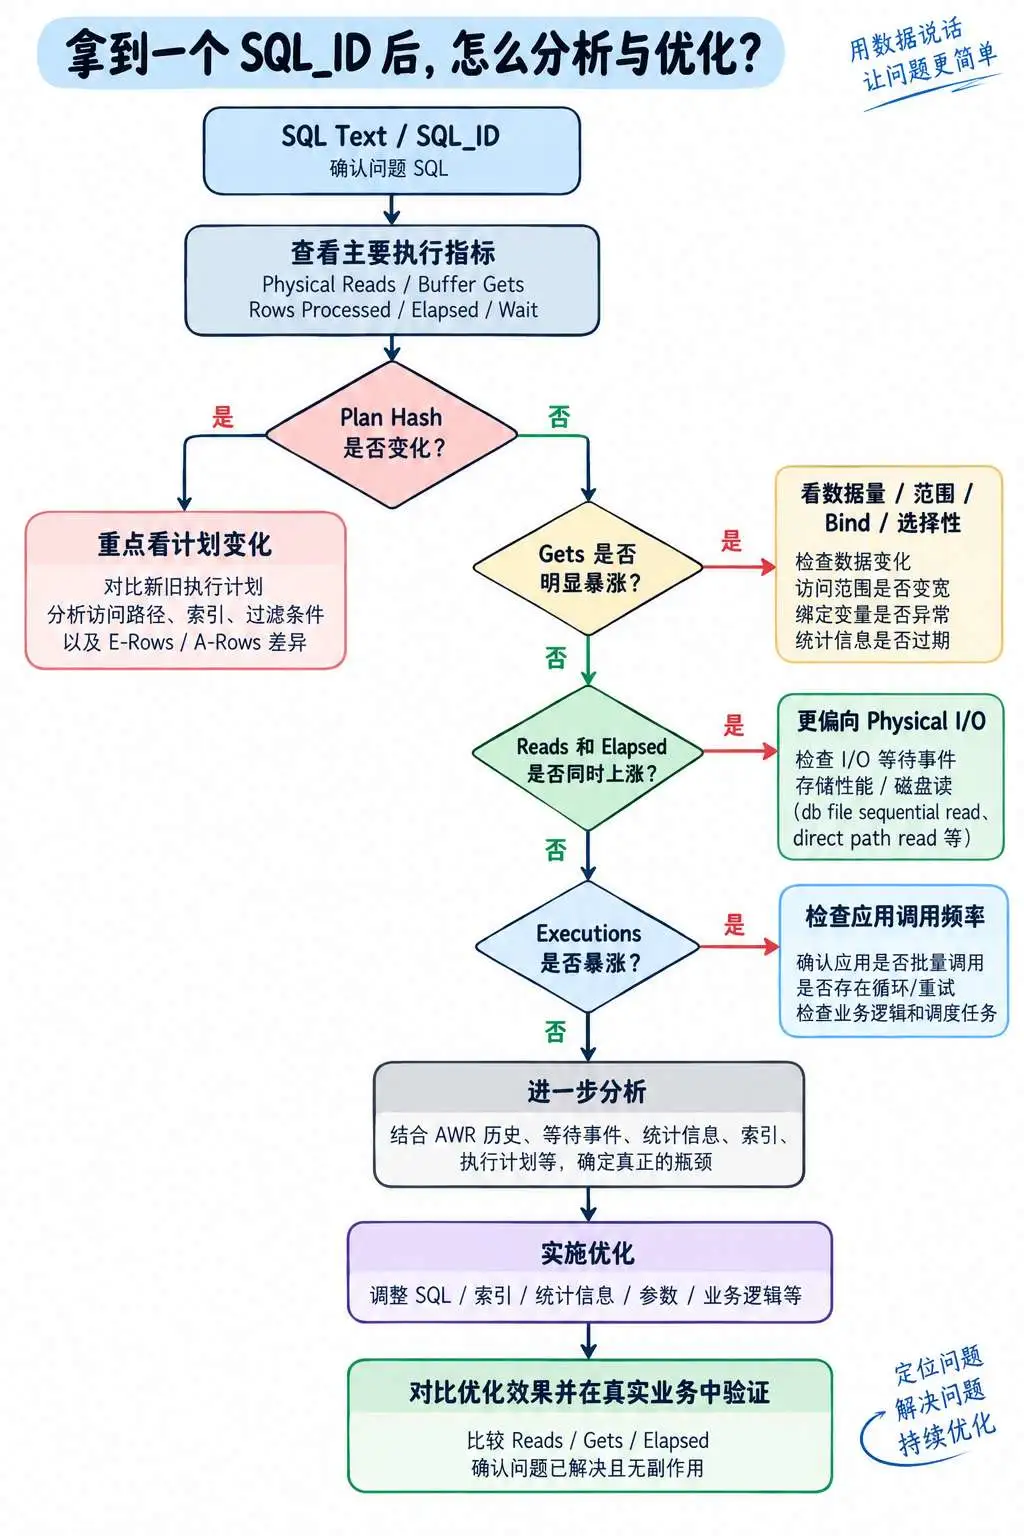
SQL 优化真正重要的不是最后用了哪一种手段,而是前面的证据链能不能说明:它为什么慢、为什么这样改,以及改完以后到底改善了多少。