运维管理23 分钟阅读
Oracle 11g RAC 异机恢复实战(漫画版)
2026年10月13日阅读—点赞—收藏—
OracleRAC
在知识库中专注阅读,并随时返回相关工具与课程
节后刚到公司,业务那边就来了一个需求:有一套测试库的数据太老了,需要从生产库恢复一份数据过去。
生产库和测试库都是 Oracle 11g RAC,准备使用 RMAN DUPLICATE 完成恢复。原本以为很简单,就是清理旧库、恢复数据、配置 RAC,没想到过程中还是遇到了几个问题:
好在最后都解决了,两个实例正常 OPEN,完整启停测试也顺利通过。
这类生产库恢复到测试环境的需求应该挺常见,索性就把这次从旧库清理、RMAN 恢复到 RAC 重建的完整操作过程记录下来,方便以后遇到类似需求时直接参考。
先看一下环境:
目标端 Oracle Home:
1/u01/app/oracle/product/11.2.0/dbhome_1RMAN 备份目录:
1/backup/rman本次采用 Backup-Based DUPLICATE,直接使用已有的 RMAN 备份恢复,不需要连接生产库。
主要分为三个步骤:
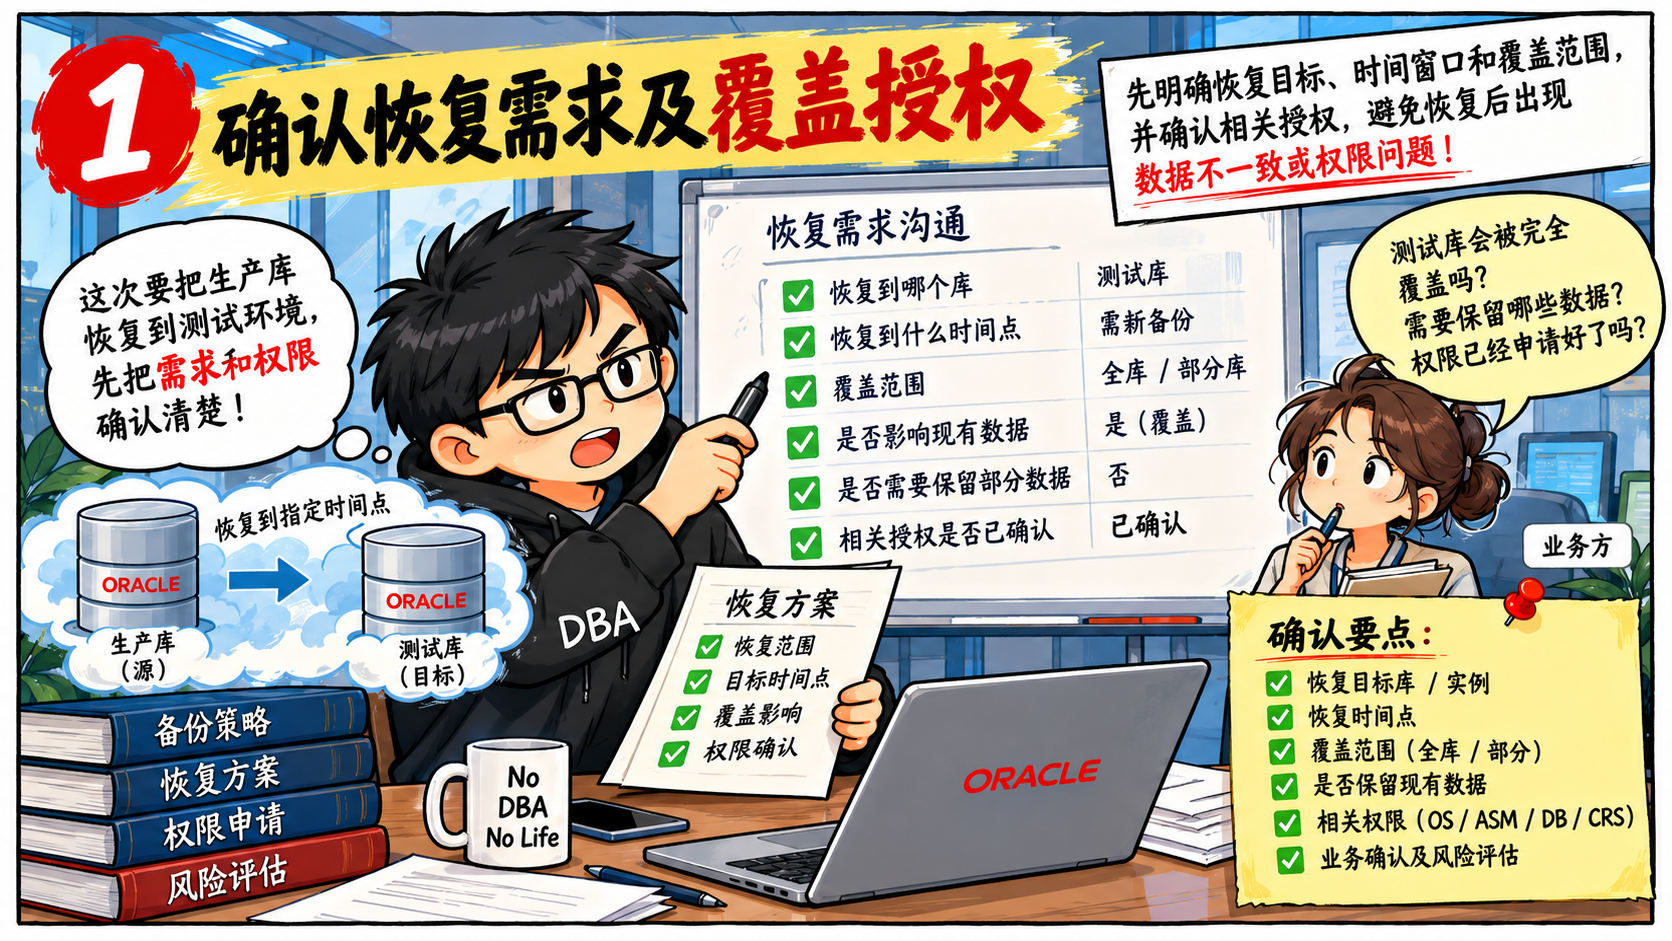
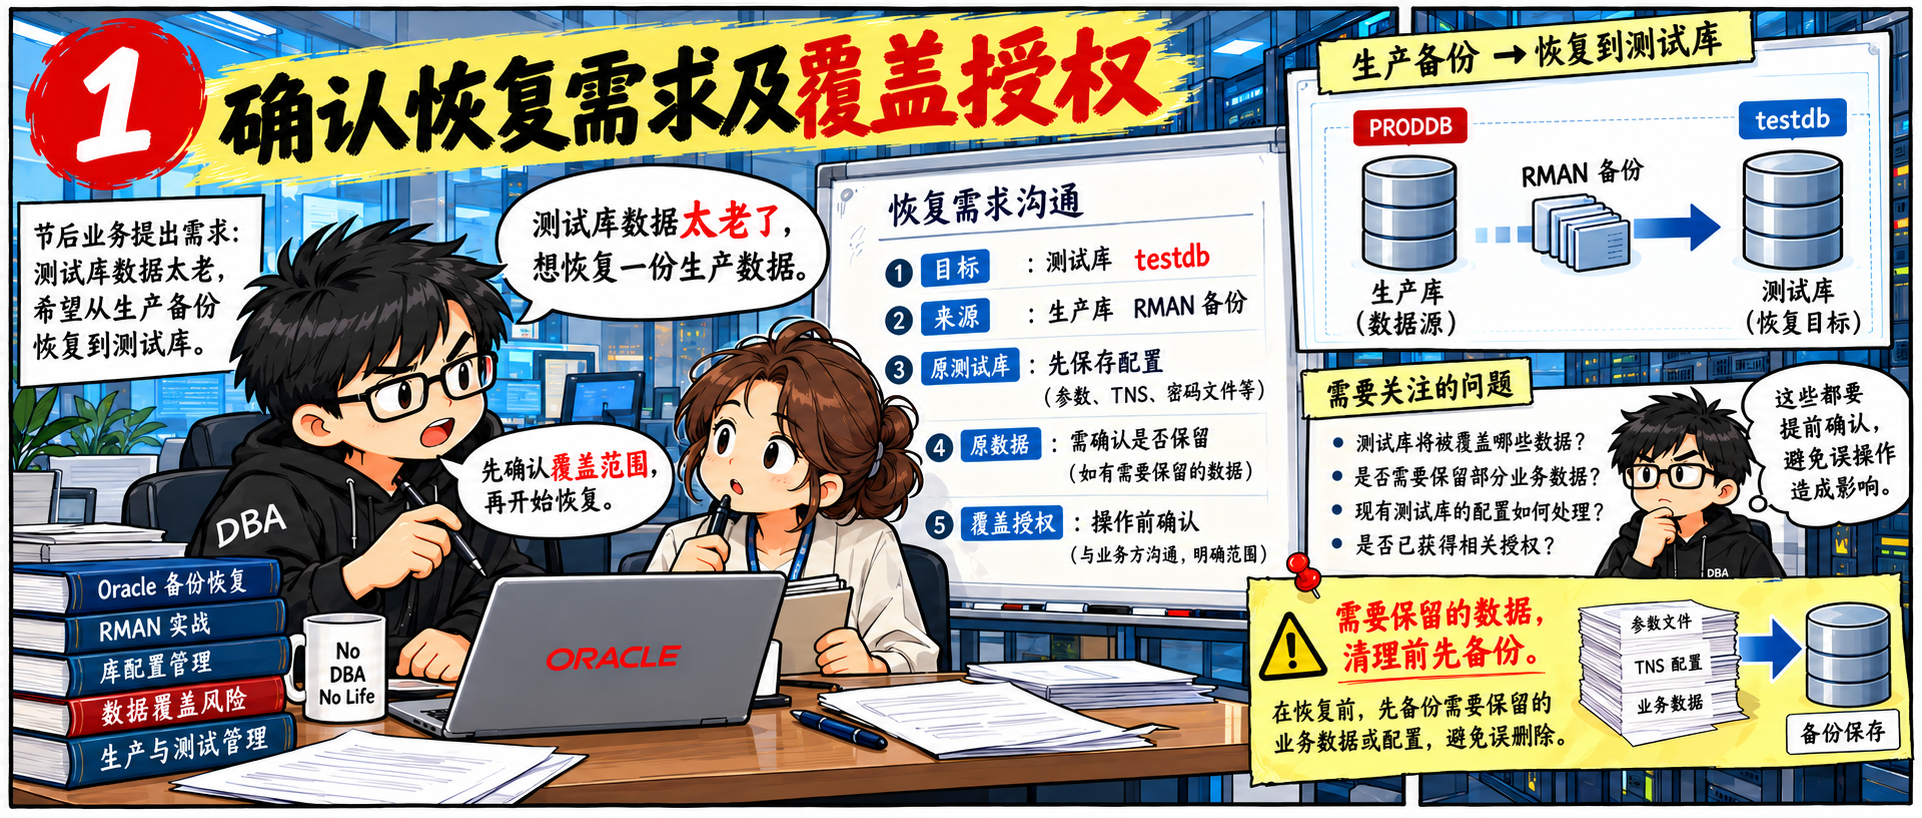
源端和目标端的 DB_NAME 均为 PRODDB,目标端使用独立的 DB_UNIQUE_NAME:testdb。
这套生产库的 RMAN 备份是通过 NFS 挂载到目标服务器作为存储,先检查:
1df -h /backup/rman2mount | grep /backup3ls -ld /backup/rman4ls -lh /backup/rman | head确认 Oracle 用户可以正常读取备份文件,并检查数据文件、控制文件及归档日志备份是否齐全。
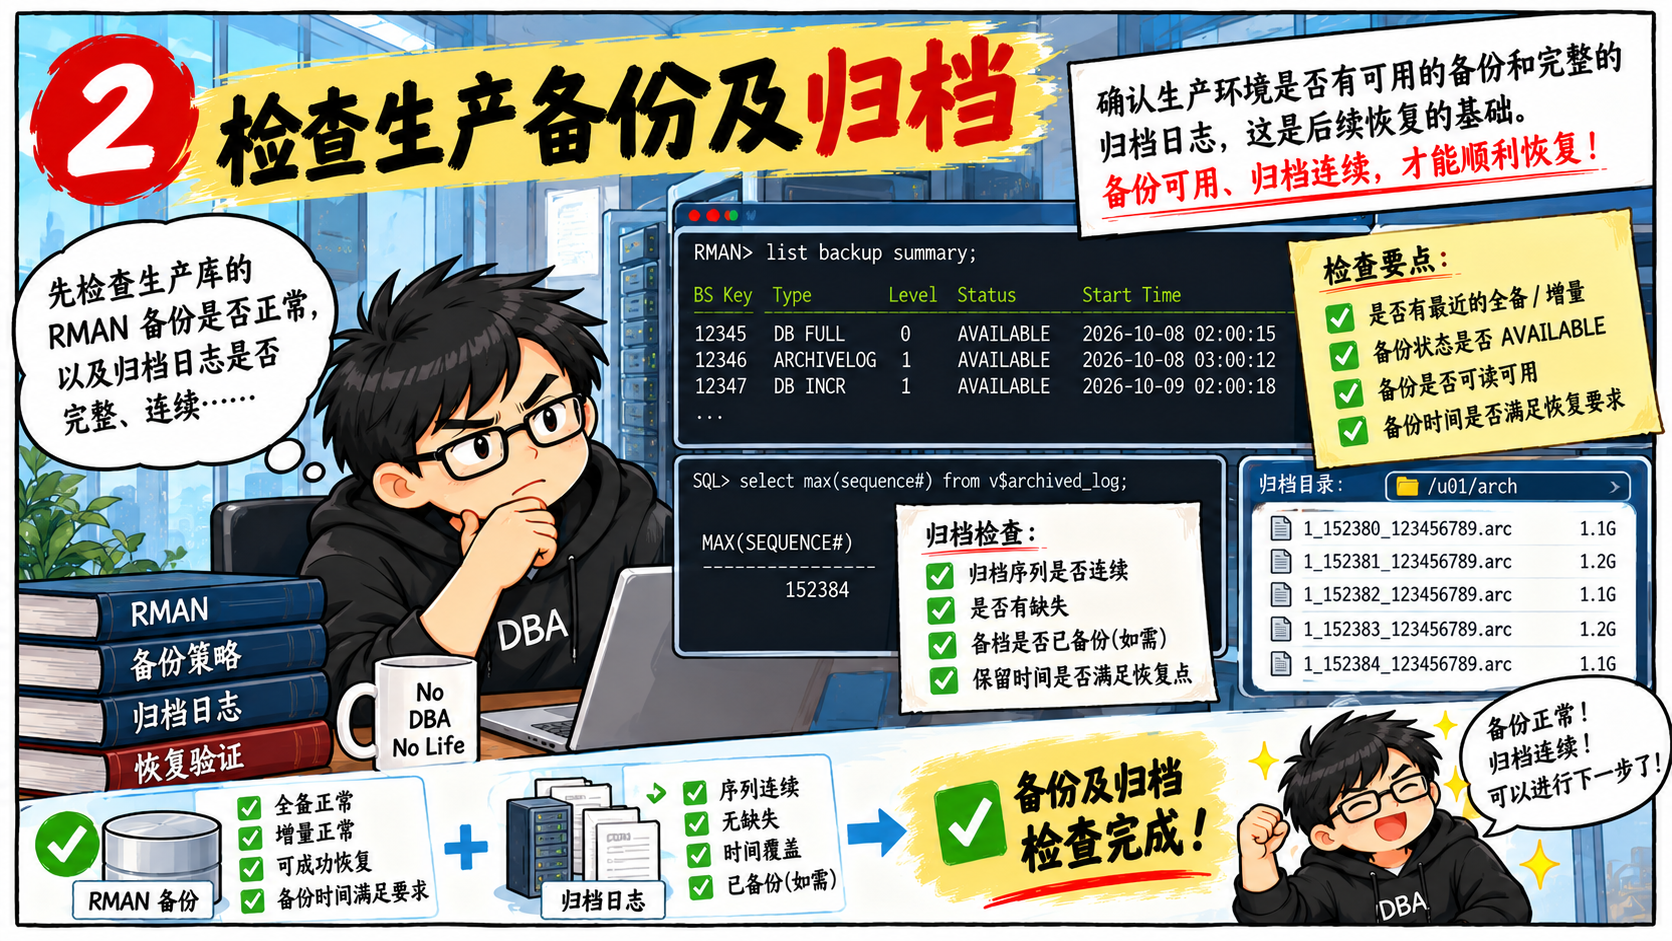
如果可以连接源库,可通过 RMAN 查看备份信息:
1LIST BACKUP SUMMARY;2LIST BACKUP OF DATABASE;3LIST BACKUP OF ARCHIVELOG ALL;本次使用 Level 0 备份,结合归档日志恢复,最终恢复至 SCN 73594150946。
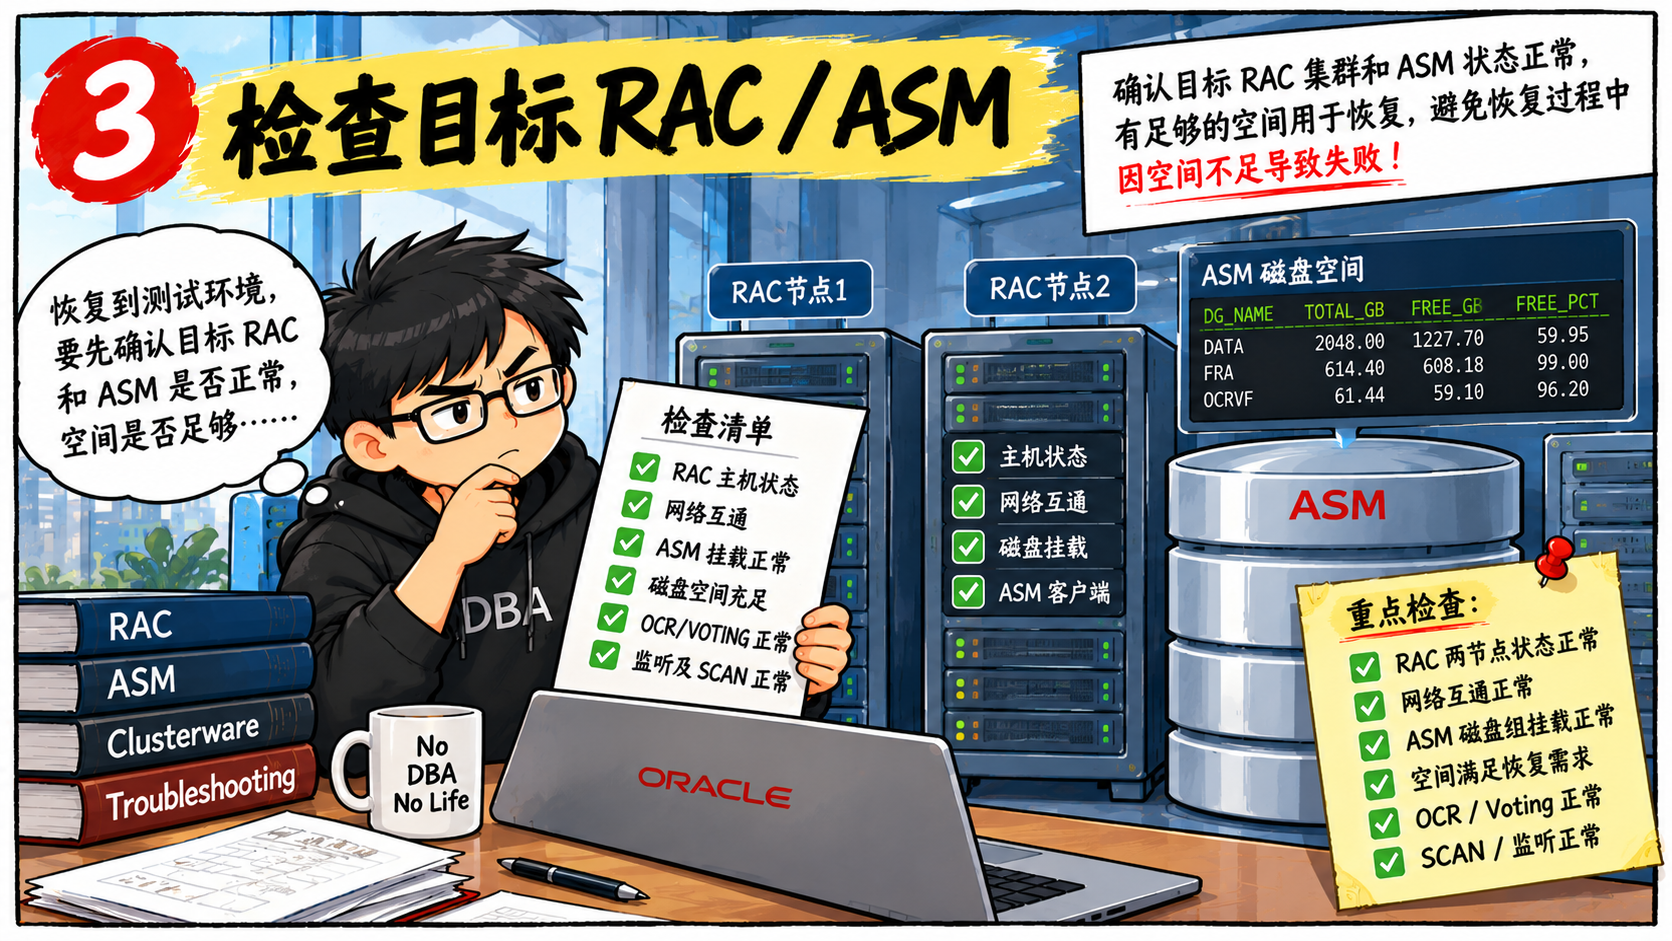
首先确认目标 RAC 环境正常,使用 grid 用户执行:
1crsctl stat res -t重点检查 ASM、监听、VIP、SCAN 等资源,再检查 ASM 磁盘组:
1asmcmd lsdg确认 +DATA、+FRA 正常挂载,并且有足够的可用空间,需要注意:ASM 磁盘组的 Free_MB 不一定等于实际可用空间,特别是 NORMAL、HIGH 冗余磁盘组,还要关注 Usable_file_MB。
接着查看当前 Clusterware 中注册的数据库:
1srvctl config database如果已经存在 testdb,还需要进一步检查:
1srvctl config database -d testdb -a2srvctl status database -d testdb3srvctl config service -d testdb这次目标端原本就有一套测试数据库,所以不能直接启动 DUPLICATE,必须先处理旧数据库。
两个节点都要确认 Oracle Home 和软件版本:
1echo $ORACLE_HOME2echo $ORACLE_SID3which sqlplus4which rman5sqlplus -v本次使用 Oracle 11.2.0.4,恢复阶段先在第一个节点操作:
1export ORACLE_HOME=/u01/app/oracle/product/11.2.0/dbhome_12export ORACLE_SID=testdb13export PATH=$ORACLE_HOME/bin:$PATH第二节点后续使用:
1export ORACLE_SID=testdb2目标端已有一套测试 RAC,本次需要使用生产数据重新恢复,因此需要先清理原测试库,保留现有 GI、ASM 和监听环境,再执行 RMAN DUPLICATE。
先连接旧测试数据库:
1sqlplus / as sysdba检查数据库身份:
1SELECT name,2 db_unique_name,3 dbid,4 open_mode5FROM v$database;检查 RAC 实例:
1SELECT inst_id,2 instance_name,3 host_name,4 status5FROM gv$instance6ORDER BY inst_id;保存 SPFILE 和控制文件位置:
1SHOW PARAMETER spfile;2SHOW PARAMETER control_files;查询数据文件:
1SELECT file#, name2FROM v$datafile3ORDER BY file#;查询临时文件:
1SELECT file#, name2FROM v$tempfile3ORDER BY file#;查询 REDO:
1SELECT group#, member2FROM v$logfile3ORDER BY group#;提前记录原测试库的数据文件、控制文件和 REDO 路径,方便后续清理 ASM 文件时核对,避免误删其他数据库文件。

先导出参数文件:
1CREATE PFILE='/home/oracle/init_testdb_before_rebuild.ora'2FROM SPFILE;再保存 Clusterware 配置:
1srvctl config database -d testdb -a \2 > /home/oracle/testdb_srvctl_before_rebuild.txt如果原测试库的数据还需要保留,应提前做好备份,避免清理后无法恢复。
确认旧测试库已停用、数据允许覆盖后,停止数据库:
1srvctl stop database -d testdb -o immediate检查:
1srvctl status database -d testdb确认两个实例均已停止:
1Instance testdb1 is not running on node rac-test012Instance testdb2 is not running on node rac-test02两个节点分别检查 PMON 进程:
1ps -ef | grep '[p]mon'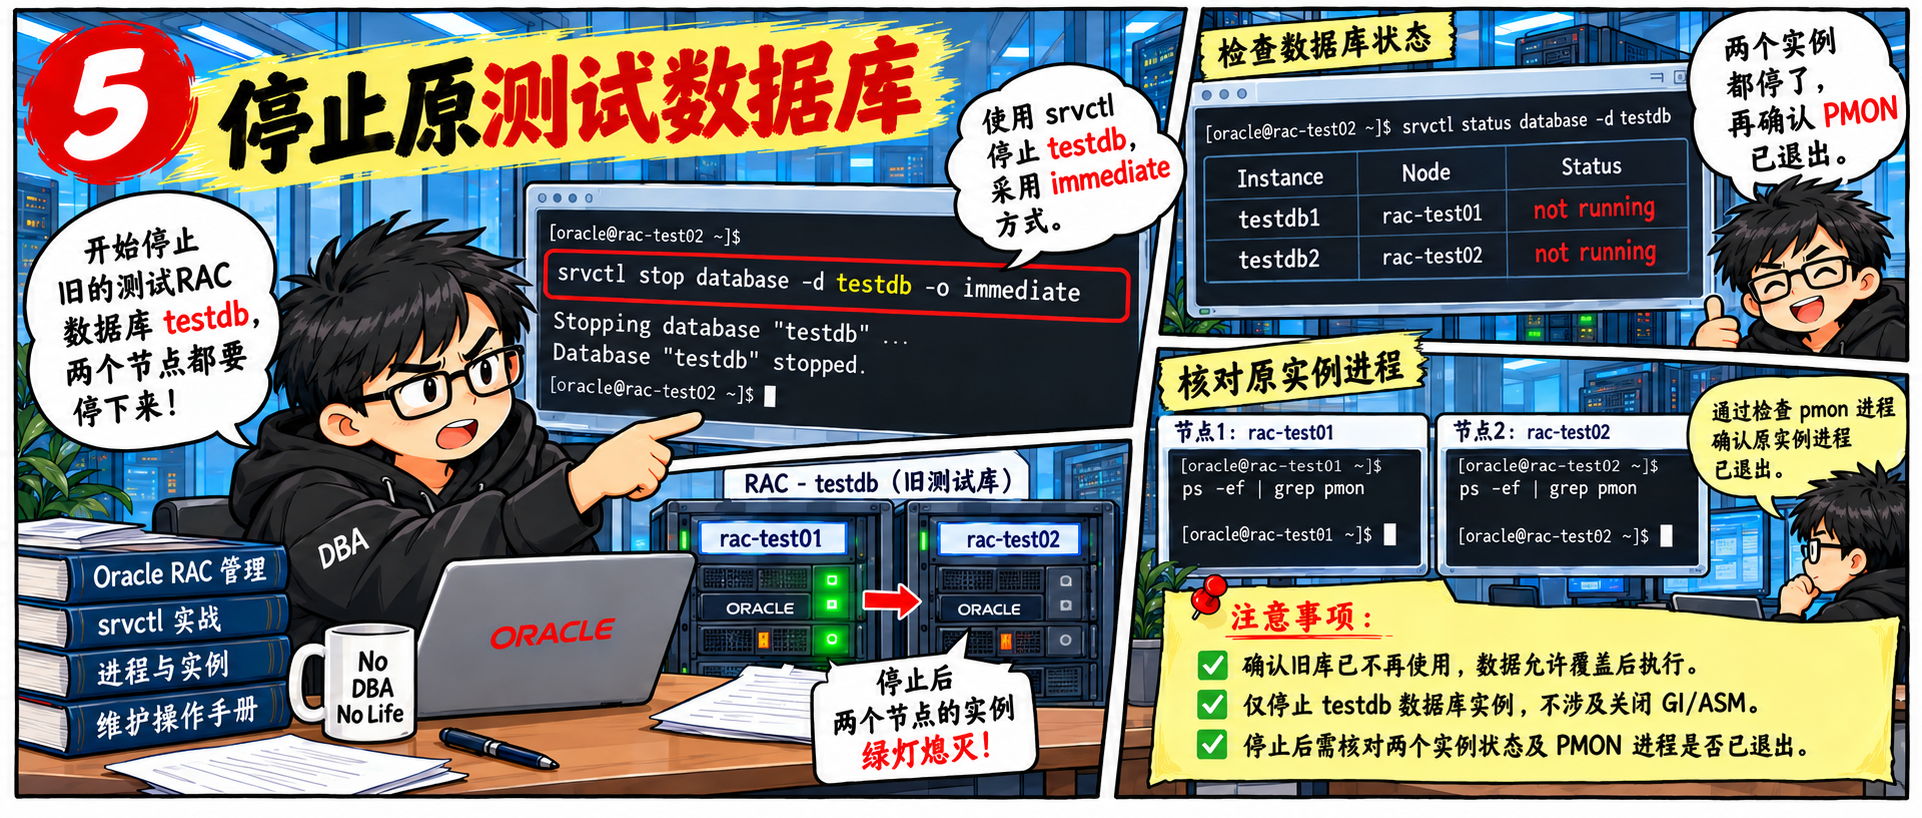
确认原实例已退出。
注销旧数据库的 Clusterware 资源:
1srvctl remove database -d testdb2srvctl config database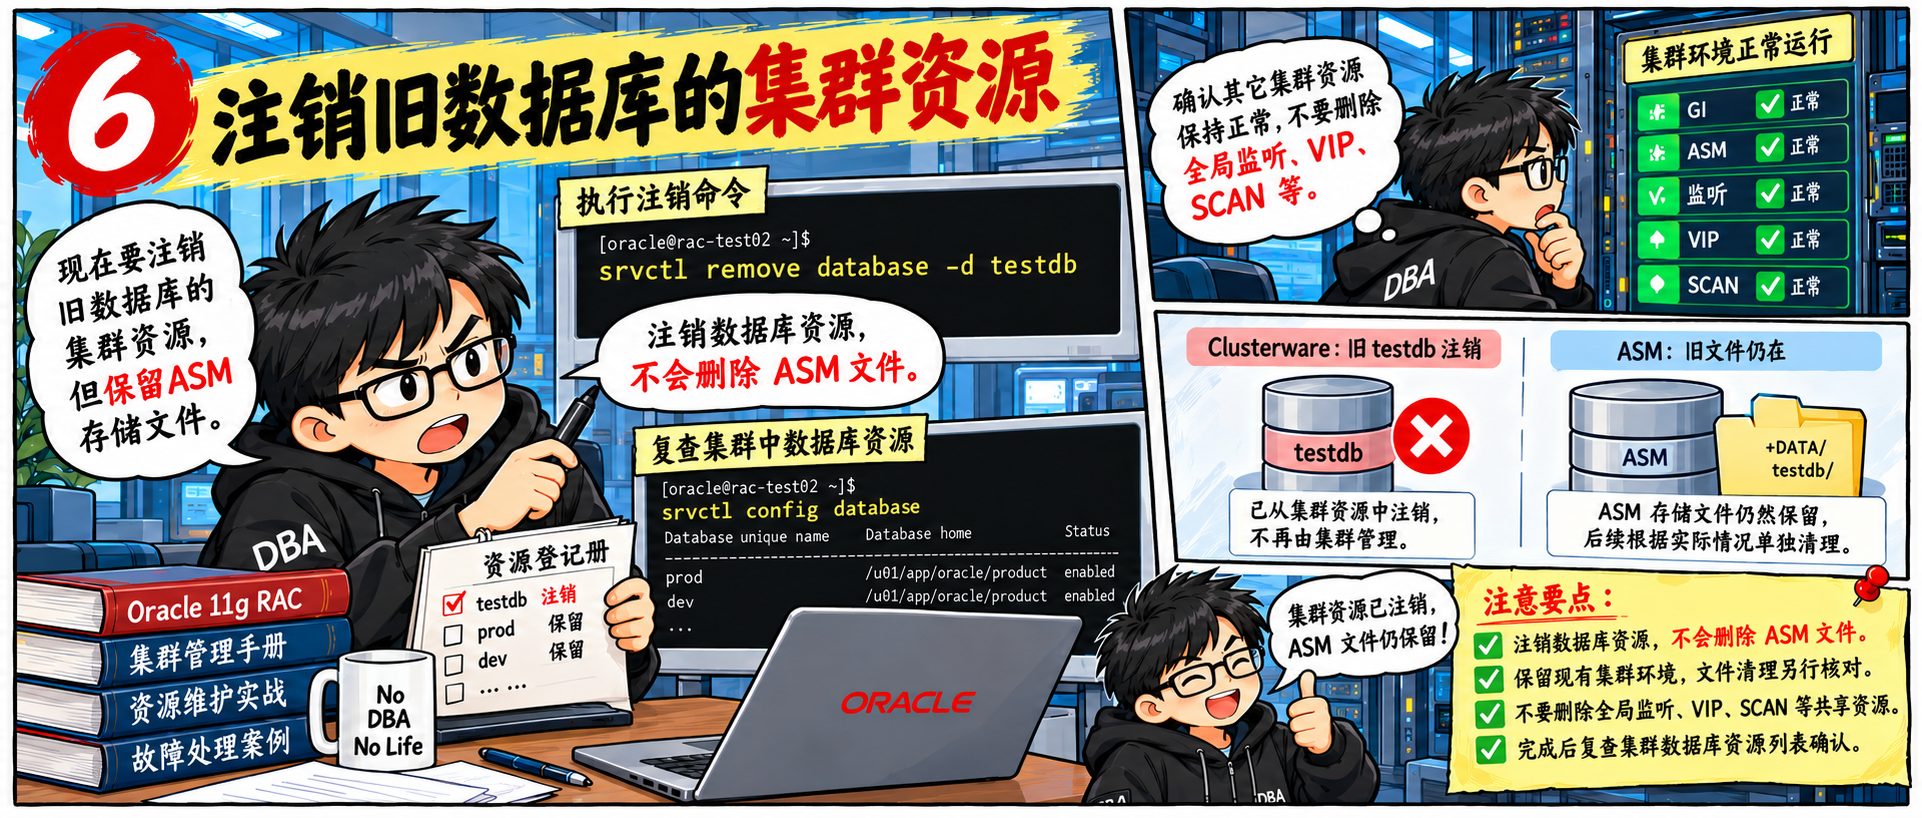
确认 testdb 已注销。注意,srvctl remove database 不会删除 ASM 中的数据文件。
使用 grid 用户:
1asmcmd lsdg2asmcmd ls +DATA/3asmcmd ls +FRA/查看旧数据库目录:
1asmcmd ls -l +DATA/TESTDB/2asmcmd ls -l +FRA/TESTDB/结合前面记录的控制文件、数据文件和 REDO 路径,逐一核对待清理文件的归属。
确认文件已废弃且没有其他资源引用后,再执行:
1asmcmd rm <已确认废弃文件的完整ASM路径>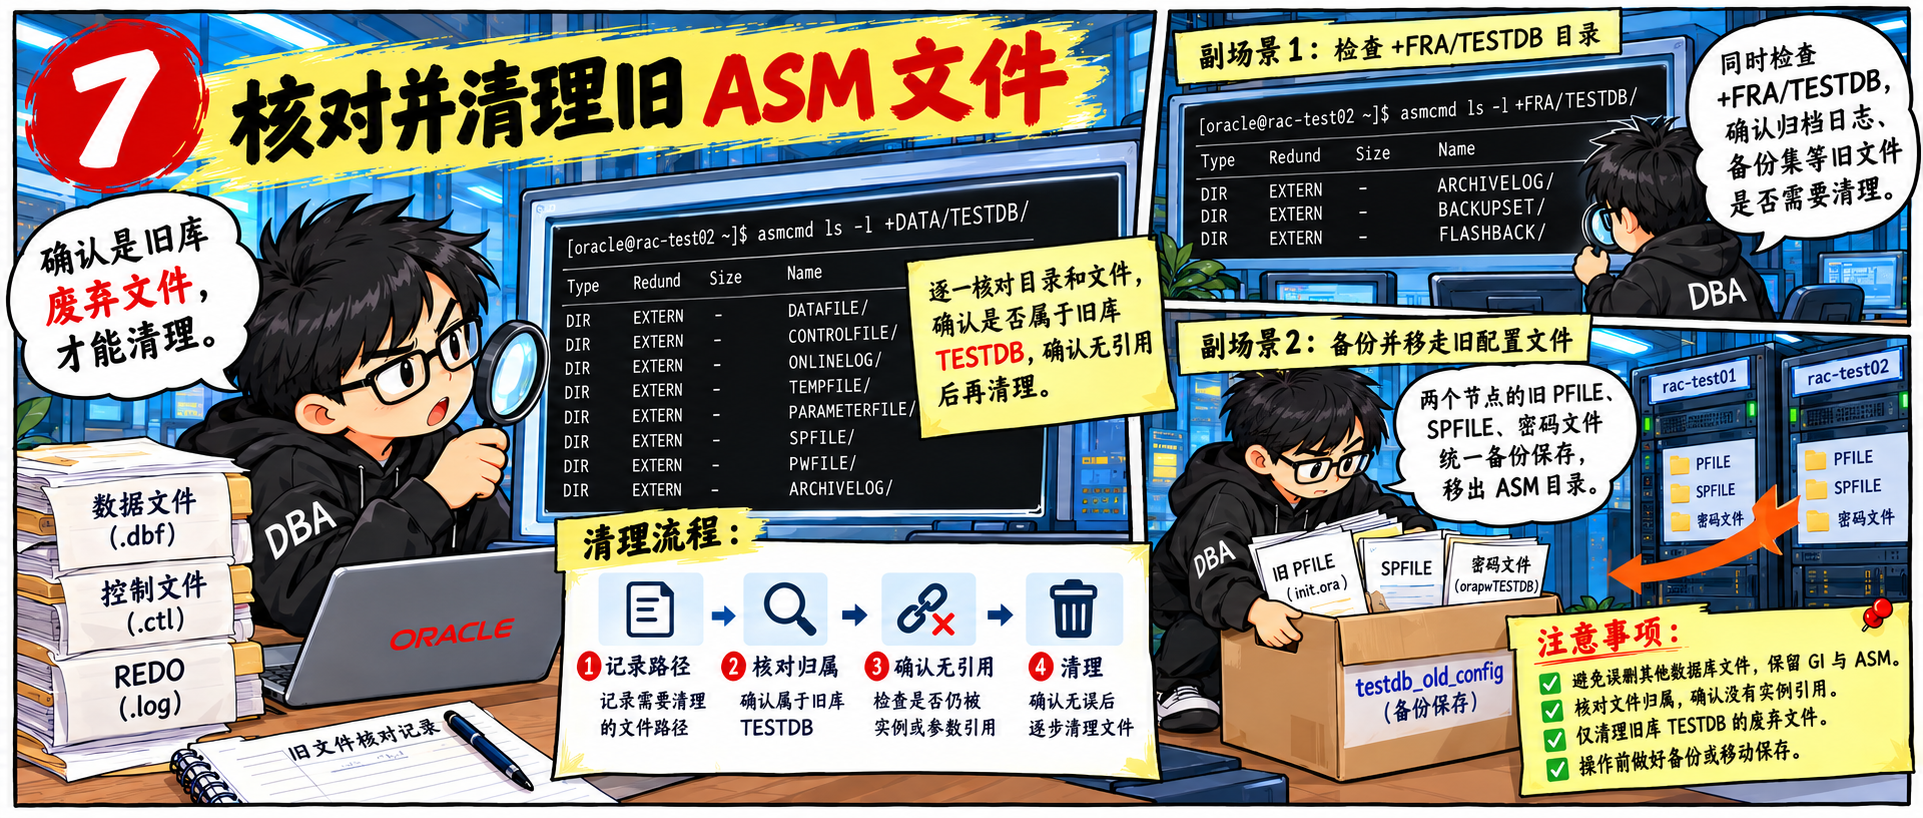
清理 ASM 文件前,建议先确认好文件的归属,避免误删。也可以根据实际情况使用 RMAN DROP DATABASE 删除旧库,但要确保不影响现有 GI、ASM、监听、VIP 和 SCAN 等集群资源。
两个节点分别检查:
1ls -l $ORACLE_HOME/dbs/*testdb*主要关注:
1inittestdb1.ora2inittestdb2.ora3spfiletestdb1.ora4orapwtestdb15orapwtestdb2先备份旧配置:
1mkdir -p /home/oracle/testdb_old_config将旧 PFILE、SPFILE 和密码文件移入备份目录,核实后再清理原文件。
清理完成后,再确认:
1srvctl config database2crsctl stat res -t3asmcmd lsdg确认旧库已清理,GI 和 ASM 正常,准备恢复。
在第一个节点准备 RMAN 辅助实例,恢复阶段暂不启用 RAC。

使用 oracle 用户:
1export ORACLE_HOME=/u01/app/oracle/product/11.2.0/dbhome_12export ORACLE_SID=testdb13export PATH=$ORACLE_HOME/bin:$PATH创建初始化参数文件:
1vi $ORACLE_HOME/dbs/inittestdb1.ora2## 写入以下内容3db_name='PRODDB'4db_unique_name='testdb'5instance_name='testdb1'6cluster_database=FALSE7db_create_file_dest='+DATA'8db_recovery_file_dest='+FRA'9db_recovery_file_dest_size=100G10diagnostic_dest='/u01/app/oracle'11audit_file_dest='/u01/app/oracle/admin/testdb/adump'12job_queue_processes=0以上为参考参数,FRA 大小、内存及兼容性参数按实际环境调整;db_name 必须与源库备份一致。
1mkdir -p /u01/app/oracle/admin/testdb/adump2chmod 750 /u01/app/oracle/admin/testdb/adump两个节点都需要创建审计目录,后面遇到的 ORA-09925 就与此有关。
1sqlplus / as sysdba执行:
1STARTUP NOMOUNT2PFILE='/u01/app/oracle/product/11.2.0/dbhome_1/dbs/inittestdb1.ora';检查:
1SELECT instance_name, status2FROM v$instance;34INSTANCE_NAME STATUS5------------- -------6testdb1 STARTED辅助实例处于 STARTED(NOMOUNT)即可,后续由 RMAN 完成恢复。
这里采用 Backup-Based DUPLICATE,直接通过 RMAN 备份恢复,无需连接生产库。
恢复前确认备份目录、源库 DBID、数据文件及控制文件路径,以及归档日志和目标恢复 SCN。
本次分配 4 个辅助通道,共恢复 59 个数据文件,最终恢复至 SCN 73594150946,并通过 RESETLOGS 打开数据库。
以下为 RMAN DUPLICATE 参考脚本,实际执行时需根据备份信息、ASM 路径和目标恢复 SCN 调整。
先通过辅助实例连接 RMAN:
1rman auxiliary /参考脚本:
1RUN {2 ALLOCATE AUXILIARY CHANNEL a1 DEVICE TYPE DISK;3 ALLOCATE AUXILIARY CHANNEL a2 DEVICE TYPE DISK;4 ALLOCATE AUXILIARY CHANNEL a3 DEVICE TYPE DISK;5 ALLOCATE AUXILIARY CHANNEL a4 DEVICE TYPE DISK;67 DUPLICATE DATABASE 'PRODDB' DBID 12345678908 TO 'PRODDB'9 BACKUP LOCATION '/backup/rman'10 NOFILENAMECHECK;1112 RELEASE CHANNEL a1;13 RELEASE CHANNEL a2;14 RELEASE CHANNEL a3;15 RELEASE CHANNEL a4;16}该脚本仅供参考,实际执行前需确认 RMAN 语法、ASM 文件路径及恢复 SCN,避免覆盖其他数据库文件。
将 RMAN 脚本保存为:
1/home/oracle/duplicate_testdb.rman执行:
1rman auxiliary / \2 cmdfile=/home/oracle/duplicate_testdb.rman \3 log=/home/oracle/duplicate_testdb.log查看恢复日志:
1tail -f /home/oracle/duplicate_testdb.log重点查看数据文件恢复、归档应用及 RESETLOGS 是否成功。
RMAN 日志显示:
1database opened23Finished Duplicate Db45Recovery Manager complete.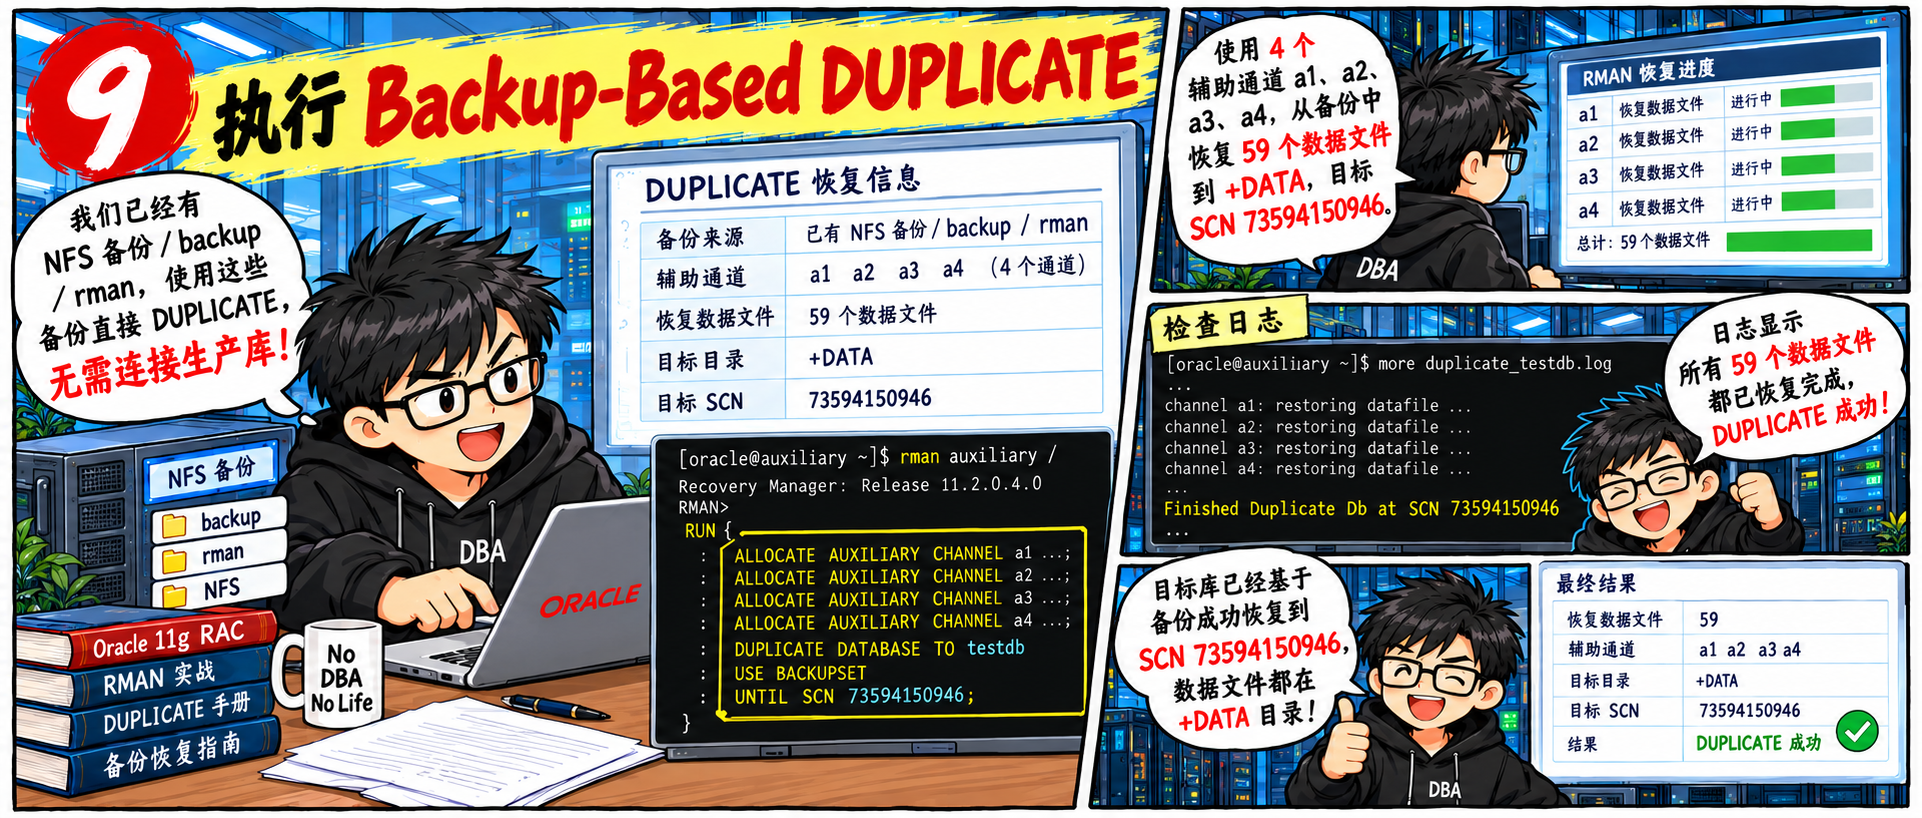
DUPLICATE 完成。
1SELECT name,2 db_unique_name,3 dbid,4 open_mode,5 database_role,6 resetlogs_time7FROM v$database;89NAME DB_UNIQUE_NAME OPEN_MODE DATABASE_ROLE10-------- -------------- ---------- -------------11PRODDB testdb READ WRITE PRIMARY确认目标库 DBID 已更新,再检查数据文件:
1SELECT file#, name, status2FROM v$datafile3ORDER BY file#;
确认数据文件已恢复至目标 ASM,接下来配置双节点 RAC。
恢复完成后,准备修改 RAC 参数:
1ALTER SYSTEM SET cluster_database=TRUE SCOPE=SPFILE SID='*';结果报错:
1ORA-01565: error in identifying file2ORA-27037: unable to obtain file status3Linux-x86_64 Error: 2: No such file or directory检查:
1SHOW PARAMETER spfile;发现当前实例引用的仍然是本地 SPFILE:
1/u01/app/oracle/product/11.2.0/dbhome_1/dbs/spfiletestdb1.ora但是操作系统上已经没有这个文件:
1ls -l $ORACLE_HOME/dbs/*testdb*实例虽然已经 OPEN,但引用的 SPFILE 文件不存在,导致无法写入参数。

重新创建 ASM 共享 SPFILE:
1CREATE SPFILE='+DATA/TESTDB/spfiletestdb.ora' FROM MEMORY;23File created.检查 ASM:
1asmcmd ls -l +DATA/TESTDB/spfiletestdb.ora在两个节点分别配置 PFILE,指向共享 ASM SPFILE。
rac-test01:
1cat > $ORACLE_HOME/dbs/inittestdb1.ora <<'EOF'2SPFILE='+DATA/TESTDB/spfiletestdb.ora'3EOFrac-test02:
1cat > $ORACLE_HOME/dbs/inittestdb2.ora <<'EOF'2SPFILE='+DATA/TESTDB/spfiletestdb.ora'3EOF新 SPFILE 不会自动生效,重启第一个实例:
1SHUTDOWN IMMEDIATE;2STARTUP;再次检查:
1SHOW PARAMETER spfile;确认已经指向:
1+DATA/TESTDB/spfiletestdb.ora确认 SPFILE 已切换。
接下来配置 RAC 参数。

1ALTER SYSTEM SET cluster_database=TRUE SCOPE=SPFILE SID='*';2ALTER SYSTEM SET cluster_database_instances=2 SCOPE=SPFILE SID='*';1ALTER SYSTEM SET instance_number=1 SCOPE=SPFILE SID='testdb1';2ALTER SYSTEM SET instance_number=2 SCOPE=SPFILE SID='testdb2';1ALTER SYSTEM SET thread=1 SCOPE=SPFILE SID='testdb1';2ALTER SYSTEM SET thread=2 SCOPE=SPFILE SID='testdb2';1ALTER SYSTEM SET undo_tablespace='UNDOTBS1' SCOPE=SPFILE SID='testdb1';2ALTER SYSTEM SET undo_tablespace='UNDOTBS2' SCOPE=SPFILE SID='testdb2';由于数据库来自生产环境,暂时不允许自动执行原生产库的任务:
1ALTER SYSTEM SET job_queue_processes=0 SCOPE=SPFILE SID='*';检查:
1SELECT sid, name, value2FROM v$spparameter3WHERE name IN (4 'cluster_database',5 'cluster_database_instances',6 'instance_name',7 'instance_number',8 'thread',9 'undo_tablespace',10 'job_queue_processes'11)12AND isspecified = 'TRUE'13ORDER BY name, sid;1415*.instance_name = testdb1恢复阶段遗留了全局 instance_name,需要清理,避免第二节点继承。
执行:
1ALTER SYSTEM RESET instance_name SCOPE=SPFILE SID='*';同时清理全局 UNDO 参数:
1ALTER SYSTEM RESET undo_tablespace SCOPE=SPFILE SID='*';最终保留实例级配置:
1*.cluster_database TRUE2*.cluster_database_instances 23testdb1.instance_number 14testdb2.instance_number 25testdb1.thread 16testdb2.thread 27testdb1.undo_tablespace UNDOTBS18testdb2.undo_tablespace UNDOTBS29*.job_queue_processes 0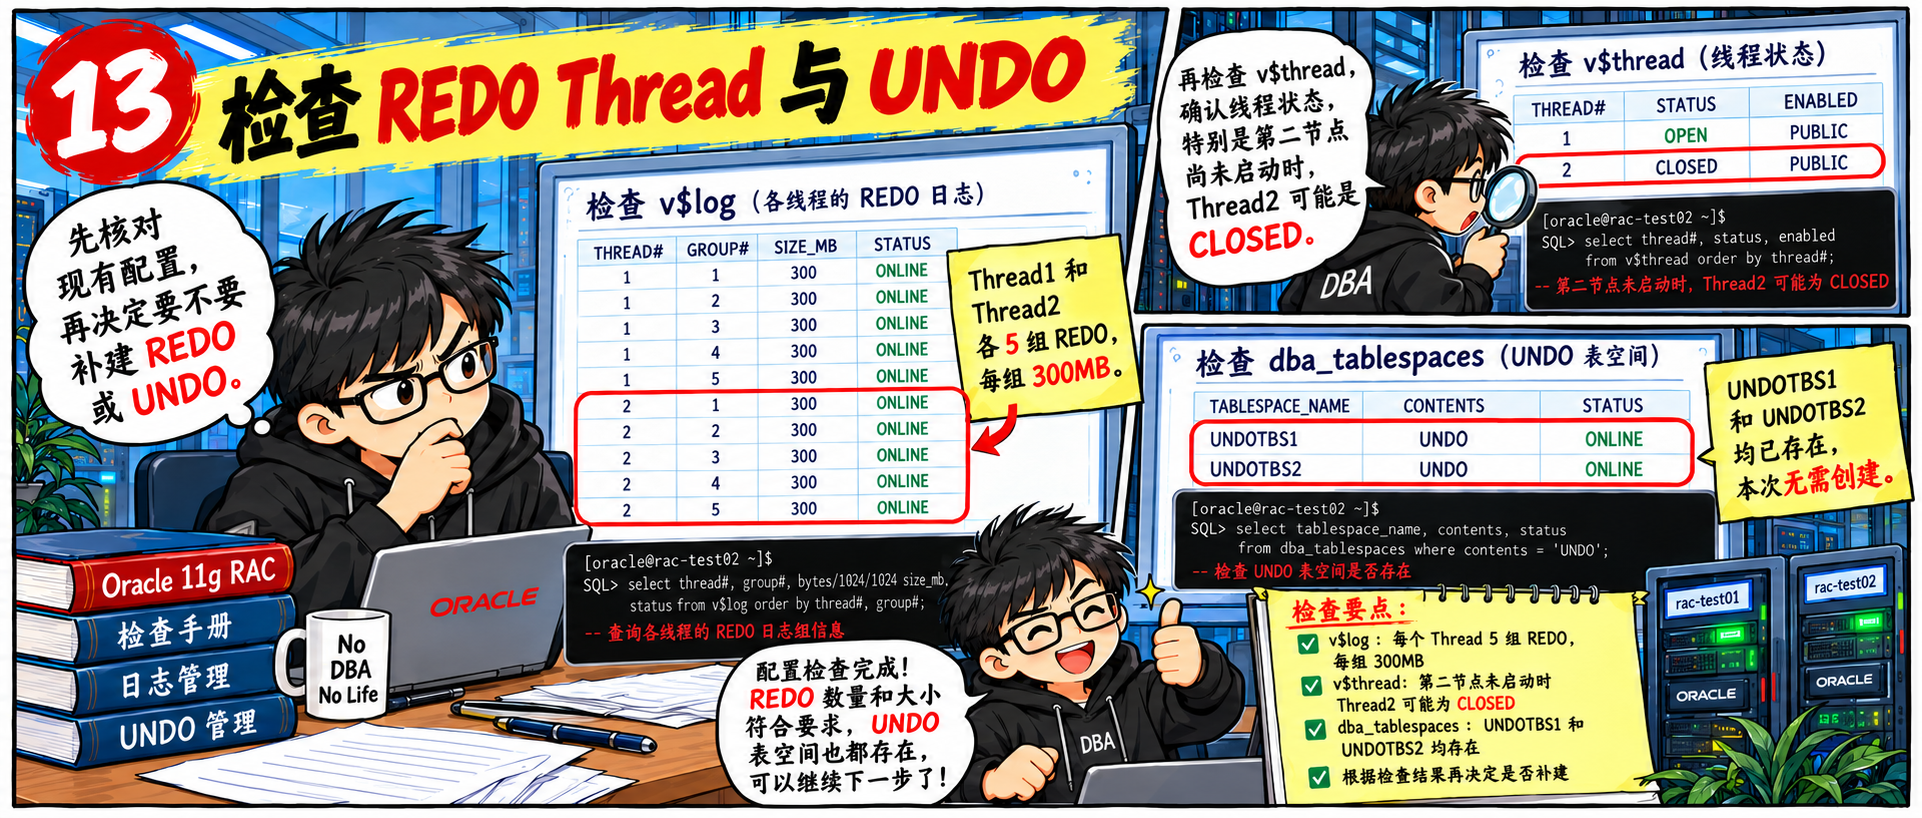
先检查 REDO:
1SELECT group#,2 thread#,3 bytes/1024/1024 mb,4 status5FROM v$log6ORDER BY thread#, group#;本次两个 Thread 均已配置,每个 Thread 5 组 REDO,每组 300MB。
检查:
1SELECT thread#, status, enabled2FROM v$thread3ORDER BY thread#;第二节点尚未启动时,Thread 2 可能显示 CLOSED。
再检查 UNDO:
1SELECT tablespace_name, status2FROM dba_tablespaces3WHERE contents='UNDO';本次 REDO 和两个 UNDO 表空间均已存在,无需重新创建。
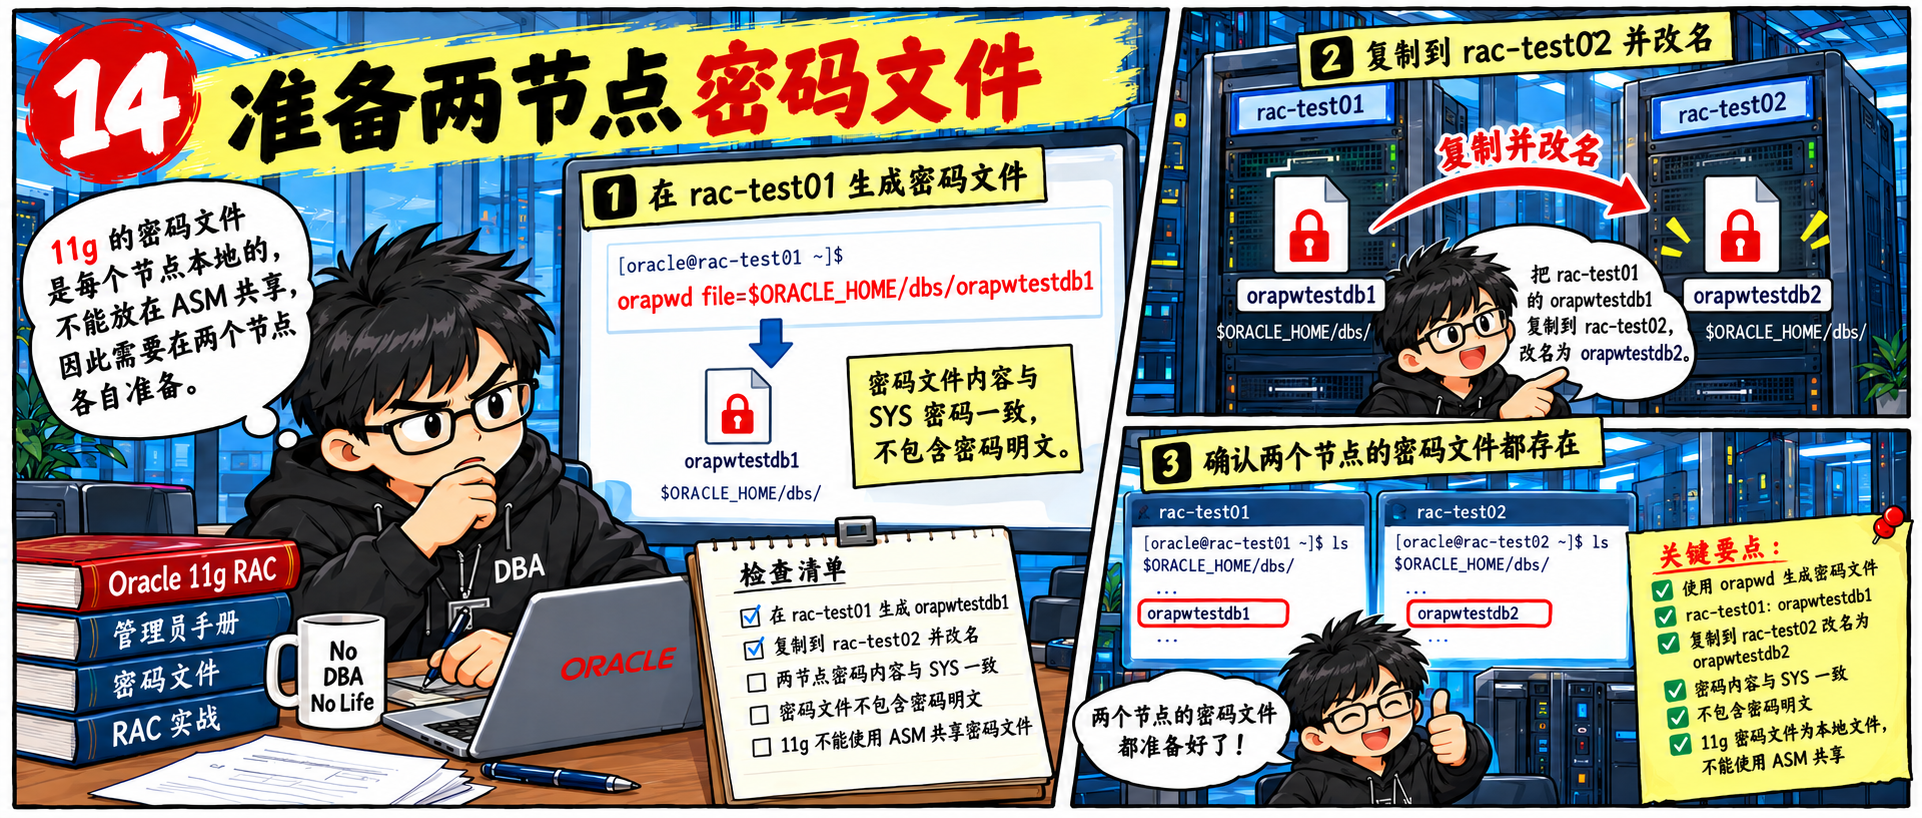
两个节点分别需要:
1rac-test01: $ORACLE_HOME/dbs/orapwtestdb12rac-test02: $ORACLE_HOME/dbs/orapwtestdb2使用 orapwd 创建密码文件,密码应与目标数据库 SYS 密码一致。
Oracle 11g 环境可以使用:
1orapwd file=$ORACLE_HOME/dbs/orapwtestdb1设置 SYS 密码后,将密码文件复制到第二节点并调整文件名,确保两个节点保持一致。
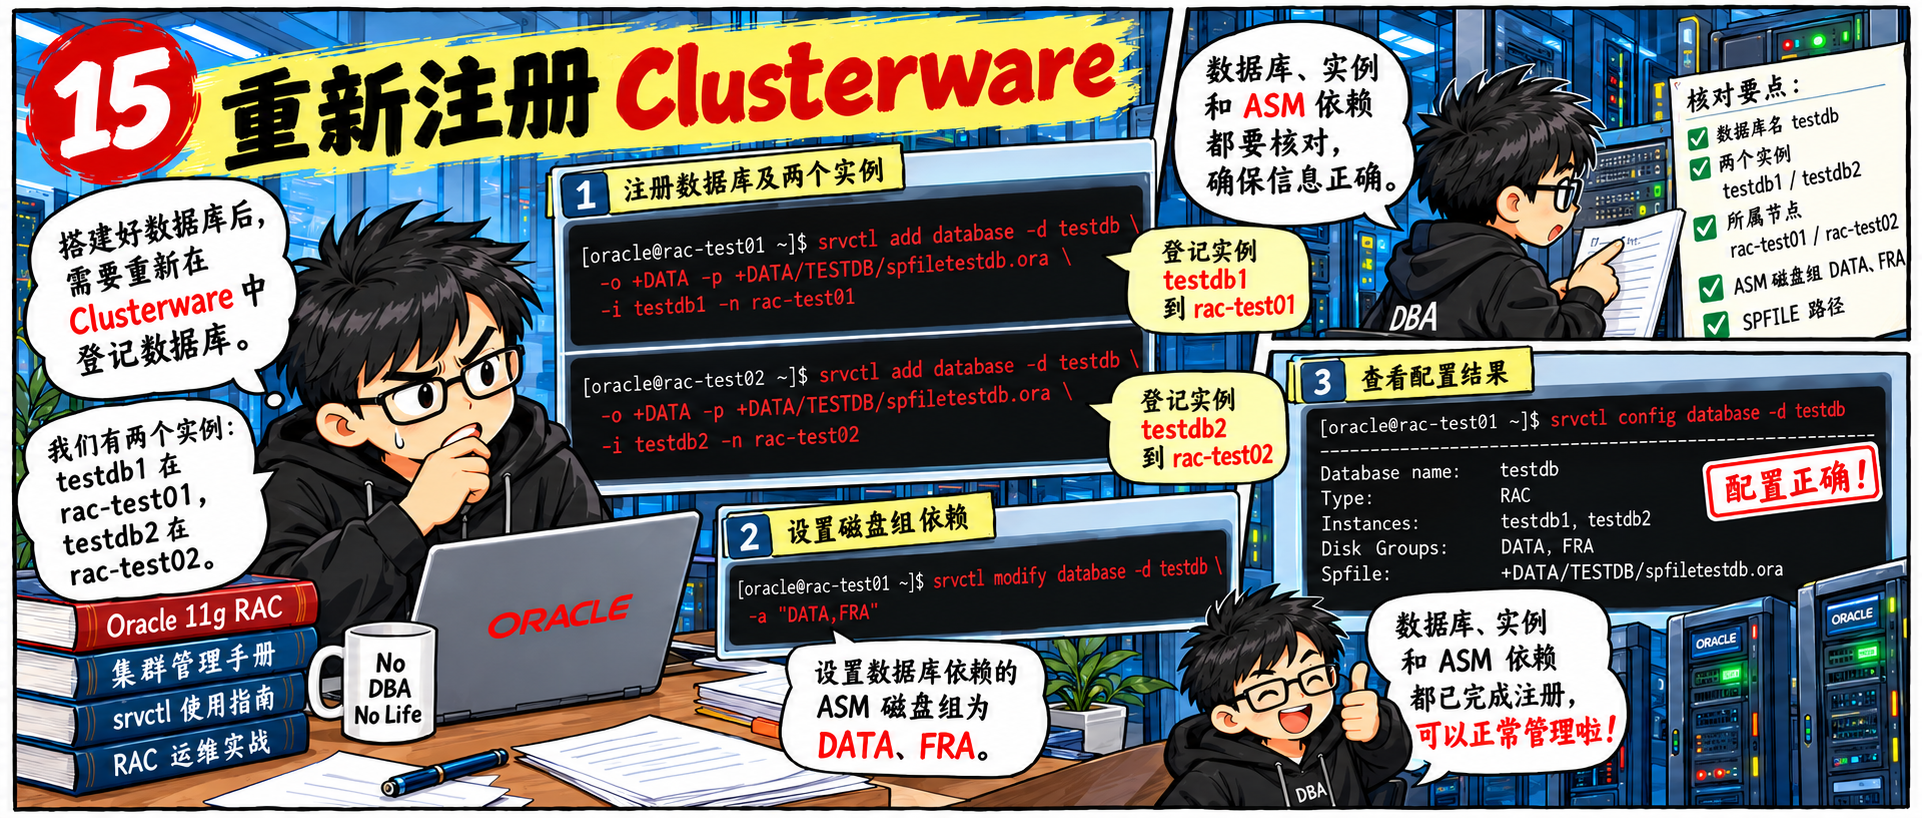
使用 oracle 用户执行:
1srvctl add database \2 -d testdb \3 -o /u01/app/oracle/product/11.2.0/dbhome_1 \4 -p +DATA/TESTDB/spfiletestdb.ora \5 -r PRIMARY \6 -s OPEN注册实例:
1srvctl add instance -d testdb -i testdb1 -n rac-test012srvctl add instance -d testdb -i testdb2 -n rac-test02添加 ASM 磁盘组依赖:
1srvctl modify database -d testdb -a "DATA,FRA"检查:
1srvctl config database -d testdb -a确认:
1Database unique name: testdb2Spfile: +DATA/TESTDB/spfiletestdb.ora3Database instances: testdb1,testdb24Disk Groups: DATA,FRA5Type: RAC6Database is enabled
先确保手工启动的实例已经关闭:
1SHUTDOWN IMMEDIATE;然后通过 Clusterware 启动:
1srvctl start database -d testdb检查:
1srvctl status database -d testdb23Instance testdb1 is running on node rac-test014Instance testdb2 is running on node rac-test02继续检查实例状态。

虽然 srvctl 显示两个实例都在运行,但进一步检查:
1SELECT inst_id,2 instance_name,3 host_name,4 status,5 thread#6FROM gv$instance7ORDER BY inst_id;89INST_ID INSTANCE_NAME HOST_NAME STATUS THREAD#10------- ------------- ---------- ------- -------111 testdb1 rac-test01 OPEN 1122 testdb2 rac-test02 STARTED 0第二节点仍停留在 STARTED。srvctl 显示 running,不代表实例已经 OPEN,继续登录第二节点检查。
1export ORACLE_SID=testdb223sqlplus / as sysdba45ORA-09925: Unable to create audit trail file6Linux-x86_64 Error: 2: No such file or directory先检查磁盘:
1df -h磁盘空间正常,继续看报错:
1No such file or directory优先检查目录是否存在。
回到第一个节点查询:
1SHOW PARAMETER audit_file_dest;发现审计目录:
1/u01/app/oracle/admin/testdb/adump到第二节点检查:
1ls -ld /u01/app/oracle/admin/testdb/adump目录不存在,补齐:
创建目录:
1mkdir -p /u01/app/oracle/admin/testdb/adump2chmod 750 /u01/app/oracle/admin/testdb/adump确保目录属于 Oracle 软件用户。
重新连接数据库:
1sqlplus / as sysdba连接恢复正常,继续执行:
1ALTER DATABASE MOUNT;2ALTER DATABASE OPEN;执行成功。
再查:
1SELECT inst_id, instance_name, status, thread#2FROM gv$instance3ORDER BY inst_id;45INST_ID INSTANCE_NAME STATUS THREAD#6------- ------------- ------ -------71 testdb1 OPEN 182 testdb2 OPEN 2第二节点正常 OPEN,问题原因是审计目录缺失。
两个实例 OPEN 后,进行验收检查。
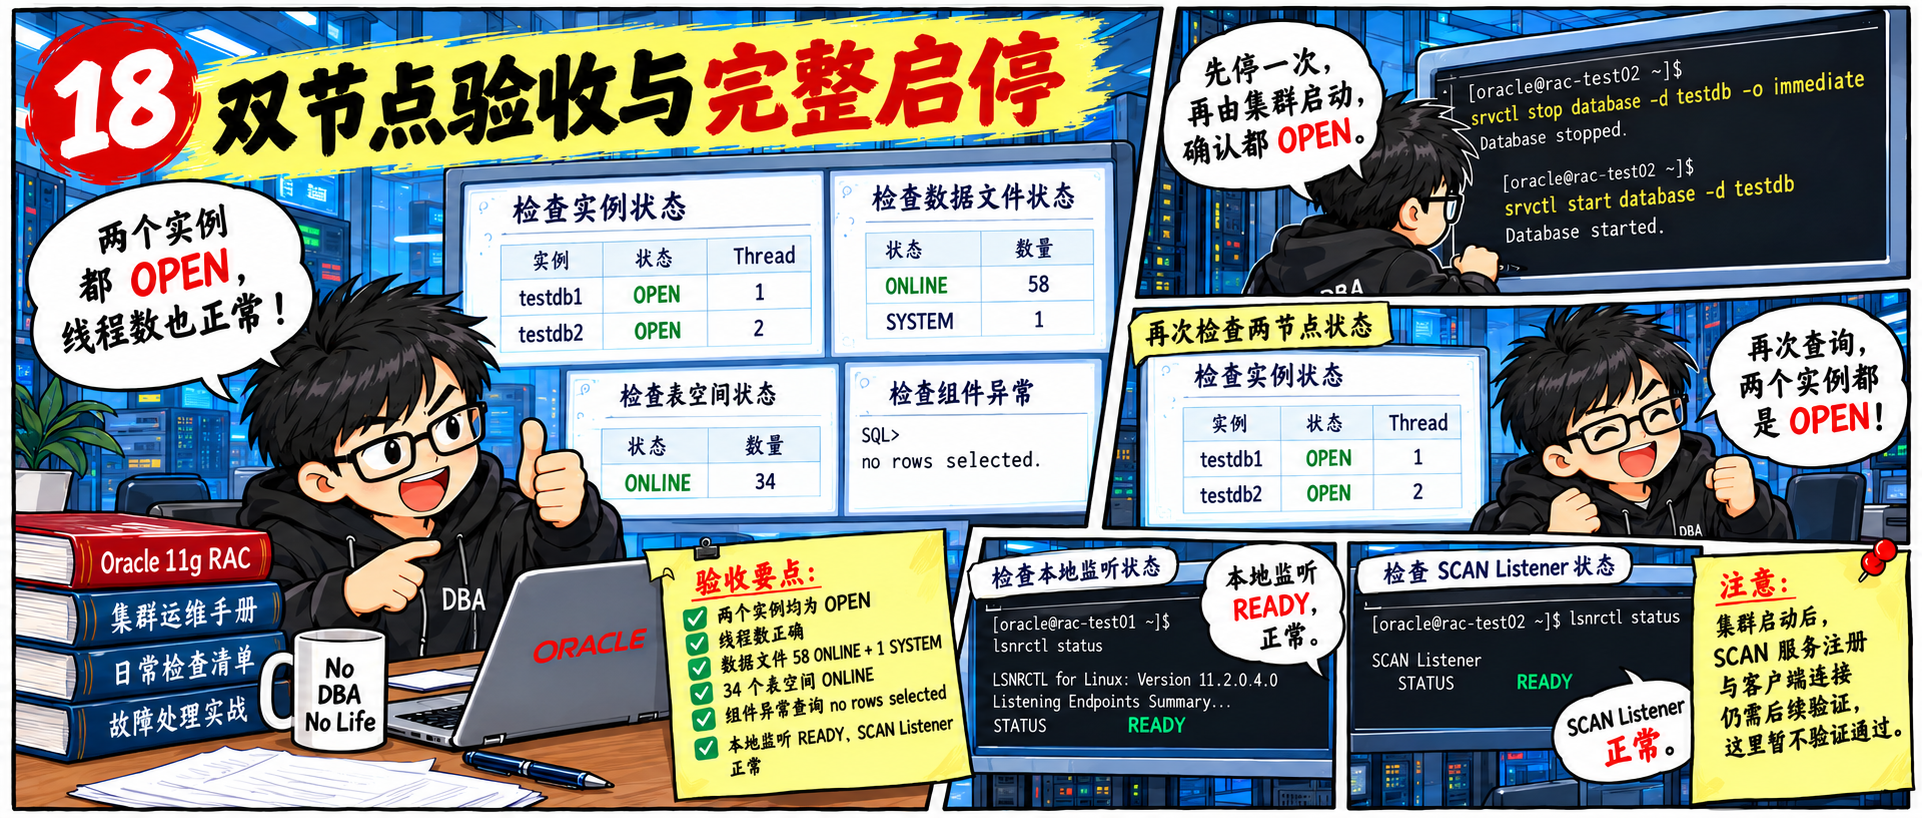
1SELECT name,2 db_unique_name,3 dbid,4 open_mode,5 database_role6FROM v$database;确认数据库名称、DBID、打开状态和角色正确。
1SELECT inst_id,2 instance_name,3 host_name,4 status,5 thread#6FROM gv$instance7ORDER BY inst_id;两个实例均为 OPEN,分别使用 Thread 1 和 Thread 2。
1SELECT status, COUNT(*)2FROM v$datafile3GROUP BY status;45STATUS COUNT(*)6-------- --------7ONLINE 588SYSTEM 1SYSTEM 为数据文件状态,属于正常结果。
1SELECT tablespace_name, status2FROM dba_tablespaces3ORDER BY tablespace_name;34 个表空间全部 ONLINE。
1SELECT comp_name, status2FROM dba_registry3WHERE status <> 'VALID';45no rows selected两个节点分别执行:
1lsnrctl services确认两个实例都注册到本地监听,并且状态为 READY。
再检查 SCAN:
1srvctl config scan2srvctl status scan_listener本地监听和 SCAN Listener 均正常,后续还需验证 SCAN 服务注册及客户端连接。
最后再做一次完整启停:
1srvctl stop database -d testdb -o immediate检查:
1srvctl status database -d testdb两个实例均已停止。
然后重新启动:
1srvctl start database -d testdb再次检查:
1srvctl status database -d testdb两个实例均显示 running。
登录数据库:
1SELECT inst_id, instance_name, status, thread#2FROM gv$instance3ORDER BY inst_id;45INST_ID INSTANCE_NAME STATUS THREAD#6------- ------------- ------ -------71 testdb1 OPEN 182 testdb2 OPEN 2完整启停通过,两个实例均由 Clusterware 正常管理。
生产库复制到测试环境后,还要检查 DB Link、定时任务和外部接口,避免误连生产系统。

先检查 DB Link:
1SELECT owner, db_link, username, host2FROM dba_db_links;这次发现测试库仍然存在连接外部数据库的 DB Link。
连接地址已脱敏,需确认是否指向生产环境。
检查 Scheduler Job:
1SELECT owner, job_name, enabled, state2FROM dba_scheduler_jobs3WHERE enabled = 'TRUE';还发现了多个已启用任务,其中包含业务相关任务。
再检查 DBMS_JOB:
1SELECT schema_user, job, broken, what2FROM dba_jobs3ORDER BY schema_user, job;因此暂时保持:
1ALTER SYSTEM SET job_queue_processes=0 SCOPE=BOTH SID='*';完成环境隔离检查前,暂不启用这些任务。
本次恢复从清理原测试库开始,依次完成 RMAN DUPLICATE、共享 SPFILE 创建、RAC 参数配置及 Clusterware 注册,最终恢复双节点 RAC。
RMAN 共恢复 59 个数据文件,过程中主要遇到两个问题:
CREATE SPFILE FROM MEMORY 重新创建共享 ASM SPFILE,重启后恢复正常。audit_file_dest 目录不存在,创建目录后正常 MOUNT、OPEN。最后通过 srvctl 完成双节点启停验证,两个实例均正常 OPEN。
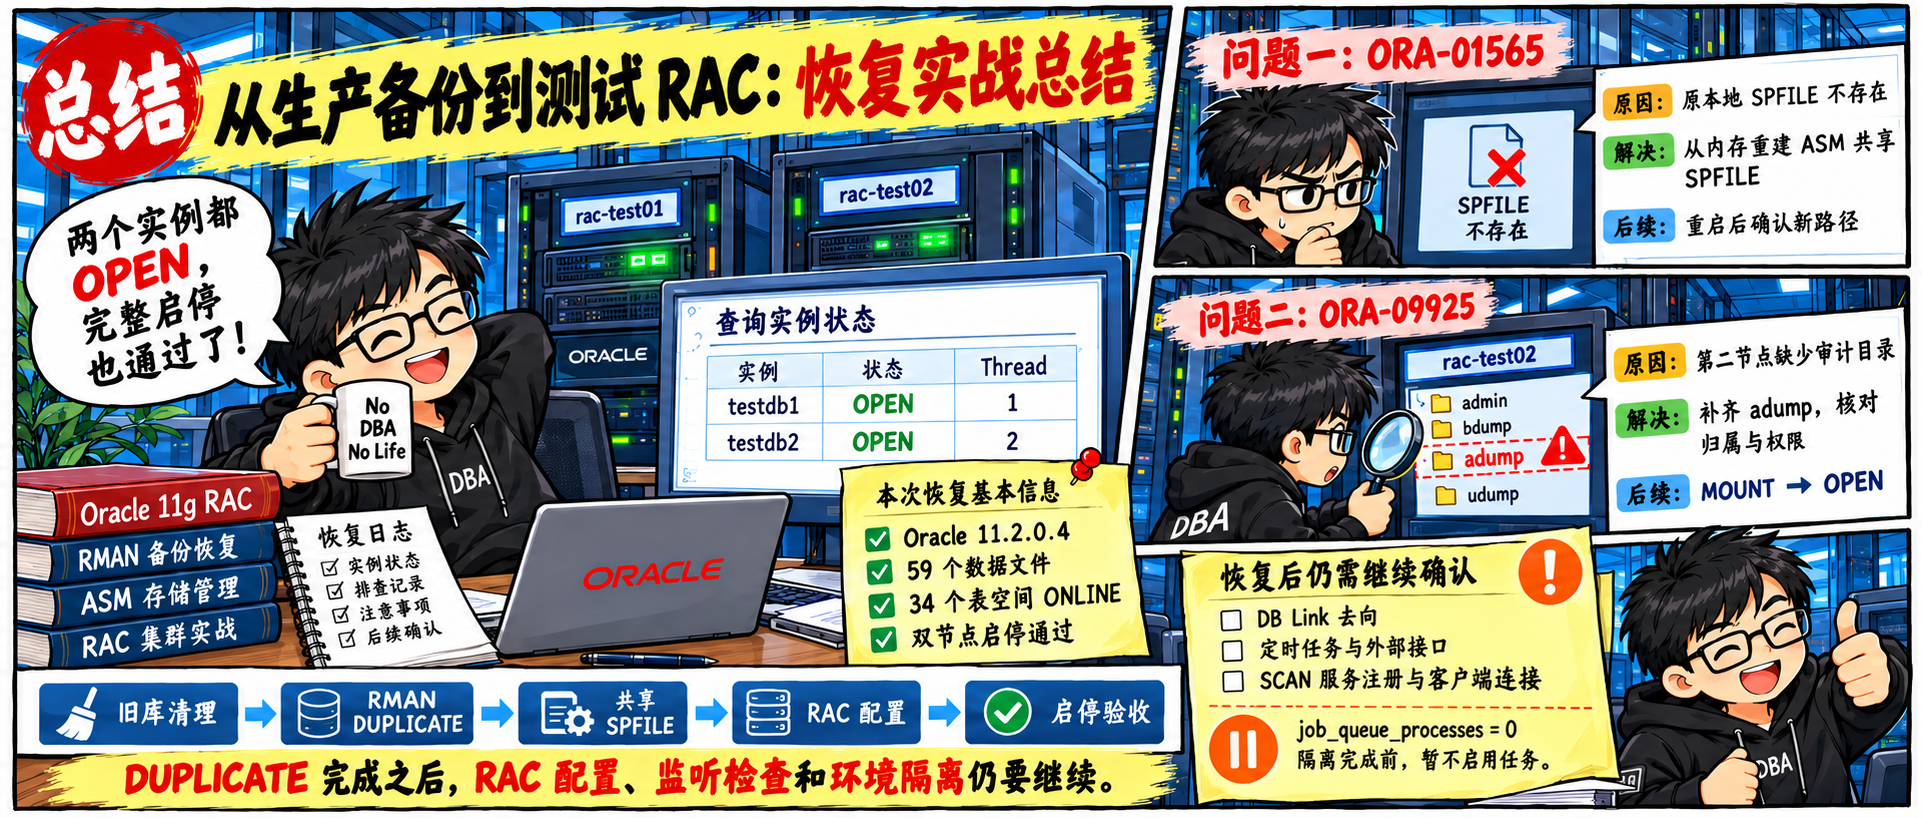
这次恢复也算再次验证了一点:RMAN DUPLICATE 完成不代表整个恢复结束,后续的 RAC 配置、监听检查和测试环境隔离同样不能少。