运维管理24 分钟阅读
Oracle Auto Stats 明明正常,为什么 519 张表一年没更新?
2026年9月23日阅读—点赞—收藏—
OracleAuto
在知识库中专注阅读,并随时返回相关工具与课程
前面我们已经写了 3 篇文章来讨论过这个问题:
第 3 篇最后,那条反复 Full Table Scan 的 SQL 已经处理完,单次 Physical Reads 从两千多万降到了几千,redo size for lost write detection 跟着回落,归档也从事故期间的 30 ~ 50GB/h 回到了 2 ~ 5GB/h。
从业务恢复的角度看,这次事故已经结束。
但当时还留下了一个没有继续深挖的问题:TASK_PARAM_DETAIL 的统计信息为什么会被锁?而且它到底是一张表的问题,还是整套库都存在类似情况?
当时没有足够的信息判断这些 Stats Lock 是谁加的、为什么加的,所以我先不猜原因,而是继续确认范围:到底是这一张表碰巧被锁了,还是这套库的统计信息本来就有问题?
本文记录完整的分析以及处理过程,希望对大家有所帮助。
首先,我是从 APP 里另外几条高 Physical Reads SQL 开始看的,其中两张核心表是 BIZ_BATCH 和 BIZ_DETAIL_PARAM。
先看统计信息:
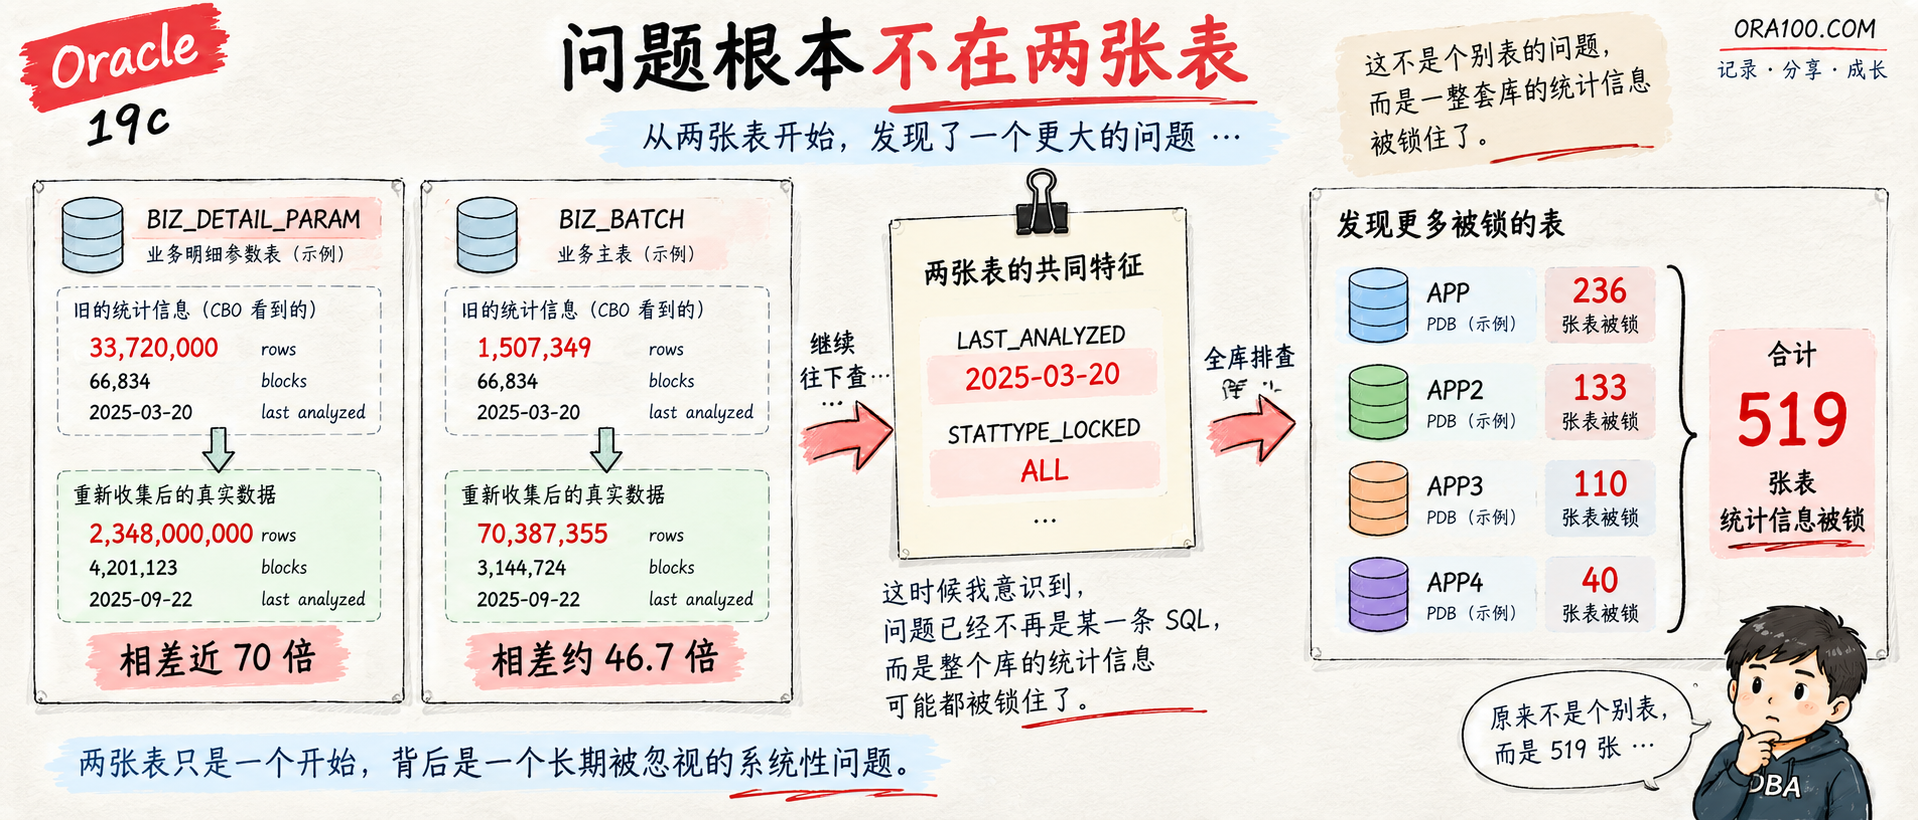
1ALTER SESSION SET CONTAINER=APP;23SELECT table_name,4 stattype_locked,5 num_rows,6 blocks,7 avg_row_len,8 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI') last_analyzed9FROM dba_tab_statistics10WHERE owner='APP'11 AND table_name IN ('BIZ_DETAIL_PARAM','BIZ_BATCH')12 AND object_type='TABLE'13ORDER BY table_name;1415TABLE_NAME STATTYPE_LOCKED NUM_ROWS BLOCKS AVG_ROW_LEN LAST_ANALYZED16---------------- ---------------- ---------- ---------- ----------- ----------------17BIZ_BATCH ALL 1507349 66834 308 2025-03-20 13:0118BIZ_DETAIL_PARAM ALL 33726965 817915 167 2025-03-20 13:01两张表的最后分析时间都停在 2025-03-20,STATTYPE_LOCKED 都是 ALL,而且都是 APP 里持续有大量 DML 的核心业务表。
再看实际 Segment:
1ALTER SESSION SET CONTAINER=CDB$ROOT;23SELECT p.name pdb_name,4 s.owner,5 s.segment_name,6 s.segment_type,7 ROUND(SUM(s.bytes)/1024/1024/1024,2) size_gb8FROM cdb_segments s9JOIN v$pdbs p10 ON p.con_id=s.con_id11WHERE s.owner='APP'12 AND s.segment_name IN ('BIZ_DETAIL_PARAM','BIZ_BATCH')13GROUP BY p.name,s.owner,s.segment_name,s.segment_type14ORDER BY size_gb DESC;1516PDB_NAME OWNER SEGMENT_NAME SEGMENT_TYPE SIZE_GB17--------- ------ ---------------- -------------- --------18APP APP BIZ_DETAIL_PARAM TABLE 421.6319APP APP BIZ_BATCH TABLE 24.02BIZ_DETAIL_PARAM 已经 421GB,统计信息却还认为它只有 3372 万行、81 万多个 block。
再看 dba_tab_modifications:
1ALTER SESSION SET CONTAINER=APP;23SELECT table_owner,4 table_name,5 inserts,6 updates,7 deletes,8 timestamp9FROM dba_tab_modifications10WHERE table_owner='APP'11 AND table_name IN ('BIZ_DETAIL_PARAM','BIZ_BATCH');1213TABLE_OWNER TABLE_NAME INSERTS UPDATES DELETES TIMESTAMP14----------- ---------------- ------------ -------- ------- ---------15APP BIZ_BATCH 70372416 71328573 800 22-SEP-2616APP BIZ_DETAIL_PARAM 2388755943 6378518 11018 22-SEP-26BIZ_DETAIL_PARAM 自上次统计信息维护以后,光 INSERT 监控值就已经到了 23 亿级。
这明显是有问题的,但是在真正处理之前,最好先把旧 Stats 备份下来:
1BEGIN2 DBMS_STATS.CREATE_STAT_TABLE(3 ownname => 'APP',4 stattab => 'BIZ_STATS_BAK'5 );67 DBMS_STATS.EXPORT_TABLE_STATS(8 ownname => 'APP',9 tabname => 'BIZ_DETAIL_PARAM',10 stattab => 'BIZ_STATS_BAK',11 statid => 'BEFORE_20260922'12 );1314 DBMS_STATS.EXPORT_TABLE_STATS(15 ownname => 'APP',16 tabname => 'BIZ_BATCH',17 stattab => 'BIZ_STATS_BAK',18 statid => 'BEFORE_20260922'19 );20END;21/然后单独解锁并重新收集,再处理 BIZ_DETAIL_PARAM:
1BEGIN2 DBMS_STATS.UNLOCK_TABLE_STATS(3 ownname => 'APP',4 tabname => 'BIZ_DETAIL_PARAM'5 );67 DBMS_STATS.GATHER_TABLE_STATS(8 ownname => 'APP',9 tabname => 'BIZ_DETAIL_PARAM',10 estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,11 method_opt => 'FOR ALL COLUMNS SIZE AUTO',12 degree => 8,13 cascade => TRUE,14 no_invalidate => FALSE15 );16END;17/1819PL/SQL procedure successfully completed.2021SELECT table_name,22 num_rows,23 blocks,24 avg_row_len,25 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI') last_analyzed,26 stattype_locked27FROM dba_tab_statistics28WHERE owner='APP'29 AND table_name='BIZ_DETAIL_PARAM'30 AND object_type='TABLE';3132TABLE_NAME NUM_ROWS BLOCKS AVG_ROW_LEN LAST_ANALYZED33---------------- --------------- ----------- ----------- ----------------34BIZ_DETAIL_PARAM 2348319750 55209166 165 2026-09-22 13:22原来 3372 万行,现在 23.48 亿行,差了接近 70 倍,接着处理 BIZ_BATCH:
1BEGIN2 DBMS_STATS.UNLOCK_TABLE_STATS(3 ownname => 'APP',4 tabname => 'BIZ_BATCH'5 );67 DBMS_STATS.GATHER_TABLE_STATS(8 ownname => 'APP',9 tabname => 'BIZ_BATCH',10 estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,11 method_opt => 'FOR ALL COLUMNS SIZE AUTO',12 degree => 8,13 cascade => TRUE,14 no_invalidate => FALSE15 );16END;17/1819PL/SQL procedure successfully completed.2021SELECT table_name,22 num_rows,23 blocks,24 avg_row_len,25 sample_size,26 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI:SS') last_analyzed27FROM dba_tab_statistics28WHERE owner='APP'29 AND table_name='BIZ_BATCH'30 AND object_type='TABLE';3132TABLE_NAME NUM_ROWS BLOCKS AVG_ROW_LEN SAMPLE_SIZE LAST_ANALYZED33----------- ---------- -------- ----------- ----------- -------------------34BIZ_BATCH 70387355 3144724 320 70387355 2026-09-22 16:17:44得,又是一张,BIZ_BATCH 从 150 万行变成 7039 万行,Blocks 从 6.6 万变成 314
万。新的 Blocks 和前面从 Segment 看到的实际规模已经基本对上。
分析到这里,我感觉这个库的所有标的统计信息可能都被锁了,因为最后的分析时间都完全一样,而且全部 STATTYPE_LOCKED=ALL,肯定不再继续一张张修了。
这套环境是 19c CDB/PDB 架构,为了方便查询(不用一直切换 PDB),所以 SQL 查询我们都尽量用 CDB_* 视图。
查看所有表的统计信息:
1ALTER SESSION SET CONTAINER=CDB$ROOT;23SELECT p.name pdb_name,4 t.owner,5 t.table_name,6 t.stattype_locked,7 t.num_rows,8 t.blocks,9 TO_CHAR(t.last_analyzed,'YYYY-MM-DD HH24:MI') last_analyzed10FROM cdb_tab_statistics t11JOIN v$pdbs p12 ON p.con_id=t.con_id13WHERE t.object_type='TABLE'14 AND t.stattype_locked IS NOT NULL15 AND t.owner NOT IN (16 'SYS','SYSTEM','XDB','WMSYS','CTXSYS',17 'MDSYS','ORDSYS','GSMADMIN_INTERNAL'18 )19ORDER BY p.name,t.owner,t.last_analyzed NULLS FIRST,t.table_name;2021519 rows selected.2223SELECT p.name pdb_name,24 t.owner,25 COUNT(*) locked_tables,26 MIN(t.last_analyzed) oldest_stats,27 MAX(t.last_analyzed) newest_stats28FROM cdb_tab_statistics t29JOIN v$pdbs p30 ON p.con_id=t.con_id31WHERE t.object_type='TABLE'32 AND t.stattype_locked IS NOT NULL33 AND t.owner NOT IN (34 'SYS','SYSTEM','XDB','WMSYS','CTXSYS',35 'MDSYS','ORDSYS','GSMADMIN_INTERNAL'36 )37GROUP BY p.name,t.owner38ORDER BY locked_tables DESC;3940PDB_NAME OWNER LOCKED_TABLES OLDEST_STATS NEWEST_STATS41--------- -------- ------------- ------------ ------------42APP APP 236 19-DEC-24 11-NOV-2543APP2 APP2 133 26-JUL-24 11-NOV-2544APP3 APP3 110 30-DEC-24 26-NOV-2545APP4 APP4 40 22-AUG-25 05-SEP-25四个业务 PDB,一共 519 张表,最早的统计信息已经停在 2024 年。看到这里,感觉有点不妙:为什么这套数据库会有 519 张业务表长期处于 Stats Locked?
如果这是人为设计的统计信息管理策略,那很可能还存在另外一套手工统计信息收集机制;如果没有,那么这些表就等于长期脱离了 Oracle 自动统计信息维护。
所以这里我没有先直接批量 UNLOCK,而是打算继续把统计信息维护机制捋一捋。
先看一下 Oracle 自带的自动统计信息任务:
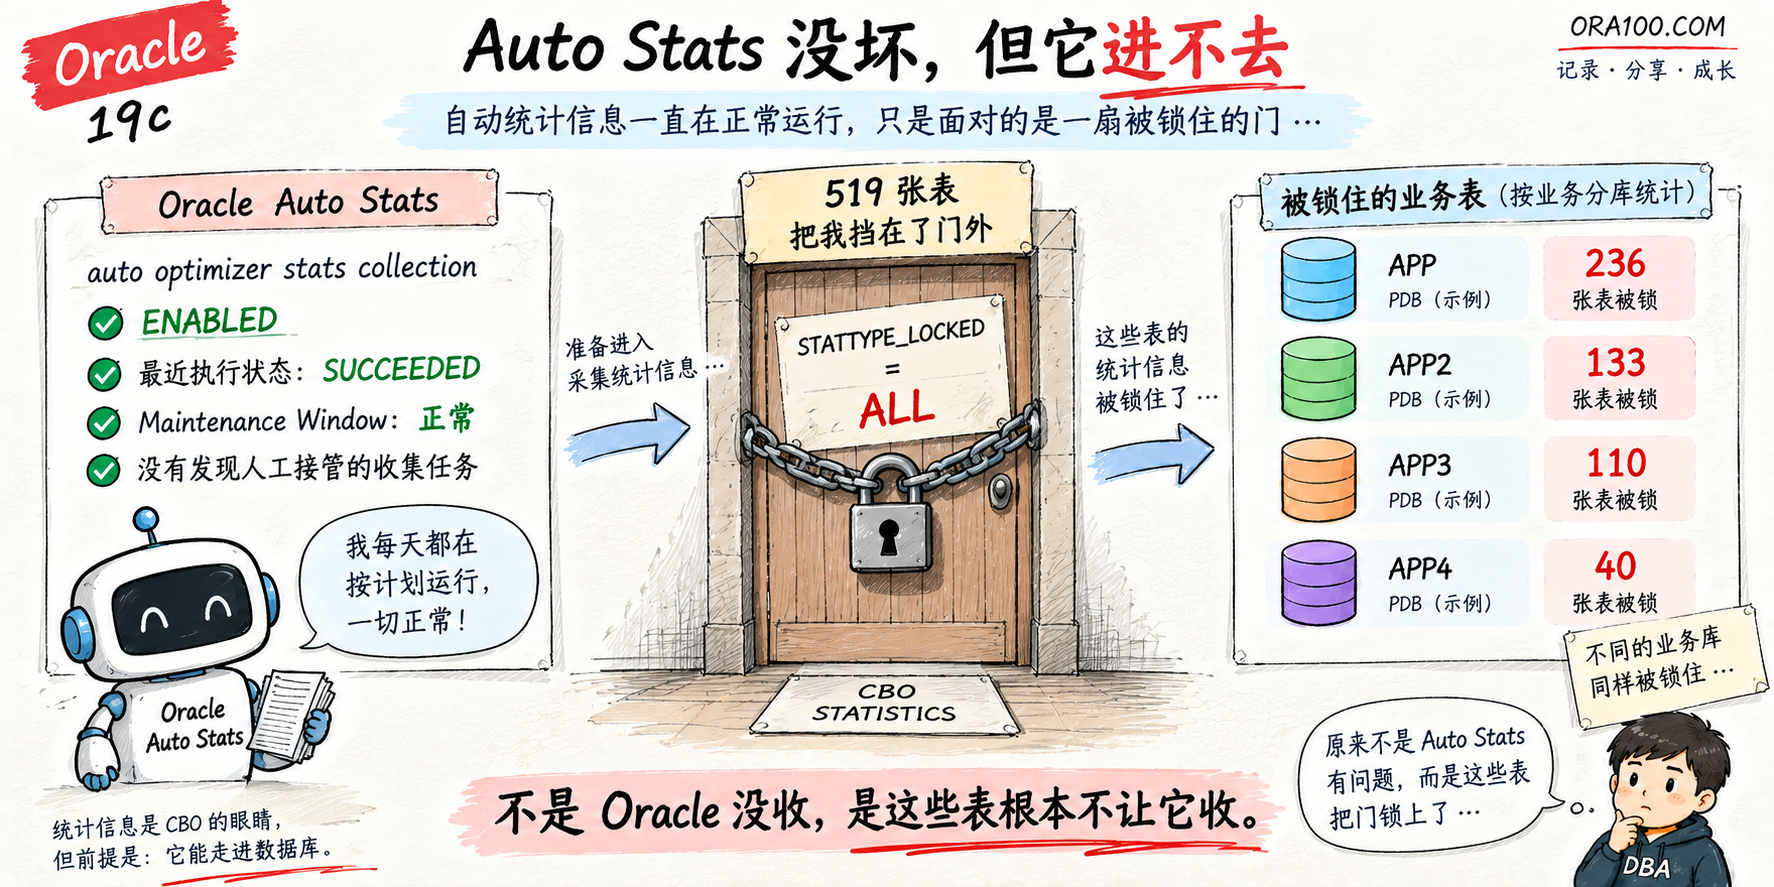
1SELECT client_name,2 status,3 attributes4FROM dba_autotask_client5WHERE client_name='auto optimizer stats collection';67CLIENT_NAME STATUS ATTRIBUTES8----------------------------------- ------- --------------------------------------------9auto optimizer stats collection ENABLED ON BY DEFAULT, VOLATILE, SAFE TO KILL是开启的,再看最近有没有真正执行:
1SELECT client_name,2 job_status,3 job_start_time,4 job_duration,5 job_error6FROM dba_autotask_job_history7WHERE client_name='auto optimizer stats collection'8 AND job_start_time > SYSDATE-79ORDER BY job_start_time DESC;1011CLIENT_NAME JOB_STATUS JOB_START_TIME JOB_DURATION JOB_ERROR12--------------------------------- ---------- ------------------------------- ------------ ---------13auto optimizer stats collection SUCCEEDED 21-SEP-26 10.00.05.696882 PM +00 00:01:06 014auto optimizer stats collection SUCCEEDED 20-SEP-26 10.06.55.095742 PM +00 00:00:10 015auto optimizer stats collection SUCCEEDED 20-SEP-26 06.05.39.586139 PM +00 00:00:08 016...任务是开着的,也一直在正常执行,维护窗口本身也正常。
这就出现了一个很容易误判的场景:Oracle Auto Stats 每天都在正常运行,Job History 也是 SUCCEEDED,但业务表的统计信息却一直没有更新。
生产库里有一种做法:为了控制执行计划变化,先把 Stats Lock 住,再由自己的 Scheduler Job 在固定时间解锁、Gather、重新 Lock。如果业务原本就是这种设计,直接把 519 张表全部放开就可能破坏原来的维护策略。
所以我没有直接蛮干,继续往下查 Scheduler:
1SELECT p.name pdb_name,2 j.owner,3 j.job_name,4 j.enabled,5 j.state,6 j.job_type,7 j.repeat_interval,8 j.last_start_date,9 j.next_run_date10FROM cdb_scheduler_jobs j11JOIN v$pdbs p12 ON p.con_id=j.con_id13WHERE UPPER(j.job_name) LIKE '%STAT%'14 OR UPPER(j.job_action) LIKE '%DBMS_STATS%'15 OR UPPER(j.program_name) LIKE '%STAT%'16ORDER BY p.name,j.owner,j.job_name;查询结果的主要是 Oracle 自己的 SYS.BSLN_MAINTAIN_STATS_JOB,没有看到 APP、APP2、APP3、APP4 下维护的 DBMS_STATS 的业务 Job。
以防万一,再查一遍老版本的 DBMS_JOB:
1SELECT p.name pdb_name,2 j.schema_user,3 j.job,4 j.broken,5 j.last_date,6 j.next_date,7 j.interval,8 j.what9FROM cdb_jobs j10JOIN v$pdbs p11 ON p.con_id=j.con_id12WHERE UPPER(j.what) LIKE '%DBMS_STATS%'13 OR UPPER(j.what) LIKE '%GATHER%'14 OR UPPER(j.what) LIKE '%STAT%'15ORDER BY p.name,j.schema_user,j.job;1617no rows selected也没有发现相关的任务,又继续扫了数据库源码里对 DBMS_STATS、LOCK_TABLE_STATS、GATHER_TABLE_STATS、GATHER_SCHEMA_STATS 的存储过程调用,看到的主要也是 Oracle 的原生代码,没有找到一套业务侧定时接管统计信息的机制。
到这里,证据基本对上了:Auto Stats 正常,维护窗口正常,最近任务持续成功,但业务表大量 STATTYPE_LOCKED=ALL,同时没有发现另外一套人工 Stats Job 在负责这些对象的统计信息收集。
所以,现阶段真正需要处理的不是"重新建一个统计信息 Job",而是把这些历史 Lock 打开,让 Oracle 原来的自动维护重新接管。
在真正开始批量解锁之前,我又把 APP 里大表和修改量单独过了一遍,几张典型表的变化是:
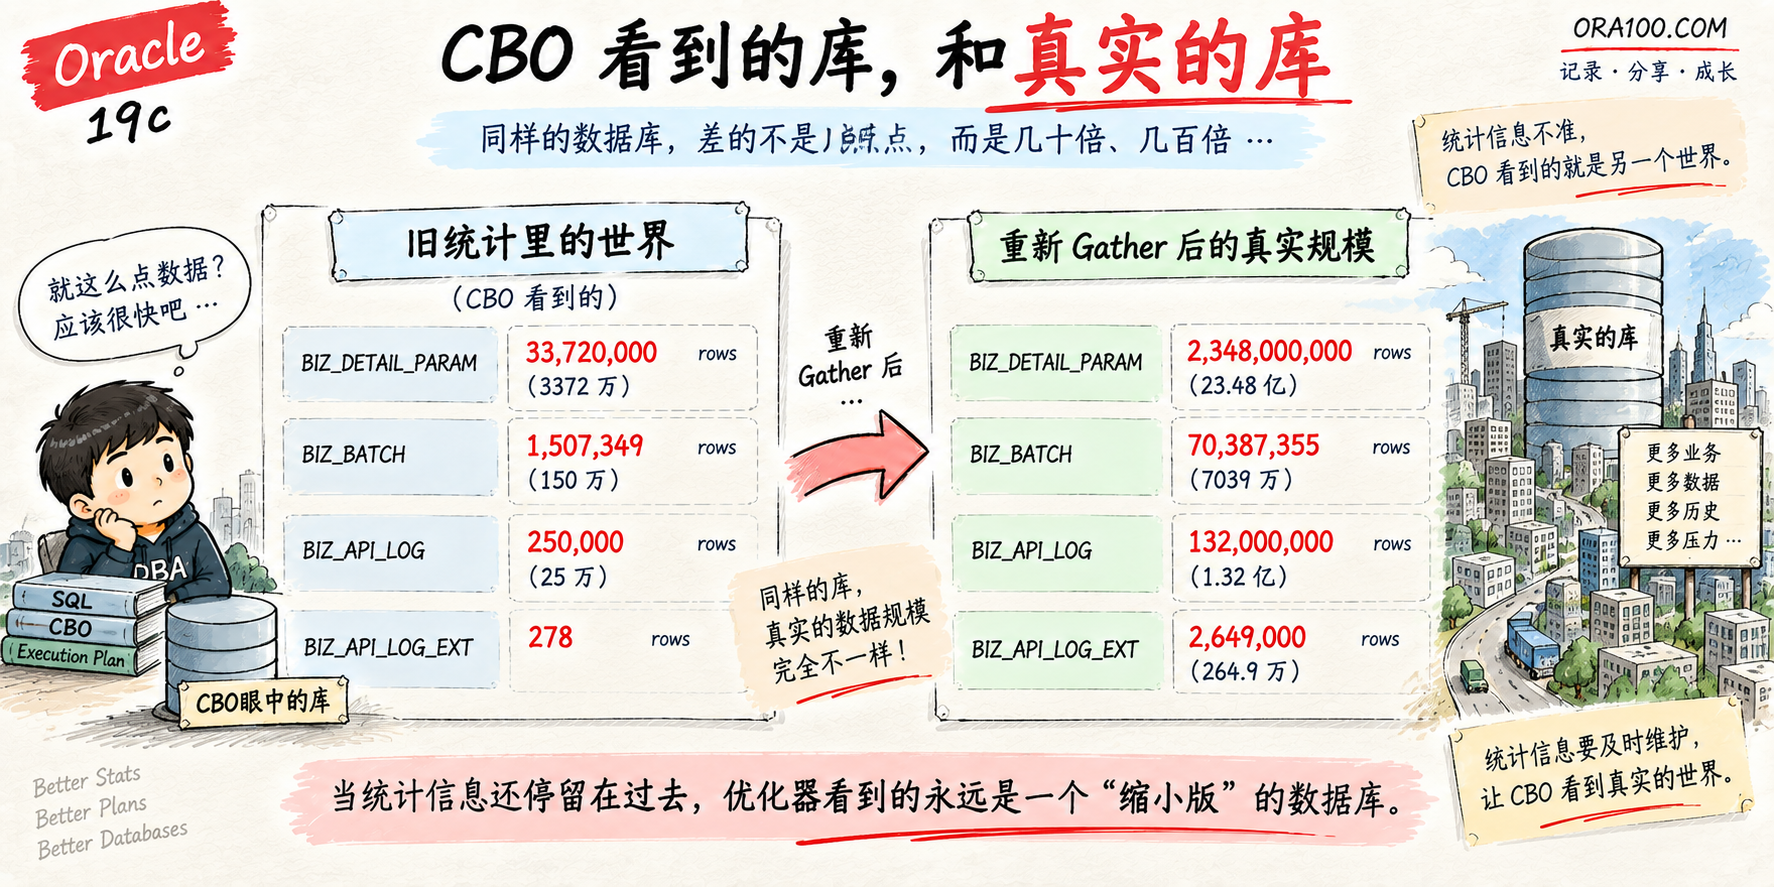
1对象 旧 NUM_ROWS 新 NUM_ROWS2------------------------- --------------- ----------------3BIZ_DETAIL_PARAM 33,726,965 2,348,319,7504BIZ_BATCH 1,507,349 70,387,3555BIZ_API_LOG 250,381 132,275,9946BIZ_ASSOCIATION 1,510,326 70,580,4997BIZ_MATERIAL_CONSUM 1,582,761 60,686,2798BIZ_RUNTIME 182,703 5,853,0989BIZ_API_LOG_EXT 278 2,649,13510BIZ_NG_RECORD 114,573 4,578,03111BIZ_EQUIPMENT_ALARM 280,610 9,028,33012BIZ_PAIR_RECORD 110,632 3,815,143其中 BIZ_API_LOG 最夸张,这张表实际已经接近 194GB,旧 Stats 里却只有 25 万行,重新收集后:
1SELECT table_name,2 num_rows,3 blocks,4 sample_size,5 stale_stats,6 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI:SS') last_analyzed7FROM dba_tab_statistics8WHERE owner='APP'9 AND table_name='BIZ_API_LOG';1011TABLE_NAME NUM_ROWS BLOCKS SAMPLE_SIZE STALE_STATS LAST_ANALYZED12------------- ---------- --------- ----------- ----------- -------------------13BIZ_API_LOG 132275994 25397227 132275994 NO 2026-09-22 20:09:41从 25 万变成 1.32 亿,差了 500 多倍,BIZ_API_LOG_EXT 表更极端,旧统计只有 278 行,重新收集以后是 264 万。
这里需要注意,DBA_TAB_MODIFICATIONS 里的 INSERT/UPDATE/DELETE 是修改监控,不应该简单拿 CHANGES / NUM_ROWS 当成"当前真实增长倍数"。同一批数据可能被反复 UPDATE,真正能判断当前规模的,还是要以重新收集后的 NUM_ROWS、BLOCKS
和实际 Segment 为准。
但这些结果已经足够说明一件事:CBO 看到的库,和真实的库明显已经不是同一个量级。
问题已经确认以后,下一步就是恢复统计信息维护,但这里我还是没有直接把 519 张表全部 UNLOCK,然后来一把全库GATHER_SCHEMA_STATS。
原因很简单:APP 里有 421GB 的 BIZ_DETAIL_PARAM、194GB 的 BIZ_API_LOG,还有一批十几 GB 的业务表,如果一次性把所有历史积压全部放开,再让维护窗口自己处理,第一次执行到底会产生多大 I/O、跑多久,都不好判断。
所以我还是打算分批处理:先处理 APP,因为当前故障和重 SQL 都集中在这里,确认 APP 的 236 张业务表后统一解除 Lock,但先不立刻全 Schema Gather:
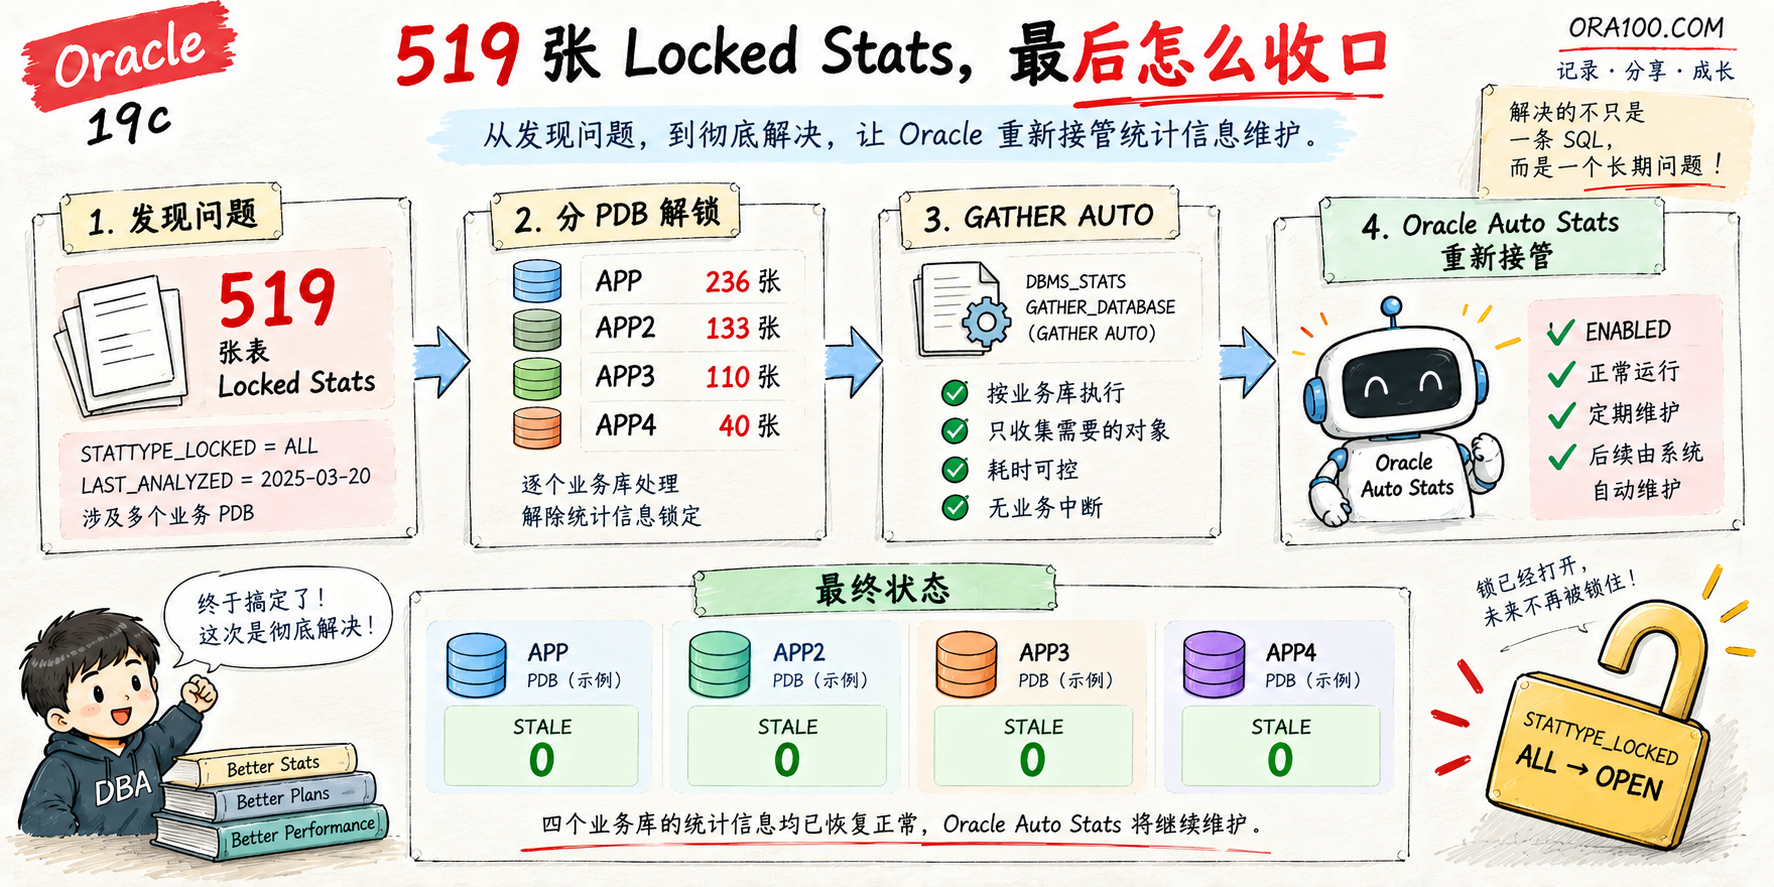
1ALTER SESSION SET CONTAINER=APP;23BEGIN4 FOR r IN (5 SELECT table_name6 FROM dba_tab_statistics7 WHERE owner='APP'8 AND object_type='TABLE'9 AND stattype_locked IS NOT NULL10 )11 LOOP12 BEGIN13 DBMS_STATS.UNLOCK_TABLE_STATS(14 ownname => 'APP',15 tabname => r.table_name16 );17 EXCEPTION18 WHEN OTHERS THEN19 DBMS_OUTPUT.PUT_LINE(r.table_name || ' : ' || SQLERRM);20 END;21 END LOOP;22END;23/2425PL/SQL procedure successfully completed.2627SELECT COUNT(*) locked_tables28FROM dba_tab_statistics29WHERE owner='APP'30 AND object_type='TABLE'31 AND stattype_locked IS NOT NULL;3233LOCKED_TABLES34-------------35 0接着看解锁后真正等待维护的对象,当时 APP 一共有 155 张 STALE_STATS=YES。
APP2、APP3、APP4 的对象规模明显小很多,所以确认完 Locked/Stale 和大表规模以后,也依次解除业务 Schema 的 Lock,APP3 最后保留了一张历史备份表 HISTORY_CONFIG_BAK 的 Lock,没有为了让数字归零强行处理。
这里我没有直接对所有对象强制重新收集,而是选择按照 PDB:
1DBMS_STATS.GATHER_SCHEMA_STATS(2 ownname => '<SCHEMA>',3 options => 'GATHER AUTO',4 estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,5 method_opt => 'FOR ALL COLUMNS SIZE AUTO',6 degree => 4,7 cascade => DBMS_STATS.AUTO_CASCADE,8 no_invalidate => DBMS_STATS.AUTO_INVALIDATE9);先从 APP3 开始:
1ALTER SESSION SET CONTAINER=APP3;23BEGIN4 DBMS_STATS.GATHER_SCHEMA_STATS(5 ownname => 'APP3',6 options => 'GATHER AUTO',7 estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,8 method_opt => 'FOR ALL COLUMNS SIZE AUTO',9 degree => 4,10 cascade => DBMS_STATS.AUTO_CASCADE,11 no_invalidate => DBMS_STATS.AUTO_INVALIDATE12 );13END;14/1516PL/SQL procedure successfully completed.17Elapsed: 00:00:02.271819SELECT stale_stats,20 COUNT(*) cnt21FROM dba_tab_statistics22WHERE owner='APP3'23 AND object_type='TABLE'24GROUP BY stale_stats25ORDER BY stale_stats;2627STALE_STATS CNT28----------- -----29NO 112APP3 原来 27 张 stale 表,GATHER AUTO 只用了 2.27 秒就处理完,并没有把所有对象机械地重新收一遍。
APP2 和 APP4 继续用同样方式:
1APP3 2.27 秒 STALE=02APP2 7.32 秒 STALE=03APP4 1.69 秒 STALE=0三个小 PDB 都正常以后,最后再回到 APP。
APP 当时还有 155 张 stale 表,其中最大的就是前面提到的 BIZ_API_LOG,直接使用同样的 GATHER AUTO:
1ALTER SESSION SET CONTAINER=APP;23SET TIMING ON45BEGIN6 DBMS_STATS.GATHER_SCHEMA_STATS(7 ownname => 'APP',8 options => 'GATHER AUTO',9 estimate_percent => DBMS_STATS.AUTO_SAMPLE_SIZE,10 method_opt => 'FOR ALL COLUMNS SIZE AUTO',11 degree => 4,12 cascade => DBMS_STATS.AUTO_CASCADE,13 no_invalidate => DBMS_STATS.AUTO_INVALIDATE14 );15END;16/1718PL/SQL procedure successfully completed.19Elapsed: 00:04:18.57Oracle 会根据现有统计信息状态判断需要处理的对象,我们要解决的是历史积压,不是为了“全部重收一遍”制造新的 I/O。执行过程中,很多旧统计信息被快速修正,比如:
1SELECT table_name,2 num_rows,3 blocks,4 sample_size,5 stale_stats,6 TO_CHAR(last_analyzed,'YYYY-MM-DD HH24:MI:SS') last_analyzed7FROM dba_tab_statistics8WHERE owner='APP'9 AND table_name IN (10 'BIZ_ASSOCIATION',11 'BIZ_RUNTIME',12 'BIZ_MATERIAL_CONSUM',13 'BIZ_API_LOG',14 'BIZ_OPER_LOG'15 )16ORDER BY table_name;1718TABLE_NAME NUM_ROWS BLOCKS SAMPLE_SIZE STALE LAST_ANALYZED19----------------------- ---------- --------- ----------- ----- -------------------20BIZ_ASSOCIATION 70580499 1639253 70580499 NO 2026-09-22 20:08:2521BIZ_RUNTIME 5853098 392348 5853098 NO 2026-09-22 20:08:5622BIZ_MATERIAL_CONSUM 60686279 2246914 60686279 NO 2026-09-22 20:09:1323BIZ_API_LOG 132275994 25397227 132275994 NO 2026-09-22 20:09:4124BIZ_OPER_LOG 1677169 2011878 1677169 NO 2026-09-22 20:12:14BIZ_API_LOG 从旧统计的 25 万行修正到 1.32 亿,BIZ_OPER_LOG 从 8 万多行修正到 167 万。
这时候再回头看第 3 篇里那些离谱的基数估算,其实已经不奇怪了。优化器不是"明知道这是一张几十亿行的大表还故意选错",而是它手里的对象统计根本没有跟上真实数据。
当然,统计信息准确不代表所有 SQL 都会自动变快,索引设计、SQL 写法、数据分布、Bind、直方图仍然都会影响执行计划。但如果连表到底有 3000 万行还是 23 亿行都不知道,后面的成本估算本身就已经失去了可靠基础。
所有处理完成以后,最后从 CDB$ROOT 做一次统一验收:
1ALTER SESSION SET CONTAINER=CDB$ROOT;23SELECT p.name pdb_name,4 x.owner,5 COUNT(*) tables_cnt,6 SUM(CASE WHEN x.stale_stats='YES' THEN 1 ELSE 0 END) stale_tables,7 SUM(CASE WHEN x.stattype_locked IS NOT NULL THEN 1 ELSE 0 END) locked_tables,8 SUM(CASE WHEN x.last_analyzed IS NULL THEN 1 ELSE 0 END) no_stats_tables9FROM (10 SELECT con_id,11 owner,12 table_name,13 MAX(stale_stats) stale_stats,14 MAX(stattype_locked) stattype_locked,15 MAX(last_analyzed) last_analyzed16 FROM cdb_tab_statistics17 WHERE object_type='TABLE'18 GROUP BY con_id,owner,table_name19) x20JOIN v$pdbs p21 ON p.con_id=x.con_id22WHERE (p.name='APP' AND x.owner='APP')23 OR (p.name='APP2' AND x.owner='APP2')24 OR (p.name='APP3' AND x.owner='APP3')25 OR (p.name='APP4' AND x.owner='APP4')26GROUP BY p.name,x.owner27ORDER BY p.name;2829PDB_NAME OWNER TABLES_CNT STALE_TABLES LOCKED_TABLES NO_STATS_TABLES30--------- ------- ---------- ------------ ------------- ---------------31APP APP 252 0 0 132APP2 APP2 139 0 0 133APP3 APP3 112 0 1 034APP4 APP4 46 0 0 0APP 和 APP2 各有一个 NO_STATS,继续查出来都是:
1SELECT p.name pdb_name,2 t.owner,3 t.table_name,4 t.stale_stats,5 t.stattype_locked,6 t.num_rows,7 t.blocks,8 TO_CHAR(t.last_analyzed,'YYYY-MM-DD HH24:MI') last_analyzed9FROM cdb_tab_statistics t10JOIN v$pdbs p11 ON p.con_id=t.con_id12WHERE t.object_type='TABLE'13 AND t.last_analyzed IS NULL14 AND (15 (p.name='APP' AND t.owner='APP')16 OR (p.name='APP2' AND t.owner='APP2')17 );1819PDB_NAME OWNER TABLE_NAME STALE_STATS STATTYPE_LOCKED NUM_ROWS BLOCKS LAST_ANALYZED20-------- ----- ------------- ----------- --------------- -------- ------ -------------21APP APP SYS_TEMP_FBT22APP2 APP2 SYS_TEMP_FBT属于特殊对象,没有必要为了让 NO_STATS_TABLES 变成 0 再强行收集。
APP3 唯一保留 Lock 的也是一张历史备份表:
1APP3.HISTORY_CONFIG_BAK到这里,业务统计信息的状态已经很干净了:APP、APP2、APP3、APP4 全部 STALE_STATS=0,正常业务表不再大面积 Locked,Oracle 原生 Auto Stats 也保持 ENABLED,后续达到 stale 条件的对象重新交给维护窗口自动处理。
第 3 篇最后,SQL 已经恢复,Physical Reads 下来了,Lost Write Detection 产生的 Redo 也跟着回落,归档从事故期间的 30 ~ 50GB/h 回到了 2 ~ 5GB/h。
当时我以为,这次故障已经处理得差不多了。
但继续往下查才发现,那条 SQL 只是最先暴露出来的问题。真正埋得更深的,是大量业务表长期锁定的统计信息。
现在再回头看,整条链路就完整了:
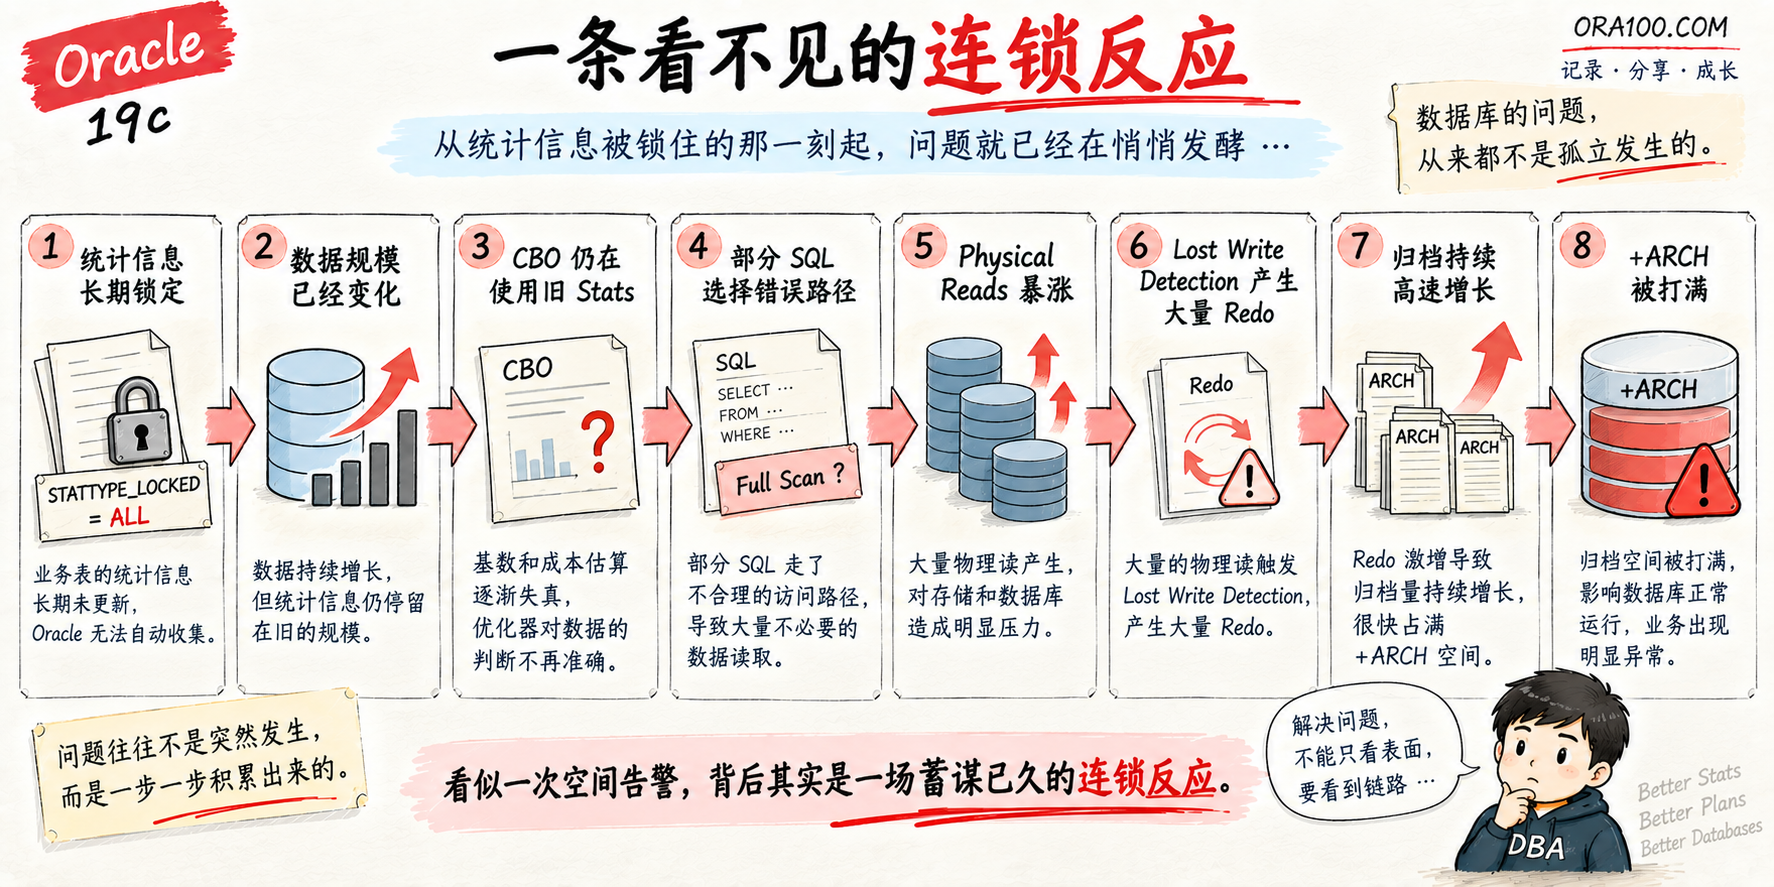
所以前面清理归档、处理 SQL,解决的是当时正在发生的故障;这次把 Locked Stats 清掉,并让 Oracle Auto Stats 重新接管,处理的才是后面还可能再次把问题带回来的那部分。
这套库后续也不需要再额外部署一套每天全 Schema Gather 的任务,Auto Stats 本身一直是正常的,真正需要保证的是:业务表不要再长期脱离它的维护范围。
到这里,从 +ARCH 被打满开始追的这次问题,才算真正收口。
解决一条慢 SQL,只能让故障停下来;把让优化器长期看错数据的问题彻底修掉,这个故障才算真正结束。