运维管理13 分钟阅读
Oracle log file sync 等待高,真的是磁盘慢吗?
2026年10月16日阅读—点赞—收藏—
OracleAWR
在知识库中专注阅读,并随时返回相关工具与课程
今天处理了一起 Oracle 19c RAC 数据库性能问题。
生产 MES 系统偶发响应缓慢,查看 AWR 后发现,凌晨 02:00–03:00 期间,数据库的 log file sync 等待时间明显升高,最高平均等待达到了 46ms。
log file sync 与事务提交密切相关,当应用执行 COMMIT 时,前台会话需要等待相关 REDO 持久化完成。如果 LGWR 写入延迟增加,事务提交时间也可能随之变长。
排查这类问题,我通常会结合 log file parallel write 一起看。如果两个等待事件同时升高,就需要进一步检查 REDO 写入 I/O。
这里我先提个问题:LGWR 写入变慢,就一定是 REDO 磁盘本身出了问题吗?
接下来看看这次排查,过程中确实发现了一些有意思的东西。
数据库环境比较常规:
+DATA 磁盘组。首先查看 2026 年 10 月 16 日凌晨的 AWR,RAC 实例 2 的等待事件变化非常明显:
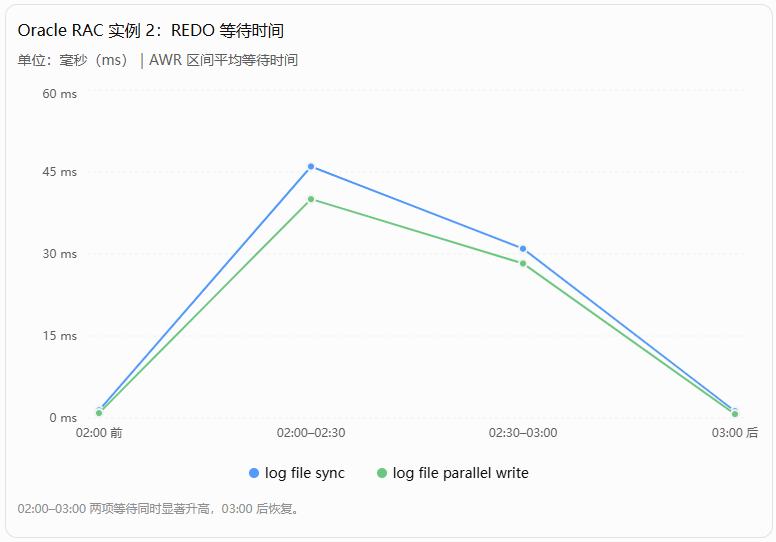
02:00 之前,两个等待事件都不到 2ms。
到了 02:00–02:30,log file sync 直接升高到 46ms,log file parallel write 也达到了 40ms。
03:00 后,又基本恢复正常。
这说明异常具有明显的时间窗口,并不是数据库一直存在的性能问题。
这里简单说一下两个等待事件的区别:
log file sync 是前台会话提交事务时,等待相关 REDO 持久化完成。log file parallel write 则与 LGWR 向 REDO 日志文件执行写入有关。如果只有 log file sync 高,还需要考虑提交频率、LGWR 调度等因素,但这次两个等待事件同时升高,而且数值比较接近,就有必要重点检查 REDO 写入 I/O。
另外,对比 RAC 两个实例发现,实例 1 同期的等待时间远低于实例 2。
看来问题主要集中在实例 2。
先看 REDO 配置:
每个 Thread 配置了 4 组 Online REDO,每组 1GB,REDO 文件存放在 ASM
+DATA磁盘组。
结合现有数据,没有发现足够证据表明这次异常是 REDO 日志过小或频繁切换造成的。
接下来检查 ASM 磁盘,+DATA 对应三块磁盘:
1data12data23data3底层通过 multipath 访问 Dell EMC ME5 存储。
在实例 2 所在节点执行:
1multipath -ll2...3active ready running检查结果显示,三个 DATA LUN 均有四条路径,路径状态正常,没有发现 failed path。
继续检查故障期间的系统日志:
1journalctl -k \2 --since "2026-10-16 01:30:00" \3 --until "2026-10-16 03:30:00" \4 --no-pager | \5grep -Ei 'multipath|scsi|reset|timeout|I/O error'没有查到对应的异常记录。到这里,至少没有发现内核日志中可见的多路径故障、SCSI reset 或 I/O error。
不过,路径正常并不代表存储性能正常,既然 AWR 显示 REDO 写入延迟突然升高,那就继续看看故障期间操作系统的磁盘 I/O。
Linux 如果启用了 sysstat,通常可以通过 sar 查看历史磁盘性能。
这次故障发生在凌晨,好在系统保留了当天的历史数据。
执行:
1sar -d -f /var/log/sa/sa16 \2 -s 01:30:00 \3 -e 03:30:00重点查看 +DATA 对应的 multipath 设备。
从现场输出中整理了几个关键时间点:
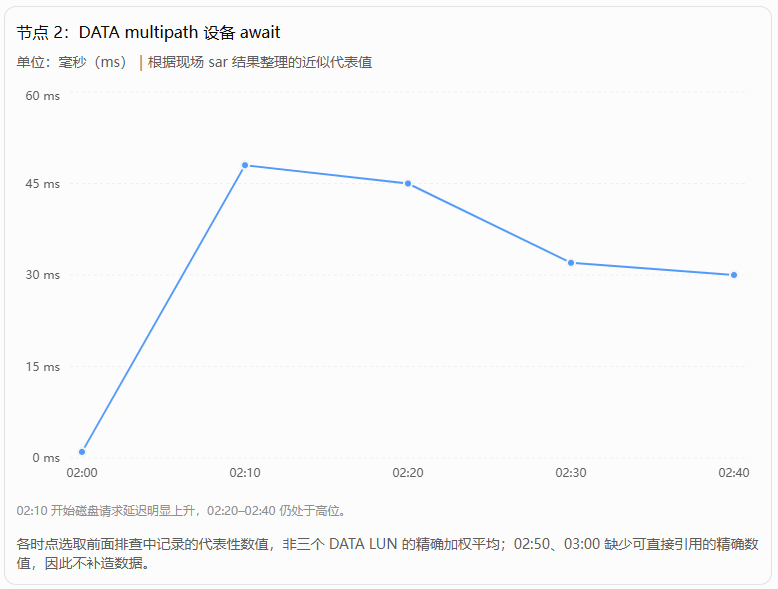 image
这里的 await 是现场多个 DATA multipath 设备的代表性数值,并不是三个 LUN 的加权平均。
02:20–02:40,部分 DATA multipath 设备的
%util已经接近 100%。
但真正引起我注意的不是 %util,而是磁盘的读取量,故障期间,DATA 磁盘的读取吞吐大幅增加,写入量却没有出现同等规模的增长。
这就有点奇怪了。
前面一直在分析 LGWR 写 REDO 慢,结果操作系统显示,这个时间段最突出的负载竟然是大量读取。
再想一下数据库的存储结构,REDO 和数据文件都位于 +DATA,如果有任务正在大量读取数据文件,就可能与 LGWR 写入共享底层存储资源。
当然,sar 的 await 包含设备 I/O 请求的平均等待时间,不能直接等同于 LGWR 的写入耗时。%util 接近 100% 也不能单独证明存储阵列已经达到性能极限。
但至少可以确认一件事:
REDO 写入变慢的同时,DATA 磁盘确实出现了明显的读取负载和 I/O 延迟异常。
下一步就要找到,到底是谁在大量读取数据。
继续分析实例 2 在 02:00–03:00 的 ASH 数据,按照程序和等待事件进行统计,结果如下:
1PROGRAM EVENT SAMPLES2-------------------------- ----------------------------- -------3rman@ssycmes02 RMAN backup & recovery I/O 18084rman@ssycmes02 ON CPU 1865oracle@ssycmes02 (LG00) log file parallel write 1326JDBC Thin Client log file sync 1237oracle@ssycmes02 (LGWR) LGWR all worker groups 438oracle@ssycmes02 (LG01) log file parallel write 34看到这个结果,排查方向就比较明确了。
故障时段,RMAN 的 backup & recovery I/O 样本数非常突出。与此同时,LG00、LG01 正在等待 log file parallel write,前台 JDBC 会话则出现 log file sync。
这些等待出现在同一个时间窗口。
也就是说,RMAN 大量执行备份 I/O 的同时,数据库 REDO 写入和事务提交都变慢了。
ASH 样本数不能直接当作磁盘吞吐量,也不能仅凭这些样本认定 RMAN 就是根因,但结合前面的 sar,已经值得重点检查备份任务了。
通过 V$RMAN_BACKUP_JOB_DETAILS 查询故障时间段内的 RMAN 任务:
1SET LINESIZE 2002SET PAGESIZE 10034SELECT session_key,5 input_type,6 status,7 TO_CHAR(start_time,'YYYY-MM-DD HH24:MI:SS') start_time,8 TO_CHAR(end_time,'YYYY-MM-DD HH24:MI:SS') end_time,9 ROUND(input_bytes/POWER(1024,3),2) input_gb,10 ROUND(output_bytes/POWER(1024,3),2) output_gb,11 ROUND(elapsed_seconds/60,2) elapsed_min12FROM v$rman_backup_job_details13WHERE start_time < DATE '2026-10-16' + 3.5/2414 AND end_time > DATE '2026-10-16' + 1.5/2415ORDER BY start_time;结果中有两条值得注意的数据库备份任务。
第一条任务从前一天晚上 22:01 开始,一直执行到第二天凌晨 02:19;第二条任务则在凌晨 02:00 启动。
两条 RMAN 备份任务重叠了约 19 分钟。
更关键的是,第二条任务从 02:00 开始,一直执行到 03:01,时间上与 AWR 和 sar 发现的异常窗口高度吻合,而且第二条任务读取了约 4.95TB,最终输出却只有 26GB。
不过我们先不要急着下结论,继续确认这两条备份分别是什么情况。
查询备份集信息:
1SET LINESIZE 20023SELECT j.session_key,4 j.input_type,5 b.incremental_level,6 COUNT(*) AS backup_sets,7 TO_CHAR(MIN(b.start_time),8 'YYYY-MM-DD HH24:MI:SS') start_time,9 TO_CHAR(MAX(b.completion_time),10 'YYYY-MM-DD HH24:MI:SS') end_time11FROM v$rman_backup_job_details j12JOIN v$backup_set_details b13 ON j.session_key = b.session_key14WHERE j.session_key IN (22301,22307)15GROUP BY j.session_key,16 j.input_type,17 b.incremental_level18ORDER BY j.session_key,b.incremental_level;1920SESSION_KEY INCREMENTAL_LEVEL BACKUP_SETS21----------- ----------------- -----------2222301 0 82322301 32422307 1 432522307 11可以确认:
22301 执行的是 Level 0 备份。22307 执行的是 Level 1 增量备份。其中 INCREMENTAL_LEVEL 为空的备份集,不属于 Level 0 或 Level 1 数据文件增量备份集,需要结合备份集内容进一步判断。
那么问题来了,这两条备份任务分别是谁发起的?
简单沟通之后发现,当前数据库使用了两套备份软件:Veeam 和爱数。
继续查备份片:
1SET LINESIZE 2202COL HANDLE FORMAT A11034SELECT d.session_key,5 d.incremental_level,6 p.device_type,7 p.handle8FROM v$backup_set_details d9JOIN v$backup_piece_details p10 ON d.set_stamp = p.set_stamp11 AND d.set_count = p.set_count12WHERE d.session_key IN (22301,22307)13 AND p.handle IS NOT NULL14ORDER BY d.session_key,d.incremental_level;任务 22301 的备份片:
1d01b6103-e732-4cc7-9182-d15f24791f07/2RMAN_3401015225_SSYCMESD_20261015_4754vps0_59527_1_1.vab看到 .vab,基本就可以识别出这是 Veeam 的备份片。
再看任务 22307:
1ORDB_SSYCMESD_59532_1_12467592532ARCH_SSYCMESD_59585_1_12467628143CTRL_SSYCMESD_59593_1_1246762899命名方式完全不同。
结合现场两套备份软件的情况,第二条任务很可能来自爱数。为了进一步确认,又去查看了爱数的备份策略。
爱数平台配置的备份计划如下:
故障发生在 2026 年 10 月 16 日,星期五,按照爱数策略,当天凌晨 02:00 正好需要执行增量备份。
而 RMAN 中记录的 Level 1 实际启动时间为:
12026-10-16 02:00:48只相差 48 秒。
结合备份片命名和平台策略,任务 22307 与爱数的增量备份计划高度吻合。
到这里,基本可以还原凌晨的情况:
两套备份同时运行了约 19 分钟。
但有一点需要注意:
Veeam 在 02:19 已经结束,而 DATA 磁盘读取压力在之后仍然持续。
这说明问题不能简单归结为两套备份重叠,爱数 Level 1 自身产生的大规模读取,同样值得重点关注。
再看一下任务 22307:
1SESSION_KEY : 223072BACKUP TYPE : Level 13INPUT_GB : 4945.234OUTPUT_GB : 26.125ELAPSED : 60.92 minutes一次 Level 1 增量备份,最终只输出约 26GB,却读取了接近 5TB。
这就要检查 Oracle 的 Block Change Tracking 了:
1SELECT status,2 filename3FROM v$block_change_tracking;45STATUS6---------------7DISABLEDBCT 没有启用。
BCT 的作用:帮助 RMAN 在执行增量备份时定位发生变化的数据块,减少不必要的数据文件扫描。
如果没有 BCT,RMAN 执行 Level 1 时,通常需要扫描大量数据块来识别变化块。因此,虽然最终备份输出只有 26GB,但读取量依然可能接近整个数据库的数据文件规模。
这次的实际统计也符合这一特征,不过需要注意,RMAN 的输入量和输出量并不能直接换算成变化块比例,因为还涉及压缩、备份集结构等因素。
而且 BCT 关闭不代表每次 Level 1 都必然完整读取全库,但对于本次任务,我们已经有明确的 RMAN 统计:它确实读取了约 4.95TB,按约 61 分钟计算,平均读取速率约为 1.36GB/s。
对于与生产 REDO 共享底层存储资源的备份负载,这个读取强度显然值得关注。
现在把 AWR、ASH、OS 和 RMAN 的数据放在一起:
到这里,整个过程已经比较清楚了,从时间关系和监控数据看,RMAN 大规模读取引发的存储 I/O 竞争,是本次异常最可能的原因。
这次数据库是 MES 生产系统,全天都有生产业务,并没有明确的业务低峰窗口,所以处理方案不能简单理解成把备份从 02:00 改到 03:00 或 04:00。
毕竟 Level 1 每次仍然需要读取大量数据,改时间只是把压力转移到另一个时段,也暂不考虑启用 BCT。
因此,我们最终决定先从爱数备份策略入手。
主要有两个方向:
第一,避免两套备份任务重叠。
协调 Veeam 和爱数的备份计划,避免 Level 0 尚未结束,另一套 Level 1 就开始执行,同时需要确认两套备份软件各自的 RMAN 备份链、保留策略和恢复依赖关系,不能只为了错开时间而影响备份恢复能力。
第二,控制爱数 Level 1 的 I/O 强度。
检查爱数是否支持调整 RMAN 通道数、备份并发数,以及源端读取限速,对于全天运行的 MES 系统,相比追求最短备份时间,更应该优先保证业务 I/O 的稳定性。
当然,降低并发或限速可能延长备份时间,需要在可接受的备份窗口内逐步验证。
目前已经确定先调整爱数备份策略,具体优化效果还需要等待下一轮备份数据确认。
后续重点对比:
await。log file parallel write。log file sync。只有这些指标确实改善,才能说明调整达到了预期效果。
这次排查从 log file sync 等待升高开始,发现 log file parallel write 也存在明显异常,于是进一步检查 REDO、ASM 和底层存储。
多路径和系统日志没有发现明显异常,但 sar 显示故障期间 DATA 磁盘读取量大幅增加。继续结合 ASH 和 RMAN 备份历史,最终发现 Veeam 和爱数两套备份任务存在时间重叠,其中 Level 1 增量备份在 BCT 关闭的情况下读取了接近 5TB 数据。
结合 AWR、ASH 和 OS 监控数据,基本可以判断,本次 log file sync 升高与 RMAN 大量读取造成的存储 I/O 竞争密切相关。
这次排查也给了我一个提醒:遇到 log file sync 高,不能只盯着 REDO 写入,还要关注同一时间是否存在其他大 I/O 任务。
目前已确定优先调整备份策略,具体优化效果还需要通过后续备份验证。