运维管理6 分钟阅读
金仓 RAC 到底怎么样?我上手测了测
2026年10月23日阅读—点赞—收藏—
RAC高可用
在知识库中专注阅读,并随时返回相关工具与课程
最近听说金仓的 RAC 快要发布了,厚着脸皮要了个安装包,在自己的虚拟化环境里搭了一套两节点集群,整体安装还是比较顺利的,两个节点读写也都正常。
作为 DBA,我更关心的是:一个节点突然宕机,剩下的节点能不能接住业务?
最好的验证就是直接实测一下:
让程序持续写数据,再关掉一个节点的电源,主要看两个点:业务多久恢复,已经提交的数据有没有丢。
下面记录一下实际测试过程。
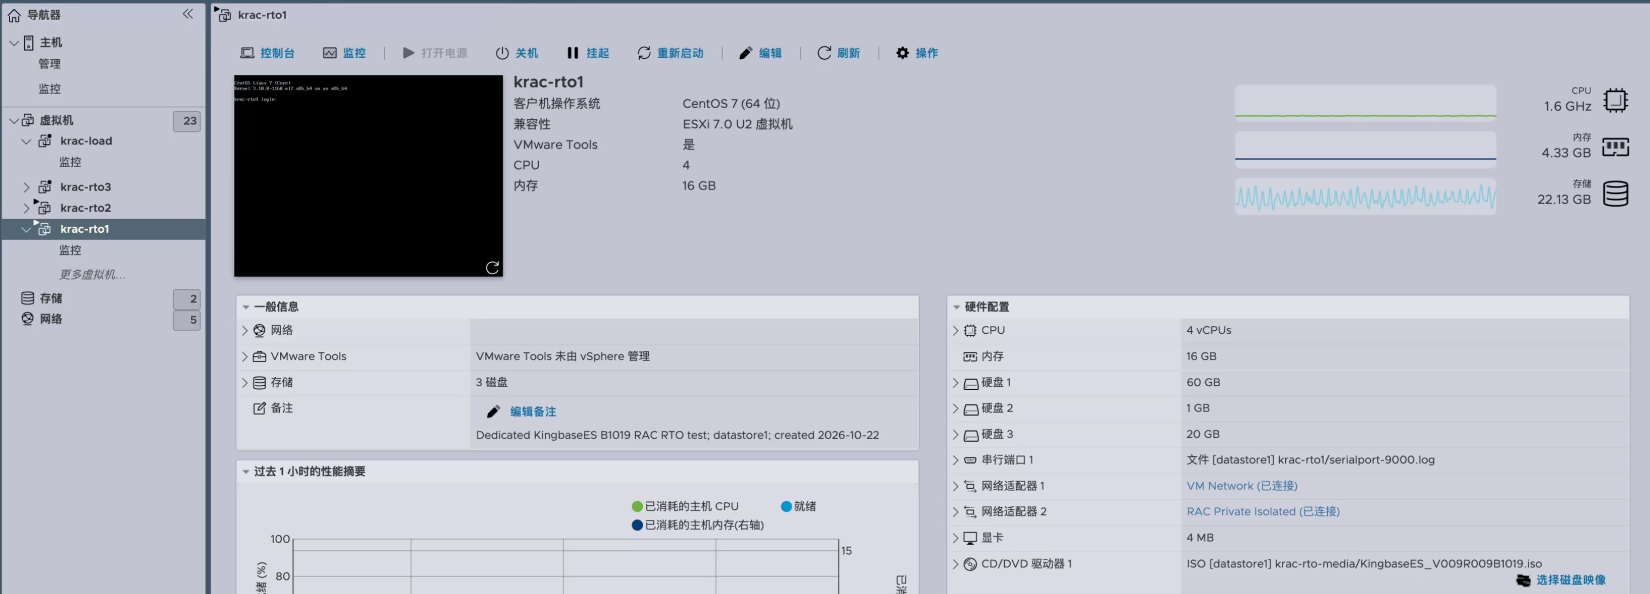
本文安装的是 KingbaseES V009R009B1019 版本,Oracle 兼容模式,环境配置如下:
这是我自己的实验环境,两个节点和共享盘都在同一台 ESXi 宿主机上,这次主要验证单台虚拟机突然掉电后的表现,宿主机和共享存储整体故障不在测试范围内。
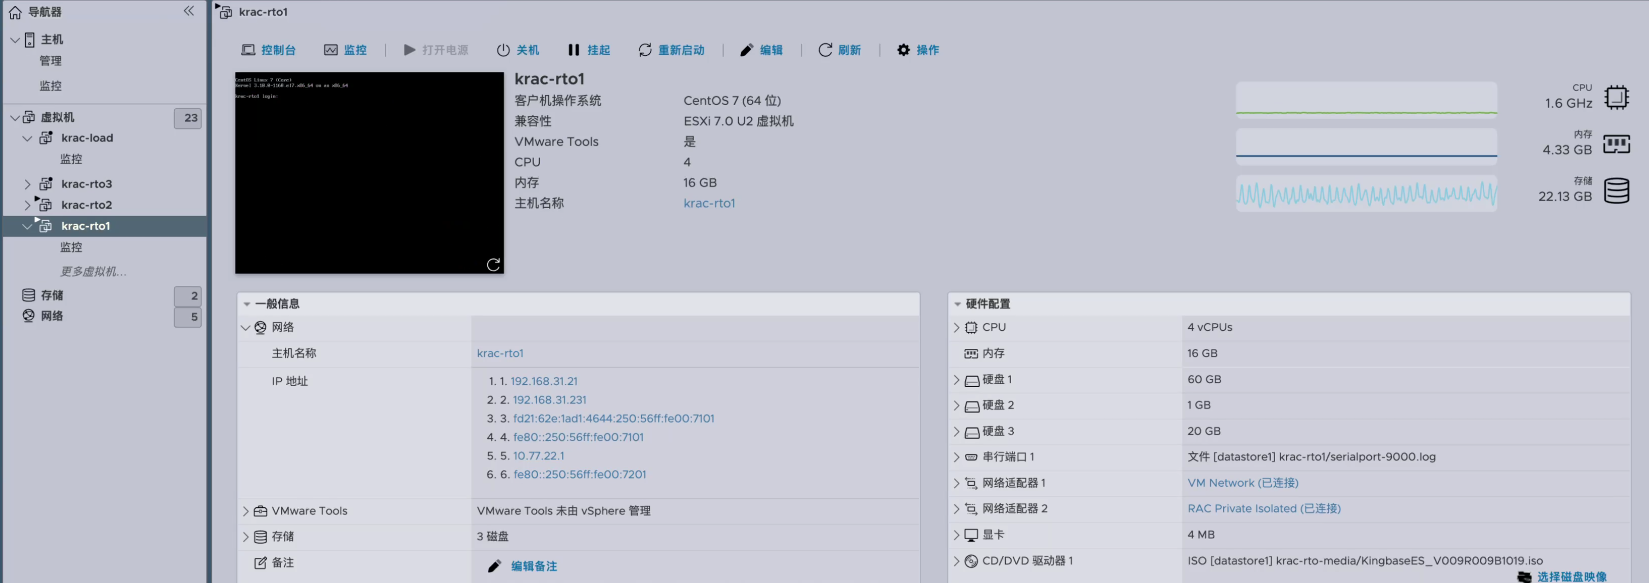
我平时做 Oracle RAC 比较多,共享存储、私网、VIP 这些概念都比较熟悉。不过金仓 RAC 的组件和管理工具有自己的实现,具体操作还是按它的手册来。
完成软件安装、网络、共享盘和节点互信配置后,执行集群部署:
1cd /home/kingbase/KingbaseRAC/Grid23./script/cluster_manager.sh --deploy -f ./conf/rac_ksm.conf部署完成后可以用 crm status 检查资源:
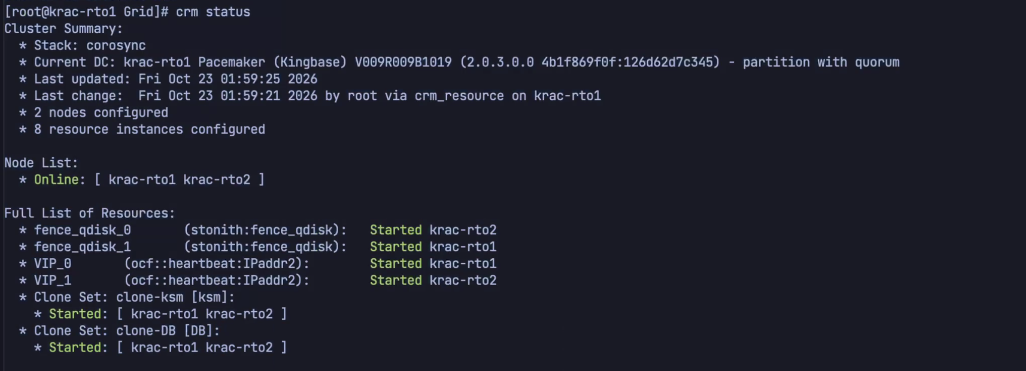
两个节点均在线,DB、KSM、VIP 都正常,再分别连接两个节点确认读写。
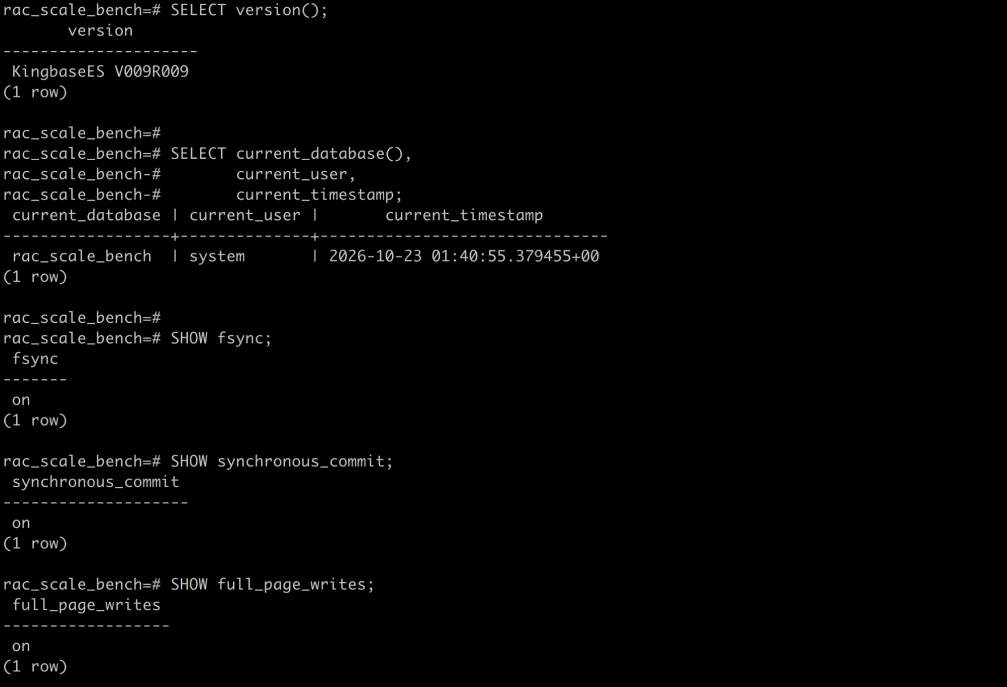
测试期间,fsync、synchronous_commit、full_page_writes 都保持 on,心跳和故障隔离超时也没有为了缩短恢复时间去调低。
我在 Macbook 上跑了两路探测,分别连接两个 VIP。
我让 codex 帮我写了个小程序,持续往数据库里插入数据,提交后再查一遍,确认写进去的内容没问题。把每次的执行结果都记下来,最后和库里的数据逐条核对。连接断了就自动重连,继续写。
恢复时间从执行断电命令开始算,重新能正常读写以后,再观察 10 秒,期间没有报错、每次耗时都在半秒以内,就算恢复了,后面这 10 秒观察时间不计入恢复耗时。
也就是说,第 36 秒开始持续成功,再观察 10 秒确认稳定,恢复时间就记为约 36 秒。
计时统一使用 Macbook 客户端的单调时钟,避免不同机器的时钟偏差影响结果。
先让程序跑起来,确认两路读写正常:
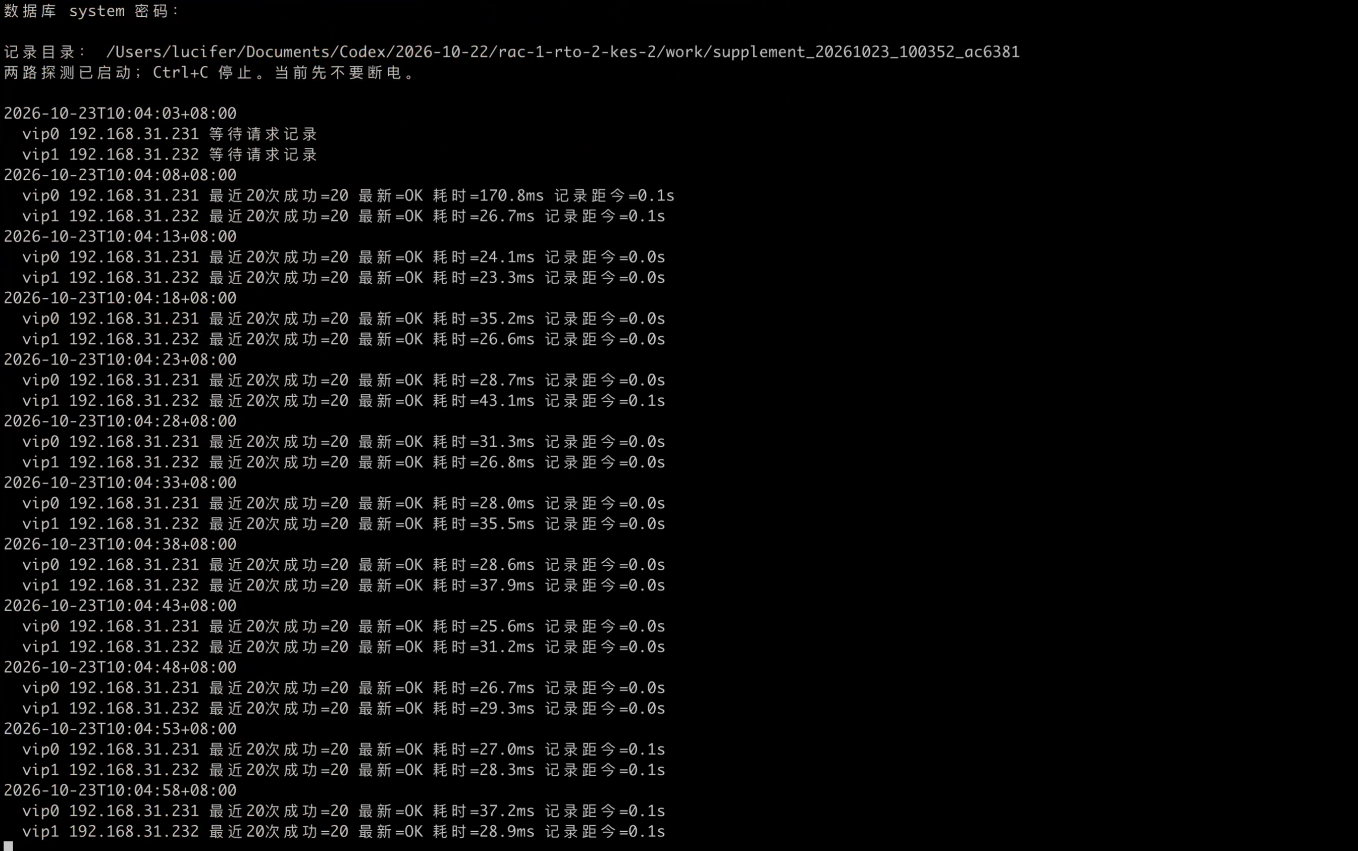
然后从 ESXi 强制关闭节点 1 的电源。
这里没有正常停止数据库,也没有关闭操作系统,模拟的就是节点突然掉电。
本轮断电命令在北京时间 10:11:57.807 发起:

刷新 ESXi 页面,确认节点 1 已经关机:
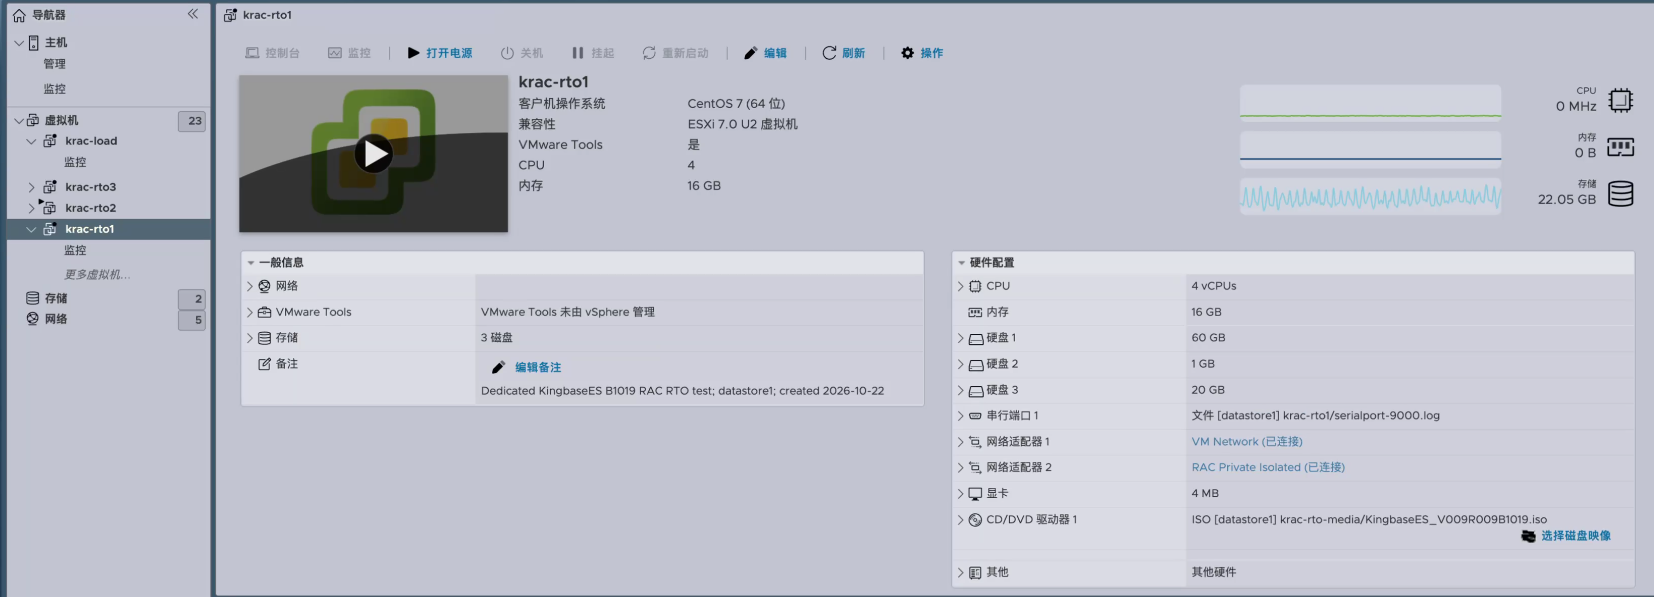
暂时先不启动节点 1,继续看客户端和节点 2。
断电以后,两路客户端都出现了请求失败,部分请求等到超时才返回,随后重新执行成功。
这里有个现象需要留意:原本连接存活节点的那一路,也发生了短暂中断。
所以我觉得做这类故障演练,两个入口都应该持续观察,不能只看故障节点对应的 VIP:
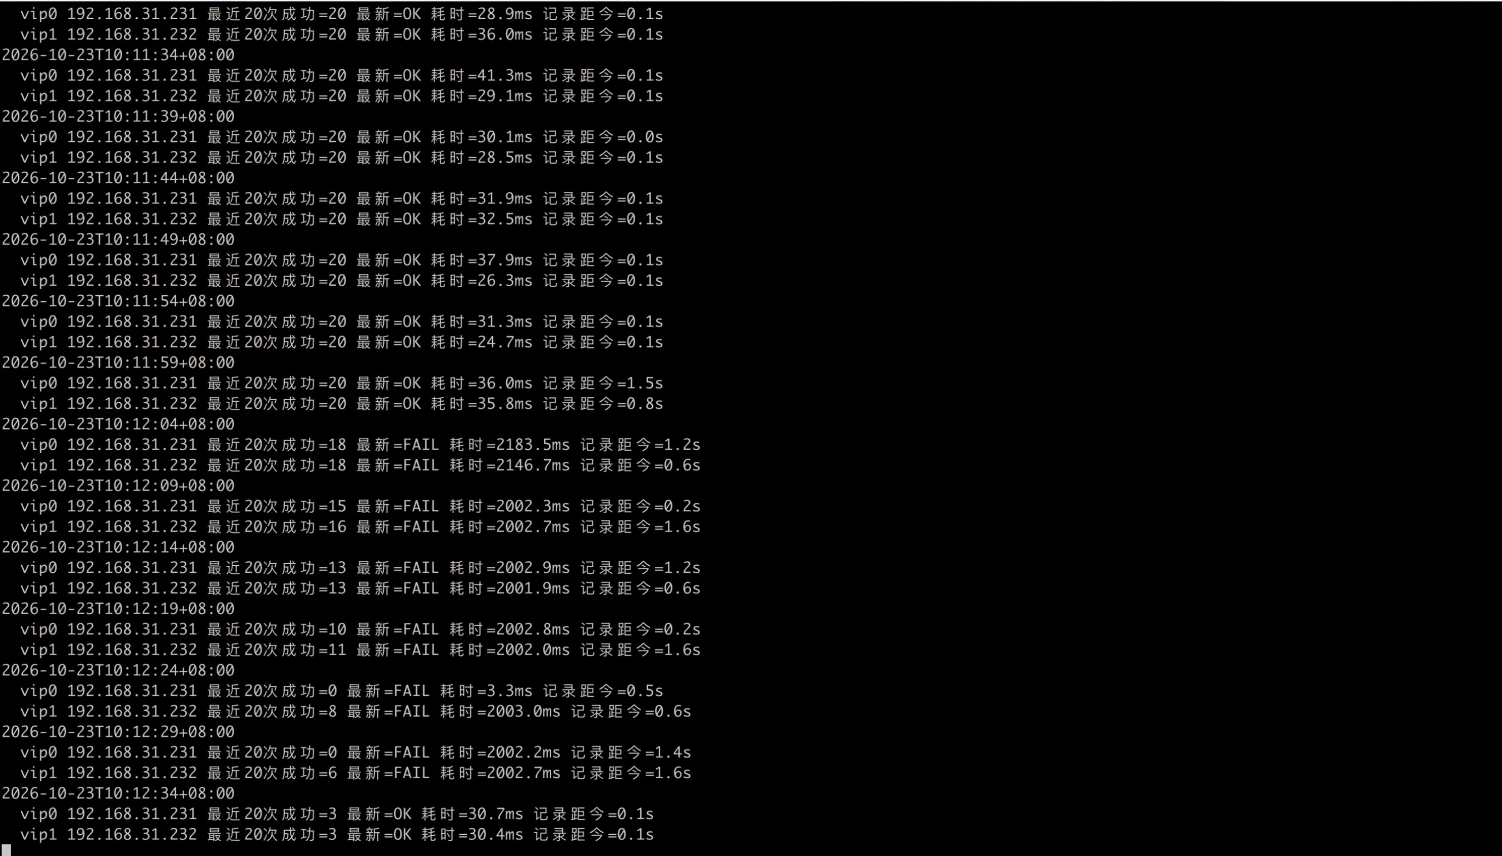
此时在节点 2 执行:
1crm status2ip -4 -o addr show eth0可以看到节点 1 离线,两个 VIP 都到了节点 2,DB 和 KSM 在节点 2 正常运行。
网卡上也能同时看到 .231 和 .232 两个 VIP:
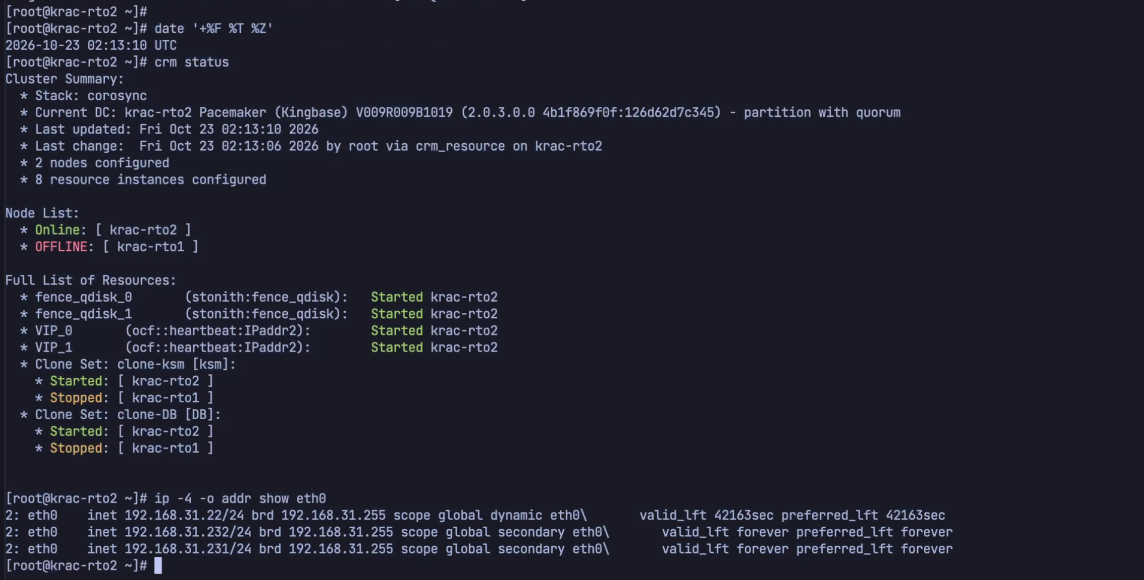
这时候节点 1 还关着,但是客户端已经恢复读写,可以确认是节点 2 接住了业务。
再从原始请求流水计算恢复时间:
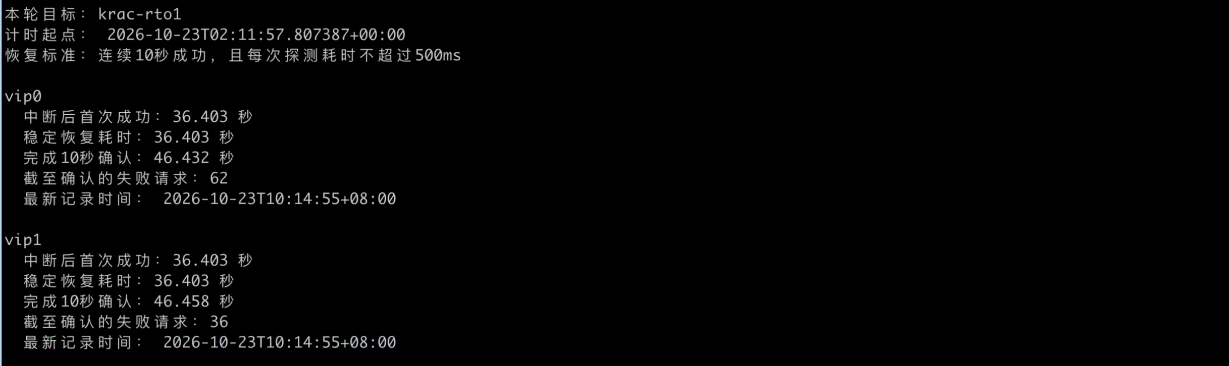
本轮两个入口均在约 36.40 秒稳定恢复。
这里测到的是客户端重新完成写入、提交和回读的时间。连接重建由探测程序处理,没有验证失败业务事务的自动重放。
确认业务恢复以后,再给节点 1 上电,两路客户端继续运行。

这一阶段没有手工启动数据库资源,等它自动加入集群。
最终两个节点都在线,DB、KSM 正常,两个 VIP 也分别回到对应节点:
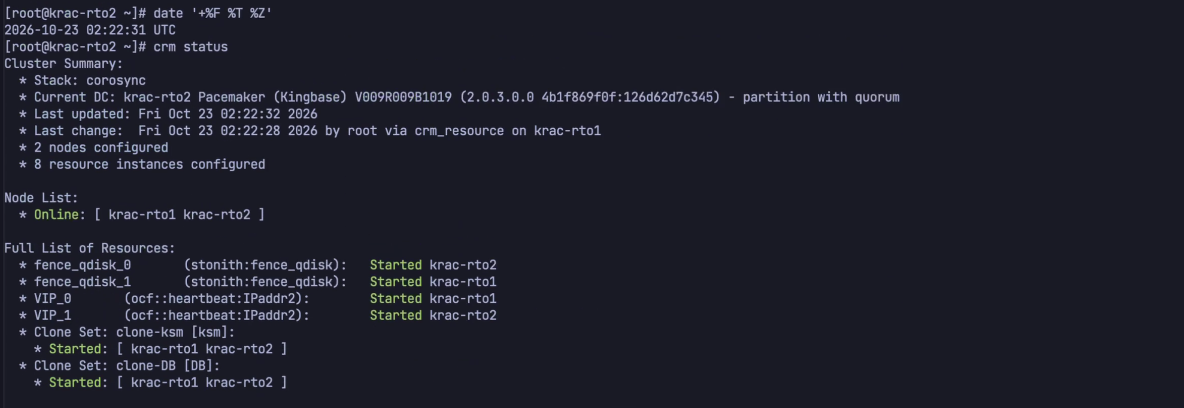
从节点 1 上电到停止探测,VIP0 记录到 1 次请求失败,VIP1 记录到 2 次,共 3 次,之后持续读写正常。
所以节点回来以后,我没有马上停程序,继续观察了一段时间。只看最后集群状态正常,容易漏掉中间这些短暂错误。
这里也交代一下前面的处理。
前一天预试时,遇到过节点重启后,残留 socket 锁文件阻塞数据库启动的问题。锁文件里的旧数据库 PID,恰好被重启后的 KSM 线程重用,数据库因此拒绝启动。
确认本节点没有实际数据库进程和监听后,清理了失效文件,并增加仅在开机阶段执行的清理规则。
本轮沿用了这项配置,后面的自动归队结果也是在这个前提下测得的。
测试结束,再看看数据有没有问题。
程序一共发起了 19,083 次请求,18,982 次收到提交成功的返回,101 次失败。
我按程序记下的请求号,分别连到两个节点查了一遍,把写成功的数据逐条对了一下:
两个节点查出来的结果一致:
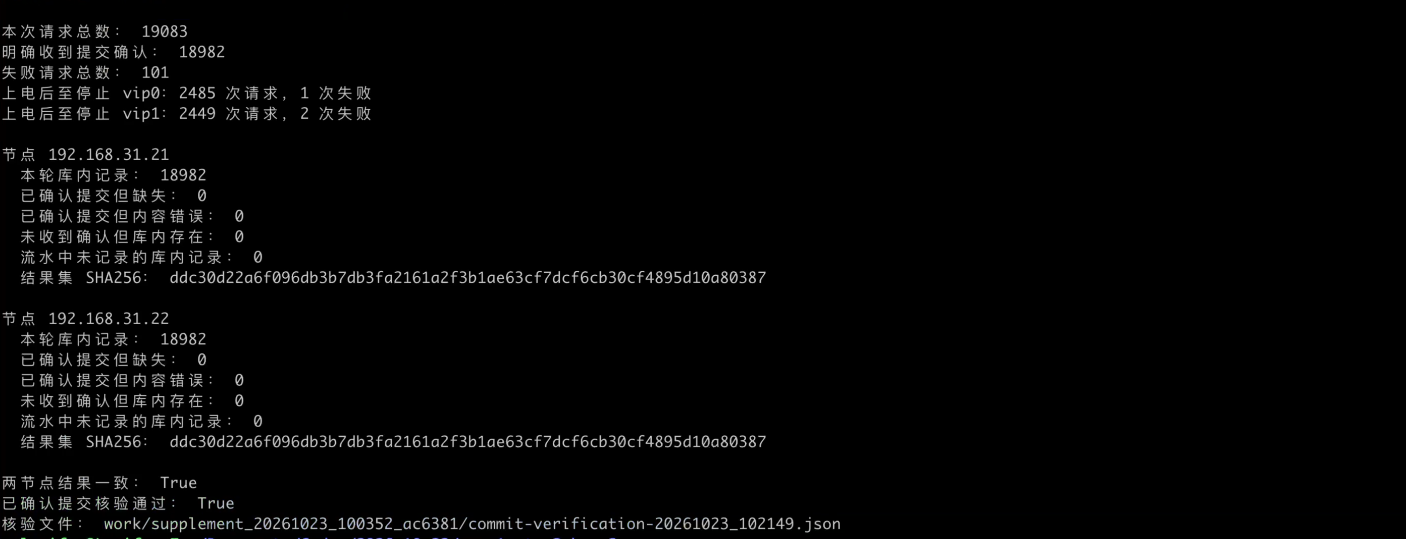
18,982 条数据都在,内容也都对得上, 那 101 次失败的请求,我也查了一下,库里没有对应的数据。
这次测的是单节点突然掉电,其他故障场景后面有机会再测。
前一天其实我已经测过五轮,两个节点轮流关。这次为了把过程截图补齐,又跑了上面这一轮。
前面五轮的恢复时间如下,统计的都是通过故障节点原 VIP 重新读写成功的时间:
四轮都是三十多秒,和这次差不多,但第一轮用了 108.66 秒。
我回头翻了一下日志,VIP 在断电后约 25 秒就已经在存活节点上启动了,但客户端一直到一百多秒才恢复正常读写。
中间为什么等了这么久,当时没有抓包,也没记录客户端的 ARP 变化,原因还没查清楚,这个结果先如实放在这里。
所以我测恢复时间,还是以客户端实际读写为准。VIP 漂过去了,应用能不能正常访问,还得再看一下。
其实做 Oracle DBA 这么多年,维护过的 RAC 也很多了,我对这类问题会比较在意。金仓 RAC 到底和 Oracle RAC 有多大差距,靠这套小环境还比不出来,但从这次搭建和故障测试来看,已经有了值得继续折腾的东西。
国产数据库这些年确实在往前走。对我来说,支持也很实际:拿来用一用,有问题就反馈,有进步也愿意写出来。希望后面的版本能把这些细节继续打磨好,给 DBA 多一个用得顺、心里有底的选择。
注:测试版本为 V009R009B1019,使用同一物理宿主机上的轻负载虚拟机环境。本轮补测与前一天五轮分别统计,截图均来自补测现场。