DBRescue
MySQL IBD 表数据恢复
本文使用 DBRescue 提取 MySQL 独立表空间中的记录。保留 IBD 副本,优先读取文件内的 SDI;没有可用 SDI 时,提供与文件对应的建表语句。
恢复原理与模式
工具读取 InnoDB 数据页,使用 SDI 或建表语句生成解析结构,再提取支持的记录。桌面单文件模式不依赖 MySQL 服务启动,用户名和表名筛选不可填写。
本文走“数据文件提取”。binlog 入口用于日志分析,不等同于恢复出误删业务记录;不要把事件清单或回滚计划当作已执行的恢复。
恢复准备
练习时下载下方测试包,解压后使用 input/sample.ibd、input/sample.sql,根目录保留比对脚本和参考数据。处理自己的文件时,准备停止写入后的 IBD 副本及可用 SDI 或单表 CREATE TABLE。另建空输出目录,不能放在输入目录内。
自己的 IBD 要使用自己的 SDI 或原表 DDL。不能给缺少结构的旧版本文件随意套一张表;加密、压缩和不支持的记录布局需先确认。
自己的文件,参数从哪里找
下面是只读查询,在数据库客户端执行,不是在 DBRescue 中执行。原库还能正常查询时,请 DBA 导出这些资料;原库已经故障,就使用匹配、可启动的副本,不要为了查参数强行启动故障原库。
先连接文件所属的原数据库,再执行下面的查询。这里的 sample 是样本表名,自己的表要替换。
1SELECT VERSION() AS version, DATABASE() AS current_database;2SHOW CREATE TABLE sample;3SELECT COLUMN_NAME, COLUMN_TYPE, IS_NULLABLE FROM information_schema.COLUMNS WHERE TABLE_SCHEMA=DATABASE() AND TABLE_NAME='sample' ORDER BY ORDINAL_POSITION;SHOW CREATE TABLE 返回的完整建表语句才是需要保存的 DDL。只把 CREATE TABLE 语句以 UTF-8 保存为 sample.sql,不要把查询表头、行号或 Excel 文件改名成 SQL。 核对列顺序、字段类型、主键和字符集。单个 IBD 走 SDI 自动识别时可以不选 DDL,但仍要检查识别结果。
下载参数核对 SQL原库和匹配副本都不可用时,先找结构备份、应用建表脚本或迁移记录。不能用本文的六列结构替代自己的表。
本次测试结果
本次来自 MySQL 8.0.46,表中 4096 行、6 个字段。手工 DDL、自动 SDI 和目录路线均通过原库基准比对,源文件哈希未改变。桌面单文件 DDL 任务结束状态为 review-required。
使用正常关闭后的真实数据库文件和虚构测试数据,桌面为开发构建、测试授权。未制造文件损坏;隔离导入是否通过,见下方各库的实测记录,不据此推算故障库恢复率。
恢复操作实战
下面是本次桌面工具的实际操作。点击标题展开,按顺序选择文件、填写参数,再检查结果。
MySQL 8.0 IBD 表记录提取实战
演示:Windows 桌面开发构建,MySQL 8.0.46 采集文件,测试授权。目标文件 sample.ibd,对应结构 sample.sql。
1. 安装工具并激活
- 从下载区安装对应系统的工具。
- 领取或购买 MySQL / 全库授权,在工具中激活;先确认引擎就绪。
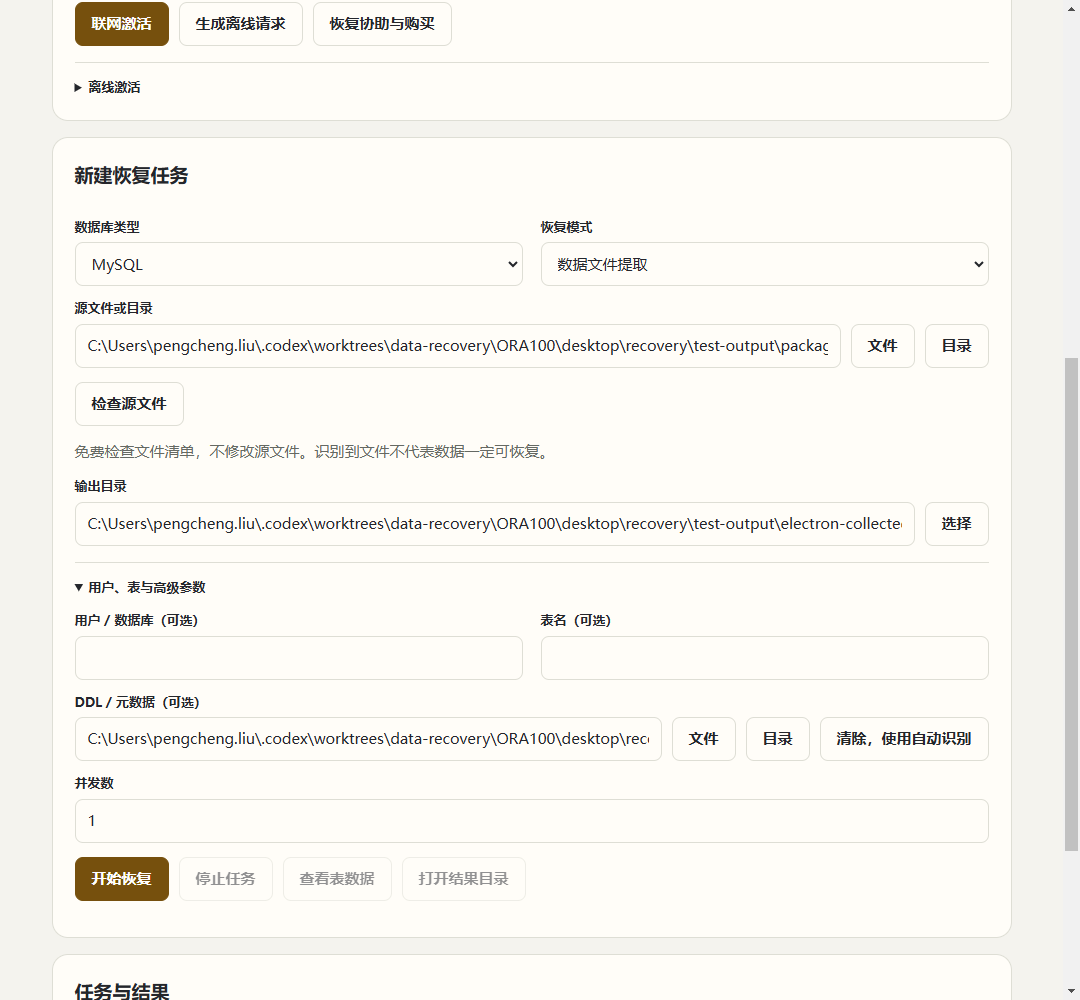
- 新建任务选择 MySQL,模式选择“数据文件提取”。
2. 选择输入和输出
- 点击源文件右侧的“文件”,选择 sample.ibd 或自己的 IBD 副本。
- 选择独立的空输出目录,不要把结果写回输入目录。
- “检查源文件”只确认文件清单和读取情况,还没有开始提取记录。
3. 填写参数
- 如果使用 IBD 内的 SDI,清空 DDL / 元数据选择,再执行预览检查结构是否识别。
- 本次使用 DDL 路线:展开“用户、表与高级参数”,选择 sample.sql。该文件仅包含对应表的 CREATE TABLE。
- 单文件模式下不用填写用户名和表名,并发数保持 1。自己的文件必须换成自己的建表语句。
4. 执行提取
- 核对 IBD、DDL 和输出目录,点击“开始恢复”。
- 等待任务结束,查看日志,不要在执行中换输入文件。
- 本次解码 4096 行,任务显示 review-required。该状态要求检查物理候选记录,并非已经恢复到业务库。
5. 查看导出记录
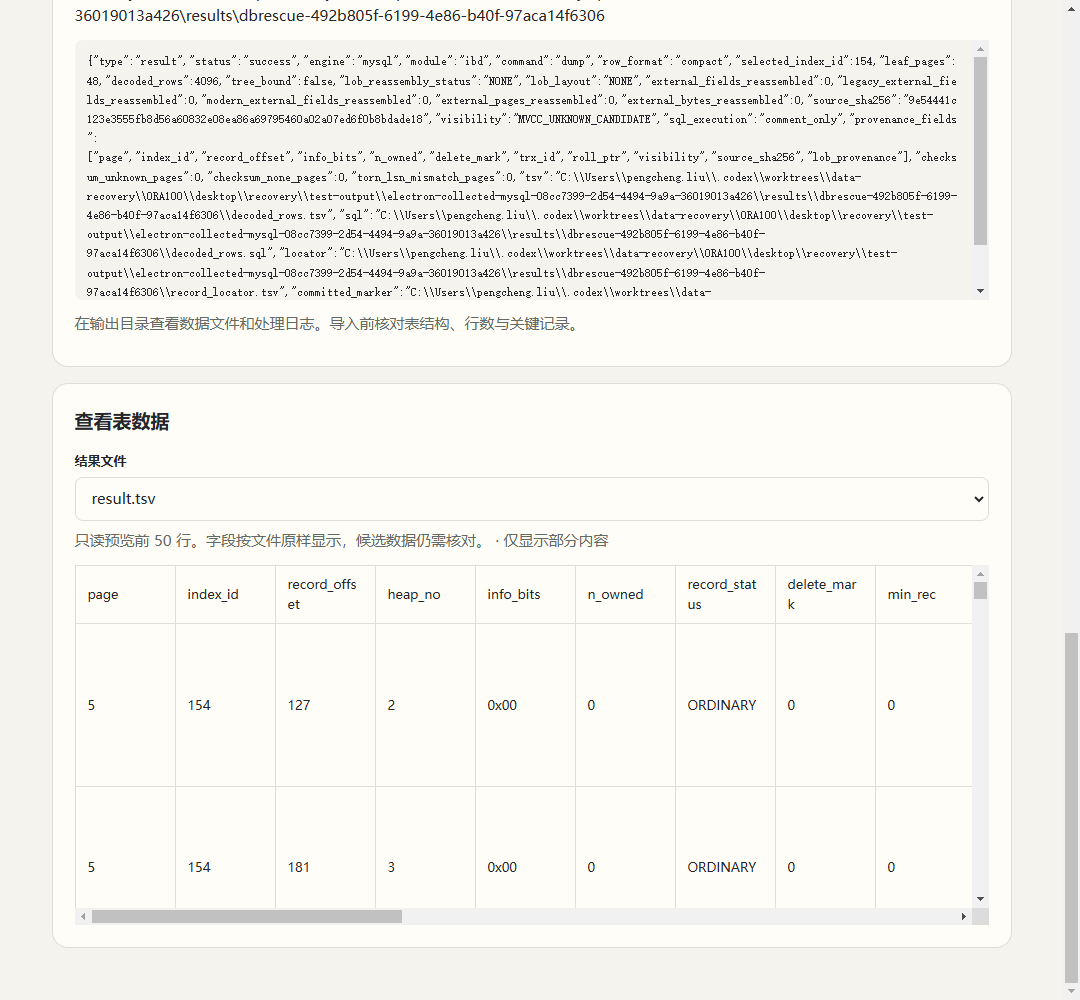
- 点击“查看表数据”,选择 result.tsv;目录任务先找到对应文件的子结果。
- 本次检查 id、name、big、amount、stamp、born 六列,核对中文、整数、金额和日期。
- 打开结果目录保留 TSV、SQL 注释和任务日志。不要把物理记录直接当作已提交记录。
6. 恢复后检查
- 与原库查询留存的基准逐字段比对。本次 4096 行、6 列全部一致,检查了重复主键和源文件哈希。
- 自己的文件要核对字段、行数、重复和缺失记录;预览只显示部分行,不能按预览数量验收。
- 查看输出中的事务与可见性提示。任何不确定的记录先保留,不能直接向原业务库执行 SQL。
使用本文练习包时,完整解压,保留根目录的 Check-Sample.ps1、baseline.json 和 settings.json。打开解压目录,在资源管理器地址栏输入 powershell,执行下面两行,按提示粘贴本次导出 TSV 的完整路径(去掉路径两端引号)。脚本仅适用于本文样本,不修改文件。
1$resultFile = Read-Host 'Exported TSV full path'2.\Check-Sample.ps1 -ResultFile $resultFile本次实际输出:PASS: 4096 rows; 6 columns match. Transaction state is not established. 只证明样本字段一致,不证明事务或业务恢复。脚本受系统策略阻止时,请使用获准的执行环境,不关闭安全策略。
导入测试库,再核对一次
提取后,又把这 4096 行写入一套新建的 MySQL 8.0.46 测试实例。按原来的 6 列类型建表,再查询回来比对,全部一致,包含 245 个 NULL,ID 没有重复。测试实例只开放本地 socket,验收后已停止。
- 先连接一套独立的 MySQL 测试环境,新建空数据库并选择它,字符集使用 utf8mb4。不要选择原业务库。
- 下载下方 SQL,在数据库客户端打开,确认里面只有本例的 sample 表和虚构测试数据,再执行整个脚本。表已存在时先停下来,另建空测试库,不要直接删表。
- 执行下面的 SQL 核对行数,再与练习包中的 baseline.json 逐字段比对。本次是在 ESXi 实验机上实际执行,不只是检查 SQL 文件。
1SELECT COUNT(*) AS rows_total, COUNT(DISTINCT id) AS distinct_ids2FROM sample;在数据库客户端里,具体怎么执行
下面使用数据库自带的命令行客户端,不是在 DBRescue 任务窗口输入命令。先安装对应客户端,让管理员准备空的隔离测试环境和账号。把练习 SQL 放到 C:/recovery-practice;路径不同就替换下面的路径。
以下是连接模板:TEST_HOST 是测试服务器地址,TEST_PORT 是实际端口,TEST_USER 是测试账号,TEST_DATABASE 是管理员给出的空测试库,Oracle 的 TEST_SERVICE 是服务名。必须替换这些字样;密码在客户端提示时输入,不写进脚本。命令找不到时,进入客户端 bin 目录再执行。
1. 先确认连接位置
1mysql --host=TEST_HOST --port=TEST_PORT --user=TEST_USER --password --default-character-set=utf8mb4 TEST_DATABASE登录后先执行 SELECT DATABASE(), CURRENT_USER();,确认是刚准备的空测试库。出现 mysql> 后,下面的 SOURCE 才是在 MySQL 客户端里执行,不是在 PowerShell 中执行。
2. 再执行练习脚本
先打开 SQL 看一遍,确认目标是 sample。确认当前测试库为空,再在 mysql> 提示符下执行:
1SOURCE C:/recovery-practice/import-sample.sql;执行中出现报错就停止,保留第一条错误和完整输出,不要反复重跑 INSERT。成功后在同一目标库执行上面的计数查询,再按 ID 对齐逐字段核对。只有两个计数都为 4096 还不能作为完整验收。
文件执行方式已在 ESXi 的原生客户端验证:MySQL SOURCE、psql 的 \i、sqlcmd -i、SQL*Plus 与 DIsql 的 @。连接地址、账号和 Windows 路径是需要替换的模板;本节没有把命令行记录当成图形客户端截图。
本例的总行数和去重后的 ID 数均为 4096。行数相同还不够,本次另外逐字段比对了全部记录;中文、NULL、数字和日期也要一起核对。
这份 SQL 是把本例已核对的导出记录转换后生成的,只供这套样本练习。自己的文件必须按真实 DDL 和导出格式处理,尤其要分清空值与文本 NULL。事务可见性仍需核对,不能拿这份样本 SQL 回补自己的表。
遇到问题时
缺少结构或元数据
自动 SDI 失败时保留日志,确认文件版本和 SDI 是否存在。转用原表单个 CREATE TABLE,不要选择导出数据 SQL 或其他表的 DDL。
没有提取出记录
检查表结构是否与 IBD 匹配,源文件是否完整以及记录布局是否支持。保留原副本和日志,不要用不同 DDL 反复覆盖输出。
显示部分完成或需要复核
检查每个子结果和失败原因。review-required 表示需复核物理候选记录;partial 表示仍有未完成或失败项。两者都不能当成业务恢复完成。
本例已完成文件提取、原库基准比对和独立 MySQL 实例中的导入核对。生产回补没有执行,自己的数据还要确认事务、表结构及业务关系。
解析细节和导出文件
用 DDL 补充表结构
解析提供的建表语句,将字段顺序和类型交给数据提取流程,避免只有 IBD 却无法解释列。
按数据库或表提取 IBD
支持指定库和表;压缩、加密、校验和及记录链异常会留下警告,不能把扫描结束当成数据完整。
事件清单与回滚计划同时保留
分析单个 binlog 或整个目录,生成事件 TSV 和逐文件回滚 SQL 计划;执行前仍要检查事务与适用范围。
完整目录先复制,再尝试导出
数据目录导出模式先复制源目录,在副本上启动关闭网络访问的临时实例,再用 mysqldump 导出。该模式有额外运行环境要求。
- result.sql
- 数据提取模式的 SQL;日志模式可能只提供审查脚手架
- result.tsv
- 提取的行或日志事件清单
- binlog_events.tsv
- binlog 事件记录
- binlog_rollback_plan.sql
- 逐文件回滚计划,执行前人工核对
查看命令行示例
1dbrescue extract --db mysql --path /recovery/data --user app --table orders --out-dir /recovery/output